

导读:OpenRaft 为 Databend Meta Service 提供共识机制。自定义 membership 让应用按节点数量、权重和部署拓扑选择 quorum。本文介绍 5 种实现及其故障取舍,并通过完整的加权 KV 示例,说明如何初始化集群、在次机房故障时继续运行,以及恢复副本。
自定义 Membership 与 Databend 元数据服务
OpenRaft 最近加入了自定义 membership,让应用决定选举或提交必须等待哪些节点。4 个节点的集群可以在取得 2 份复制确认后提交,而不必等待通常多数派所需的 3 份。9 个节点分在 3 个机房时,可以要求任意 2 个机房各有 2 份确认,用 4 份确认完成提交,而不是 5 份。
OpenRaft 为 Databend Meta Service 提供共识机制。Databend 是用 Rust 开发的开源数据仓库,将表数据存储在对象存储中,通过 Meta Service 管理数据库和表定义等元数据。OpenRaft 运行在 Meta Service 内部,负责 Leader 选举和节点间元数据变更的复制。因此,副本如何部署、哪些节点参与选举和提交,都与元数据服务的可靠性直接相关。
Databend
+-- Query: 执行查询, 访问对象存储中的表数据
+-- Meta Service: 管理共享元数据
    +-- OpenRaft: election 和元数据变更的复制
即使表数据仍然可以访问,元数据的可用性也会影响数据库操作。创建表或提交元数据更新,都需要元数据服务继续运行。因此,元数据副本的部署位置和 quorum 规则能容忍的故障,会影响整个数据库。
自定义 membership 让应用根据部署需求选择共识规则。例如,可以优先保障主机房可用,要求副本分布在不同机房,或允许部分副本不可用时继续提交。减少必须等待的确认数,有机会缩短提交等待时间,但也可能减少提交时已保存的副本,或提高重新选举 Leader 的要求。即使 quorum 包含的节点更少,提交延迟仍可能取决于必须等待的慢机房。
下文的配置用于展示 OpenRaft 的能力,并不代表 Databend 当前生产环境的 quorum 配置。API 示例和协议细节均以这里链接的 OpenRaft 版本为准。
1. 选举与日志提交可以使用不同的 Quorum
应用可以减少提交等待的副本数,同时要求选举收集更多投票。例如,node {1,2,3,4} 采用 write quorum = 2,read quorum = 3。
Leader 1 收到 foo=1 的客户端写入后,在本地保存日志条目,并向其他节点发送 AppendEntries。节点 2 也保存这条日志条目后,节点 {1,2} 就构成 write quorum,允许这条日志条目按 Raft 的提交规则完成提交。这 2 份确认包含 Leader 自己的副本,所以 Leader 只需等待 1 个 Follower。
替换 Leader 需要 3 个节点的选票。例如,投票节点检查 candidate 3 的日志是否足够新,检查通过后,候选节点 3 可以凭 {1,3,4} 的投票赢得选举。节点 {1,3,4} 构成 read quorum,与 write quorum {1,2} 共享节点 1。
append entries: write quorum {1,2}
election:       read quorum  {1,3,4}
shared voter:               {1}
每个 read quorum 都必须与每个 write quorum 相交。因此,每次选举都会遇到至少 1 个保存了相应已提交日志条目的节点。这个交集与 Raft 的日志规则、投票检查共同保证下一任 Leader 的日志仍包含已提交的日志条目。Flexible Paxos 描述了类似的选举与复制 quorum 分离设计。
read quorum 中的 read 指选举过程中对候选节点日志的检查。应用读取某个 key 或执行 SQL 查询时的读取规则,需要另行区分。线性一致性读仍需通过 OpenRaft 的 Leader 身份校验和状态应用进度检查。设置 read quorum = 3,并不意味着每次应用读取都要获取同一个值的 3 份副本。
选举所需的投票数还取决于 leader ID 类型。下文示例使用 OpenRaft 默认的 advanced leader IDs。这类 leader ID 具有全序关系,收集 read quorum 的投票即可选出 Leader。使用 standard leader IDs 时,投票集合必须同时满足 read quorum 和 write quorum 规则。例如,3x3 网格使用 advanced leader IDs 时需要 3 票,使用 standard leader IDs 时则需要 5 票。选举 quorum 文档解释了这一区别。
其余节点仍会接收 AppendEntries。较小的 write quorum 只改变提交时必须等待的确认范围,不会自动减少总复制流量。它也意味着提交时保证已保存的副本更少。这些示例假设故障属于崩溃故障,存储行为正确,且存活节点之间可以通信,不考虑拜占庭故障。
2. 用 5 种 Membership 实现不同的部署策略
openraft-membership crate 提供 5 种按节点数量、权重或部署位置定义 quorum 的实现。每种实现都定义 read 和 write 这 2 类 quorum。如果选举和提交都适合使用多数派,仍可使用 OpenRaft 默认的 Membership。
ThresholdMembership 按节点数量定义 Quorum
ThresholdMembership 让应用选择提交所需的副本数。对于 4 个投票节点,设置 write_size = 2 后,任意 2 个投票节点就能构成 write quorum。read quorum 自动推导为 3,计算方式如下。
read quorum = voter count - write quorum + 1
            = 4 - 2 + 1
            = 3
如果所有投票节点的地位相同,而且减少提交等待比依靠少量存活节点替换 Leader 更重要,可以选择这种实现。这个集群的 Leader 只需等待 1 个 Follower,而 4 个节点的多数派需要等待 2 个 Follower。
可用性的取舍会在故障后体现出来。如果 Leader 1 和节点 2 仍在,节点 3、4 故障,Leader 就能继续提交。但这 2 个存活节点无法完成选举。如果集群需要替换 Leader,就必须先恢复另一个投票节点。
如果应用要求在确认写入成功前保证更多副本,就不应使用过小的 write quorum。节点数量也无法反映副本所在的故障域。2 份确认可能来自同一个机架或机房。如果要求容忍整个机房丢失,应使用能表达部署位置的规则。
WeightedMembership 按节点权重定义 Quorum
WeightedMembership 可以让一个机房拥有足够的投票和复制权重,不依赖另一个机房就能运行。给节点 {1,2,3,4} 分配权重 {1:2, 2:1, 3:1, 4:1},总权重为 5。设置 write_weight = 3 后,read weight 也为 3。
read weight = total weight - write weight + 1
            = 5 - 3 + 1
            = 3
将节点 1、2 放在机房 A,节点 3、4 放在机房 B。机房 A 的权重为 3,不依赖机房 B 就能完成选举和提交。机房 B 的权重为 2,与机房 A 失去联系后,选举和提交都无法完成。节点 {2,3,4} 的权重也为 3,所以节点 1 故障后,只要这 3 个节点仍然可用,集群就能恢复运行。
如果部署有意优先保障某个机房,或者不同投票节点应贡献不同权重,可以选择这种实现。它只需部署 4 个节点,就能在次机房故障时保持主机房可用。
这个配置无法支持两个机房互相接管服务。机房 A 丢失后,机房 B 就无法继续运行。权重也不会增加物理副本,或自动让权重最高的节点成为 Leader。如果某个节点自己的权重就达到 write weight,提交时可能只有它保存了副本。分配权重时不仅要计算可用性,也要审查持久性。
HierarchicalMembership 按机房和机架分层定义 Quorum
HierarchicalMembership 可以要求任意 2 个机房各有 2 个节点保存日志条目。对于包含 3 个机房、每个机房部署 3 个节点的集群,将根层的 write size 设为 2 个机房,每个机房的 write size 设为 2 个节点。
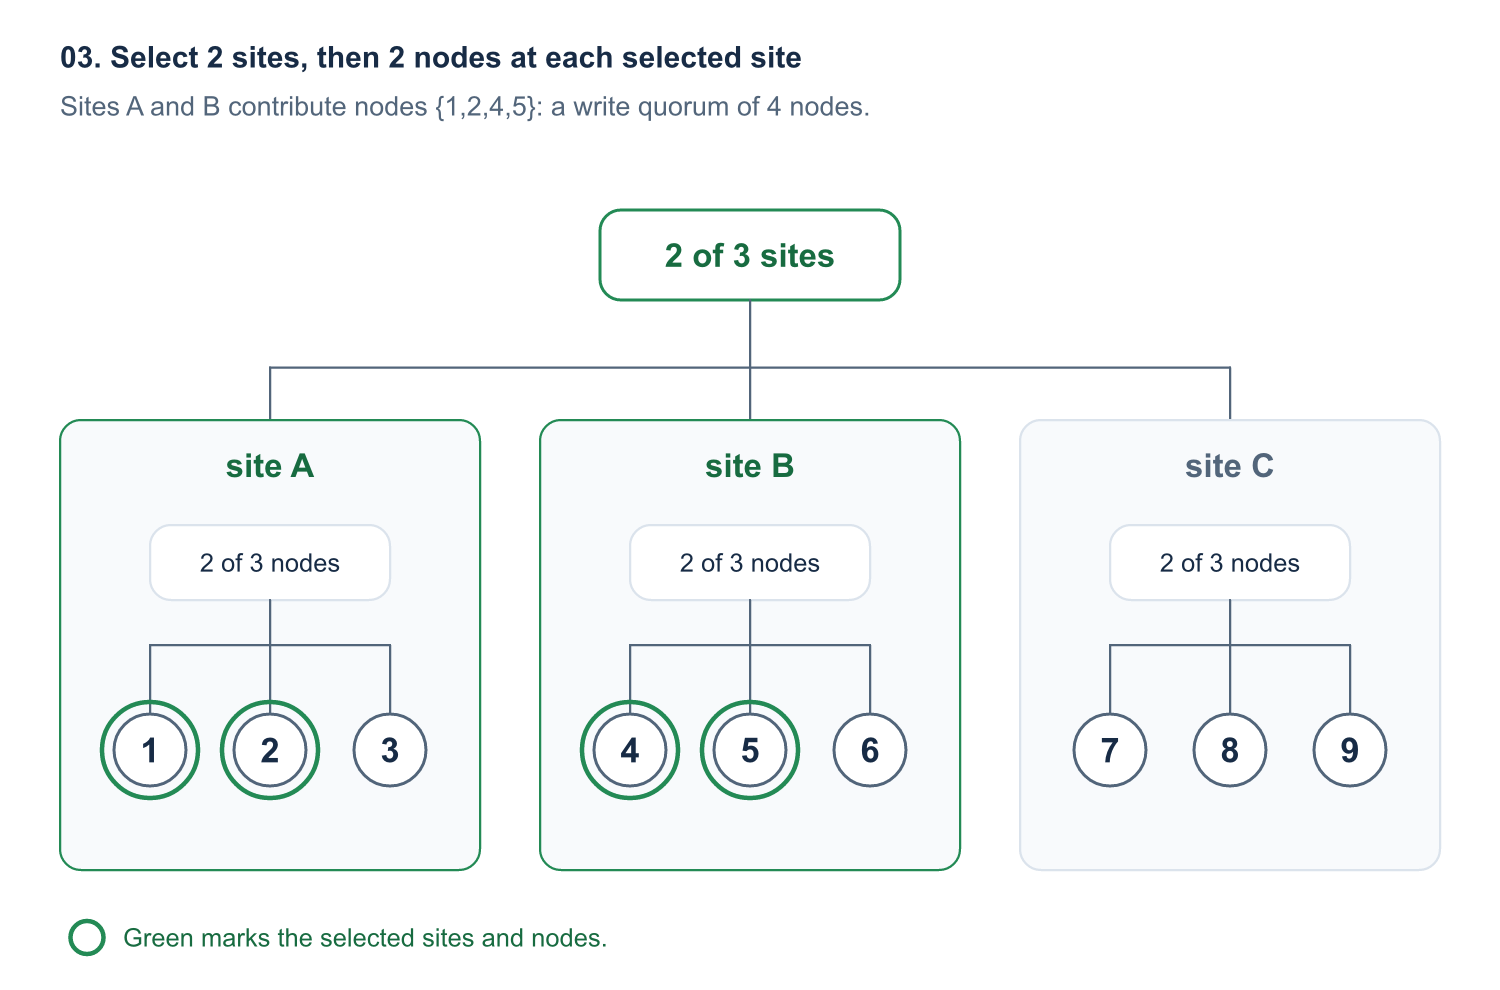
Leader 1 可以在机房 A 的节点 1、2 和机房 B 的节点 4、5 保存日志条目后,提交 foo=1。这 4 个节点构成 write quorum,而不分层的多数派需要 5 个节点。推导出的 read 规则同样要求 2 个机房各有 2 个投票节点。
如果故障域是需求的一部分,可以选择这种实现。机房 A 故障后,机房 B、C 仍能完成选举和提交。每个机房各丢失 1 个节点时,集群也能继续运行。更多层级还可以表达数据中心、机架和服务器。
分组边界也带来了限制。如果只剩 {1,4,7,8,9},虽然还有 5 个节点存活,但只有机房 C 拥有 2 个可用节点。选举和提交都无法满足规则。同样的 9 个节点如果使用不分层的多数派,这 5 个存活节点仍能运行。
选择这条规则时,还需要考虑确认数之外的要求。它保证特定的副本分布,容忍特定的故障,与普通多数派规则的故障取舍不同。这条规则还要求另一个机房的确认,因此在机房间无法通信时,不能只靠本机房完成提交。
GridMembership 用行列布局定义 Quorum
GridMembership 通过布局约束同时减小 read quorum 和 write quorum。将 9 个投票节点排成 3x3 网格,任意完整的 1 行构成 read quorum,每行至少取 1 个节点构成 write quorum。
election: read quorum {1,2,3}
+-------------------------+
|   [1]      2       3    |
+-------------------------+
     4      [5]      6
     7       8      [9]

[n] = node in write quorum {1,5,9}
使用 advanced leader IDs 时,候选节点 1 可以凭 {1,2,3} 的投票赢得选举。节点 {1,5,9} 保存日志条目后,这条日志条目就可以提交。每个 write quorum 都覆盖每行,所以与每个 read quorum 相交。提交最少需要 3 份确认,选举最少需要 3 票,而多数派需要 5 个节点。
如果预期的故障模式适合网格布局,且较小的 quorum 值得引入这些布局约束,可以选择这种实现。当 {1,2,3,5,9} 存活时,第 1 行能够完成选举,{1,5,9} 能够完成提交。使用 standard leader IDs 时,选举本身需要完整的 1 行,再加上其他每行各 1 个投票节点,共 5 票。
故障对选举和提交的影响不同。丢失节点 {1,4,7} 后,仍有 6 个节点存活,但每行都不完整,因此无法选出新 Leader。如果原有 Leader 仍在存活节点中,它仍可使用 {2,5,8} 完成提交。反过来,丢失整行会阻止所有提交,尽管使用 advanced leader IDs 时,其他完整行仍能选出 Leader。没有 write quorum 的新 Leader 无法完成当前 term 的初始提交,也无法提供线性一致性读。
如果主要考虑任意节点故障,就不应选择网格。这个 3x3 网格只能容忍任意 2 个节点故障,而 9 个节点的多数派可以容忍任意 4 个。如果将每行映射到一个机房,每次提交还都必须等待所有机房。选择网格前,需要确认它在故障时的行为符合部署要求,仅比较 quorum 大小不足以作出选择。
ExplicitMembership 直接列出 Quorum
ExplicitMembership 可以表达其他实现不便描述的策略。例如,要求每次提交都包含主站节点 {1,2,3} 中的任意 2 个,再加上备份节点 9,而选举只需主站的 2 个投票节点。
minimal read quorum    minimal write quorum
{1,2}                  {1,2,9}
{1,3}                  {1,3,9}
{2,3}                  {2,3,9}
这里共有 4 个投票节点,备份节点的 ID 为 9,无需部署 9 个节点。一个集合只要包含列出的某个 quorum,就满足相应规则。列出的每个 read quorum 都与每个 write quorum 相交,构造函数会检查这些交集。
如果一个简短的显式列表就能清楚表达重要策略,可以选择这种实现。在这个例子中,每次已确认的写入都在节点 9 上有副本。代价是每次提交都必须等待备份节点的同步复制。节点 9 或它的网络链路故障时,所有提交都会停止。使用 advanced leader IDs 时,主站的 2 个投票节点仍能完成选举,但新 Leader 仍需节点 9 才能提交初始日志条目,并完成线性一致性读。使用 standard leader IDs 时,选举也需要节点 9 的投票。
如果备份故障时仍需保持写入可用,就不应使用这条策略。主站故障后,它也不能让备份机房独立运行。对于常见的大规模阈值策略,应避免显式列举。最小 quorum 的数量会按组合数增长,验证时还需要逐一比较每个 read quorum 与每个 write quorum。如果按数量、权重或树形结构就能表达相同需求,这些规则会更容易维护。
3. 用完整的加权 KV 示例保持主机房可用
一个跨 2 个机房的元数据 KV 服务,可以优先保障主机房可用,同时明确其容灾能力的边界。假设多数客户端运行在机房 A,服务应在机房 B 不可用时继续接受写入。任意 1 个节点故障,且其余 3 个节点仍能通信时,服务也应继续运行。运维方接受机房 B 无法独立接管服务的限制。
使用上一节的加权配置。
| 节点 | 机房 | 权重 | Raft 地址 | 应用地址 |
|---|---|---|---|---|
| 1 | A | 2 | 127.0.0.1:37001 | 127.0.0.1:36001 |
| 2 | A | 1 | 127.0.0.1:37002 | 127.0.0.1:36002 |
| 3 | B | 1 | 127.0.0.1:37003 | 127.0.0.1:36003 |
| 4 | B | 1 | 127.0.0.1:37004 | 127.0.0.1:36004 |
read weight 和 write weight 都为 3。上面的地址用于在 1 台机器上运行示例,机房 A、B 表示预期部署和故障分组。这是 OpenRaft 加权 KV 示例展示的一种应用设计,用于说明 quorum 规则的行为。该示例不代表 Databend Meta Service 的实际部署方案。
选择 membership 和对应的 edit 类型
应用通过 TypeConfig 选择 quorum 的表示类型,以及修改它的操作类型。示例中的 types_kv crate 提供 KV 请求和响应类型。
use openraft_membership::{WeightedChange, WeightedMembership};

openraft::declare_raft_types!(
    pub TypeConfig:
        D = types_kv::Request,
        R = types_kv::Response,
        Node = openraft::NodeInfo,
        Membership = WeightedMembership<Self::NodeId, Self::Node>,
        MembershipEdit = WeightedChange<Self::NodeId, Self::Node>,
);
初始化集群,等待 learner 追上日志后再提升为投票节点
先初始化节点 1,等待它成为 Leader 并应用初始日志条目。然后将其他节点加入为 learner,再为它们分配投票权重。在下面的异步初始化代码中,raft 是按 TypeConfig 创建的节点 1 的 Raft 实例,其余 3 个节点进程已在运行。
use std::collections::BTreeMap;
use std::time::Duration;

use openraft::{LogIdOptionExt, NodeInfo};

let node_info = |id: u64| {
    NodeInfo::new(
        format!("127.0.0.1:{}", 37000 + id),
        format!("127.0.0.1:{}", 36000 + id),
    )
};

let membership = WeightedMembership::new(
    BTreeMap::from([(1, 1)]), // 初始 voter 及其权重.
    1,                      // 初始 write weight.
    BTreeMap::from([(1, node_info(1))]),
)?;
raft.initialize(membership).await?;

// 更新 membership 前, leader 的初始 log entry 需要先 commit.
raft.wait(Some(Duration::from_secs(10)))
    .metrics(
        |m| m.current_leader == Some(1) && m.last_applied.index() >= Some(1),
        "node 1 leads and has applied its initial entry",
    )
    .await?;

for id in [2, 3, 4] {
    // true 表示等待 learner 追上后再返回.
    raft.add_learner(id, node_info(id), true).await?;
}

let weights = BTreeMap::from([(1, 2), (2, 1), (3, 1), (4, 1)]);
let change = WeightedChange::weights(weights).with_write_weight(3);
raft.change_membership(change, false).await?;
单节点初始化属于准备步骤,不具备容错能力。最终 membership 通过 OpenRaft 的 membership 变更协议生效。因为权重发生变化,OpenRaft 会先提交联合配置,再切换到目标配置。参数 false 表示,如果有投票节点被降级,就将其移除,不再保留为 learner;这次变更没有降级任何投票节点。
完成写入,停掉次机房,再次写入
进程测试覆盖了完整的初始化和故障过程。
-
启动 4 个节点进程,初始化节点 1,加入 learner,并设置最终权重。
-
发送
foo=1的客户端写入,等待每个节点都能读到这个值。 -
停掉节点 3、4,模拟机房 B 丢失。
-
向 Leader 1 发送
foo=2。节点{1,2}保存日志条目,达到 write weight2 + 1 = 3,因此写入完成提交。 -
检查节点 2 读到
foo=2,并检查节点 1 完成线性一致性读,返回相同的值。
要复现仓库中的测试,请使用仓库指定的 Rust toolchain,在本文对应版本运行以下命令。
git clone https://github.com/databendlabs/openraft.git
cd openraft
git checkout 43537dd5b7d247be49c10163cff09700915c0f60
cargo test -p raft-kv-memstore-weighted-membership \
    test_weighted_membership -- --nocapture
测试使用应用端口 36001 到 36004,Raft 端口 37001 到 37004。它展示了机房 B 丢失后继续写入和完成线性一致性读的能力,并未测试所有可能的选举或网络分区场景。
明确哪些故障会让服务停止
这些权重也能推导出其他故障场景的结果。接任 Leader 的节点还必须拥有足够新的日志,并完成正常的选举和初始提交步骤。
| 故障 | 此配置下的结果 |
|---|---|
| 机房 B 故障,节点 3、4 停止 | 机房 A 的权重为 3,可以提交,需要时也能选出新的 Leader。 |
| 机房间链路故障 | 机房 A 凭权重 3 继续运行。机房 B 的权重为 2,无法形成任意一类 quorum。 |
| 机房 A 故障,节点 1、2 停止 | 机房 B 的权重为 2,无法提交,也无法选出 Leader。 |
| 节点 1 故障,节点 2、3、4 仍能通信 | 存活节点的权重为 3,可以完成选举和提交,但必须跨机房通信。 |
| 机房 B 故障后,机房 A 再丢失任意 1 个节点 | 剩余节点的权重最多为 2,提交和选举都会停止。 |
同一条规则也决定了提交时的持久性保证。提交可能只等待机房 A 的节点 1、2。条件允许时,日志仍会继续复制到机房 B,但写入成功并不保证机房 B 已保存相应日志条目。如果机房 B 尚未追上,机房 A 就永久丢失,最近已确认的写入也可能丢失。如果要求丢失任意一个机房后仍保留每次已确认的写入,就需要同步跨机房复制等其他策略,而不能只靠增加机房 A 的权重。
在原集群中恢复副本
机房 B 恢复后,让节点 3、4 通过日志复制或快照追上集群进度。在依赖这些副本应对后续故障或修改其权重之前,先检查复制进度。不要在这些副本上再次调用 initialize(),也不要在各节点上独立设置新权重。
如果机房 A 不可用,机房 B 拥有权重 2 并不意味着它可以另建一个有权接受写入的集群。应恢复原集群中足够多的节点,重新获得 quorum;或者按照单独制定的灾难恢复流程操作,并明确其中的数据丢失风险。
可执行示例使用内存存储,因此终止进程会丢失该进程的本地状态。生产部署需要持久化日志、投票记录和快照。进程测试展示了 quorum 行为,未覆盖持久化存储的恢复过程。
4. Membership 如何保存 Quorum 规则与节点信息
quorum 策略属于需要在节点间复制的集群配置,必须由集群统一协调变更。membership 包含 read quorum 和 write quorum 规则、已知节点的 ID 和地址,以及使用这些节点所需的角色。OpenRaft 将 membership 记录为配置日志条目,让副本同时收到 quorum 策略和节点信息。
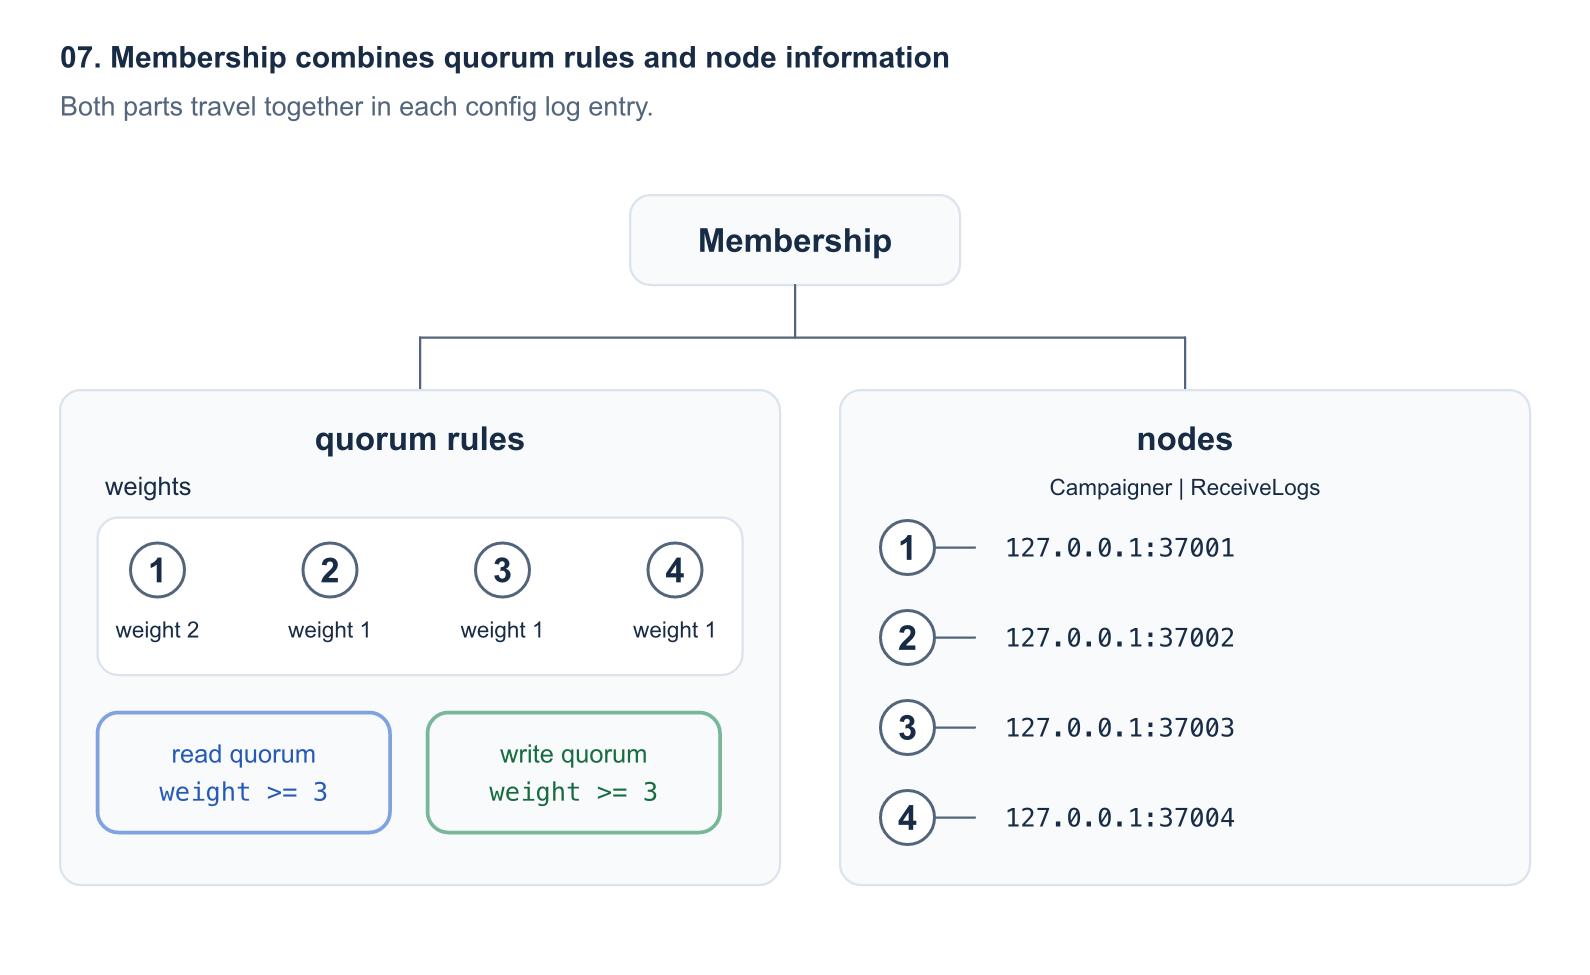
节点信息告诉 OpenRaft 如何连接副本。这些元数据由应用定义,可以包含网络地址和机房信息。NodeId 独立于地址标识节点,常见的选择是 u64。
角色区分接收日志和发起选举的能力。learner 通常具有 NodeRole::ReceiveLogs,但不属于任意一类 quorum。只有 ReceiveLogs 的投票节点可以保存日志和投票,但不会自行发起选举。Campaigner 允许节点自行发起选举。每个参与 write quorum 的投票节点都必须接收日志,因为提交不能依赖一个从不保存日志条目的节点的确认。
Membership 变更时,联合配置需要同时满足新旧规则
即使节点集合不变,修改 quorum 规则也需要协调。例如,将节点 1 的额外权重转移给节点 3。旧配置下,机房 A 可以通过 {1,2} 完成提交;新配置下,机房 B 可以通过 {3,4} 完成选举。这 2 个集合没有交集,因此各节点独立切换配置,会让新选举错过旧配置下已提交的日志条目。
如果无法证明新旧规则可以安全地直接切换,OpenRaft 就会使用联合配置。
C_old -> joint -> C_new

joint.read  = C_old.read  AND C_new.read
joint.write = C_old.write AND C_new.write
联合配置的 read quorum 同时满足新旧的 read 规则,write quorum 同时满足新旧的 write 规则。联合配置完成提交后,OpenRaft 就可以切换到目标配置。
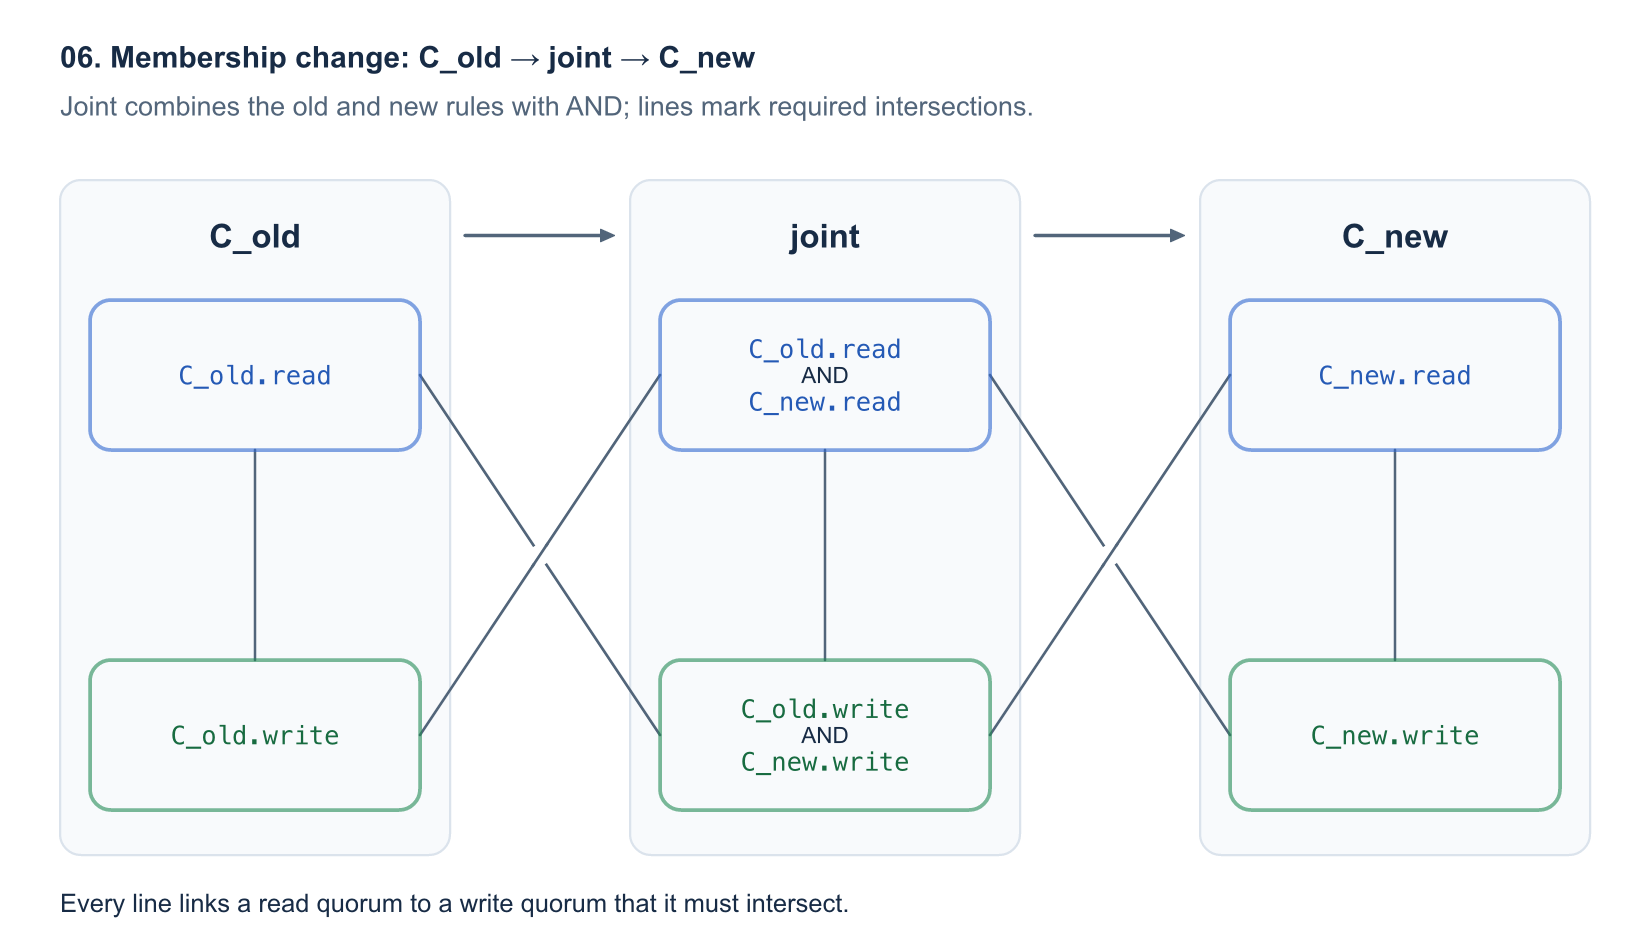
只有当每个旧 read quorum 都与每个新 write quorum 相交,且每个新 read quorum 都与每个旧 write quorum 相交时,才允许直接切换。现成的 membership 实现会检查能否证明这 2 类交集。无法证明时,OpenRaft 就使用联合配置。现成的加权实现修改权重时会使用联合配置,即使投票节点集合本身没有变化。
应在新旧投票节点都有足够数量可用,能满足联合配置规则时规划变更。即使目标配置能在某次故障后运行,如果集群无法从当前配置安全地切换过去,这个目标配置也无济于事。
5. 现成规则不足时,如何实现自己的 Membership
自定义 membership 可以表达应用特有的策略,而复制和选举仍由 OpenRaft 负责。实现新类型前,先检查现成实现是否已经能表达需求。例如,主站加备份的策略只需使用 ExplicitMembership。
自定义的 MyMembership 实现 RaftMembership,主要职责如下。
| 方法 | 职责 |
|---|---|
read_quorum_set(),write_quorum_set() | 返回选举的 read 规则和复制的 write 规则。 |
get_node(node_id),node_ids() | 查询每个 quorum 参与者的节点信息,并列出所有已知节点,包括 learner。 |
read_write_quorums_intersect() | 证明每个 read quorum 都与每个 write quorum 相交。只有返回 Some(true) 时,OpenRaft 才接受应用提供的 membership。 |
supports_direct_transition_to(other) | 只有 2 类跨配置交集都成立时才允许直接切换,否则要求使用联合配置。 |
joint_with(goal) | 构造联合配置,使 read quorum 和 write quorum 分别满足旧配置与目标配置的对应规则。 |
实现还需定义 NodeId,Node,QuorumSet 和节点迭代器 Iter。quorum set 实现 QuorumSet::is_quorum(),并通过 ids() 列出参与者。QuorumIntersection::intersects_with()表示一条规则的每个 quorum 是否都与另一条规则的每个 quorum 相交。
对于主站加备份的策略,write 规则应接受 {1,2,9},拒绝 {1,2},read 规则应接受 {1,2}。测试不仅要检查应该接受的集合,也要检查应该拒绝的集合,然后覆盖节点故障和切换到新策略的场景。
对应的 MyEdit 实现 RaftMembershipEdit<MyMembership>。apply(membership, retain) 生成目标配置,add_learner(node_id, node) 构造添加 learner 的操作,make_uniform() 构造结束联合配置的操作。通过 TypeConfig::Membership 和 TypeConfig::MembershipEdit 选择这 2 个自定义类型。
edit 类型独立于 membership 的表示类型。应用可以保留现成的 membership,仅实现自己的 edit 操作,自定义操作测试展示了这种用法。
OpenRaft 信任自定义实现对交集和切换安全性的判断。没有有效证明就返回 Some(true),或允许直接切换,可能导致已提交的日志条目丢失。现成实现满足需求时应优先使用,并按共识协议的要求审查自定义 quorum 逻辑。
6. 先确定要容忍的故障,再选择 Quorum 大小
自定义 membership 让应用根据部署需求,明确提交时必须满足的副本条件,以及哪些故障发生后仍需保持可用。阈值规则选择副本数,权重规则优先保障特定节点或机房,分层规则表达故障域,网格用较低的任意故障容忍度换取更小的 quorum,显式列表则直接表达特殊要求。
对于 Databend 以及其他使用多副本元数据服务的系统,这些选择关系到元数据更新和数据库操作能否在故障期间继续进行。选择规则时,应从具体的故障要求出发。例如,次机房故障时继续运行,丢失一个机房后保留每次已确认的写入,或在特定的一组节点故障后选出新 Leader。然后,选择能满足要求的最简单的 quorum 规则。
现有 Leader 能否继续提交,与集群能否选出新的 Leader,是 2 项独立的可用性保证。 评估时应同时检查这 2 项保证、提交时保证已保存的副本,以及 membership 变更的切换路径。较小的 quorum 是否值得采用,取决于它带来的提交收益和故障取舍是否符合应用需求。

