在 Claude Code 团队的 CLI 仓库里,一个夜间,AI 作者与 AI 审查器来回拉扯了 50 多轮,每一轮修改都触发新一轮审查,直到人类作者强行叫停。
这不是段子。Anthropic 在 11 月 15 日公开了 Claude Code 团队的代码审查方法,InfoQ 当天跟进报道。Addy Osmani、Morgan Westlee Lunt 和 Qing Wang 三个人描述了这套流程如何随着 AI 生成代码体量的增长而演化:6 月到 9 月,合入 Claude Code 仓库的 PR 数量翻倍以上,而需要回滚的变更比例下降 40% 以上。产量翻倍,回滚率反而下降,说明前置验证在起效,质量没有随体量失控。
团队在文中给出一个数字:Claude Code 自身约 90% 的代码由 Claude 编写与审查(团队自述)。当写代码的主力变成机器,审查这件事就必须重新设计:审什么、谁来审、审到多深、什么时候停,都要有明确答案,这正是这篇文章的价值。
一、量变:逐行审查撑不住了
过去两年,团队的审查重心已经从「通读每一行 diff」移开。InfoQ 的报道说,现在的审查围绕「这个变更引入的风险」来组织,而不是人类读了多少行代码。合入的变更通常挂在功能开关后面,先在内部测试,再逐步放量给真实用户;事故和被回滚的变更则会进入一个不断增长的评测集,用来衡量和改进自动化审查器。这意味着审查器本身也在被持续训练:线上出过的错,会变成下一次审查的判断依据。
这套做法的前提是量。Boris Cherny 是 Claude Code 的创建者,他的判断是:给 Claude 一个可以运行的验证手段,是把产出质量提升 2 到 3 倍的最大杠杆。验证的形态随领域而变:有时只是一条 bash 命令,有时是一整套测试,有时是把应用放进浏览器或手机模拟器里跑一遍。
二、验证前置:先证明它能跑
大部分审查发生在 PR 出现之前。Claude 写完后先跑测试、构建和 linter,用真实的输出替代「我写完了」这句话;随后一个独立的子智能体在全新上下文里审查 diff,避免写代码的 agent 顺着自己的思路给自己背书。开 PR 之前,团队内部还会跑几个技能:/code-review 抓 bug、/simplify 收敛 diff、/verify 端到端确认行为;UI 变更额外对照设计指南检查,设计规则沉淀在 DESIGN.md 里。如果审查器反复标记同一个问题,团队从源头修:技能本身、lint 规则,或者文档。
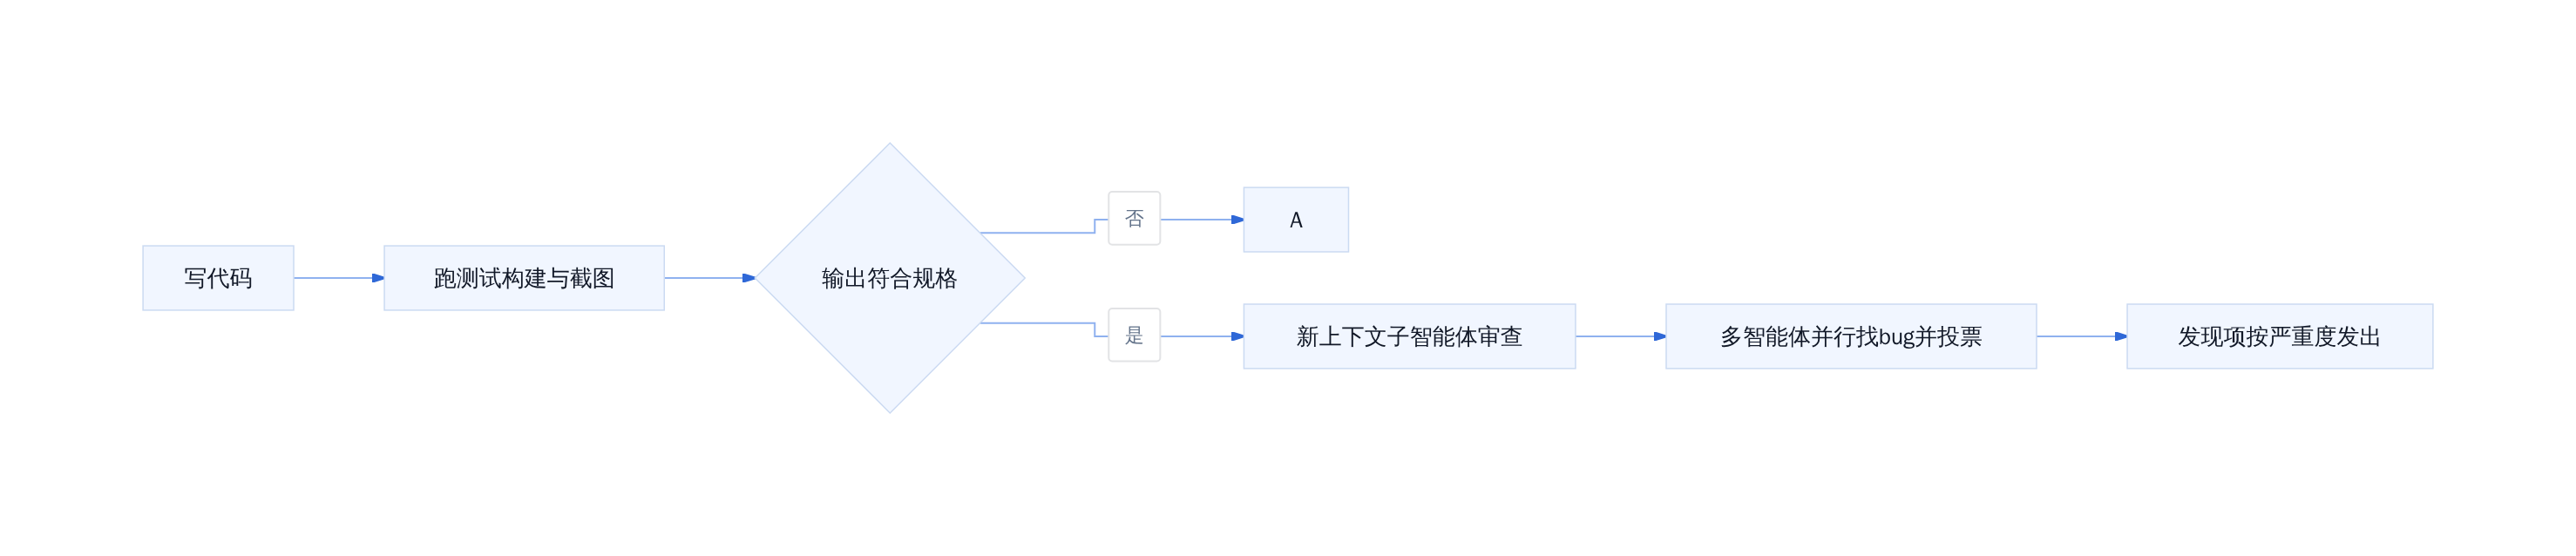
验证循环前移到PR之前
进入 PR 之后,审查器找到的问题先经过另一组智能体投票:足够多的 agent 认为某条发现真实,它才会进入评论区;只涉及风格、诊断或清理的意见被直接丢弃。团队在自家 PR 上做过 A/B 测试,才保留这些过滤规则。每条发现都会被打上 Important、Nit 或 Pre-existing 标签,PR 之前已经存在的问题不会算到当前作者头上。每一条发现都必须得到回应:要么修掉,要么带着理由关闭讨论串。夜里 agent 会接手修复,作者早上回来时,PR 往往已经历了新一轮。安全审查有一票否决权,可以阻断合并。
三、收敛的审查:给AI审AI设上限
agent 审 agent 有一个天然陷阱:它不会自己收敛。人类看到一条吹毛求疵的意见,几秒就能忽略;agent 则会老老实实去改,产生新提交,触发新一轮审查。团队为此设了硬规则:
三轮之后,审查器会主动要求作者跳出局部,重新审视当前实现方案;最初几轮过后,后续审查严格只看新增的增量 diff,不再扫全量;发现同类通病时,要求作者一次性修改所有同类问题;已经发过的审查意见禁止重复提出。
用 git blame 溯源那些被反复指出的意见,团队发现其中约 59% 的代码在审查器第一轮跑完时就已存在。审查器很少是在发现新问题,多数是在翻旧账。这就是 50 多轮拉扯事故的根源:两个 agent 之间可以无限拉扯,流程必须有熔断。
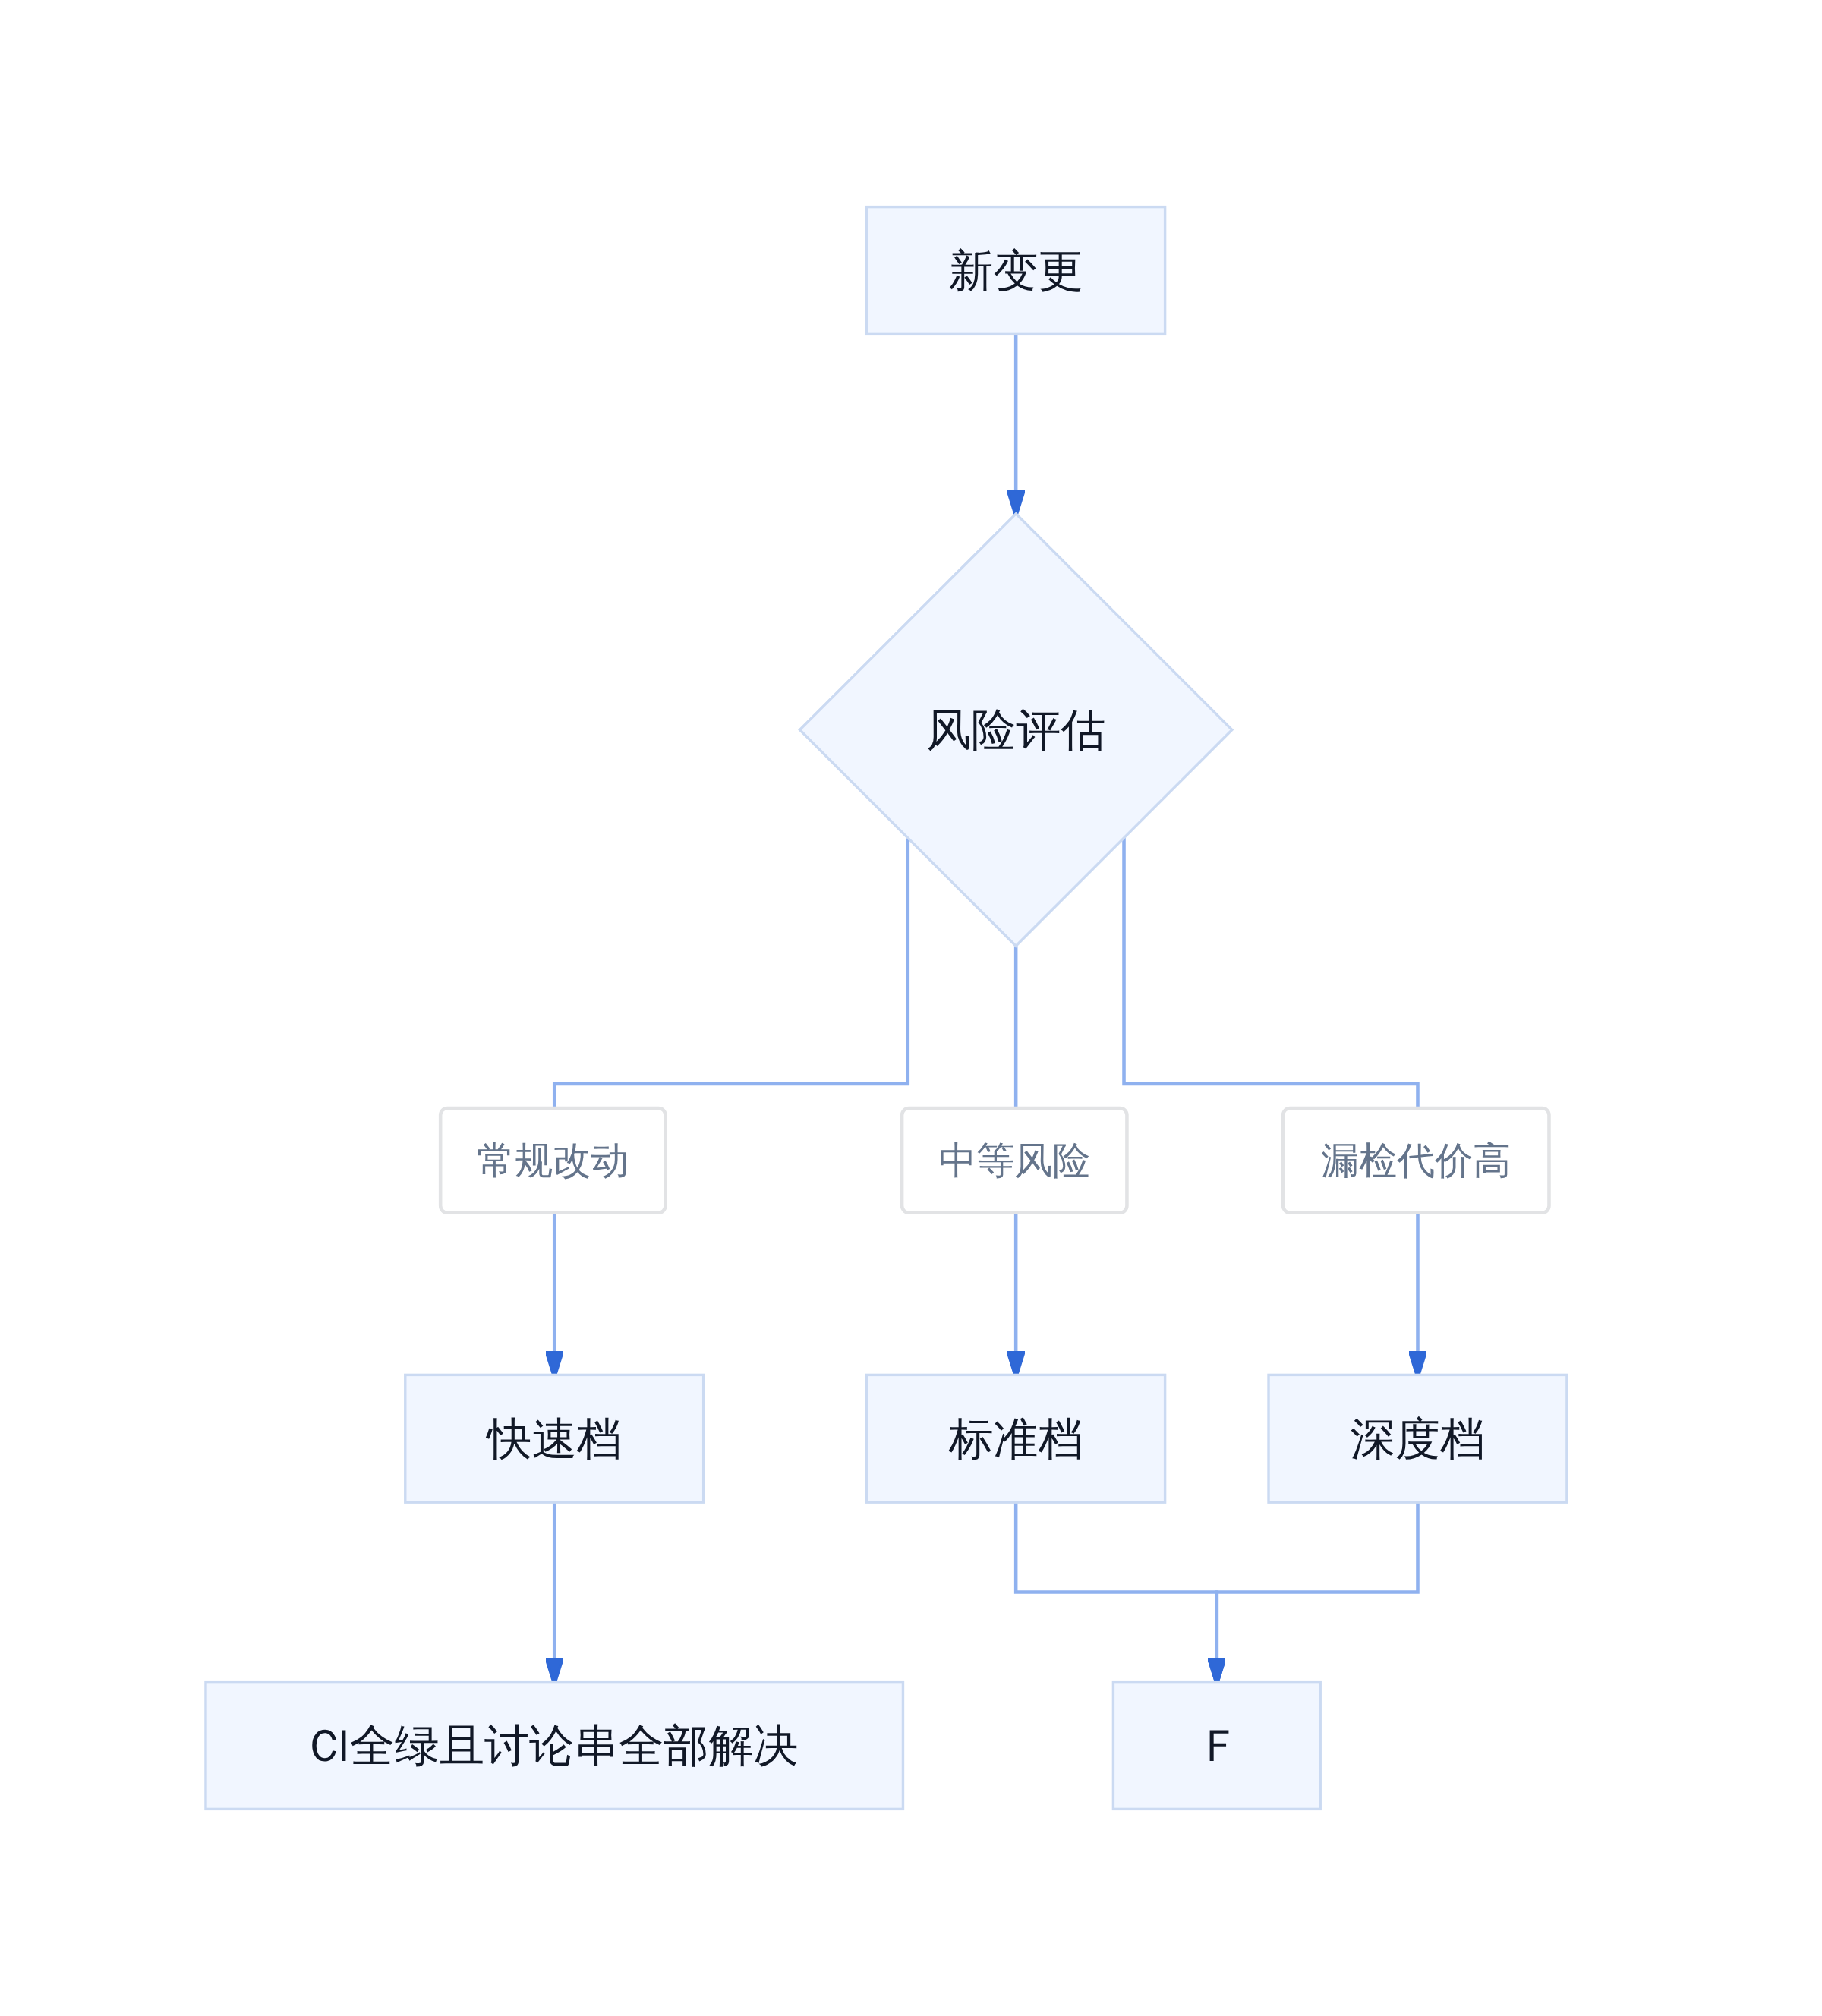
审查强度按风险分三档
审查强度与风险匹配:常规改动走快速档,漏检代价高昂的高危改动走深度档,对应审查工具的快速、标准、深度三档。审查器的噪音同样被当成指标来管:团队对每条评论分类统计人类怎么处理它,也会把审查器放到已知正确的干净 PR 上运行,统计它提出误导性假警报的频率。白纸黑字的原则是:优先捕捉真实 bug,其次才是削减审查轮数。审查 Agent 每天夜间还会扫描存量代码,把旧 bug 挖出来,防止它们蔓延到别处。
四、人必须留在闭环里
自动化越深,人守的边界越清晰。Anthropic 把工作重心从通读 diff 转向了机器不擅长的决策领域,五个位置一个都不能少:
方向与范围。我们真的需要做这个需求吗?哪怕一个自称解决了审查瓶颈的团队,也严格保留对团队外部提交变更的人工审查,让有人守住这道灵魂拷问。
高危敏感代码:计费系统、自动更新程序、CI 核心工作流。这类代码漏检的代价最高,人工深度审查不能省。
架构演进:可能被其他模块竞相效仿的核心模式。一处架构决定会被放大成整个代码库的形状,必须由人来定。
研读验证凭据:测试输出日志、实际执行的命令与返回结果、界面截图、审查器的最终意见。如果你说不清当前自动化检查可能漏掉什么,就应该发起一次全面的人工深度审查,而不是草率批准。
全责。无论代码最初由谁、由什么生成,每个合入发布的变更都必须有一个人类承担全责。
这五个位置划出来之后,人每天花在通读 diff 上的时间可以被大幅压缩,但责任链条没有变:每个合入的变更,背后都有具体的人。
五、你的仓库这周可以做什么
这些做法的零件今天都拿得到,不需要等团队规模到位:
- 在 CLAUDE.md 里列清可独立运行的检查手段,把验证标准写清楚:测试用例、预期输出、截图对比,让 agent 有据可查;再配置自动跑格式化和 lint 的钩子。
- 开 PR 前本地跑 /code-review 与 /security-review,或者发起一次全新独立上下文的子智能体审查。
- 建一份 REVIEW.md,把过往反复出现的人工审查意见归纳沉淀进去,让审查器照着它调优。
- PR 模板加三栏:怎么测、风险多高、怎么回滚;合并前要求 CI 全绿、所有审查讨论串标记为已解决。
- 先在一个仓库试点引入 AI 审查器,打磨几周再向更多仓库推广;轮数设上限,最初几轮之后只审增量 diff。
顺序也很关键:先让验证跑起来,再引入 AI 审查器,最后才谈规模化。团队的经验是,验证做得越前,后面所有的环节都更便宜。Claude Code 团队的经验指向一个结论:当代码主要由机器生产,质量保障的重心从「读代码」移到「设计验证」。谁先把验证做成闭环,谁就能让数十上百个 agent 并行而不失控。
参考文献
- claude.dev 博客:How the Claude Code team does code review
- InfoQ:Anthropic Outlines Its AI-Powered Code Review Process
- 知乎译文:Claude Code 团队是如何进行代码审查的
- Addy Osmani X 帖
- claude.com:How Anthropic teams use Claude Code
延伸入口
- 原文归档:tobemagic.github.io/ai-magician…
- 公众号:计算机魔术师