同一个模型,不同渠道的价格能差几倍到几十倍。最低价不一定最稳,但会筛就能省不少钱。
最近在做一个小项目,需要长期调用大模型 API。翻了几家官方文档和聚合平台之后,发现两个问题:
- 同一个模型,官方价、云厂商价、聚合平台价、套餐价混在一起,很难直接比。
- 免费额度散落在各个文档里,有的按天,有的按月,有的限速。
于是我把公开渠道的价格抓下来,统一换算成「人民币 / 每百万 token」,做了个每天更新的比价站:LLM Rank Hub。
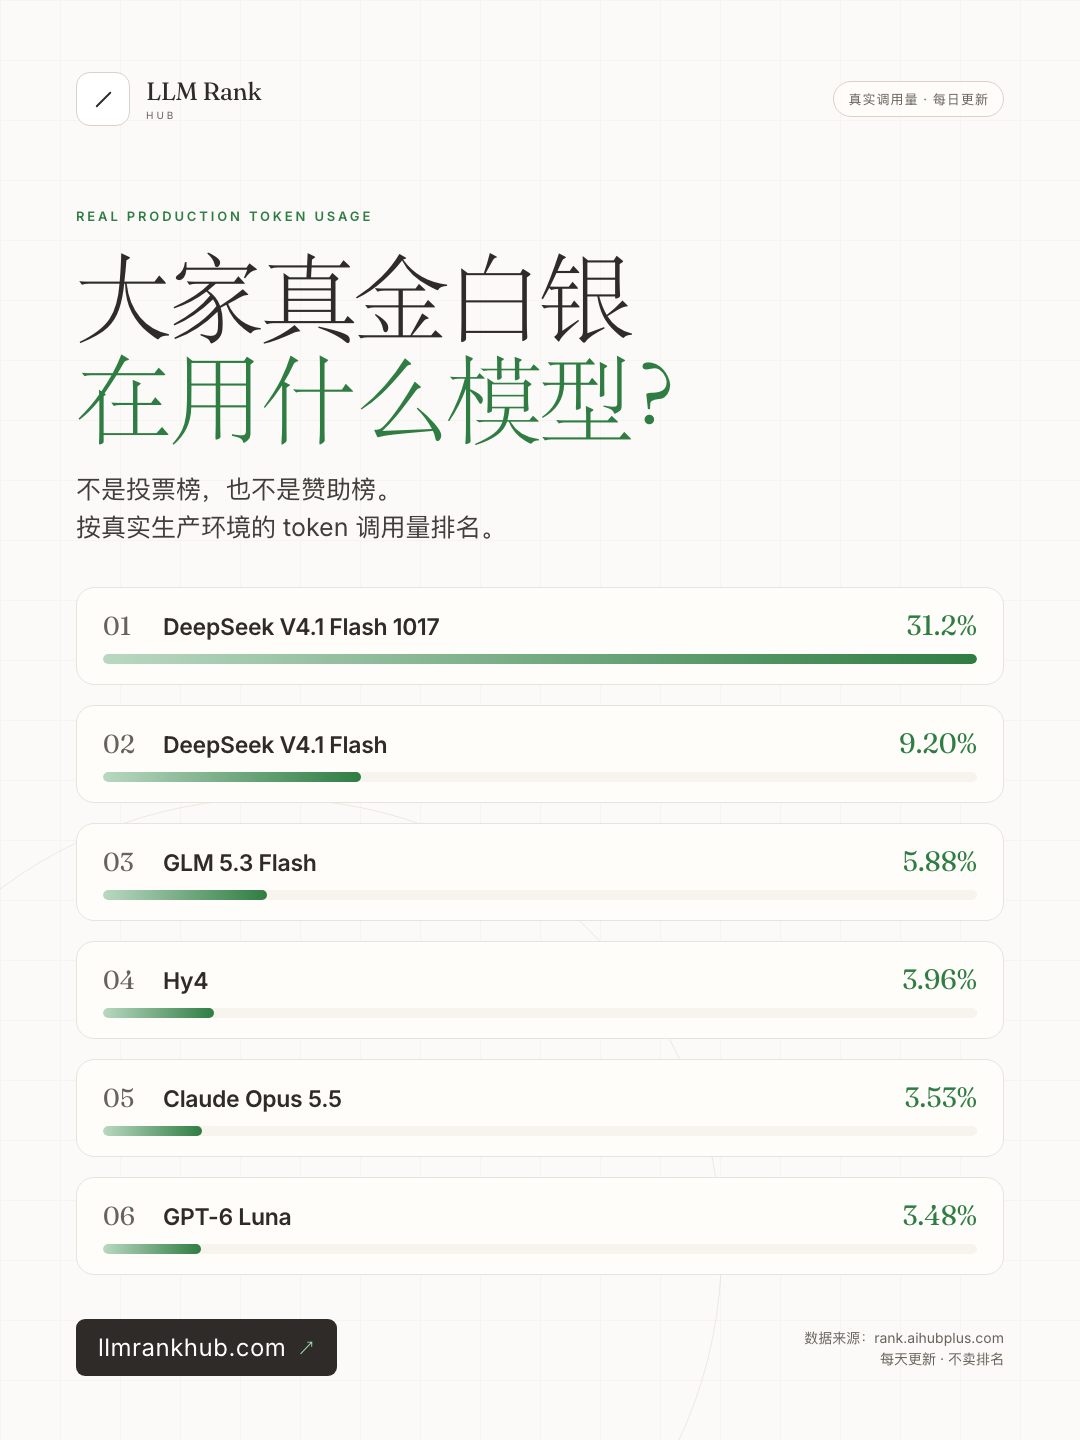
目前收录了 614 个模型、3603 个渠道、130 个免费渠道,还有一个按真实生产 token 调用量排的榜。
数据怎么归一化
比价最难的不是抓数据,而是把不同口径拉到同一张表上。我主要做了这几件事:
- 币种:美元按实时汇率折算成人民币。
- 单位:统一成「每百万 token」,输入、输出、缓存分开列。
- 峰谷价:DeepSeek 这类有高峰/空闲价的,取当前生效价并标注。
- 套餐价:包月套餐折算成每百万 token,但单独标记「套餐」,不和按量计费直接混排。
- 免费额度:记录每日/每月额度、上下文、限速和限制条件。
- 去重:同名渠道、同模型不同区域、同一家的不同套餐,都要合并或拆分清楚。
价差有多大
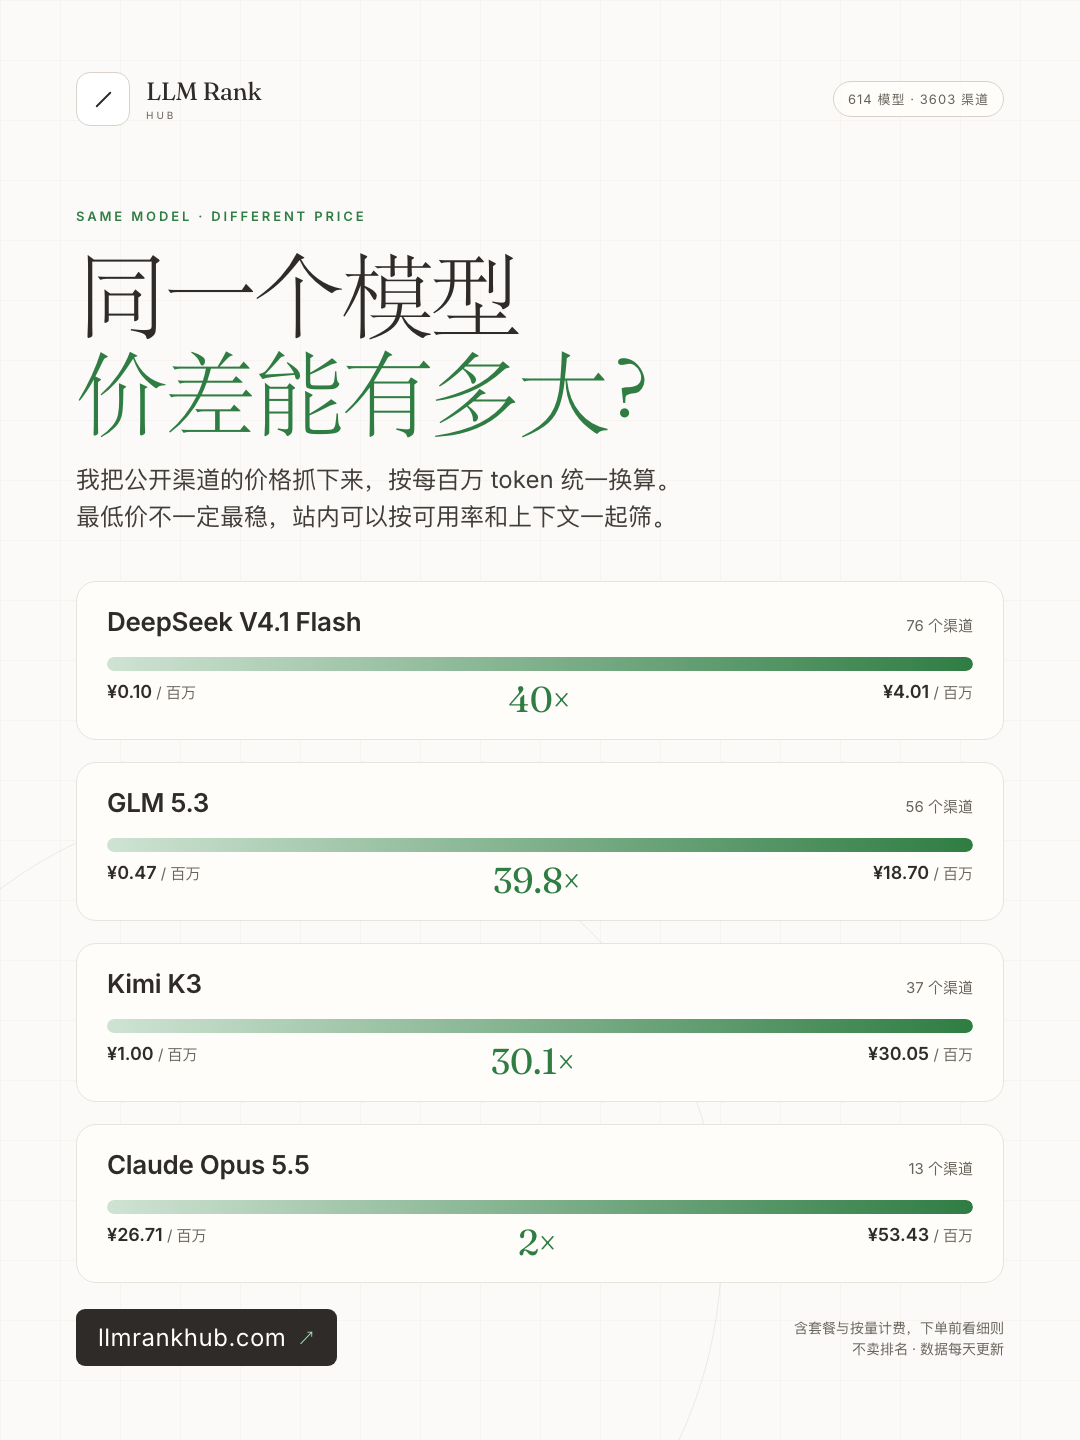
先看几个例子(都含套餐/按量计费,具体以下单页为准):
| 模型 | 渠道数 | 输入价(¥/百万 token) | 最高/最低 |
|---|---|---|---|
| DeepSeek V4.1 Flash | 76 | 0.10–4.01 | 40× |
| GLM 5.3 | 56 | 0.47–18.70 | 39.8× |
| Kimi K3 | 37 | 1.00–30.05 | 30.1× |
| Claude Opus 5.5 | 13 | 26.71–53.43 | 2× |
看到这里,很多人的第一反应是「那我选最低价不就行了」。但实际选型不能只看价格。
我一般按这三步选
第一步:先看免费额度
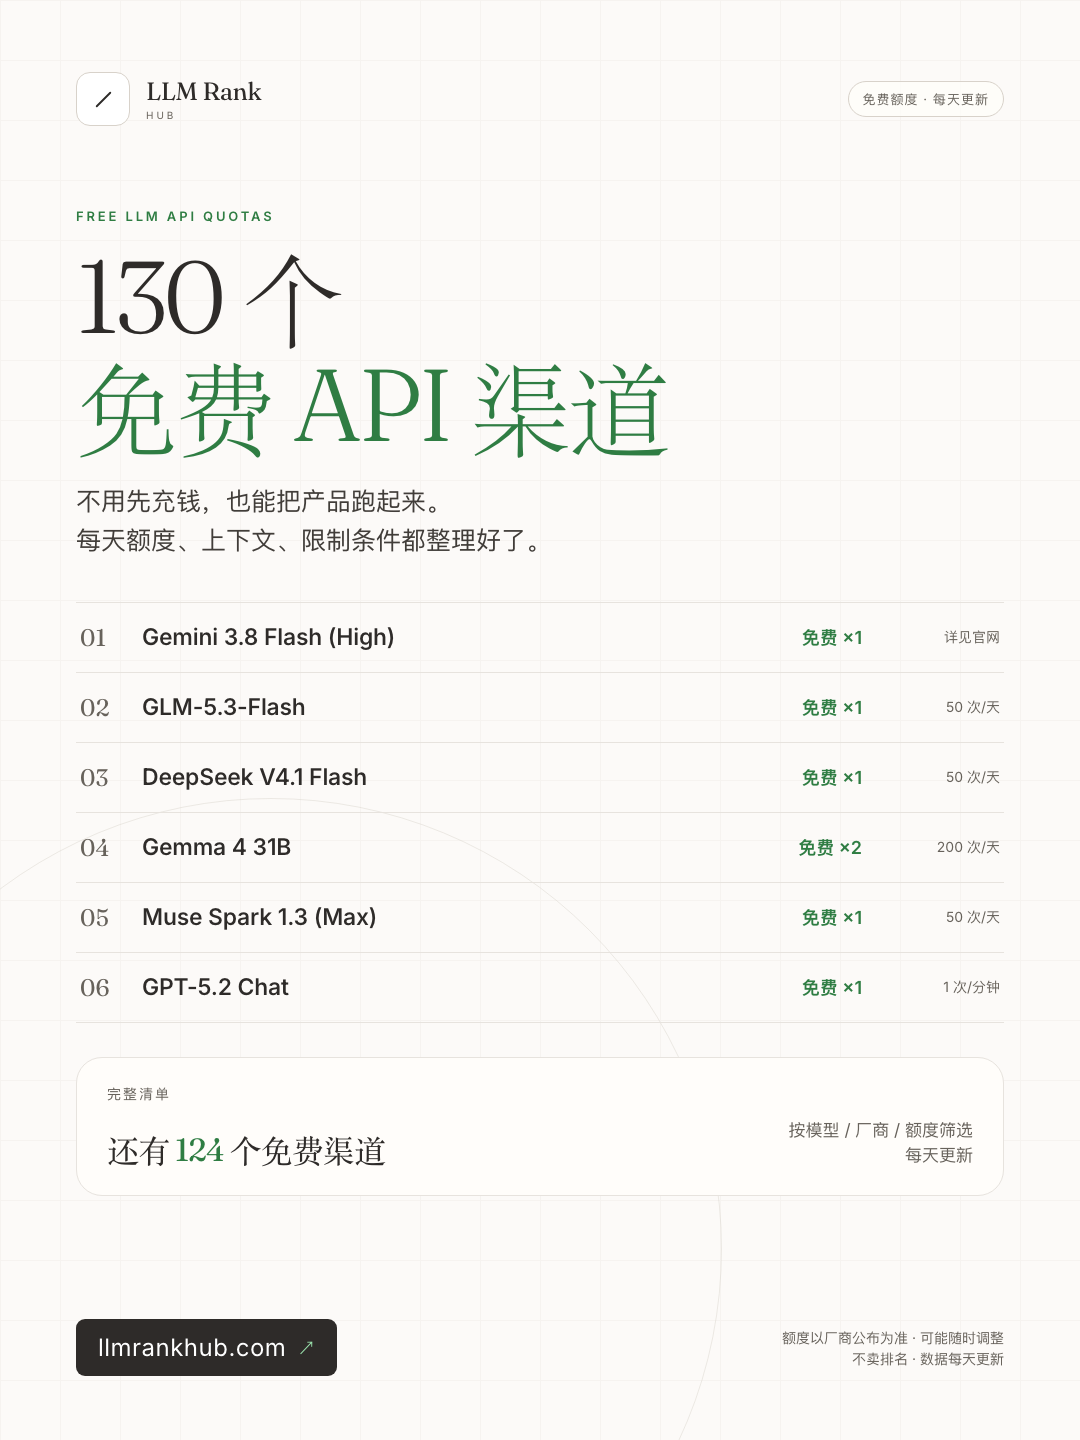
如果你只是做原型、写 demo、跑小流量,优先用免费渠道。站里整理了 130 个免费渠道,标了每日额度、上下文和限制。比如 Gemini 3.8 Flash、GLM-5.3-Flash、DeepSeek V4.1 Flash、Gemma 4 31B 都有免费额度,适合先跑通。
第二步:再算按量成本
把输入价、输出价、缓存价、峰谷价都拉平到「每百万 token」。很多渠道看起来输入价很低,但输出价很高;或者低价只适用于缓存命中。真正要算的是你的业务 mix:输入多少、输出多少、缓存命中率多少。
第三步:最后看稳定性
最低价往往来自小渠道,可用率、上下文、限速、是否官方都需要确认。站里可以按可用率和上下文筛,不要只按价格排序。
踩过的坑
- 同名模型:不同厂商、不同版本、不同精度,名字很像,价格差很多。
- 重复渠道:同一个渠道在多个来源出现,价格却不一样。
- 价格过期:抓取时是低价,下单时已经涨了。
- 套餐陷阱:¥0.1/百万 token 可能是包月套餐折算,用不满就不划算。
- 免费额度变化:有的按天、有的按月,有的限速,有的只对特定模型开放。
- 可用率:最低价渠道不一定稳定,生产环境要把可用率纳入决策。
除了比价,还有三个功能
- 闲置 token 交易:手里的 API 额度用不完,可以挂到额度市场;需要额度的人可以直接买。入口在站内左侧「额度市场」:打开 LLM Rank Hub
- Token 计算器:把自己的 Key 接进来,按真实请求算 token、缓存命中、延迟和成本:查看 Token 计算器
- SmartWork:Mac 上的 AI 工作搭子,读写本地文件、执行命令、整理 diff,模型统一走 LLM Rank Hub 网关:了解 SmartWork
免费额度可以直接看这里:130 个免费 API 渠道。
最后
我为什么做这个站?因为我自己每次选 API 都要开好几个标签页,而且价格经常变。做成每天更新的表之后,至少能先筛掉一批明显不合适的渠道,再去官方页确认。
如果你也在选 API,可以去看看:
不卖排名,不放赞助榜,数据来源和口径都写在关于页。最近还在补模型和渠道,欢迎在评论区告诉我缺了谁。
最后提醒一句:比价只是第一步,真正省钱的是「选对模型 + 控制上下文 + 提高缓存命中率」。别为了省一点单价,把工程成本搭进去。