200,000 行数据,每页 20 条,翻到第 10,000 页,OFFSET 分页要扫描 200,000 行,游标分页只扫 20 行。
我把两种分页放进同一个网页,边翻页边插入新数据,跑了一遍。
结果很直接:OFFSET 翻 15 页出现 42 行重复、42 行漏掉;游标分页 0 重复、0 漏。
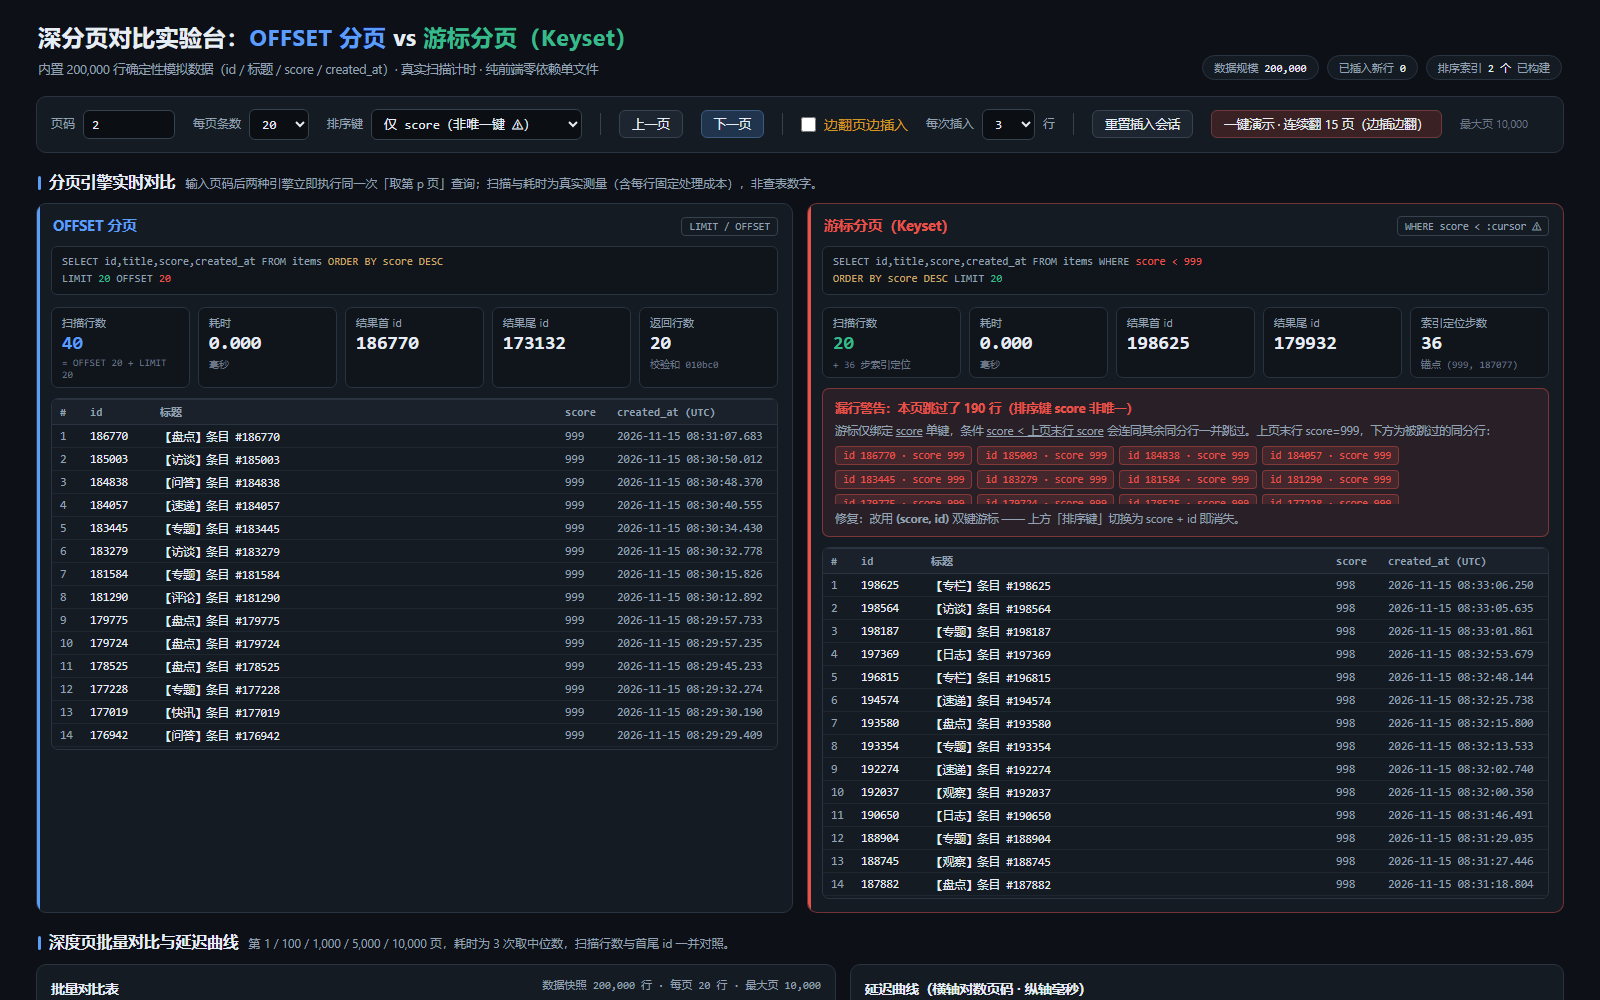
单键游标又是另一回事,第 2 页一次跳过 190 行同分数据。
这不是 MySQL 压测,是一个能亲手点、数字能当场复算的分页实验台。
一、为什么值得看:翻到深页,数据库在替你做无用功
LIMIT 20 OFFSET 99980 读起来像只取 20 行。
数据库实际要先数过前面 99,980 行,再把它们丢掉。
页越深,白扫的行越多,这就是深分页。
游标分页换了个问法:上一页最后一行是谁?
下一页从那一行后面接着取,不再从第 1 行数起。
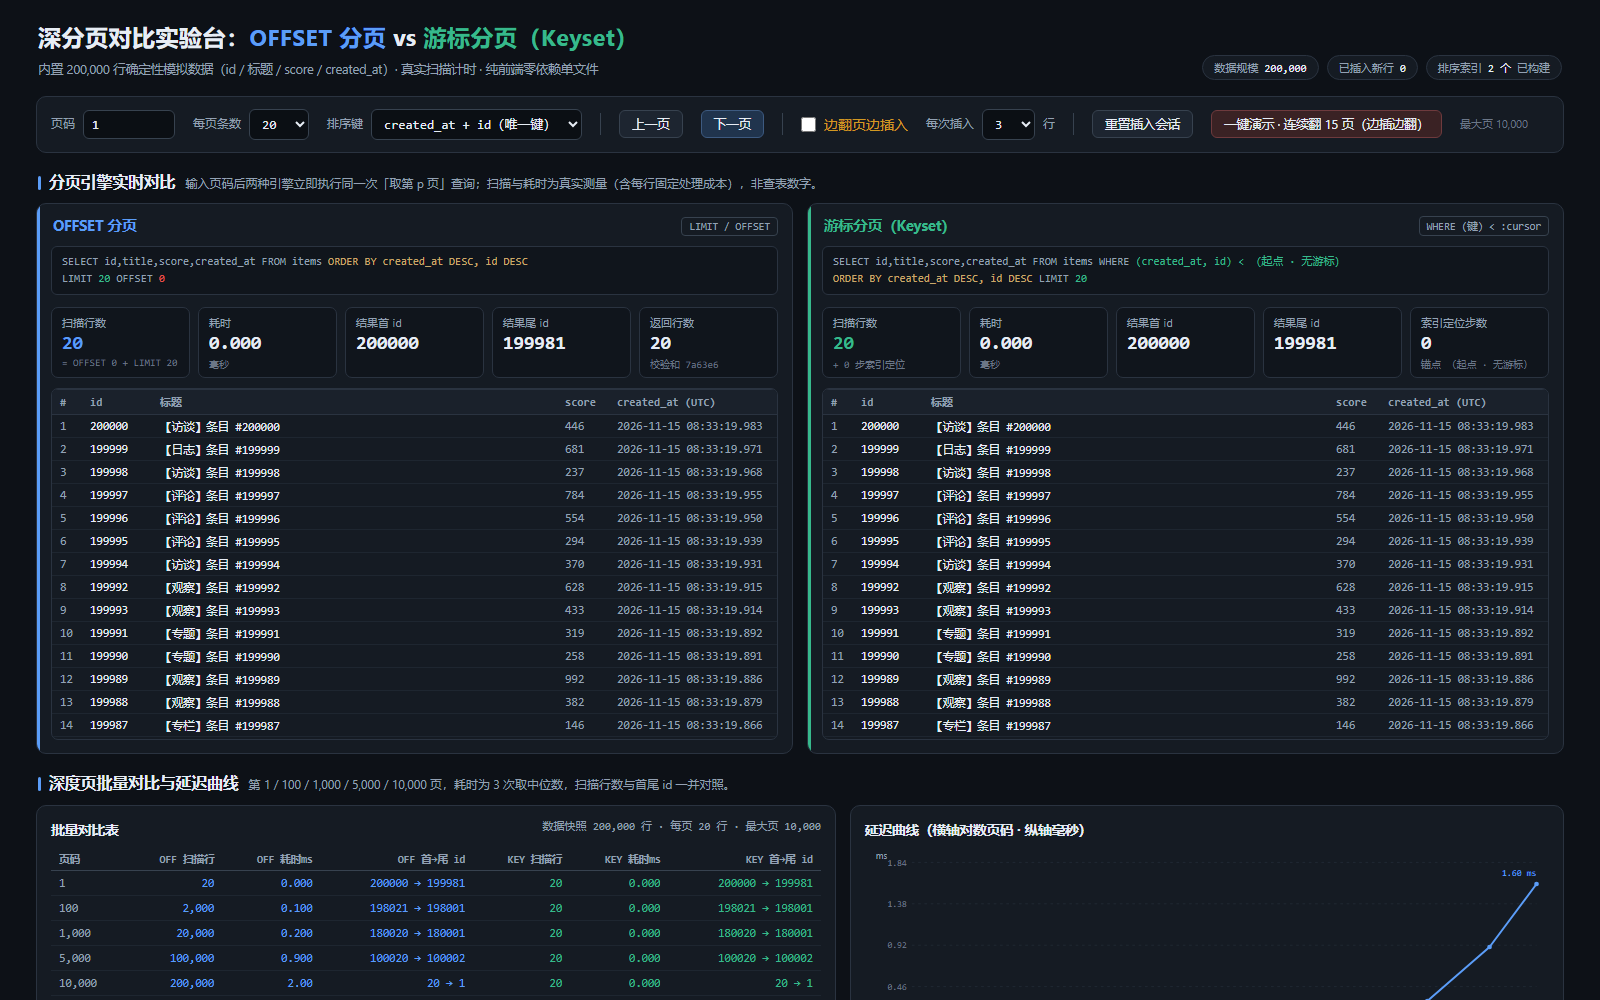
我把页码从 1 拉到 5,000,OFFSET 的扫描行数从 20 涨到 100,000,游标仍然是 20。
图 1:第 1 页,两种分页都只扫 20 行,结果完全一样。
二、为什么我不只看耗时:扫描行数、耗时、结果对不对
只看毫秒不够。
浏览器里的 200,000 行是内存数组,扫 100,000 行只要 1 毫秒出头。
真实数据库还要读磁盘、走网络、经过优化器,深页往往慢得多。
所以我同时记三个数:扫描行数、耗时、返回的首尾 id。
前两个看成本,第三个看结果有没有跑偏。
表 1:同一份数据,五种页深的对照。
| 页码 | OFFSET 扫描行 | OFFSET 耗时 | 游标扫描行 | 游标耗时 |
|---|---|---|---|---|
| 1 | 20 | 0.000 ms | 20 | 0.000 ms |
| 100 | 2,000 | 0.000 ms | 20 | 0.000 ms |
| 1,000 | 20,000 | 0.200 ms | 20 | 0.000 ms |
| 5,000 | 100,000 | 1.00 ms | 20 | 0.000 ms |
| 10,000 | 200,000 | 1.90 ms | 20 | 0.000 ms |
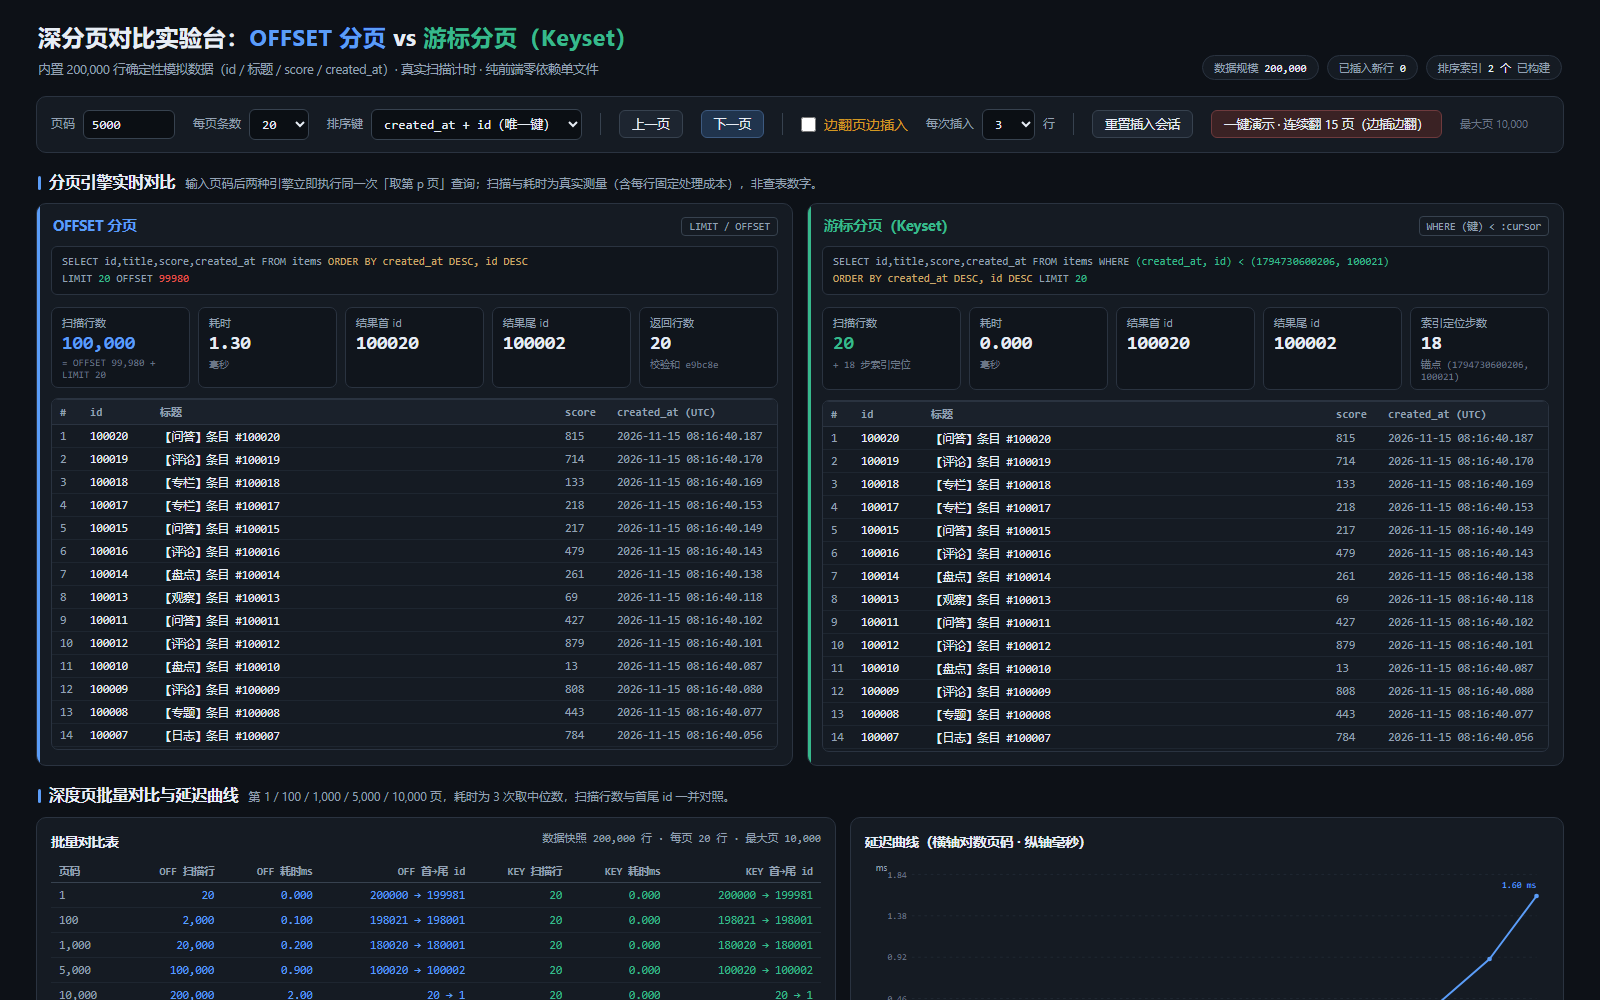
第 10,000 页是最后一页,OFFSET 是 199,980,加 LIMIT 20 正好 200,000。
两种分页都返回 20 行,id 从 20 到 1,没有空页。
区别在过程:一个扫完整张表,一个只走 18 步索引定位再取 20 行。
图 2:第 5,000 页,OFFSET 扫描 100,000 行,游标扫描 20 行。
三、怎么做:把两种分页放进一个页面
页面内置 200,000 行确定性数据,字段是 id、标题、score、created_at。
创建时间按降序排,id 参与组合键,保证排序键唯一。
OFFSET 引擎按位置切片,扫描行数就是 offset 加 limit。
游标引擎先二分找到上一页末行的位置,再顺序取 20 行。
我把每页条数做成 10、20、50、100 四档,页码可以直接输入。
页面右侧还有一条延迟曲线,横轴是页码,纵轴是毫秒。
曲线抬头的那个点,就是 OFFSET 开始明显变慢的地方。
四、验证与踩坑:边翻页边插入,OFFSET 重复了 42 行
我打开“边翻页边插入”,每翻一页前插入 3 行新数据。
新数据排在最前面,会把旧数据整体往后推。
OFFSET 按位置取数,位置一移,上一页看过的行又出现在下一页。
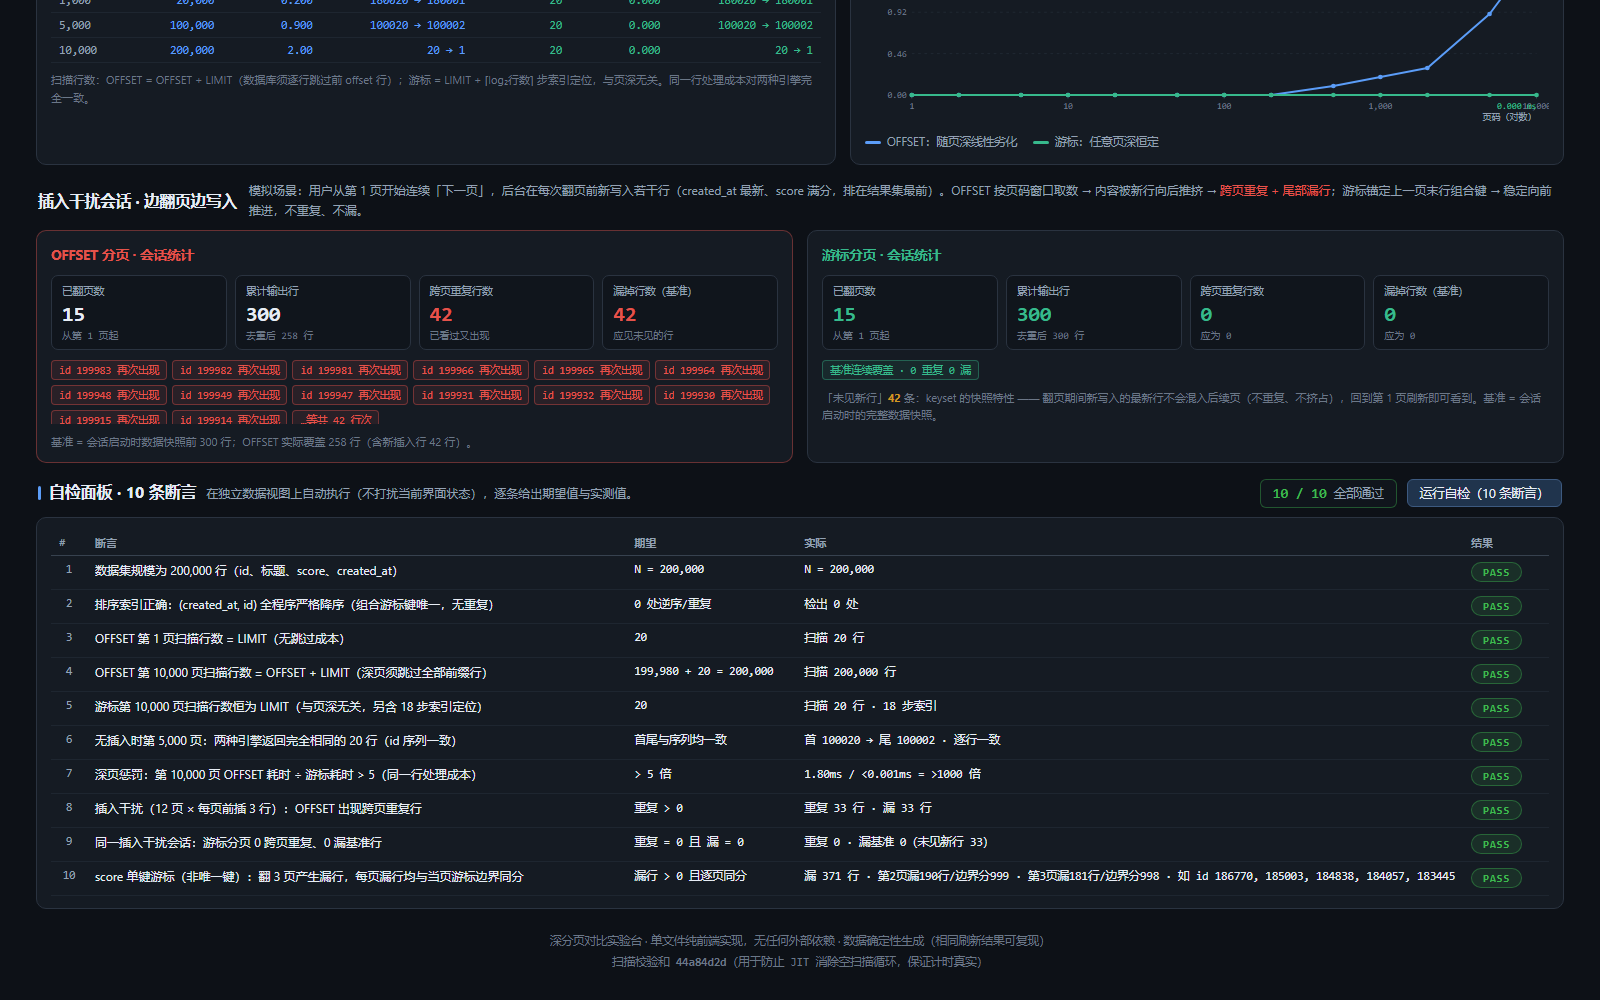
15 页翻完,OFFSET 输出了 300 行,其中 42 行重复、42 行基准数据没被看到。
游标拿的是上一页末行的键,新数据插在最前面也不影响它往后走。
同一组操作,游标 0 重复、0 漏,42 行新数据也如实出现在后续页里。
表 2:同一场插入会话的对照。
| 指标 | OFFSET 分页 | 游标分页 |
|---|---|---|
| 已翻页数 | 15 | 15 |
| 累计输出行 | 300 | 300 |
| 跨页重复行 | 42 | 0 |
| 漏掉基准行 | 42 | 0 |
| 看到新插入行 | 42 | 42 |
图 3:插入会话统计,左侧 42 重复、42 漏,右侧 0 重复、0 漏。
这里的 42 不是巧合。
每页插 3 行,15 页就是 45 次插入机会,实际池里多了 42 行。
重复和漏掉的数量相同,因为新行把旧行往后推,推出去多少就重复多少。
五、失败路径:单键游标漏了 190 行
游标分页也不是无脑正确。
我把排序键切到“仅 score”,分数只有 0 到 999,重复值很多。
第 2 页的游标只带 score=999,SQL 条件写成 score < 999。
所有 score=999 的行会被一起跳过,不只是上一页最后那一行。
页面当场给出漏行警告:本页跳过了 190 行,并列出被跳过的 id。
表 3:第 2 页,两种分页返回了不同的行。
| 分页 | 返回首 id | 返回尾 id | 本页跳过 |
|---|---|---|---|
| OFFSET | 186770 | 173132 | 0 |
| 单键游标 | 198625 | 179932 | 190 |
图 4:单键游标的漏行警告,190 个同分 id 被跳过,右侧从 score=998 开始。
修法不复杂:游标带上 id,改成 (score, id) 双键。
切回“score + id”后,同样的第 2 页不再漏行。
如果业务排序键本身唯一,单键游标可以工作;不唯一就必须补第二键。
六、真实 bug:演示页把“跳过”的行又显示出来了
第一版页面有一个逻辑 bug,我是在看截图时发现的。
警告说“本页跳过了 42 行”,但右侧表格第一行就是 48422,而 48422 正好在警告列表里。
同一行既被跳过又被返回,说明演示本身算错了。
根因在 queryKeyset。
代码先用 (score, id) 双键找到 r1.pos,又用单键 score < ? 找到 r2.pos。
单键模式应该从 r2.pos 开始取数,第一版却把 posT 设成了 r1.pos。
于是 [r1.pos, r2.pos) 这段本该跳过的行,又被 scanFrom 取了回来。
修复只有一行:单键模式 posT = r2.pos,跳过集合取 [r1.pos, r2.pos);双键模式仍然用 r1.pos。
修完后第 2 页 OFFSET 首行是 186770,游标首行是 198625,警告里的 190 个 id 不再出现在右侧表格。
自检第 10 条也从 FAIL 回到 PASS。
顺手还修了一个显示 bug。
自检里用 1 微秒做除法下限,1.60ms / 0.000ms 被打印成 1700000 倍。
计时没有错,是展示错了;现在显示成 1.60ms / <0.001ms = >1000 倍。
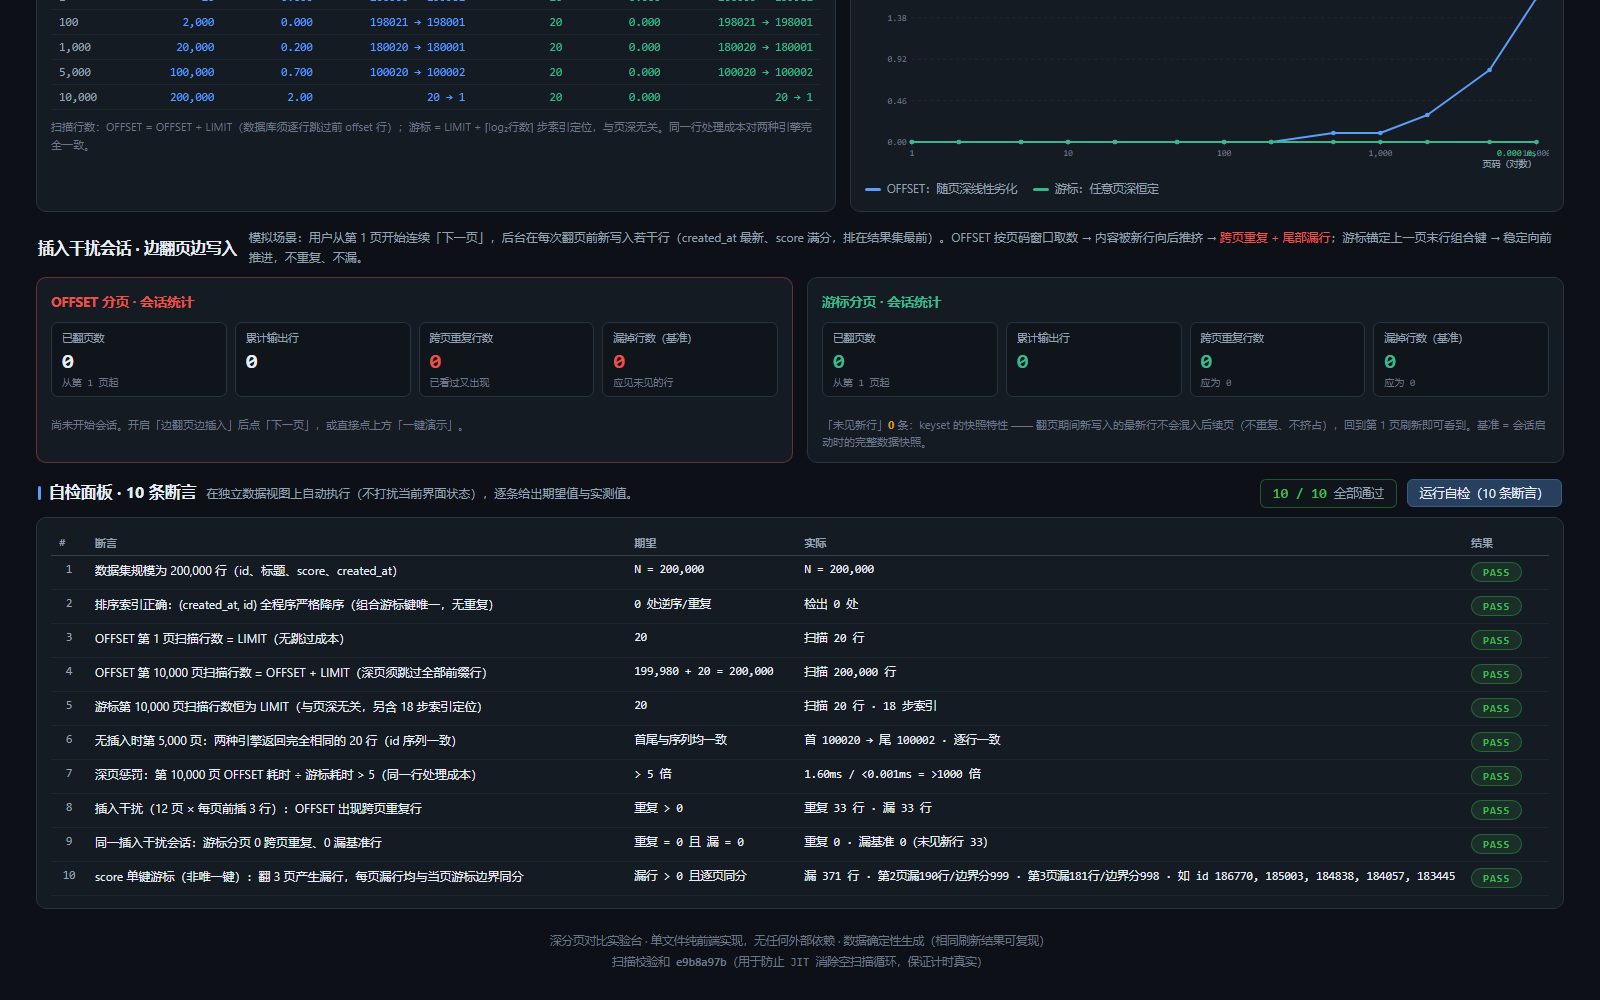
七、自检 10/10:每条断言都能当场复跑
页面底部有 10 条断言,点一下按钮就跑。
我跑完是 10/10 通过。
断言覆盖数据集规模、排序索引是否严格递减、第 1 页和第 10,000 页的扫描行数、两种引擎结果是否逐行一致、插入后的重复与漏行、单键游标是否漏同分行。
第 7 条用三次取中位数,比较第 10,000 页的 OFFSET 和游标耗时。
第 8 条固定 12 页、每页前插 3 行,要求 OFFSET 重复大于 0。
第 9 条要求同一会话里游标 0 重复、0 漏。
第 10 条翻 3 页,要求每页漏掉的行都和当页游标边界同分。
图 5:10 条断言全部 PASS,实际值写在表格里。
八、准备环境:打开码道 Web
这个页面是码道 WebUI 生成的,我在上面改了两处逻辑。
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source…,登录后直接在对话窗口输入需求。
九、本地复现:三步验证
第一步,拿到文件。
git clone https://gitcode.com/OPCTeam/demo_park.git
cd demo_park/codearts-deep-pagination-lab
第二步,起一个本地静态服务。
python -m http.server 8000
浏览器打开 http://localhost:8000,或者直接双击 index.html。
页面没有外部依赖,CSS 和 JS 都在同一个文件里。
第三步,按顺序点三下。
先把页码输成 5000,看左边扫描 100,000 行、右边扫描 20 行,首尾 id 是否一致。
再打开“边翻页边插入”,点“一键演示”,看左边重复和漏行是否都大于 0,右边是否都是 0。
最后把排序键切到“仅 score”,翻到第 2 页,必须看到 190 行漏行警告;没有警告就是失败路径没生效。
自检面板应该显示 10/10 通过。
十、使用码道体会:把“生成”变成“验收”
这轮下来,码道负责把页面写出来,验收还是得自己盯。
我整理了几条能迁移的做法。
- 把验收条件写进需求:页码、每页条数、要显示的指标、失败路径、自检条数。
- 让页面自己报数:扫描行数、耗时、首尾 id、重复和漏行都显示在界面上。
- 用真实浏览器点一遍,不以“生成完成”作为完成。
- 失败路径单独做:单键游标、边插边翻、非法输入,都要有明确提示。
- 同一页两种引擎必须逐行一致,不一致就是 bug,不是“正常波动”。
- 修 bug 先定位到一行代码,再改,再跑同一组断言。
- 文章只写自己点过、看过的数字。
十一、结果与下一步
如果你的场景是列表、Feed、无限滚动,游标分页更合适。
它不关心前面有多少行,翻到多深都是取 20 行。
如果后台必须显示总页数、支持跳到任意页,OFFSET 仍然有位置。
但要给深页设上限,或者用覆盖索引、延迟关联把回表成本压下去。
排序键不唯一时,游标必须带第二键,通常是 id。
只带一个 score,就会复现第 5 节那 190 行漏行。
下一步我想把同一组查询接到真实 MySQL 的慢查询日志上,看看内存模拟和磁盘查询差多少。
十二、直接下载试玩
本案例目录:gitcode.com/OPCTeam/dem…
一个 index.html,没有构建步骤,也没有第三方依赖。
附:完整需求
做一个单文件网页应用「深分页对比实验台」:左边是 OFFSET 分页,右边是游标分页(keyset),内置 20 万行模拟数据(id、标题、score、created_at),可以输入页码和每页条数,实时显示两种分页各自扫描的行数、耗时、结果首尾 id;提供第 1/100/1000/5000/10000 页的批量对比表和延迟曲线;加一个「边翻页边插入」开关,模拟翻页时新数据插入导致 OFFSET 分页重复和漏项,统计重复行数和漏掉行数;再做一个游标分页失败路径:只按 score 排序(不唯一)时展示漏行警告和具体漏了哪些 id;页面底部要有自检面板,跑 10 条断言并显示 PASS/FAIL;所有 CSS/JS 内联、无外部依赖、中文界面,布局适合 1600×1000 截图。