一个页面 12 个请求,浏览器对同一域名只开 6 条连接。
第 7 个请求不是发不出去,是要等前面的连接空出来。
我把这场排队做成了可交互的时间线。
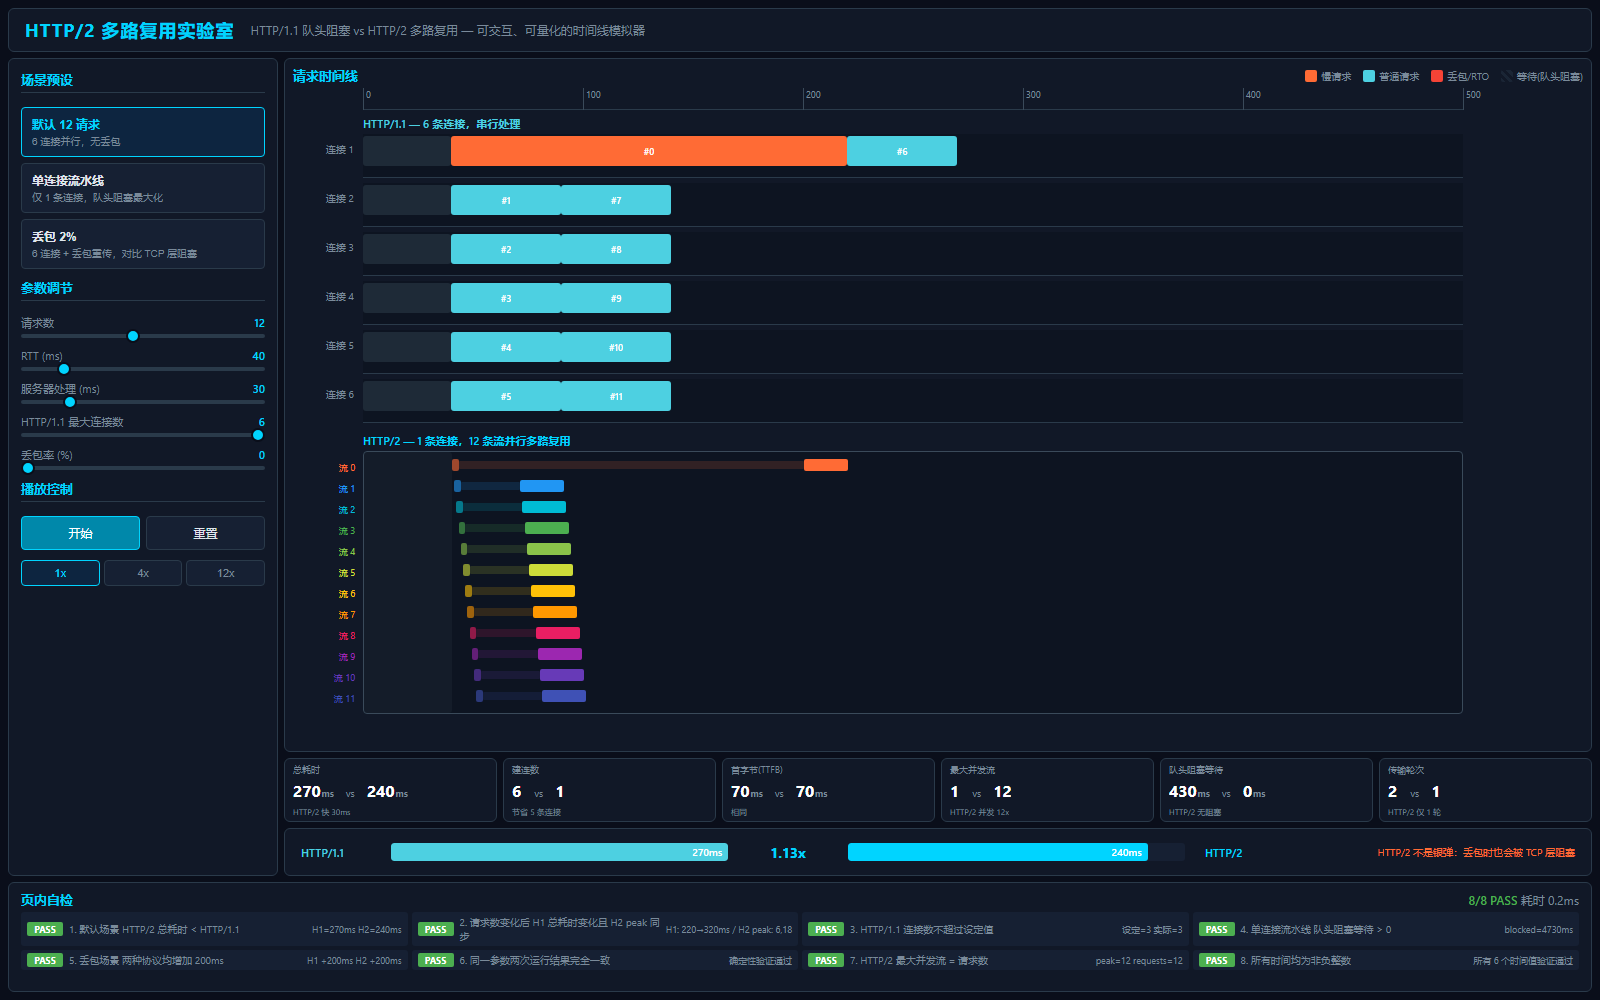
同一组参数,HTTP/1.1 跑 270ms,HTTP/2 跑 240ms。
差距只有 30ms,因为 12 个请求分到 6 条连接,只排了两轮。
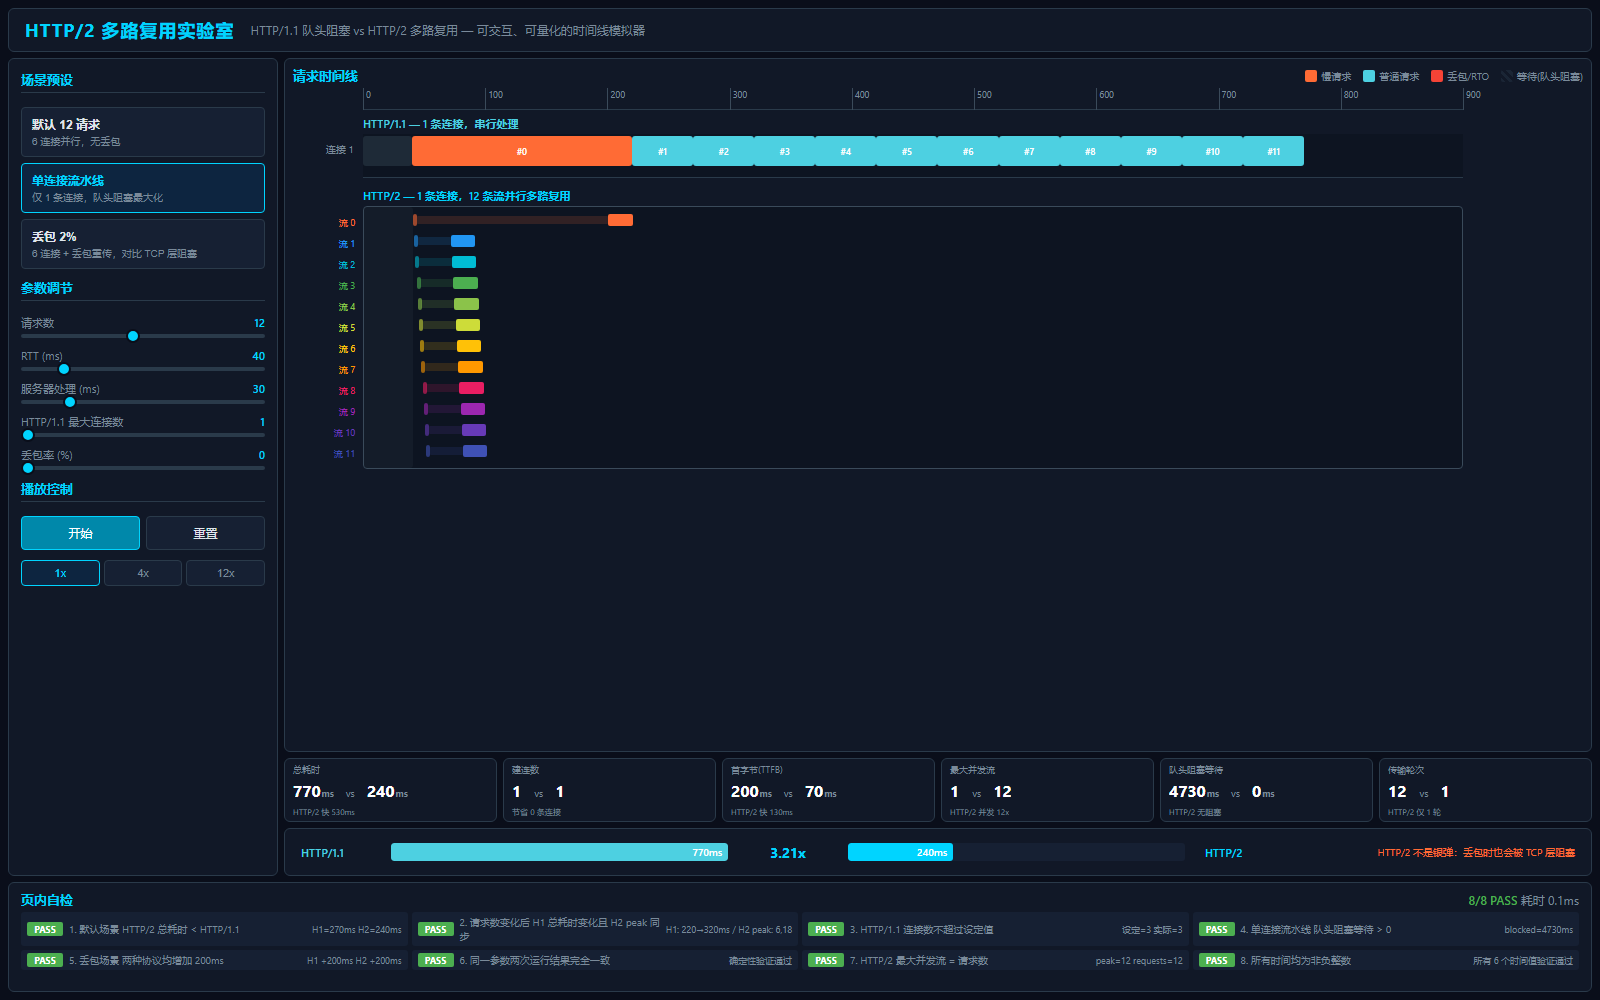
换成单连接流水线,数字变成 770ms 对 240ms。
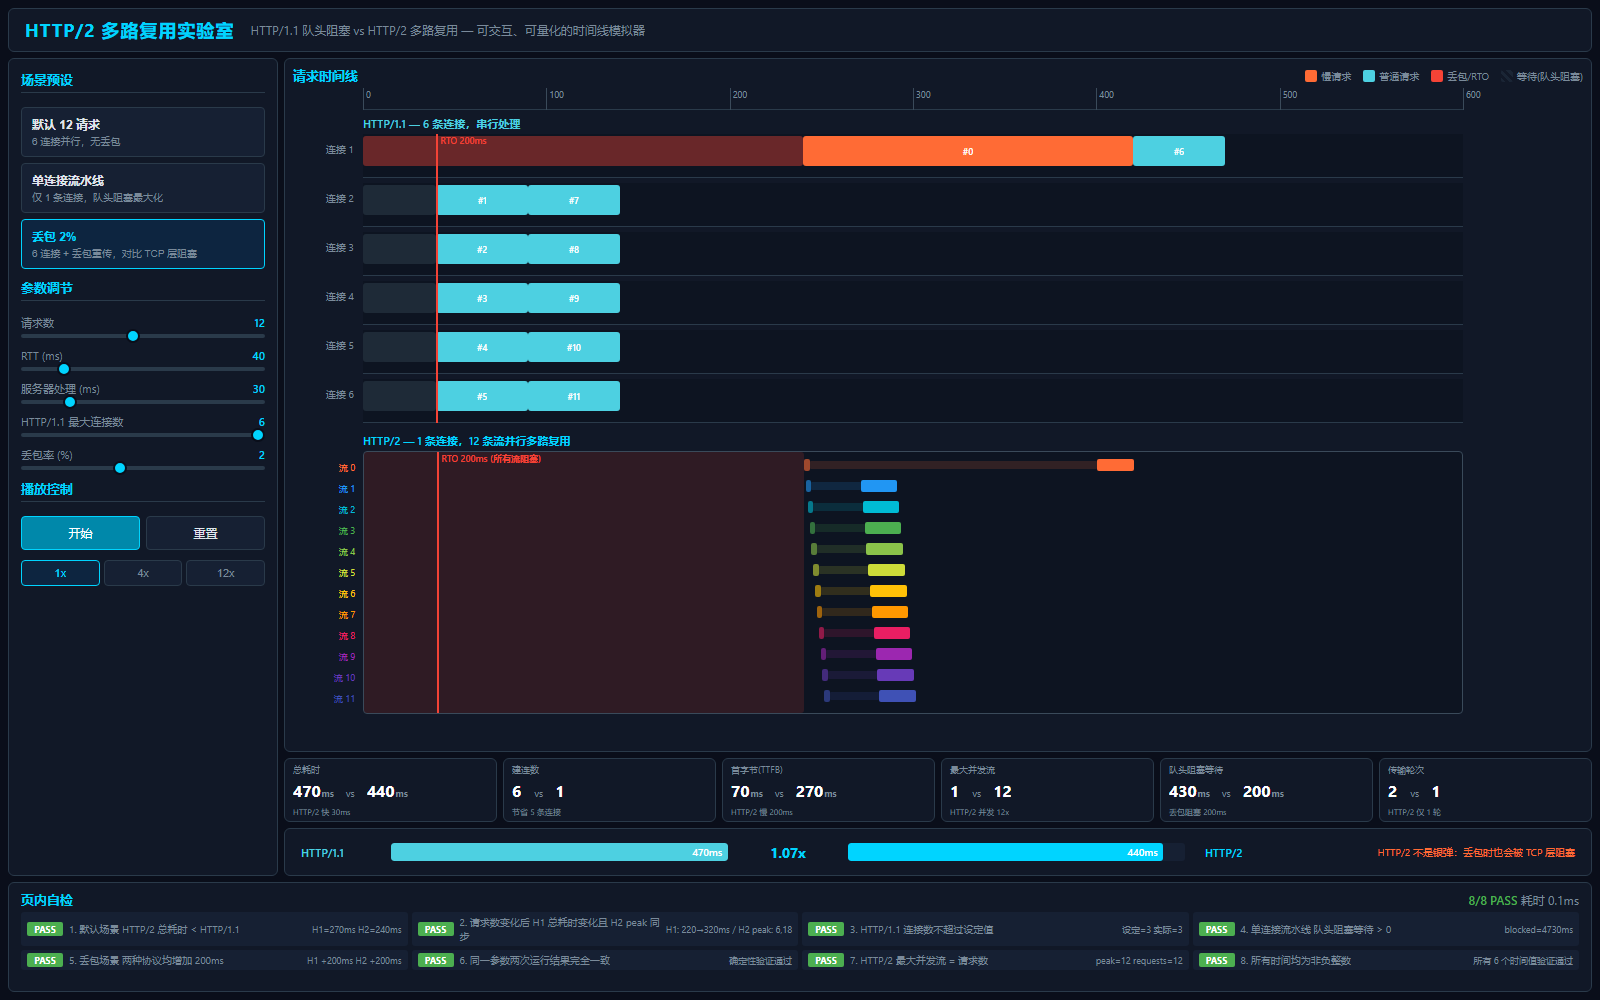
再给 2% 丢包,HTTP/2 的 12 条流会一起停 200ms,优势缩到 1.07 倍。
多路复用搬走的是 HTTP 层的队头阻塞,不是 TCP 层的。
公开仓库在 Demo Park,单个 index.html,双击就能开。
页内自检 8/8 PASS,五个场景都能用同一套公式复算。
一、为什么值得看:五组数字先摆出来
所有场景都用同一套参数:建连 1 个 RTT,普通请求服务 50ms,第 1 个请求是 180ms 的慢请求。
| 场景 | HTTP/1.1 | HTTP/2 | 加速比 | HTTP/1.1 阻塞等待 |
|---|---|---|---|---|
| 默认 12 请求,6 连接,RTT 40ms | 270ms | 240ms | 1.13x | 430ms |
| 单连接流水线,12 请求 | 770ms | 240ms | 3.21x | 4730ms |
| 丢包 2%,6 连接 | 470ms | 440ms | 1.07x | 430ms |
| 24 请求,2 连接,RTT 80ms | 1140ms | 280ms | 4.07x | 11660ms |
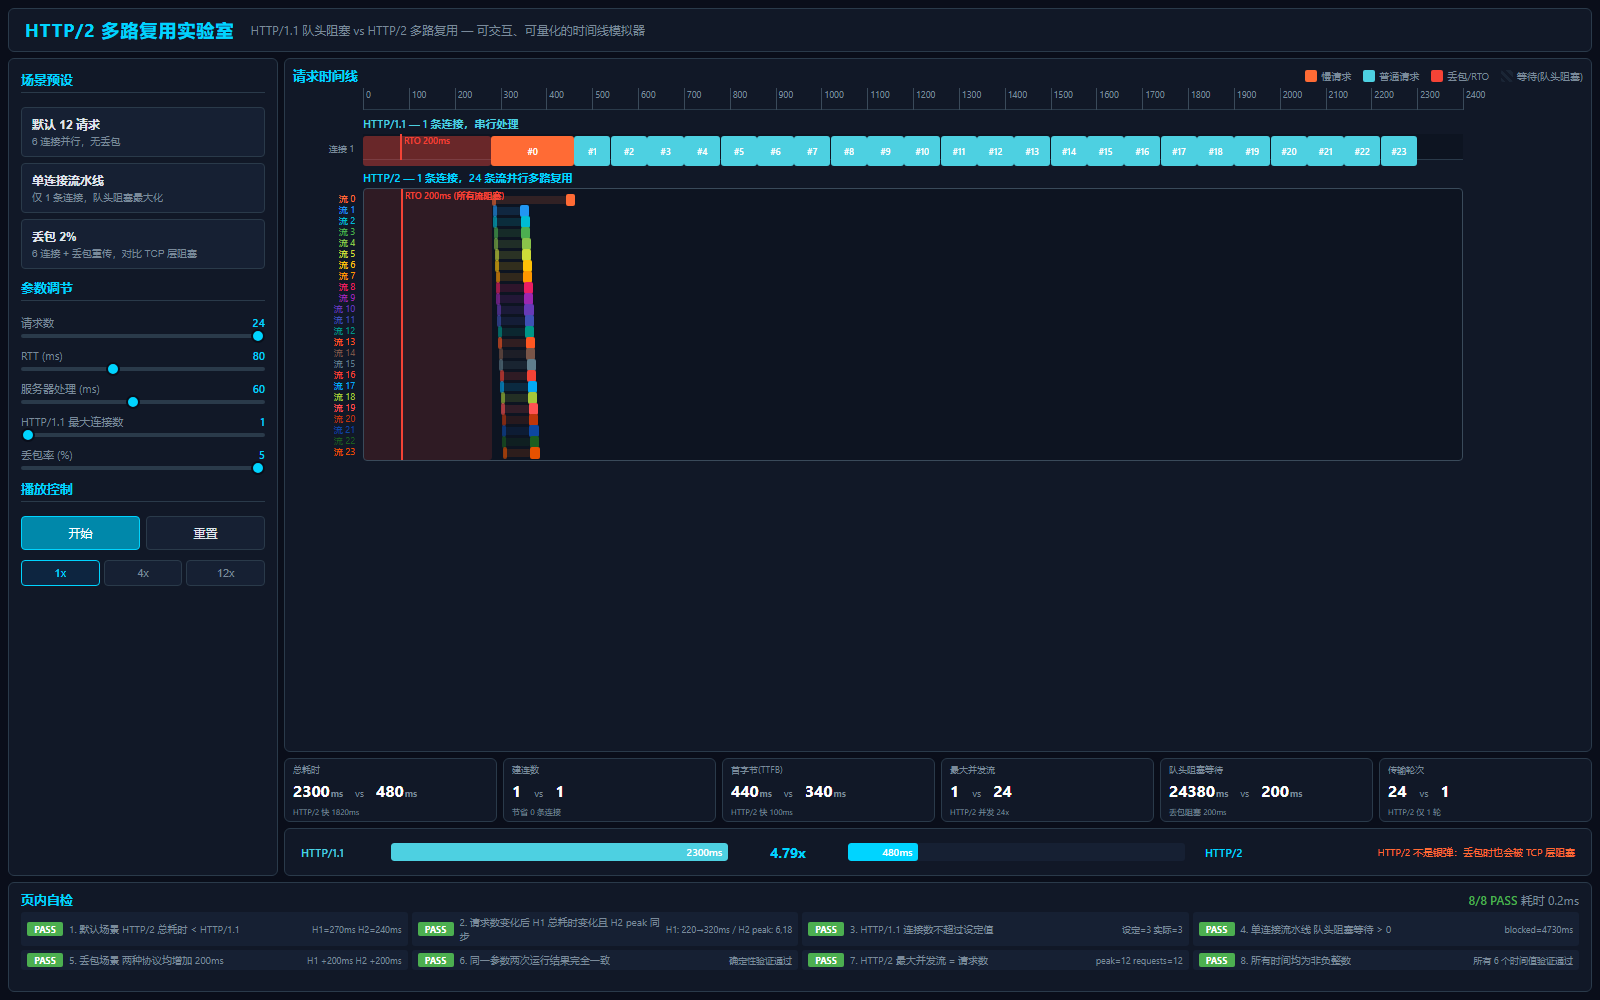
| 24 请求,1 连接,丢包 5% | 2300ms | 480ms | 4.79x | 24380ms |
表格里的总耗时由页面实时计算,不是我事后填的。
同一组参数点两次「开始」,数字完全一致。
默认场景的 1.13 倍看起来不痛不痒。
原因不在 HTTP/2 不给力,而在 6 条连接已经把 12 个请求摊薄了。
请求数越多,差距越明显。
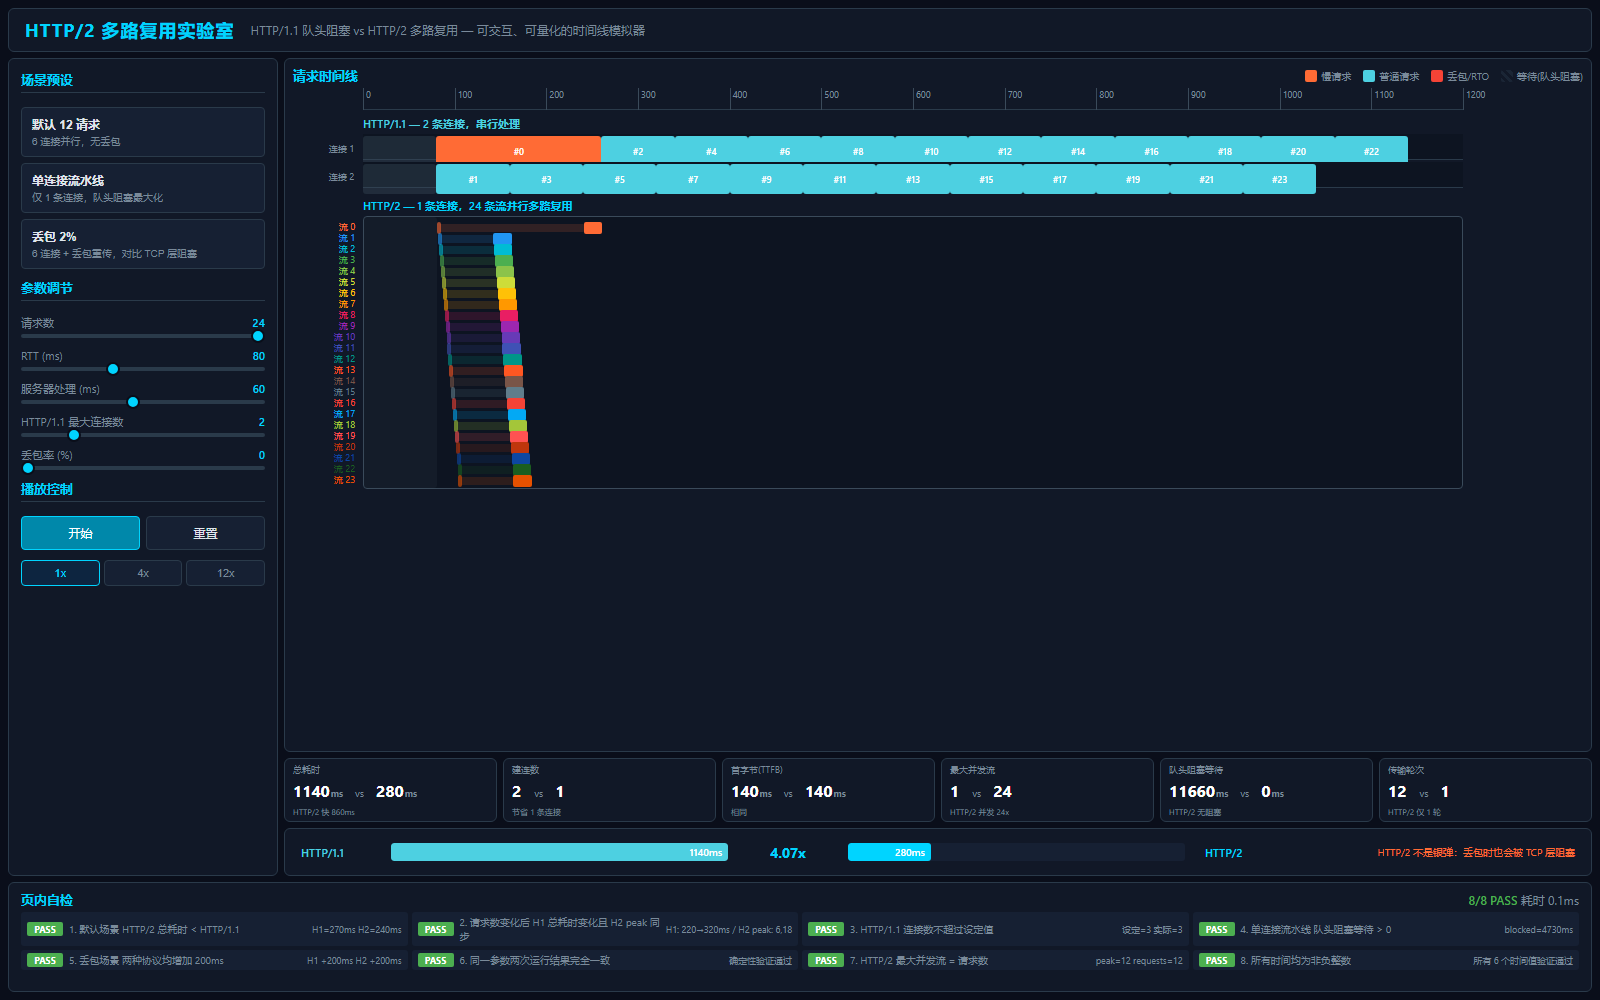
24 个请求、2 条连接,HTTP/1.1 要 1140ms,HTTP/2 只要 280ms。
二、HTTP/1.1 的 6 条连接,只是把一条队拆成六条
HTTP/1.1 的一条连接,同一时刻只处理一个请求。
响应还必须按请求顺序返回。
浏览器对同一个域名开 6 条连接,这是实现选择,不是协议规定。
12 个请求分到 6 条连接,每条连接两个。
连接 1 先跑慢请求 #0:40ms 建连,180ms 服务,220ms 结束。
#6 只能等到 220ms 才开始,270ms 结束。
另外五条连接在 140ms 就收工了。
页面总耗时取最慢的一条,所以是 270ms。
我把连接数拖到 1,队头阻塞立刻显形。
12 个请求串成一条链:40ms 建连 + 180ms 慢请求 + 11 个 50ms。
总耗时 770ms,阻塞等待累计 4730ms。
请求数拉到 24、连接数降到 2,问题还会放大。
每条连接要背 12 个请求,HTTP/1.1 跑到 1140ms。
页面把「传输轮次」单独列出来:12 轮对 1 轮。
域名分片、雪碧图、资源合并,都是在绕这件事。
连接开得越多,握手和 TLS 成本也越高。
6 条连接是折中,不是根治。
三、HTTP/2 把消息切成帧,用流 ID 让它们交错
HTTP/2 在同一条连接上引入二进制分帧层。
一个请求拆成 HEADERS 帧和 DATA 帧,每帧带上流 ID。
12 个请求就是 12 条流,帧可以交替发送。
服务器也能并行处理这些流。
页面上每条流都能单独看到 HEADERS 和 DATA 的位置。
总耗时等于建连 40ms + 最慢流 180ms + 传输 20ms,正好 240ms。
普通流的首字节仍是 70ms,慢流的数据在 200ms 到 220ms 之间回来。
慢流不再挡住后面 11 条流。
这就是多路复用的核心:把「按请求排队」改成「按帧调度」。
连接数从 6 降到 1,传输轮次从 2 降到 1,最大并发流从 1 变成 12。
24 个请求时,并发流变成 24,总耗时仍是 280ms。
因为最慢的那条流说了算,普通流早就传完了。
四、丢包时 HTTP/2 也会停:200ms 的 RTO 覆盖整条连接
TCP 提供的是有序字节流。
一个包丢了,后面的包即使到了,也不能先交给应用。
HTTP/2 的 12 条流跑在同一条 TCP 连接上,只能一起等。
我在页面里固定丢 1 个包,触发 200ms 重传超时。
红色竖线从 0ms 拉到 200ms,HTTP/2 的 12 条流全部后移。
总耗时从 240ms 变成 440ms,首字节从 70ms 变成 270ms。
HTTP/1.1 只影响命中的那条连接。
另外五条连接照常 140ms 收工,总耗时从 270ms 变成 470ms。
加速比从 1.13 倍掉到 1.07 倍,多路复用的优势基本被吃掉。
把丢包率拉到 5%、请求数拉到 24,差距又是另一种样子。
HTTP/1.1 是 2300ms,HTTP/2 是 480ms,仍有 4.79 倍。
但 HTTP/2 的首字节从 140ms 变成 340ms,所有流都晚了 200ms。
快,不等于每条流都准时。
要根治这个问题,得把流控制搬到 UDP 上。
QUIC 和 HTTP/3 就是这么做的:一条流丢包,只停这一条。
这个实验室只测到 HTTP/2,没有实现 QUIC。
五、实测与踩坑:三条断言和两个布局问题
页面底部的 8 条自检直接调用计算函数,不读界面上的数字。
结果 8/8 PASS,总耗时 0.1ms。
| 自检项 | 期望 | 实测 |
|---|---|---|
| 默认场景 HTTP/2 更快 | 240ms < 270ms | PASS |
| 请求数变化后指标同步 | H1 220→320ms,H2 peak 6→18 | PASS |
| 连接数不超上限 | 设定 3,实际 3 | PASS |
| 单连接有队头阻塞 | 等待大于 0 | 4730ms |
| 丢包让两边都慢 200ms | H1 +200ms,H2 +200ms | PASS |
| 同参数结果一致 | 连跑两次相同 | PASS |
| HTTP/2 并发流等于请求数 | peak 12,请求 12 | PASS |
| 时间都是非负整数 | 6 个时间值 | PASS |
第一条坑是断言写错。
最初第 2 条比较「6 请求和 18 请求的 HTTP/2 总耗时不同」。
可慢请求固定 180ms,HTTP/2 两次都是 240ms,断言误报 FAIL。
改成比较 HTTP/1.1 总耗时和 HTTP/2 的并发流数量,才测到真正会变的东西。
第二条坑是截图视口。
页面 body 固定 1600×1000,浏览器默认视口只有 1264×625。
第一次截图时指标卡和自检都被挤出画面,看起来像布局坏了。
先把视口设成 1600×1000 再截,五张图才完整。
第三条坑是 24 条流的密度。
1600×1000 下,12 条流能舒服排开,24 条会裁掉最后一条。
请求数超过 12 时,页面自动切到密集模式:连接泳道 26px,流高 10px。
边界也要说清楚。
这是浏览器里的确定性模拟,不是真实网络抓包。
没有模拟 TLS 握手、带宽上限、服务器并发上限和浏览器的真实调度。
RTT、服务时间、慢请求时长都是可调参数,数字会随参数变。
六、结果、使用码道体会与下一步
现在它是一个 1600×1000 的单页,左侧参数,右侧时间线,底部指标和自检。
五个场景按钮对应默认、单连接、丢包,再拖两个滑块就能复现 24 请求。
三步验收就够:
第一,默认场景确认 270ms 对 240ms,HTTP/2 并发流 12。
第二,切「单连接流水线」,HTTP/1.1 必须变成 770ms,阻塞等待 4730ms。
第三,切「丢包 2%」,必须看到红色 RTO 线覆盖整条 HTTP/2 连接。
三步都过,页面才算真能跑。
什么时候值得上 HTTP/2?
同域资源多、请求数大、RTT 高、丢包低,收益最明显。
请求只有三五个,或者链路丢包严重,先别指望它救场。
中间件、CDN、服务端不支持 HTTP/2,前端再优化也落不了地。
下一步我会补两件事。
一是接真实站点的 HAR,把模拟参数换成实测 RTT 和请求数。
二是把 HTTP/3 的丢包隔离做进同一个时间线,和 HTTP/2 并排对比。
使用码道体会,我记了五条:
- 先把计算模型写死,再让页面画图,数字才不会跟着动画乱飘。
- 失败路径要单独做一个预设,丢包和队头阻塞不能只靠嘴讲。
- 自检必须调用计算函数,不能读 DOM 里的结果。
- 让每个场景都有可复算的输入和输出,读者才能自己验证。
- 单文件交付,双击可开,复现成本最低。
七、准备环境:进入码道 Web
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。
本文用 WebUI 版生成。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source…,登录后直接在对话窗口输入需求,不需要装软件。
八、仓库与复现
git clone https://gitcode.com/OPCTeam/demo_park.git
cd demo_park\codearts-http2-multiplex-lab
start index.html
也可以只下载 index.html 双击打开。
如果只想看结论,先点「单连接流水线」和「丢包 2%」,两分钟就能看懂差别。