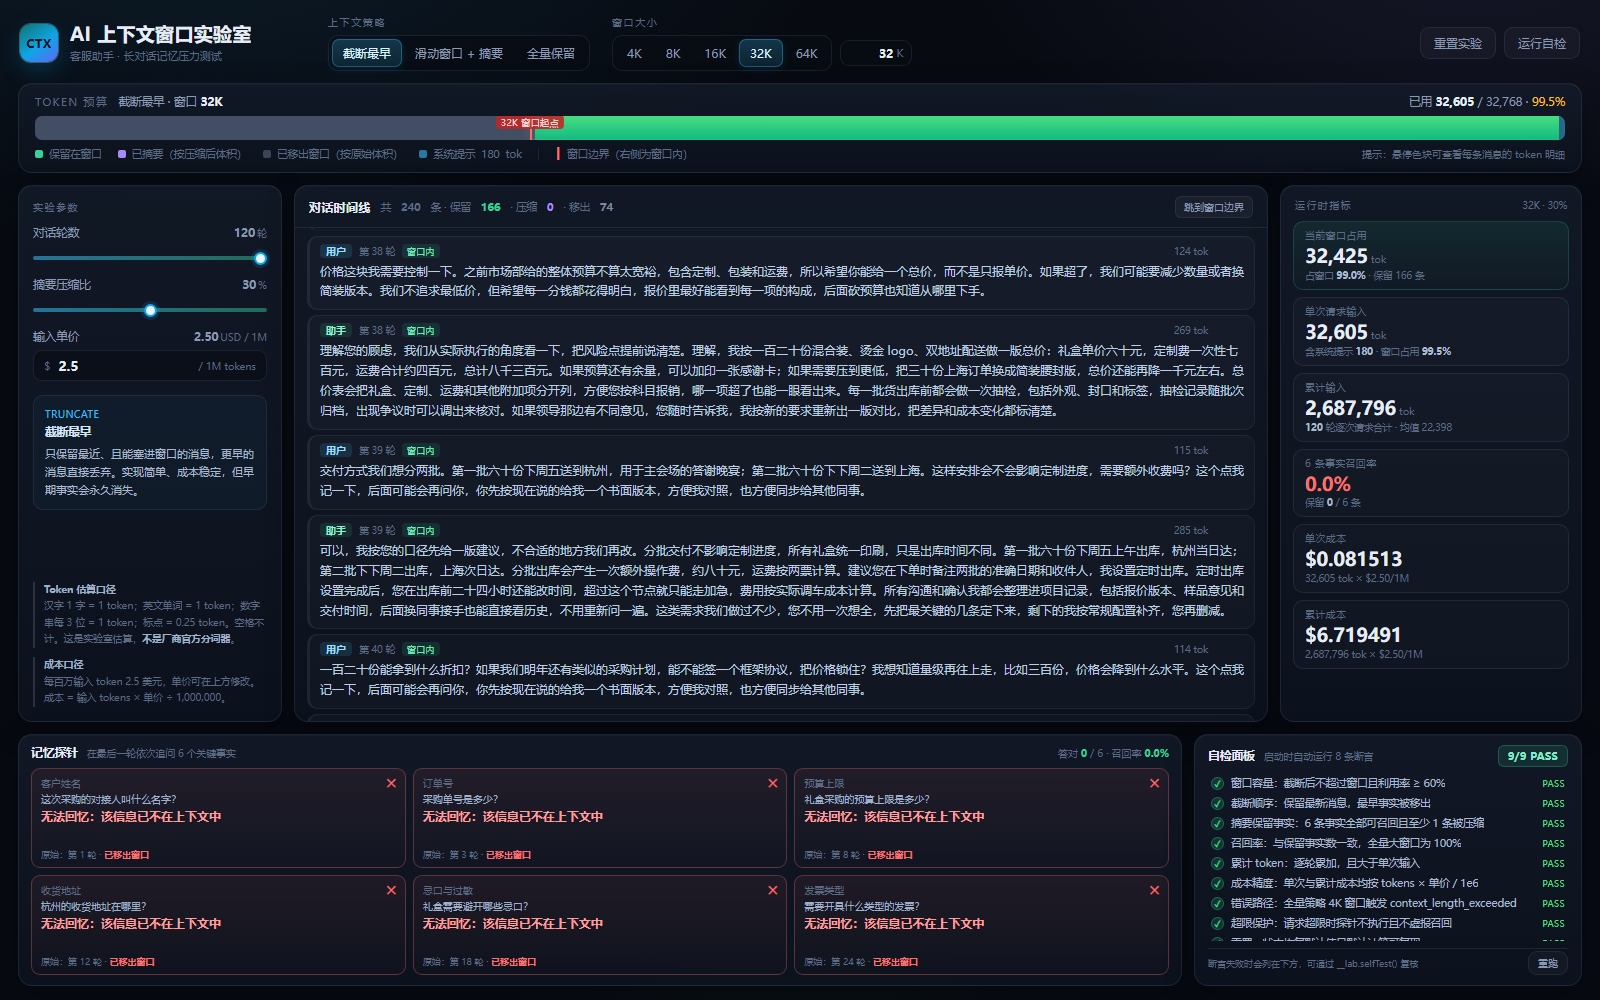
32K 上下文会在第 80 轮开始丢东西。
先掉的是第 1 轮说的客户姓名,第 3 轮的订单号紧随其后。
跑到 110 轮,6 条关键事实一条不剩。
同一段对话换成 8K 窗口加 10% 摘要,120 轮仍然答对 6/6,累计输入 910,716 tokens,按每百万 2.5 美元算约 2.28 美元。
在线案例与源码:gitcode.com/OPCTeam/dem… 成品是一个 index.html,双击就能打开,不连网,不装依赖。
一、先看结果:窗口翻倍,能多撑的轮数也翻倍
我写了一段固定的客服对话,一共 120 轮。
每轮是用户加助手两条消息,平均 402 tokens。
对话里埋了 6 条关键事实:姓名在第 1 轮,订单号在第 3 轮,预算在第 8 轮,地址在第 12 轮,忌口在第 18 轮,发票类型在第 24 轮。
然后我用 4K、8K、16K、32K 四个窗口,各跑 30、60、120 轮。
策略固定为截断最早,只保留最近、且能塞进窗口的消息。
跑完的召回率如下。
| 窗口 | 30 轮 | 60 轮 | 120 轮 |
|---|---|---|---|
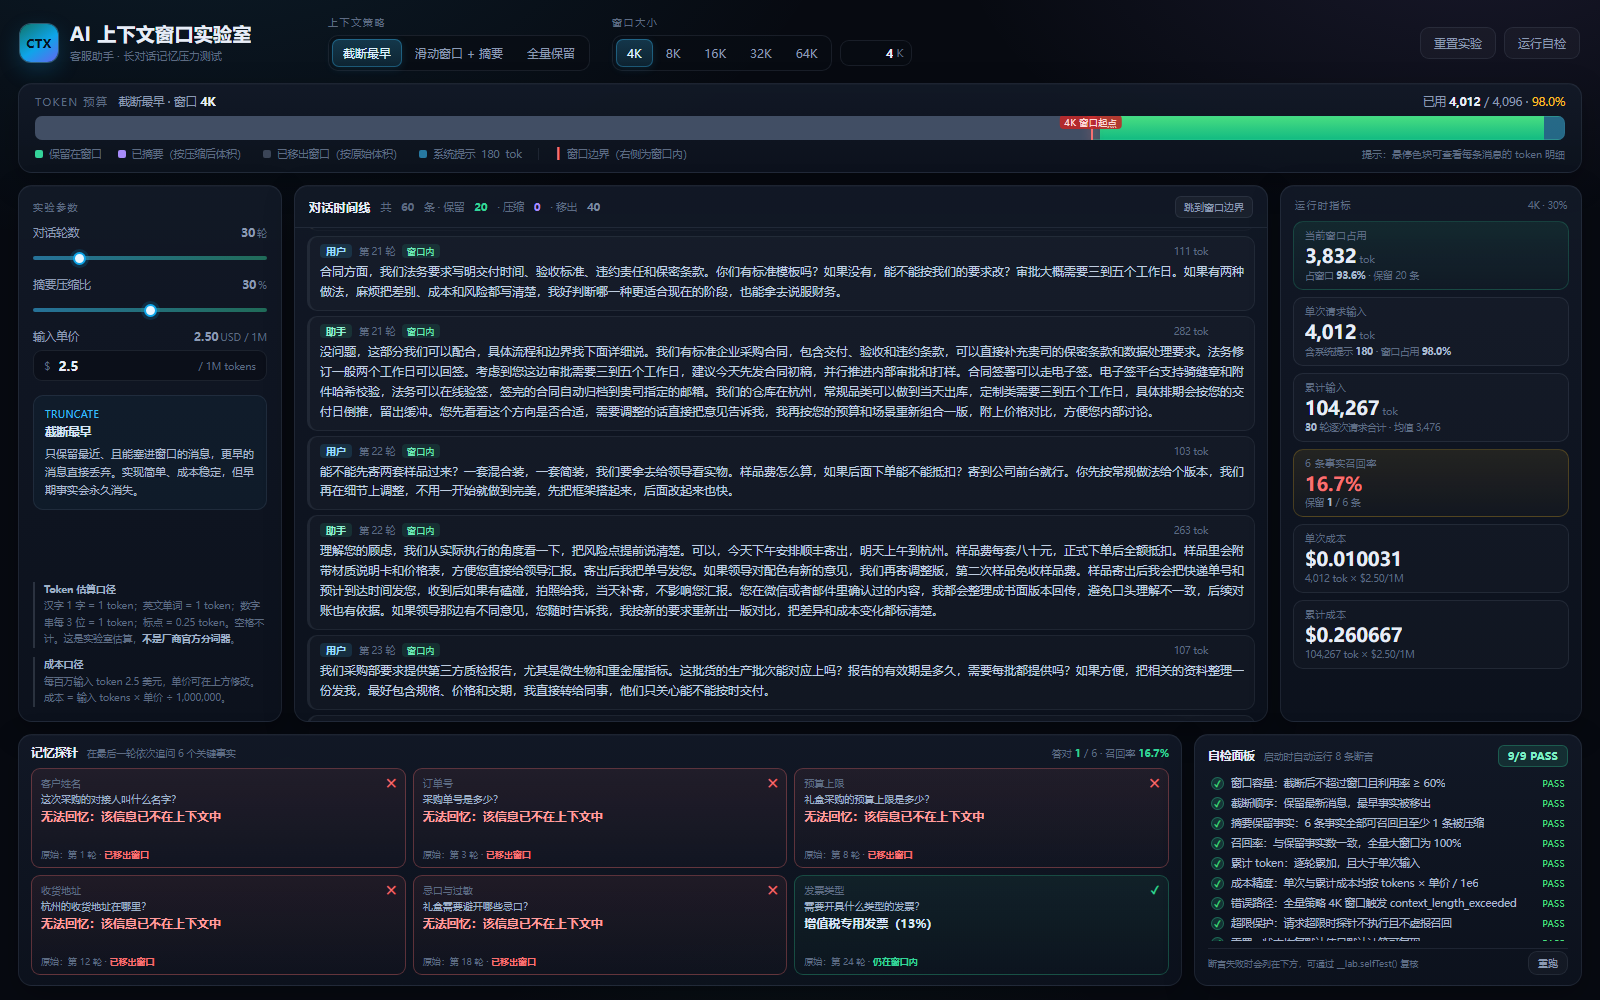
| 4K | 16.7% | 0.0% | 0.0% |
| 8K | 50.0% | 0.0% | 0.0% |
| 16K | 100.0% | 16.7% | 0.0% |
| 32K | 100.0% | 100.0% | 0.0% |
30 轮时,16K 和 32K 都能拿满分,4K 只剩 1/6。
60 轮时,32K 还是满分,16K 掉到 1/6,8K 和 4K 归零。
120 轮时,四个窗口全部归零。
窗口翻倍,能多撑的轮数也大致翻倍:4K 约 9 轮,8K 约 19 轮,16K 约 39 轮,32K 约 77 轮。
这条线很直:每轮 402 tokens,窗口除以 402 就是容量。
32K 不等于“能记住很多”,它只等于“能装下最近 77 轮”。
二、为什么这样做:AI 不是忘了,是它根本没收到
我们平时说“AI 记不住”,多数时候不是模型丢了记忆。
是每一轮请求都只带上了窗口里的那一段历史,窗口外的内容根本没进请求。
我把三种常见处理方式放在同一个页面里对照。
截断最早:只保留最近、能塞进窗口的消息,更早的直接丢。
滑动窗口加摘要:最近的原文保留,更早的压缩成摘要继续带着。
全量保留:一条不裁,全部发送。
这三种策略的差别,不是“谁更聪明”,而是“谁愿意为历史付多少 token”。
截断的成本最稳,代价是早期事实永久消失。
摘要能保住事实,但多了一次压缩,压缩比越低越省 token,摘要越短越容易丢细节。
全量保留信息最完整,但 120 轮要发 48,250 tokens,4K 窗口直接装不下。
三、32K 的丢失顺序:名字先走,订单号第二
我把 32K 窗口从 60 轮拉到 120 轮,每 5 轮记一次。
结果不是一起掉,而是一条一条掉。
| 对话轮数 | 还在的事实 | 刚掉的事实 |
|---|---|---|
| 75 | 6/6 | 无 |
| 80 | 5/6 | 第 1 轮姓名 |
| 85 | 4/6 | 第 3 轮订单号 |
| 95 | 2/6 | 第 8 轮预算、第 12 轮地址 |
| 105 | 1/6 | 第 18 轮忌口 |
| 110 | 0/6 | 第 24 轮发票类型 |
75 轮时,6 条事实都还在,单次输入 30,937 tokens。
80 轮时,姓名先掉,单次输入升到 32,707 tokens。
85 轮时,订单号也掉了,只剩 4 条。
95 轮时,预算和地址一起掉,只剩忌口和发票类型。
105 轮时,只剩发票类型。
110 轮时,一条不剩。
丢的顺序就是事实出现的顺序。
窗口从最老的开始裁,最早说的话最先离开。
这也解释了一个常见现象:AI 记得你昨天下午说的偏好,却忘了你一开始报的订单号。
不是它觉得订单号不重要,是订单号排在更前面。
四、怎么做:先算 token 预算,再谈记忆
这个页面是一个 1600×1000 的单文件 index.html。
没有 CDN,没有外部字体,没有图片依赖。
token 估算口径写在左下角:汉字 1 字 1 token,英文单词 1 token,数字串每 3 位 1 token,标点 0.25 token,空格不计。
这是估算,不是任何厂商的官方分词器。
120 轮对话按这个口径算是 48,250 tokens,平均每轮 402。
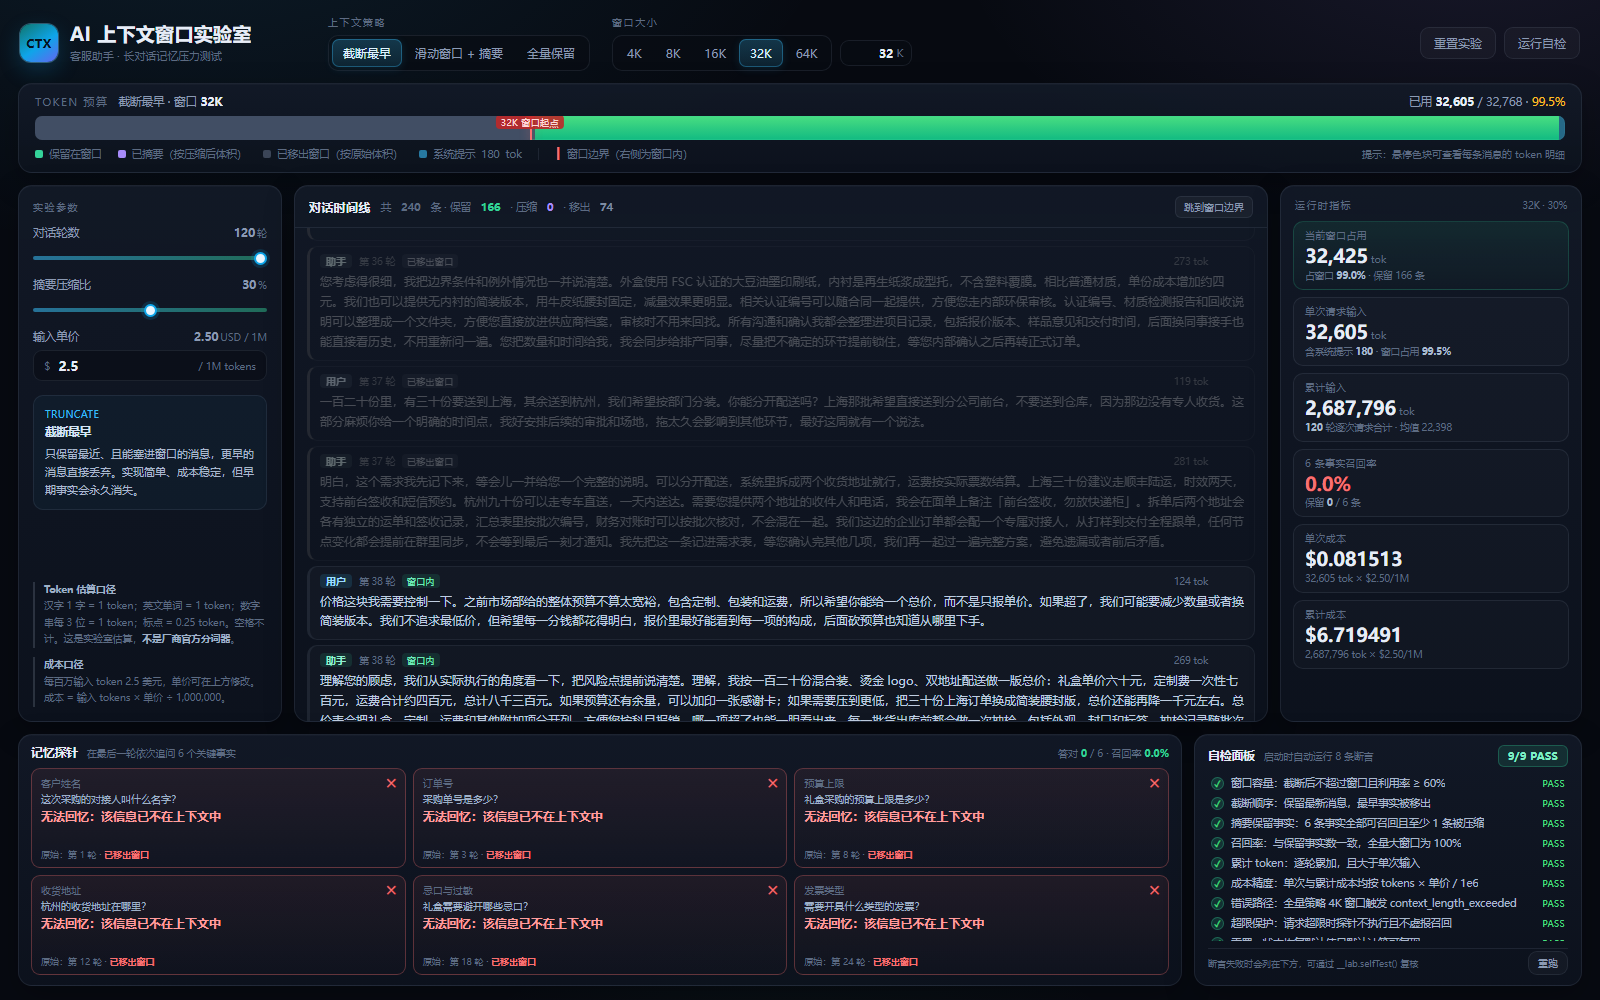
页面顶部是预算条,每条消息按“保留 / 已摘要 / 已丢弃”三种状态着色。
红色竖线标出窗口边界,右侧半透明区域是窗口内。
中部是对话时间线,被丢弃的消息变灰,并标上“已移出窗口”。
右侧指标卡给出当前窗口占用、单次输入、累计输入、召回率、单次成本和累计成本。
底部是记忆探针,最后一轮依次问 6 个问题。
答对显示绿色,答错显示红色,并注明这条事实原本在第几轮、是否已经移出窗口。
自检面板启动时跑 9 条断言,当前是 9/9 PASS。
我在这里改过三个地方。
第一个是超限时的召回率。
最初版本在请求已经超过窗口时,探针仍然显示 6/6,等于把“问不出去”算成了“全记得”。
我加了 probeBlocked 标记:请求超限时探针不执行,召回率记 0,并补了第 9 条自检专门盯这个。
第二个是预算条的标签。
红色竖线原本写“32K 上限”,但它实际标的是窗口起点,右侧才是窗口内。
现在当历史总量超过窗口时,标签改成“32K 窗口起点”,并给右侧窗口区加了一层淡绿色底。
第三个是摘要策略的说明。
原文写“摘要越长越容易失真”,说反了。
压缩比越低,摘要越短,越容易丢事实。
这三处都不影响主流程,但都会让读者得出相反结论。
我宁愿把它们写进文章,也不想留一个“看起来对”的页面。
五、实测:8K 摘要比 32K 截断更便宜,也记得更多
同样跑 120 轮,我把四种组合的累计输入和累计成本放在一起。
单价按每百万输入 token 2.5 美元算。
| 策略 | 窗口 | 召回率 | 单次输入 | 累计输入 | 累计成本 |
|---|---|---|---|---|---|
| 截断最早 | 16K | 0.0% | 16,375 | 1,670,733 | $4.18 |
| 截断最早 | 32K | 0.0% | 32,605 | 2,687,796 | $6.72 |
| 摘要 30% | 16K | 100.0% | 16,268 | 1,675,658 | $4.19 |
| 摘要 10% | 8K | 100.0% | 8,103 | 910,716 | $2.28 |
32K 截断最贵,6.72 美元,召回率 0。
8K 加 10% 摘要最便宜,2.28 美元,召回率 100%。
两者差了 2.95 倍成本,记忆结果正好相反。
原因不复杂。
截断每次都把 32K 窗口塞满,120 轮累计发了 268 万 tokens。
摘要把早期历史压到 10%,每次请求只发 8K 左右,累计 91 万 tokens。
窗口大不等于账单小,关键看每轮实际发了多少。
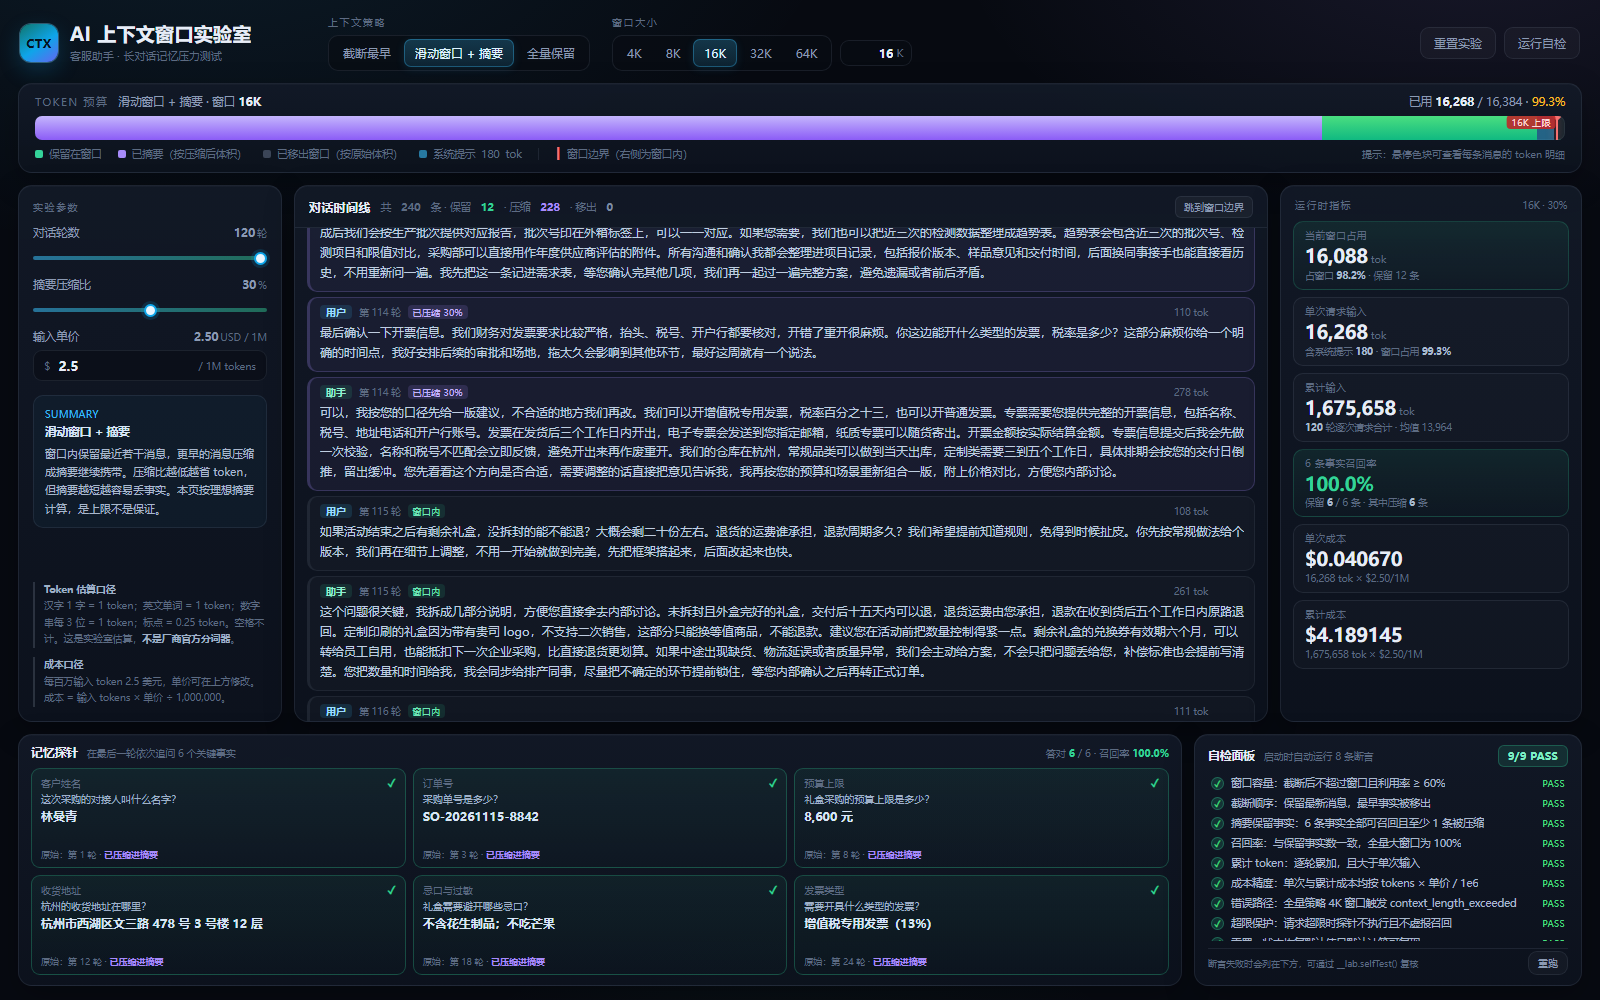
摘要也不是随便调都能过。
同样是 8K 窗口,压缩比 30% 时需要 14,655 tokens,直接超过窗口。
把压缩比降到 10%,输入降到 8,103 tokens,才刚好塞进去。
压缩比和窗口要一起调,只改一个会撞墙。
六、失败路径:先报错,不白屏
我把策略切到全量保留,窗口压到 4K,轮数拉到 120。
页面立刻给出错误:
context_length_exceeded:当前 48,430 tokens 超过窗口 4,096
下面写清了超出 44,334 tokens,并保留上一次成功计算的结果。
时间线、指标和探针都停在上一次 4K、30 轮的状态,没有白屏。
错误卡给了三个可点的动作:把窗口提升到 48K、改用摘要策略、改用截断策略。
这三个按钮不是装饰,点下去会直接改配置并重算。
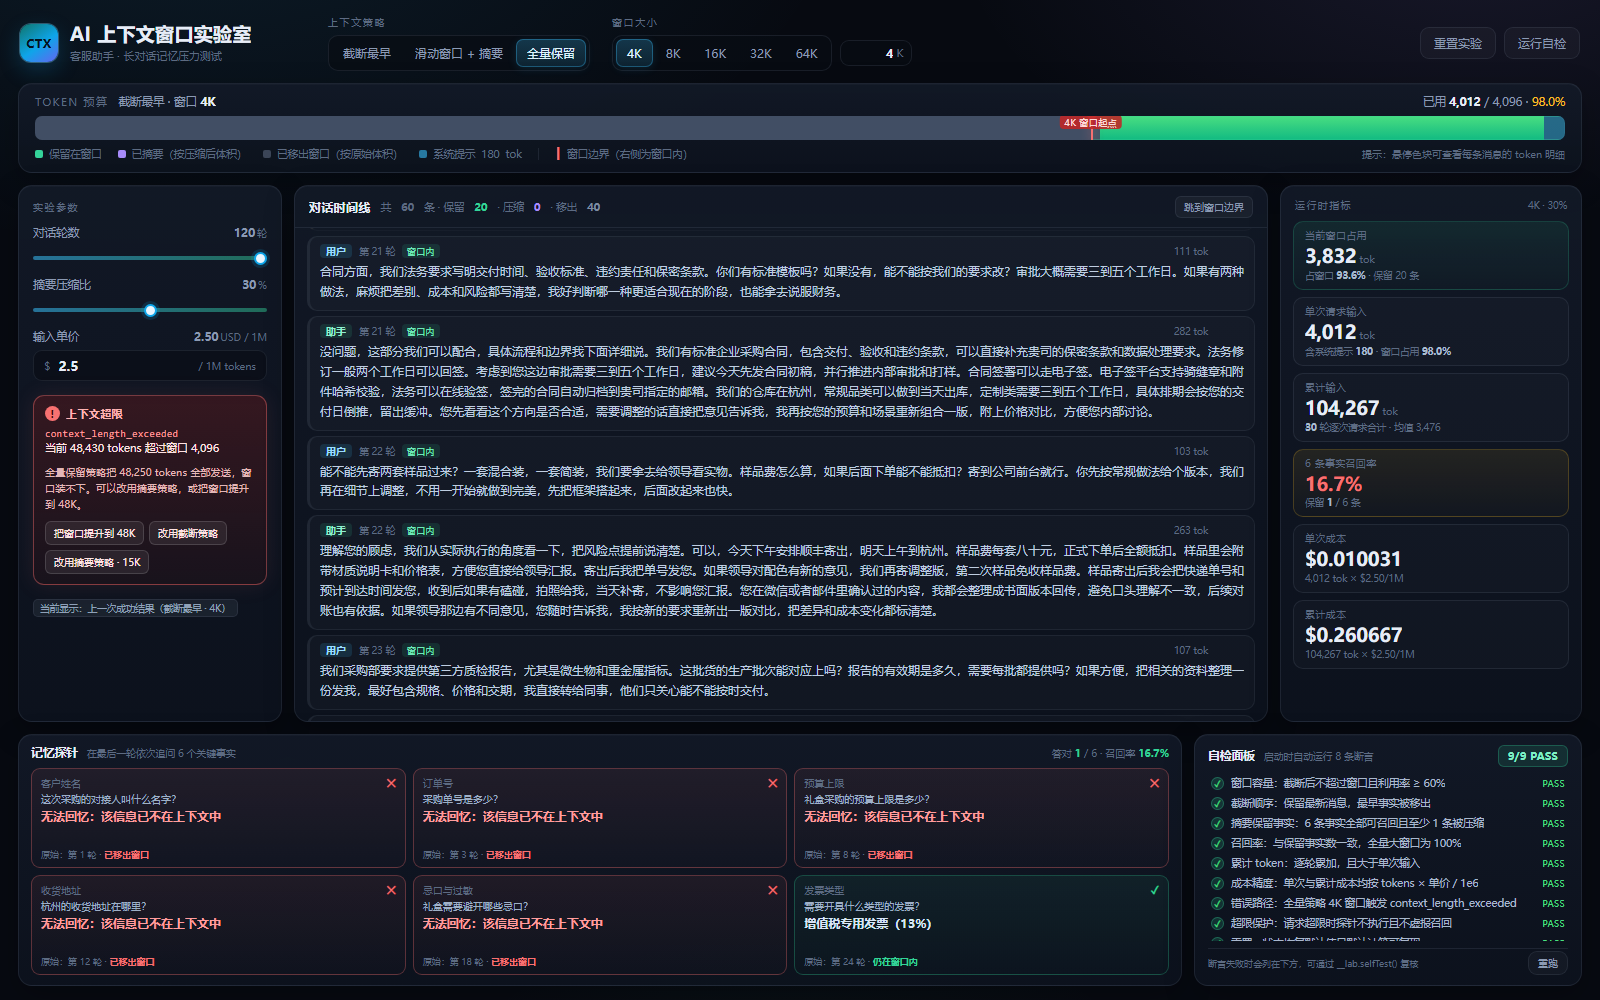
复现这条失败路径只要三步。
策略选“全量保留”,窗口点 4K,轮数拉到 120。
错误卡出现后,点“改用摘要策略 · 15K”,页面会回到可计算状态。
七、边界:这不是某家 API 的真实账单
这个页面没有调用任何模型 API。
对话是固定脚本,token 数是按字符规则估的,成本按 2.5 美元每百万 tokens 算。
真实厂商的分词、缓存计价、阶梯折扣都不一样,数字会有偏差。
摘要策略按“理想摘要”计算。
它假设压缩后的摘要不丢事实,所以 6 条事实全部可召回。
真实模型做摘要会漏、会改写、会把订单号抄错。
所以摘要那一列的 100% 是上限,不是保证。
截断和全量保留没有这层假设,它们的召回率是确定的。
页面也没有模拟延迟和回答质量。
它只回答一个问题:给定窗口和策略,哪些历史还在请求里。
这已经足够解释“AI 为什么忘事”,但不足以预测某个具体产品的表现。
八、准备环境:进入码道 Web 并复现
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source…
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
下载 index.html 后,可以直接双击打开。
也可以在当前目录起一个静态服务:python -m http.server 8000,再打开 http://localhost:8000/index.html。
按这个顺序点,能复现本文的数字:
- 策略选“截断最早”,窗口 32K,轮数 120,看召回率 0.0%。
- 轮数拉到 75,看 6/6;再拉到 80,看姓名先掉。
- 继续拉到 110,看 6 条全部移出。
- 切到“滑动窗口 + 摘要”,窗口 8K,压缩比 10%,轮数 120,看召回率 100%、累计输入 910,716。
- 切到“全量保留”,窗口 4K,轮数 120,看 context_length_exceeded。
自检面板 9/9 PASS。
失败路径提示原文就是上面那行 context_length_exceeded。
九、使用码道体会
需求里我把验收条件写成了可执行的数字。
1600×1000、单文件、无外部依赖、三种策略、6 条固定事实、9 条自检、超限必须给中文错误。
页面把这些都做出来了,还把自检结果直接渲染在右下角。
我做的事不是替它写循环,而是把“什么算对”说清楚。
比如窗口容量要等于窗口除以每轮 token,召回率要等于保留事实数除以 6,累计成本要等于累计 tokens 乘单价。
这些条件越具体,验收越省事。
真正需要我自己判断的是边界。
自检全绿时,超限路径仍然虚报过 6/6。
这个问题不是语法错误,是产品语义错了。
我是在把 4K 和全量保留放在一起对照时发现的。
这也是我建议每个读者亲手点一遍的地方。
十、下一步
还缺三块。
一是接真实模型。
同一段对话发给我常用的 API,记录每次请求的 usage.input_tokens,和页面的估算并排。
二是把摘要换成真实摘要。
让模型自己压,再看 6 条事实还能召回几条。
三是加一组“事实放系统提示”的对照。
把姓名和订单号固定在系统提示里,看召回率能不能从 0 拉回 100%。
仓库地址在文章开头,拿去改。
附录:复现用需求
下面是我用来生成这个页面的需求,和页面实际实现一致,可以直接复制:
做一个单文件网页应用「AI 上下文窗口实验室」,文件名 index.html,无外部依赖、无 CDN、无网络请求,纯 HTML/CSS/JS,中文界面,桌面 1600x1000 布局,深色主题。

场景:一个客服助手的长对话,共 30~120 轮,每轮用户加助手约 420 个估算 token。对话在固定轮次埋 6 条关键事实:姓名第 1 轮、订单号第 3 轮、预算第 8 轮、收货地址第 12 轮、忌口第 18 轮、发票类型第 24 轮。

功能要求:
1. 上下文策略三选一:截断最早 truncate、滑动窗口加摘要 summary、全量保留 full。
2. 窗口大小按钮 4K/8K/16K/32K/64K,另有输入框可自定义 1K~128K。
3. 轮数滑杆 10~120,摘要压缩比滑杆 10%~50%。
4. 顶部 token 预算条:每条消息按保留/已摘要/已丢弃三种颜色堆叠,标出窗口边界。
5. 中部对话时间线,可滚动;被丢弃的消息变灰并标「已移出窗口」,被摘要的标「已压缩」。
6. 右侧指标卡:当前窗口占用 tokens、单次请求输入 tokens、累计输入 tokens、6 条事实召回率、单次成本、累计成本。
7. 底部记忆探针:在最后一轮依次问 6 个问题,答对绿色、答错红色,并标注该事实原本在第几轮、是否已移出窗口。
8. 失败路径:单条消息本身超过窗口,或 full 策略超限时,显示中文错误「context_length_exceeded:当前 N tokens 超过窗口 M」,保留上一次结果,不白屏,给出可操作提示。
9. 自检面板:启动时跑断言(窗口容量、截断顺序、摘要保留事实、召回率、累计 token、成本精度、错误路径触发、超限保护、重置),显示 PASS 数量,失败列出具体断言。
10. 暴露 window.__lab:__lab.run({strategy,window,turns,ratio,price}) 返回 inputTokens、cumulativeTokens、recall、keptFacts、droppedFacts、cost、overflow;__lab.selfTest() 返回 pass、total、failures。

所有数字必须由代码实际计算,不要写死。token 估算口径:汉字 1 字 1 token,英文单词 1 token,数字串每 3 位 1 token,标点 0.25 token;页面上要标注这是估算口径,不是任何厂商的官方分词器。成本按每百万输入 token 2.5 美元估算,单价可改。

完成后打开预览,让我直接看到运行效果。