两条 JSON 粘成一条,问题不在 TCP。
TCP 只负责把字节按序送到,从不保留“消息”边界。
应用层没规定一帧多长,接收端就只能靠猜。
我把四种常见拆包方案做成了一个能点的实验室。
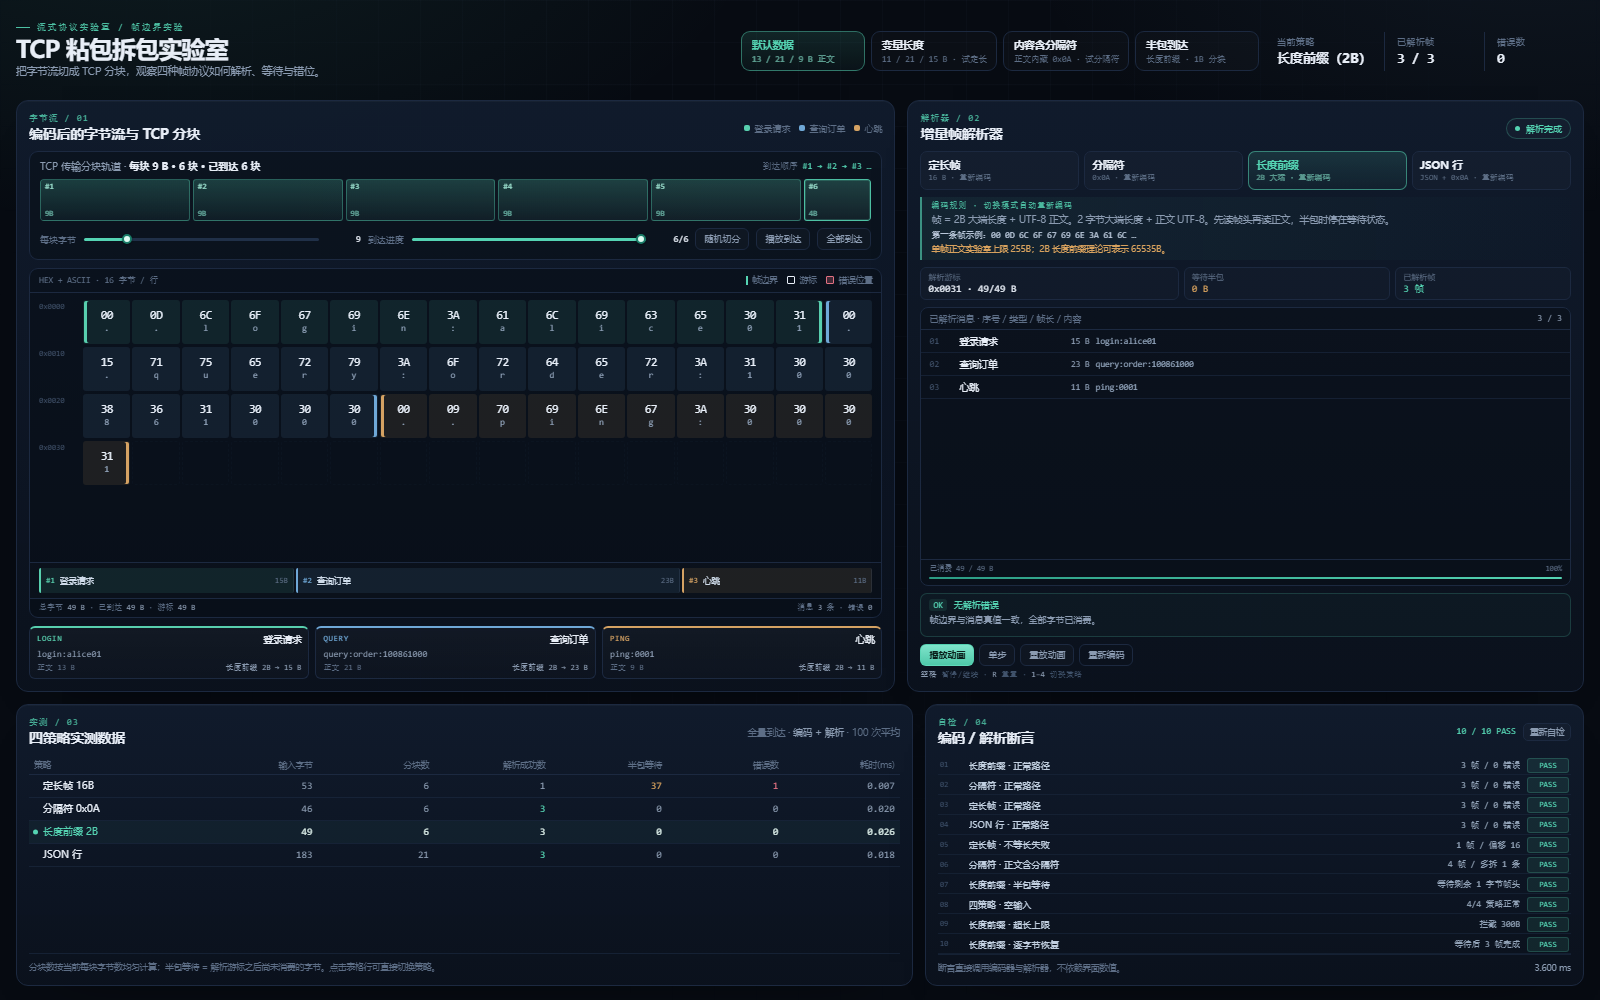
公开仓库在 Demo Park,单个 index.html,双击就能开。
本地复跑自检 10/10 PASS,失败路径也逐条点过。
一、为什么“粘包”不是 TCP 的错
很多人以为是网络把包粘住了。
其实 TCP 根本没有“包”这个概念,它只提供字节流。
发送端 write 两次,接收端 read 一次拿到 30 字节,完全合法。
反过来,一次 write 也可能被拆成两次 read,这就是半包。
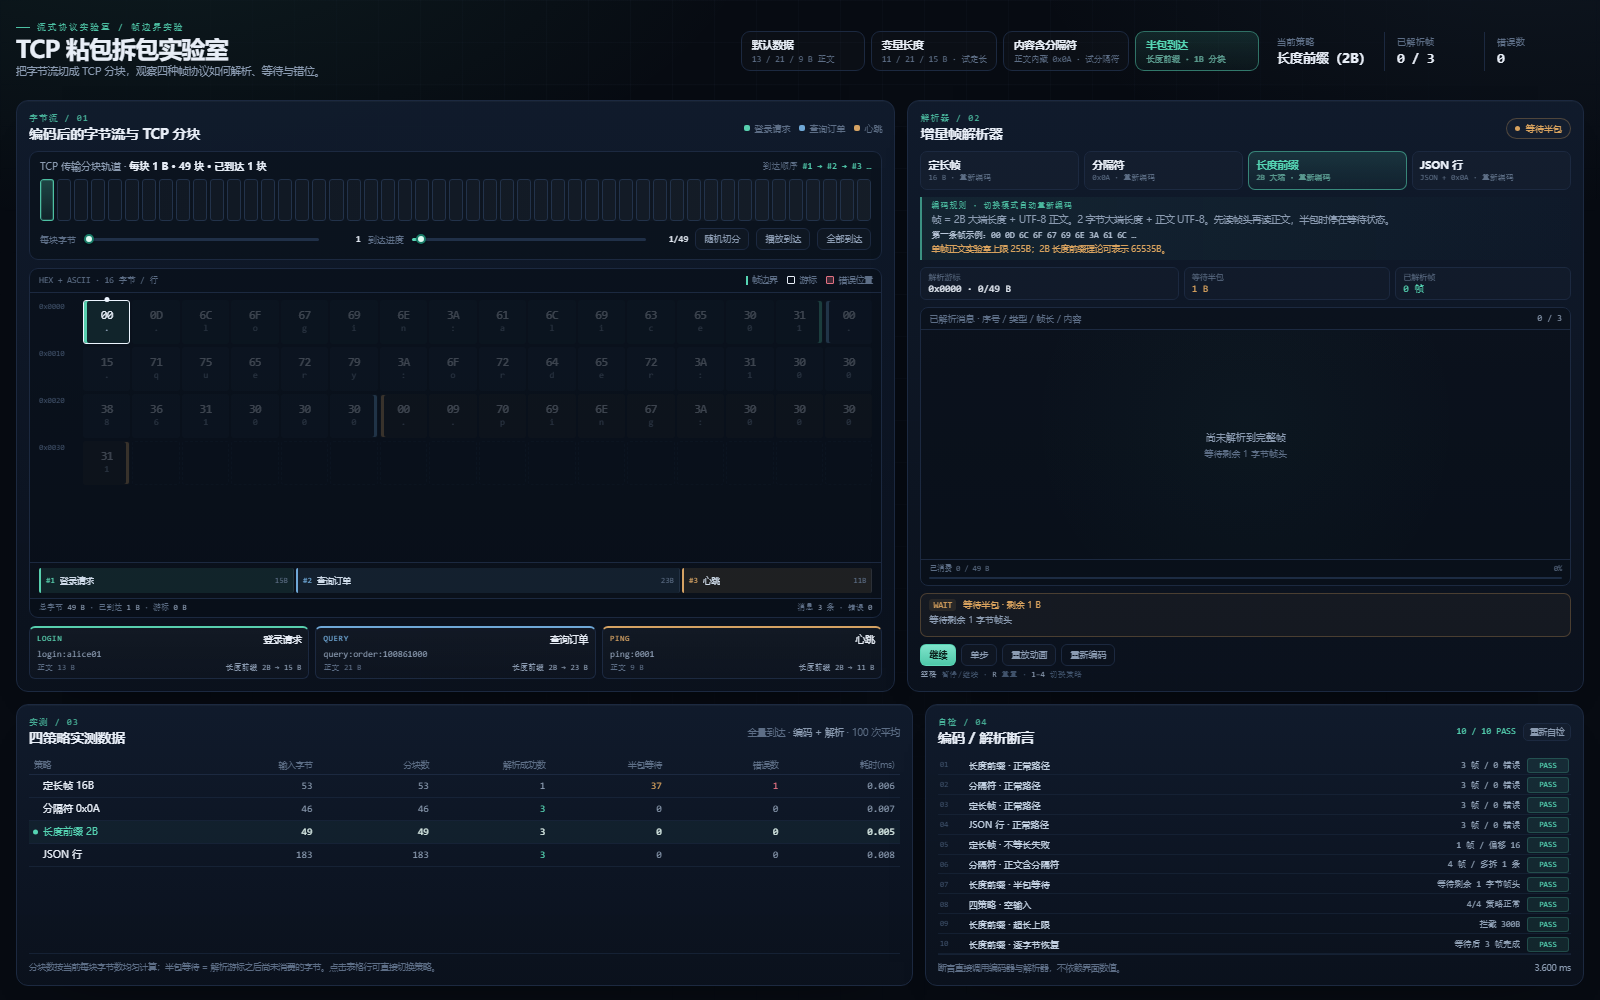
我在页面上把 49 字节拆成 9 字节一块,轨道变成 6 个分块。
顺序没变,边界全丢。
接收端看到的只是一条连续的十六进制带,哪几个字节属于哪条消息,协议不说就没人知道。
所以“粘包”和“半包”是同一个问题的两面:应用层没有帧边界。
解决方向只有一类:让每条消息自带可识别的结束条件。
常见做法就是定长、分隔符、长度前缀、自描述格式。
二、四种拆包方案,差在哪
| 方案 | 编码规则 | 一眼看懂 | 什么时候会翻车 | 本次实测 |
|---|---|---|---|---|
| 定长帧 16B | 每条固定 16 字节,不足补 0x00 | 切固定长度就行 | 消息长度不等就整体错位 | 1/3 帧,错误偏移 0x0010 |
| 分隔符 0x0A | 正文后追加换行 | 读到换行为止 | 正文自带换行会被误拆 | 4 帧,比真值多 1 条 |
| 长度前缀 2B | 2 字节大端长度加正文 | 先读帧头再读正文 | 帧头本身也可能半包 | 3/3 帧,半包时正确等待 |
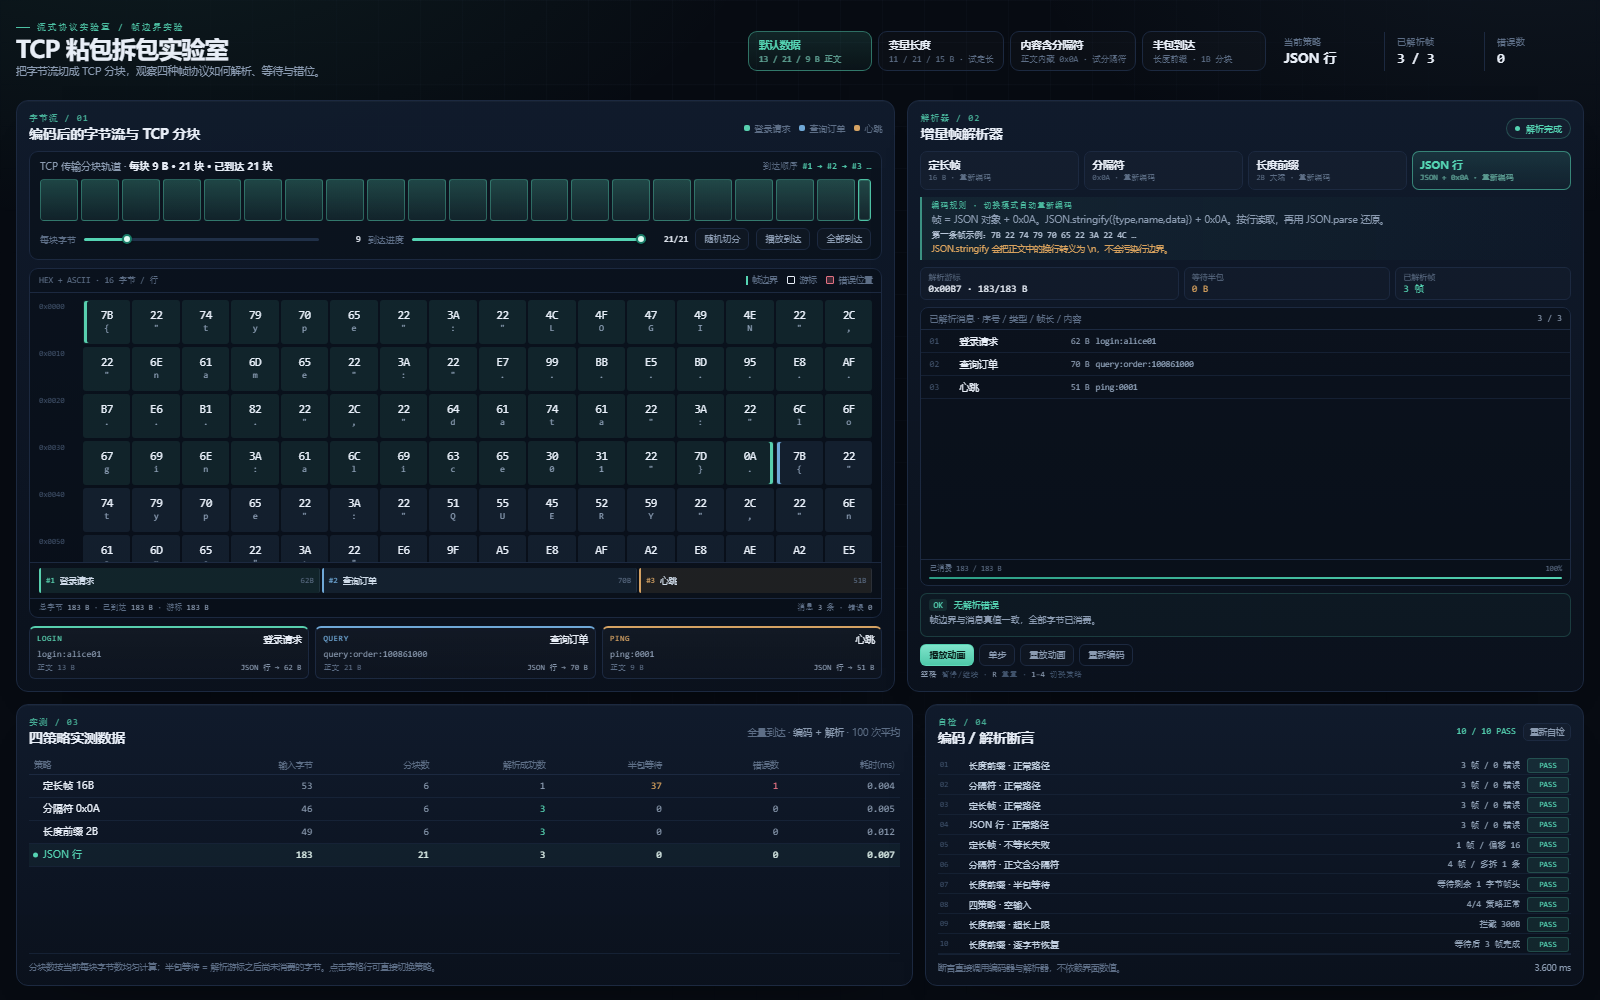
| JSON 行 | 一行一个 JSON,换行结尾 | 自描述,字段可扩展 | 体积膨胀,解析更慢 | 183 字节,3/3 帧 |
定长帧的实现最简单。
每条消息固定占 16 字节,不够补 0x00,解析器每次切 16 字节。
问题是消息长度一变就全乱。
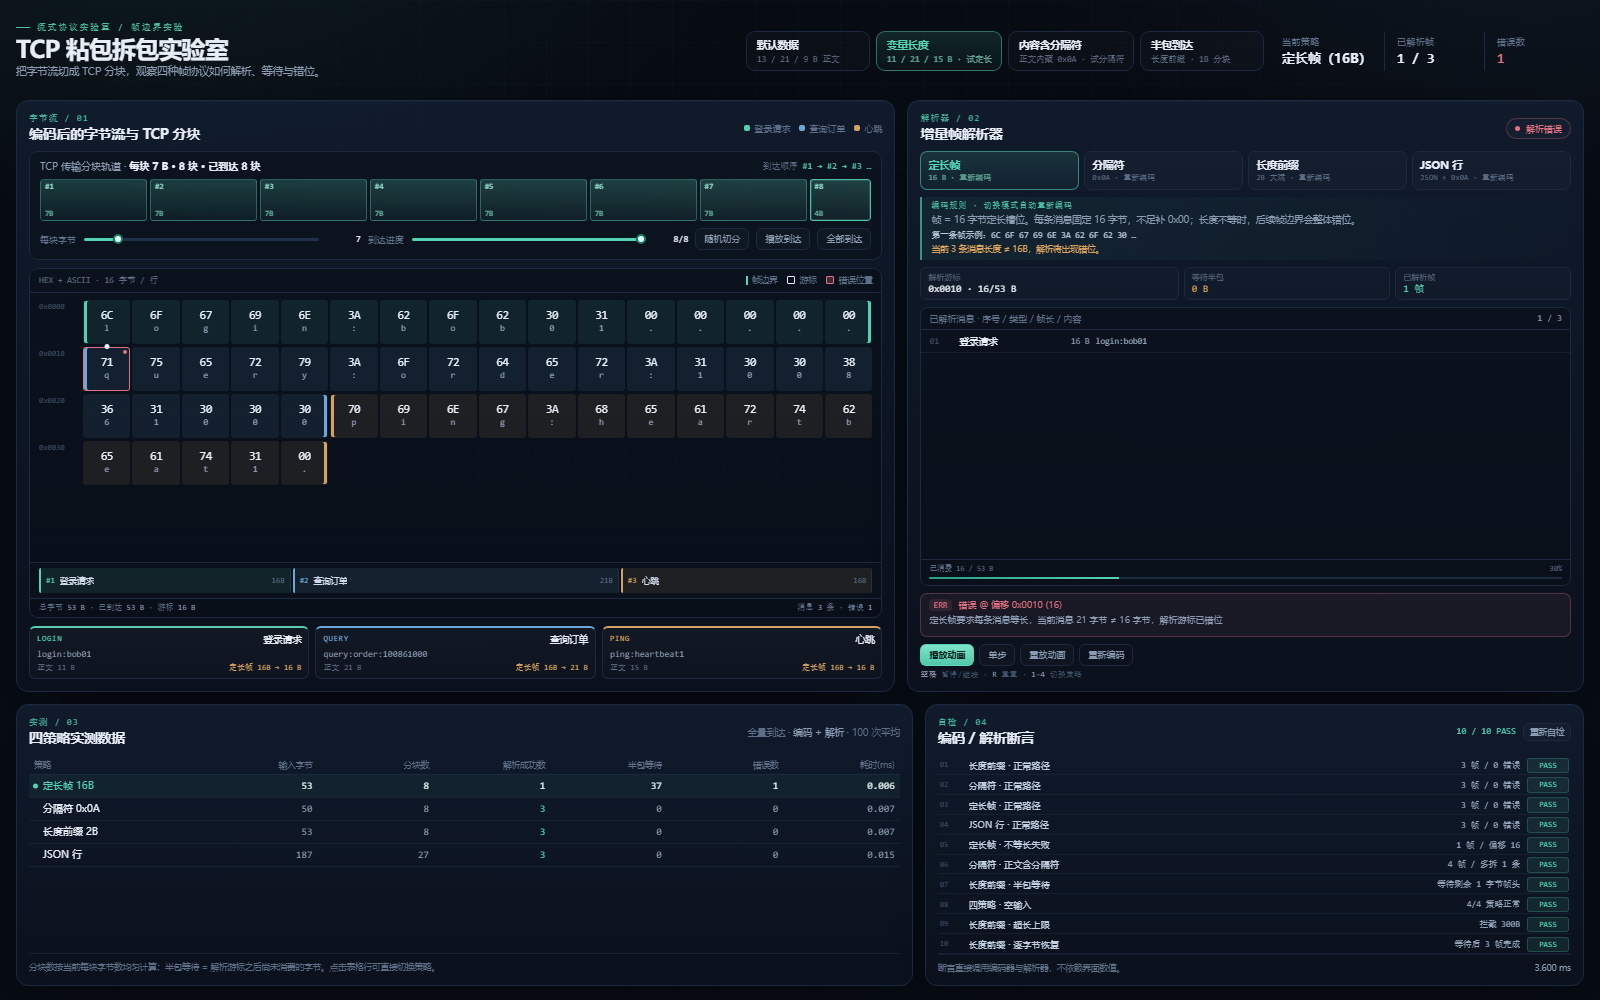
我切到“变量长度”预设,11/21/15 B 进流,第一帧后游标停在 0x0010。
页面直接报错:“定长帧要求每条消息等长,当前消息 21 字节 ≠ 16 字节,解析游标已错位”。
分隔符方案在文本协议里很常见。
正文后面追加 0x0A,接收端一直读到 0x0A 为止。
可读性好,调试也方便。
代价是正文不能随便出现分隔符,要么转义,要么换一个不会出现的字节。
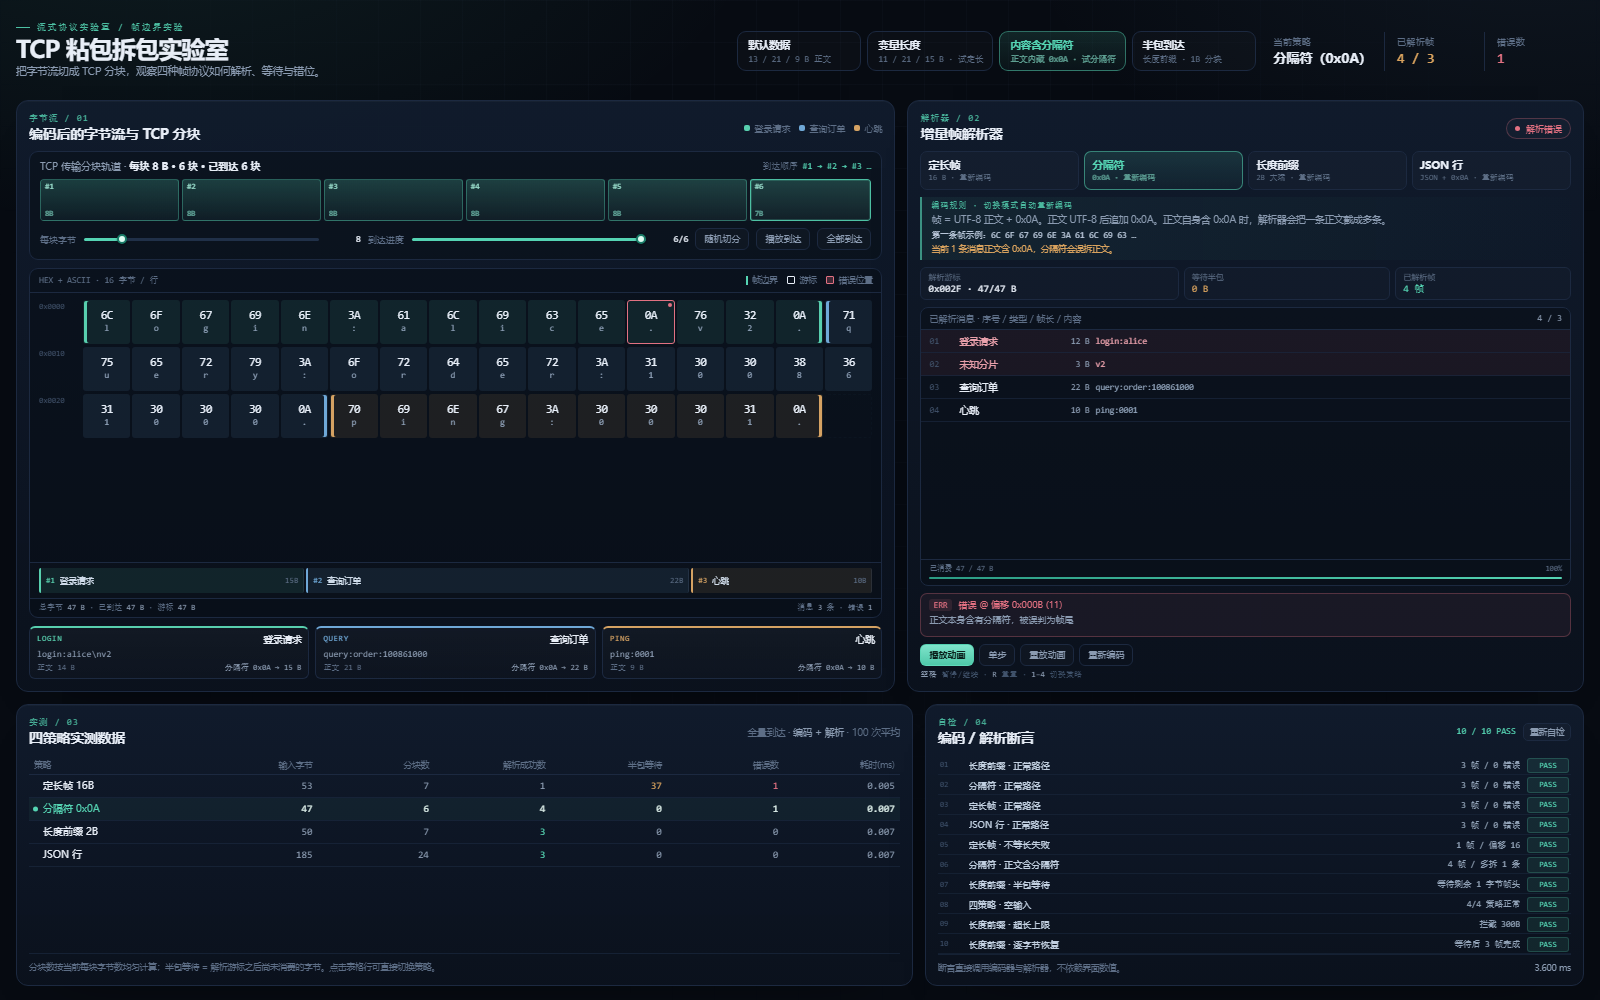
“内容含分隔符”预设里,登录消息正文是 login:alice 加换行再加 v2。
解析器切出 4 帧,比真值多 1 条,多出来的那条显示为“未知分片 v2”。
长度前缀是二进制协议最常见的选择。
帧头两字节大端写正文长度,后面跟 UTF-8 正文。
接收端先读 2 字节,知道后面该收多少,再收正文。
缺点是帧头本身也可能半包。
“半包到达”预设把 49 字节切成 49 个 1 字节分块,只到达第 1 块。
页面显示“等待剩余 1 字节帧头”,0/3 帧,0 错误。
这个状态很重要:字节不够时应该等,不是报错。
JSON 行是自描述格式,前端调试最舒服。
每条消息是一行 JSON,用 0x0A 结尾,字段可以随时加。
代价是体积。
同样三条消息,长度前缀 49 字节,JSON 行 183 字节,膨胀 3.7 倍。
中文按 UTF-8 三字节算,键名和引号也要占位。
三、实测:我踩到的三个坑与验证方法
坑一,半包不是错误。
如果看到 1 字节帧头就报“帧头不完整”,网络正常分片也会红。
正确做法是缓冲区加游标:不够就 return,等下一块到了再继续。
页面自检第 7 条专门盯这个状态,期望“等待剩余 1 字节帧头”。
坑二,定长帧的“正常路径”要单独造数据。
界面上三条消息长度不同,定长帧必然失败。
自检第 3 条用三条 16 字节的等长消息,才能验证“能解析”。
第 5 条再用不等长数据验证“会错位”。
一个策略要同时有成功和失败两条断言,否则测试全绿也说明不了边界。
坑三,分隔符冲突不能靠多试几次。
正文里的 0x0A 就是 0x0A,解析器没有上下文,无法分辨它是正文还是帧尾。
要么在编码时转义,要么选一个正文不会出现的分隔符。
这个实验室只演示冲突,没有实现转义,这是它的边界。
验证方式在页面底部。
10 条断言直接调用编码器和解析器,不依赖界面数字。
结果 10/10 PASS,总耗时 3.600 ms。
四条正常路径、定长失败、分隔符多拆、半包等待、空输入、超长拦截、逐字节恢复,各一条。
我还在表格里对了输入字节:49 / 53 / 47 / 183,和字节流的十六进制行数能对上。
四、结果与下一步:使用码道体会
现在它是一个 1600×1000 的单页,四块布局不用滚动。
左边字节流,右边解析器,底部实测表和自检。
键盘空格暂停,R 重置,1~4 切策略。
四个预设分别对应正常、错位、误拆、半包。
亲手点三下就能验收。
第一,看尺子:默认预设下确认 3/3 帧、49/49 B、0 错误。
第二,换输入:拖“每块字节”到 1,看解析器从 3 帧变成等待。
第三,看失败路径:切“变量长度”再点定长帧,必须看到偏移 0x0010 的中文报错。
三步都过,页面才算真能跑。
边界也要说清楚。
这是浏览器里的字节流模拟,没有真的开 socket。
耗时是 JS 循环 100 次的平均值,不是网络 RTT。
单帧正文上限 255 B,长度前缀理论上限 65535 B。
定长帧只适合等长消息,分隔符没有做转义。
使用码道体会,我记了五条:
- 把失败路径写进需求,页面才会把错位和误拆当成一等公民。
- 要求自检直接调用编解码函数,界面数字才不会自说自话。
- 预设比参数面板更好验收,一个按钮就能把状态切到边界。
- 先定数据真值,再让页面算,49 字节、3 条消息、偏移 0x0010 都能手算复核。
- 让生成结果落到单文件,双击可开,读者复现成本最低。
五、准备环境:进入码道 Web
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。
本文用 WebUI 版生成。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source…,登录后直接在对话窗口输入需求,不需要装软件。
六、仓库与复现
git clone https://gitcode.com/OPCTeam/demo_park.git
cd demo_park\codearts-tcp-sticky-packet-lab
start index.html
也可以只下载 index.html 双击打开。
如果只想看效果,先点“默认数据”和“半包到达”,再看“变量长度 + 定长帧”的报错。
粘包不是玄学,是协议少写了一行边界。
把这四种方案各跑一遍,再遇到线上“两条 JSON 粘一起”,就能直接定位到帧头、分隔符或长度字段,而不是先怀疑网络。