juejin-cli 是一个连接本地 Markdown 与掘金发布流程的命令行工具。这篇聊它如何让人和 AI Agent 共享一套可靠的写作工作流。
这篇文章就是使用 juejin-cli 自动化发布的,具体请看下面介绍
安装官网与使用指南 · GitHub 开源项目 · npm 安装包
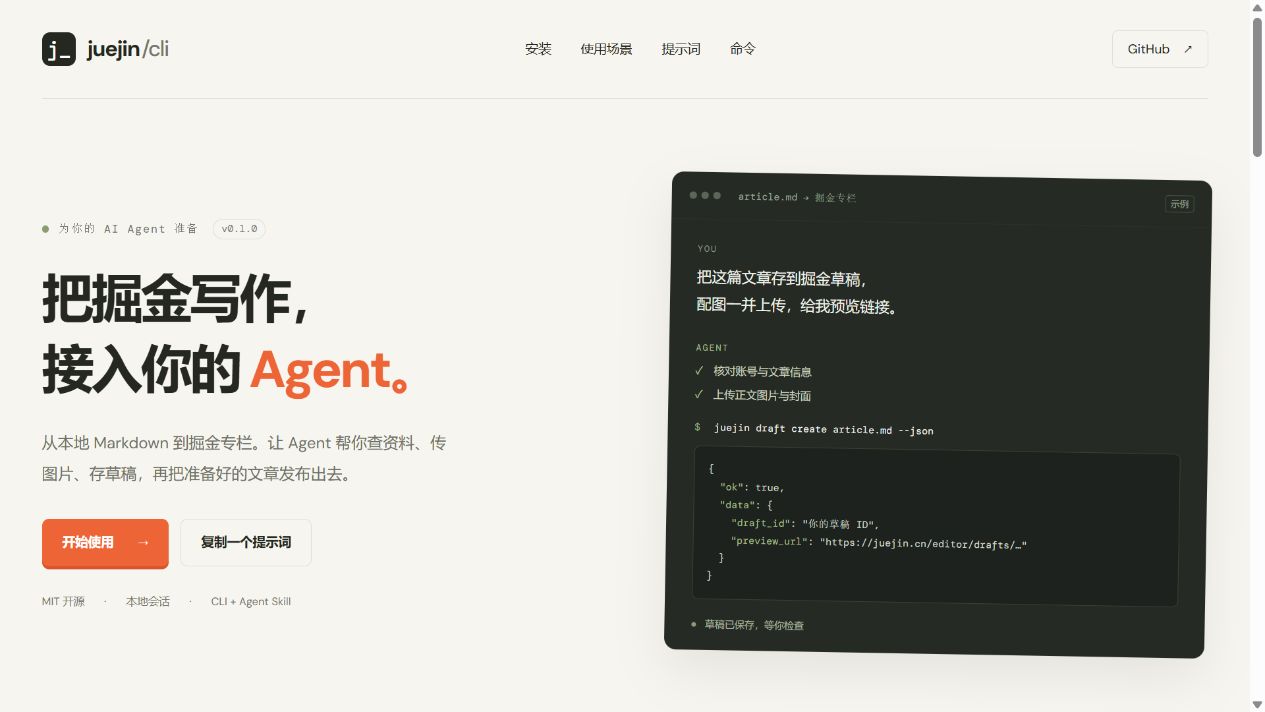
官网提供安装命令、使用场景和可复制的 Agent 提示词。上图是实际页面截图。
写完一篇技术文章,距离发布完成还有一段重复劳动:填写分类和标签、上传图片、创建草稿、选择专栏,再确认平台是否接受提交。文章积累到十几篇后,这些步骤就值得变成可重复执行的工作流。
我做 juejin-cli,希望本地 Markdown 能成为写作入口,让人和 AI Agent 都可以通过同一套命令完成查询、草稿管理与发布。第一版已经发布到 npm。本文结合实现与实际发布测试,记录其中几个比“封装一个 HTTP 请求”更重要的设计问题。
一、让命令描述能力,让结构化结果连接下一步
普通用户可以查看帮助,Agent 则需要知道参数、必填项和合法选项。juejin-cli 从 Commander 的同一套命令定义生成 schema,避免命令已经修改、另一份手写说明却没有更新。
juejin schema article publish --json
juejin draft create ./article.md --dry-run --json
--json 模式成功时在 stdout 返回一个 JSON 文档,失败时在 stderr 返回错误文档和非零退出码。调用者可以据此读取 draft_id,交给后面的更新或发布命令,无需从一段自然语言里猜测结果。
这是接口设计的一部分。对 Agent 来说,稳定的结果结构与明确的失败语义,会直接影响整条工作流能否继续。
二、把职责边界放在变化发生的地方
项目的可执行入口只负责启动 CLI。领域命令在 src/cli/commands/ 注册,依赖在 context.ts 组装;平台请求和类型放在 src/platform/juejin/,HTTP 层统一处理业务错误与空数据。
Markdown 解析、图片路径识别和正文替换放在 src/content/。会话、浏览器和 Skill 安装属于运行时。草稿、专栏和发布等写入流程则由 WritingService 编排,负责锁、读取合并与操作回执。
这样的拆分有一个实际好处:平台接口变化时,可以集中修改平台层;用户提示需要调整时,可以修改 CLI 展示;SDK 和 CLI 仍然复用同一套底层能力。命令树也按调用创建实例,避免进程内多次运行互相污染参数。
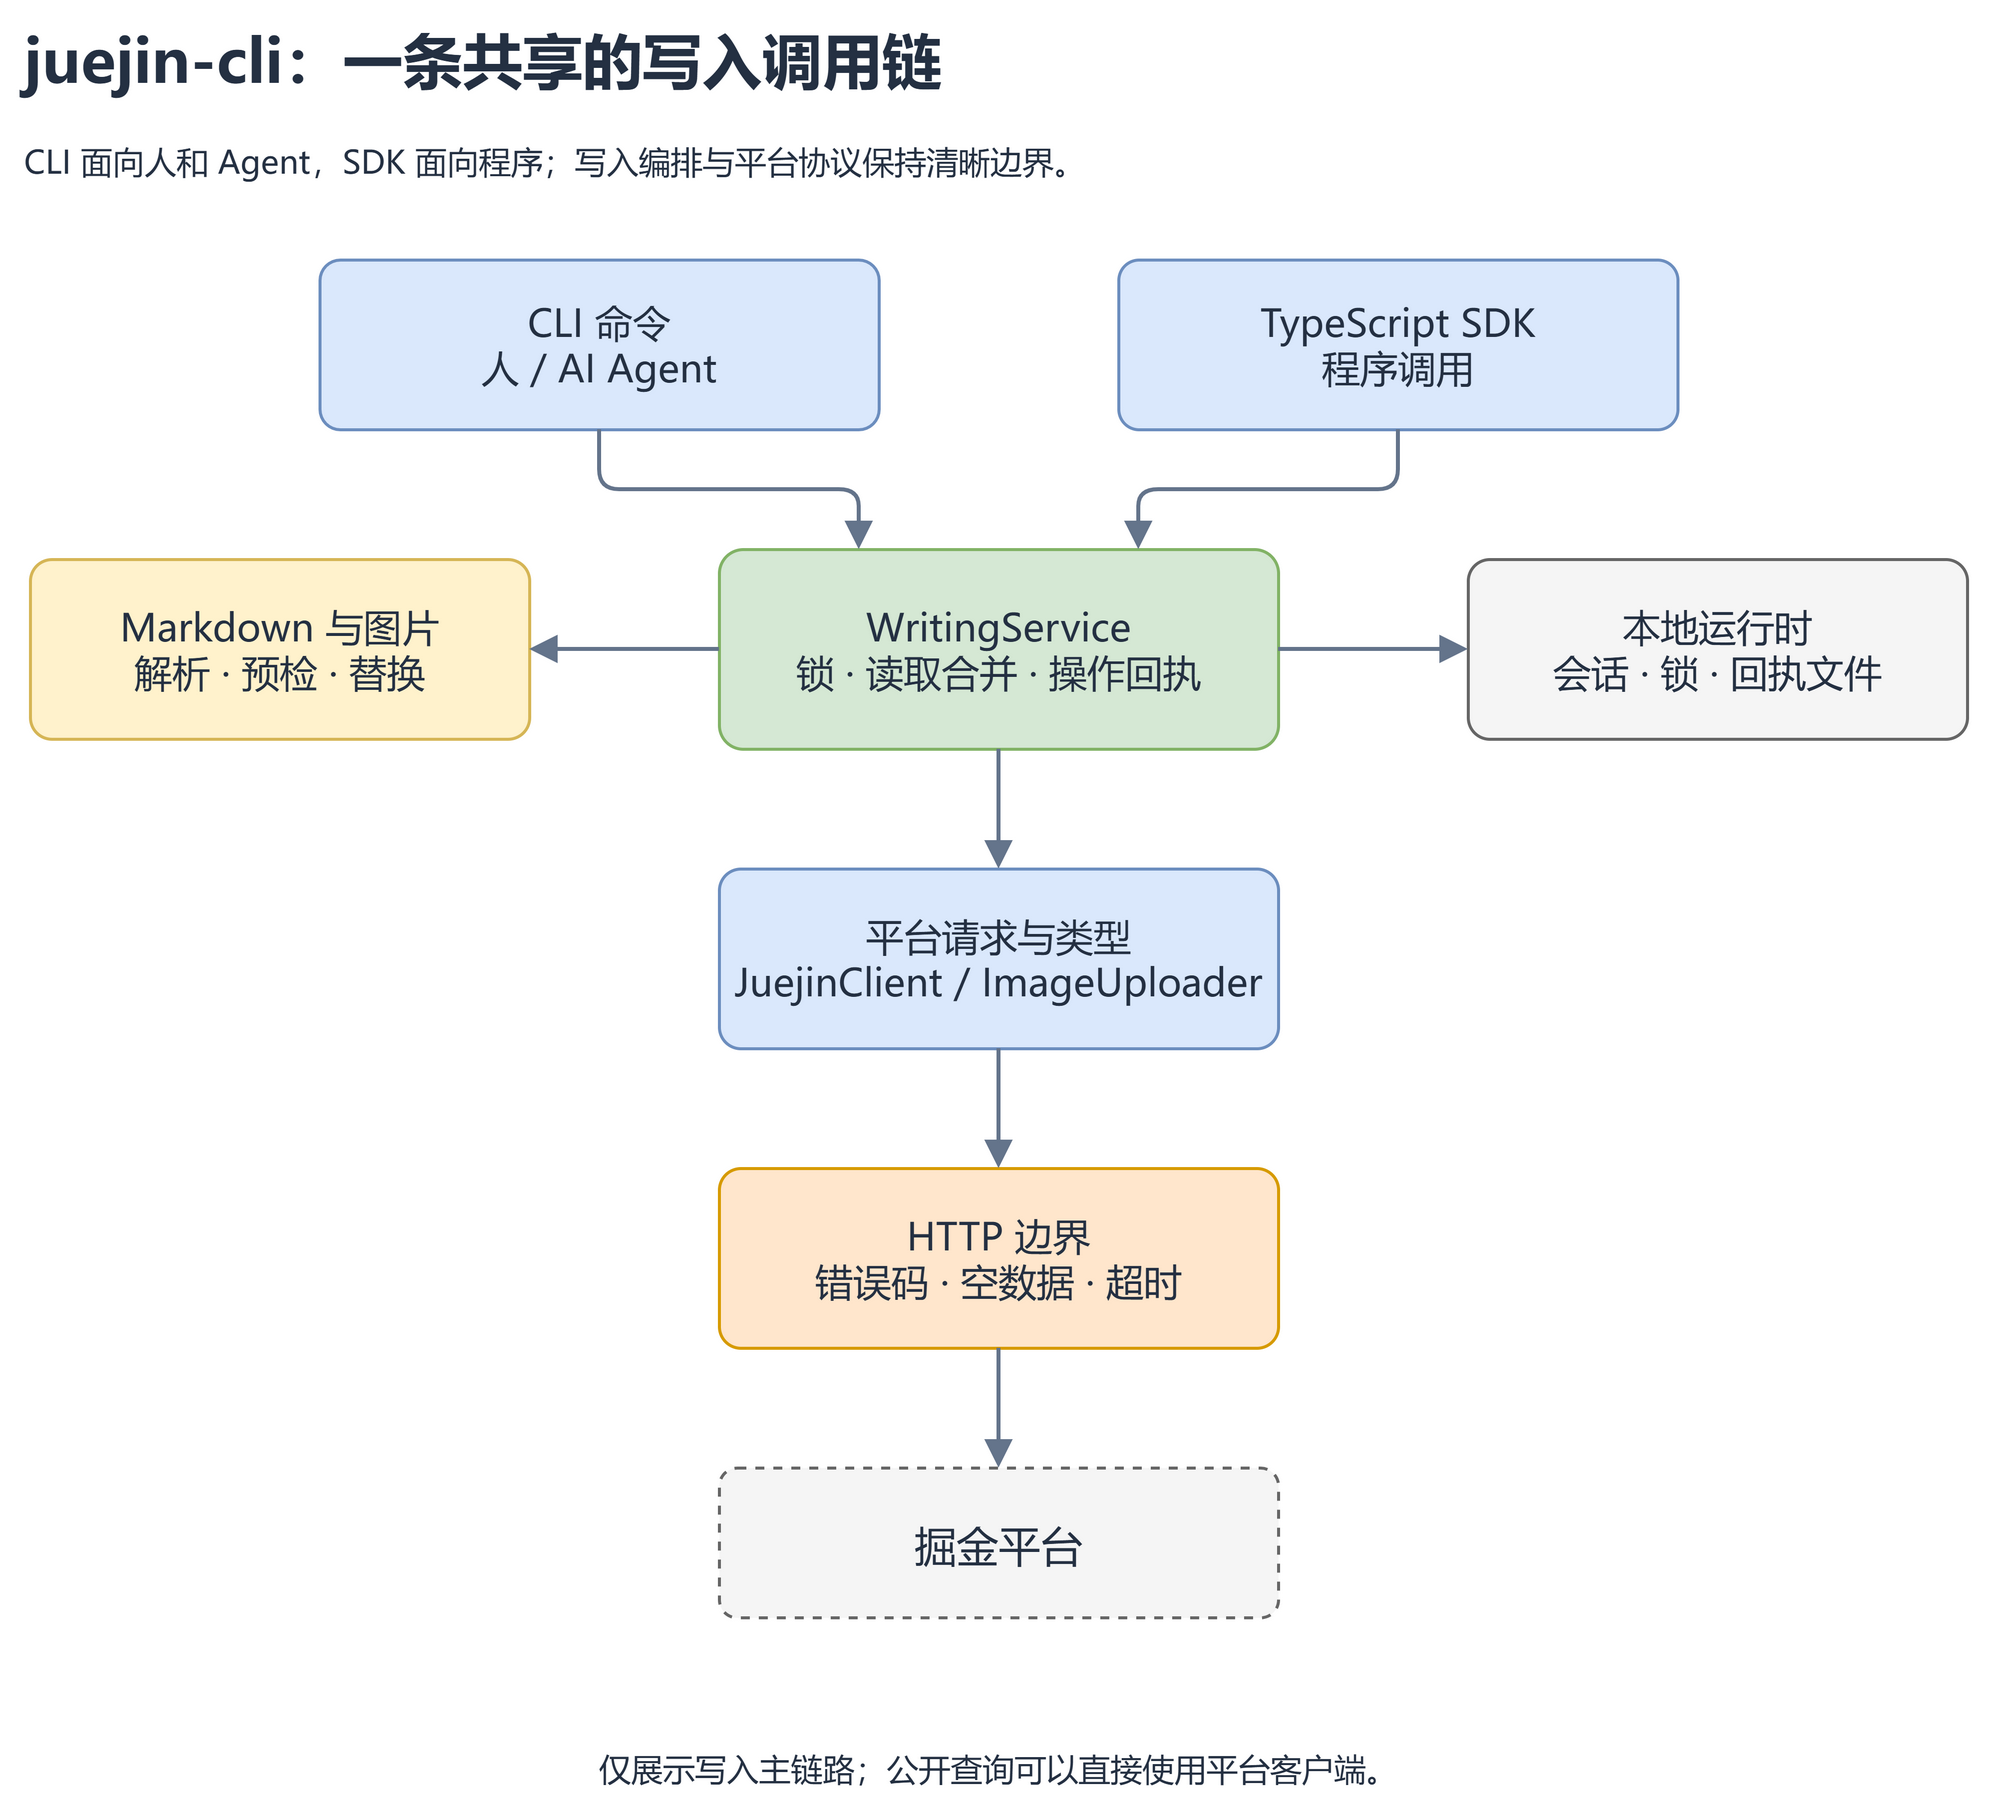
图中 SDK 指供程序直接调用的接口。两种入口共享写入逻辑,避免命令行和程序调用产生不同的业务行为。
三、Markdown 是输入,发布配置也应当可复用
文章文件可以携带 frontmatter,把标题、摘要、分类和标签放在正文旁边:
---
title: 我的 TypeScript 实践
brief: 此处填写五十到一百字的文章摘要,概括问题、方法和结果。
category: 开发工具
tags:
  - "6809640543006490638"
---
上面的摘要只是字段示意,实际内容仍需满足长度要求。标签 ID 用字符串保存;这也避免了 JavaScript 对大整数精度的影响。
本地图片路径相对于文章文件。上传前先检查文件是否存在和格式是否受支持,随后替换上传后的正文引用,原始 Markdown 保持不变。对作者而言,文章和素材仍然可以放在自己的目录或 Git 仓库中管理。
固定信息适合做成模板,但模板不应该替作者编造内容。教程适合按“问题—实现—验证”组织,排障记录适合按“现象—定位—修复”组织;发布配置则优先采用文章已有信息和用户指定的专栏。样式判断需要理解内容,命令行负责忠实执行已经整理好的文件。新版把写作原则与 draw.io 绘图技能一起打包,Agent 可以直接读取本地指南,根据素材决定章节,并把可编辑图源导出为清晰配图。
四、写入超时不等于写入失败
最容易被忽视的情况是:平台已经保存了草稿,但客户端没有收到响应。此时自动重试创建,可能产生第二份草稿;对发布操作也是如此。
juejin-cli 不会在请求异常或超时后自动重放写入。写操作前后记录 operation ID、阶段以及已知的草稿或专栏 ID。后续可以查看回执:
juejin history --json
回执无法消除网络不确定性,却能给恢复过程留下线索。用户或 Agent 应先核对远端状态,再决定是否继续。已经取得的草稿 ID 应当沿用,更新文章时调用 draft update,而不是再创建一份。
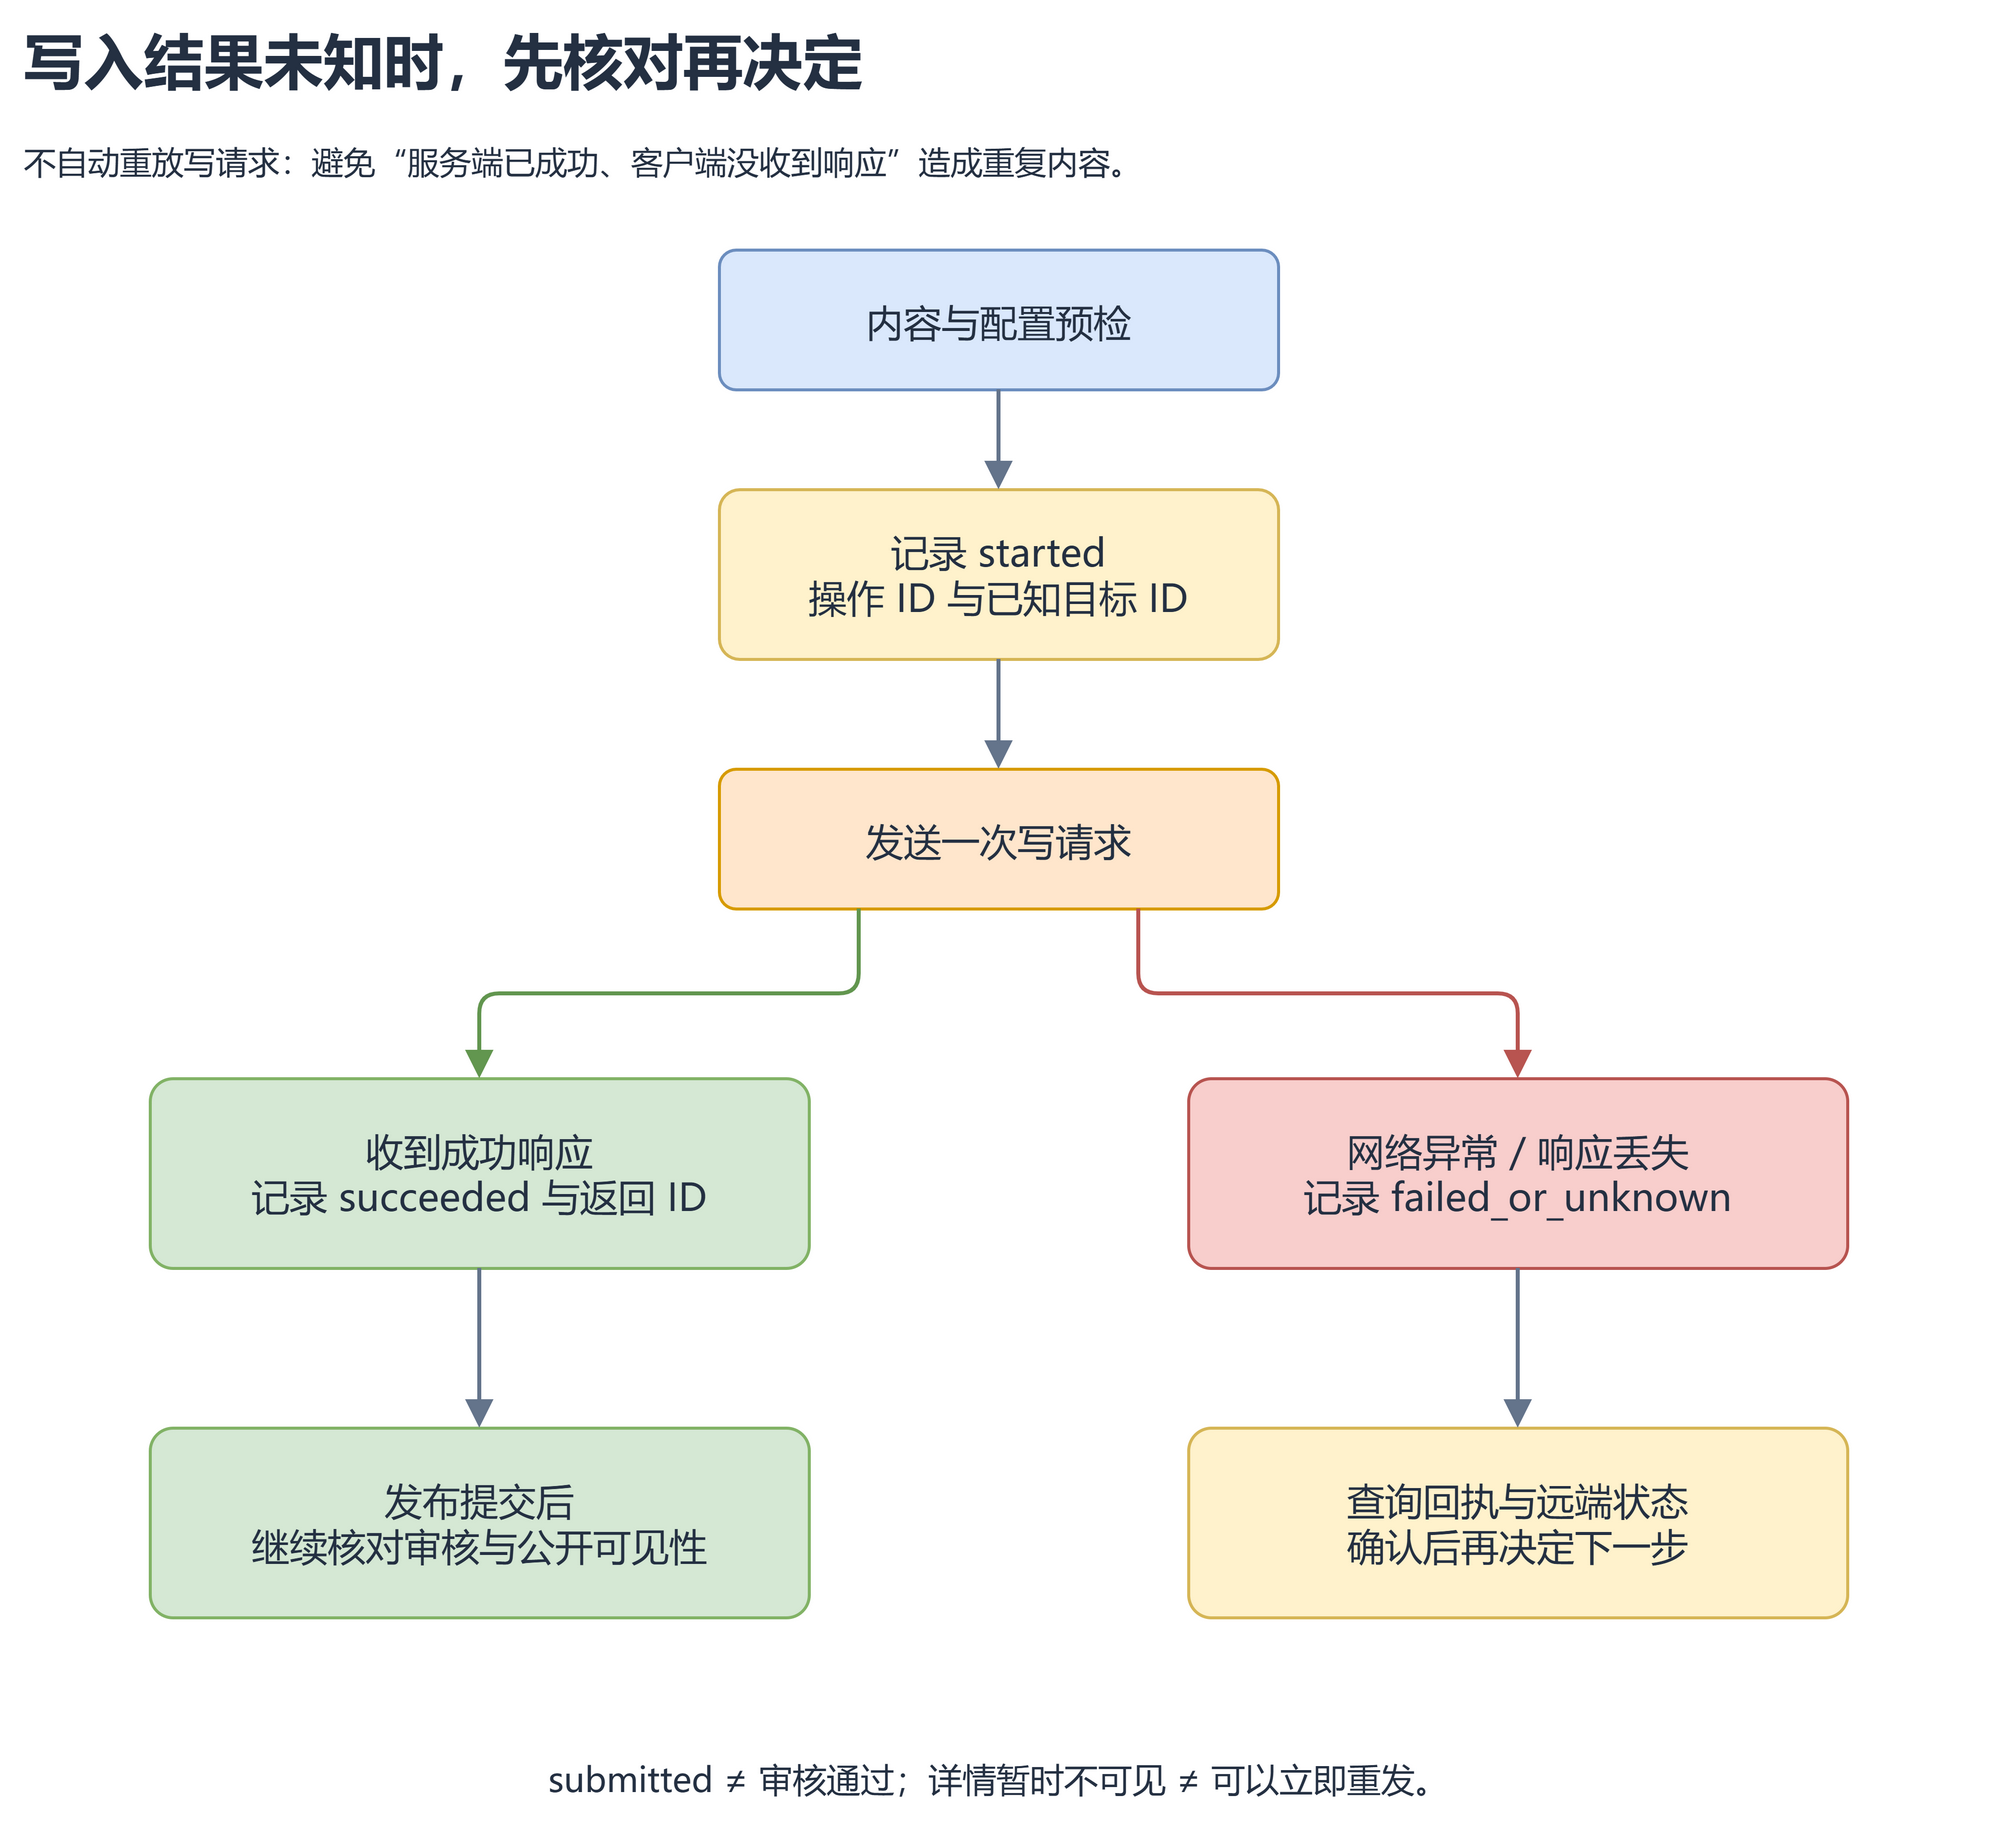
最后这条分支不会自动回到“发送请求”。它保留不确定状态,让恢复过程有依据。
同样,发布结果中的 submitted 只表示平台接受提交。审核或索引尚未完成时,公开详情可能暂时不可见。工具应把这种区别说清楚,避免用户误以为发布失败而重复提交。
五、速度优化首先来自减少不必要的工作
真实测试中发现,草稿准备阶段按名称解析标签,即使找到完全匹配项,原实现仍会继续遍历后续标签页。本轮改进让精确匹配立即结束,同时保留公开标签搜索的完整结果。
另一种更直接的办法是把确认过的标签 ID 写入模板。这样每次保存文章都不必重新搜索名称。它减少的是不必要的读取,并不会改变写请求不自动重试的原则。
对用户来说,等待也需要可理解的反馈。0.2.0 更新在普通模式中增加等待提示,并在提交后说明审核状态。JSON 模式继续保持稳定的单文档结果,方便自动化消费。
六、批量发布需要预检和进度,而不只是循环
本轮增加了一个目录级发布入口:把同一目录中的 Markdown 统一预检,再逐篇发布到指定专栏,保存每篇文章的草稿 ID 和文章 ID。
它的关键约束是:先发现输入错误,再开始写入;已经确认完成的文章可以跳过;上次写入结果未知时,停止自动执行并提示核对回执。否则,一个简单的循环很容易在中断后制造重复内容。
这一批量入口已完成本地验收,将随 0.2.0 发布,0.1.0 不包含此命令。文章中的架构讨论也不意味着所有目标已经实现:例如搜索接口对条数限制的实际行为、审核状态查询和测试内容清理,仍需要继续完善。
七、把“成功”定义在用户真正关心的位置
接口返回成功、草稿保存成功、发布提交成功、读者能看到文章,是不同的结果。验收时需要分别记录,而不是统一归为“通过”。
已有实测覆盖了登录、查询、图片上传、草稿创建和更新、文章提交、专栏创建与更新。一次占位测试文章虽然提交成功,随后却被审核拒绝,促使我们把自动化测试限定在草稿,并给正式发布增加正文预检。一次成功不能证明长期成功率达到 95%;更可信的方法是持续记录具体场景、请求耗时和失败原因,并保留可以复现问题的输入。
juejin-cli 的技术取舍围绕这些具体问题展开:让命令可发现,让输入可预检,让结果可衔接,让失败可恢复。它还在演进,而每一次用它发布真实文章,都会暴露下一处值得改进的细节。
项目源码:Ganzhib/juejin-cli