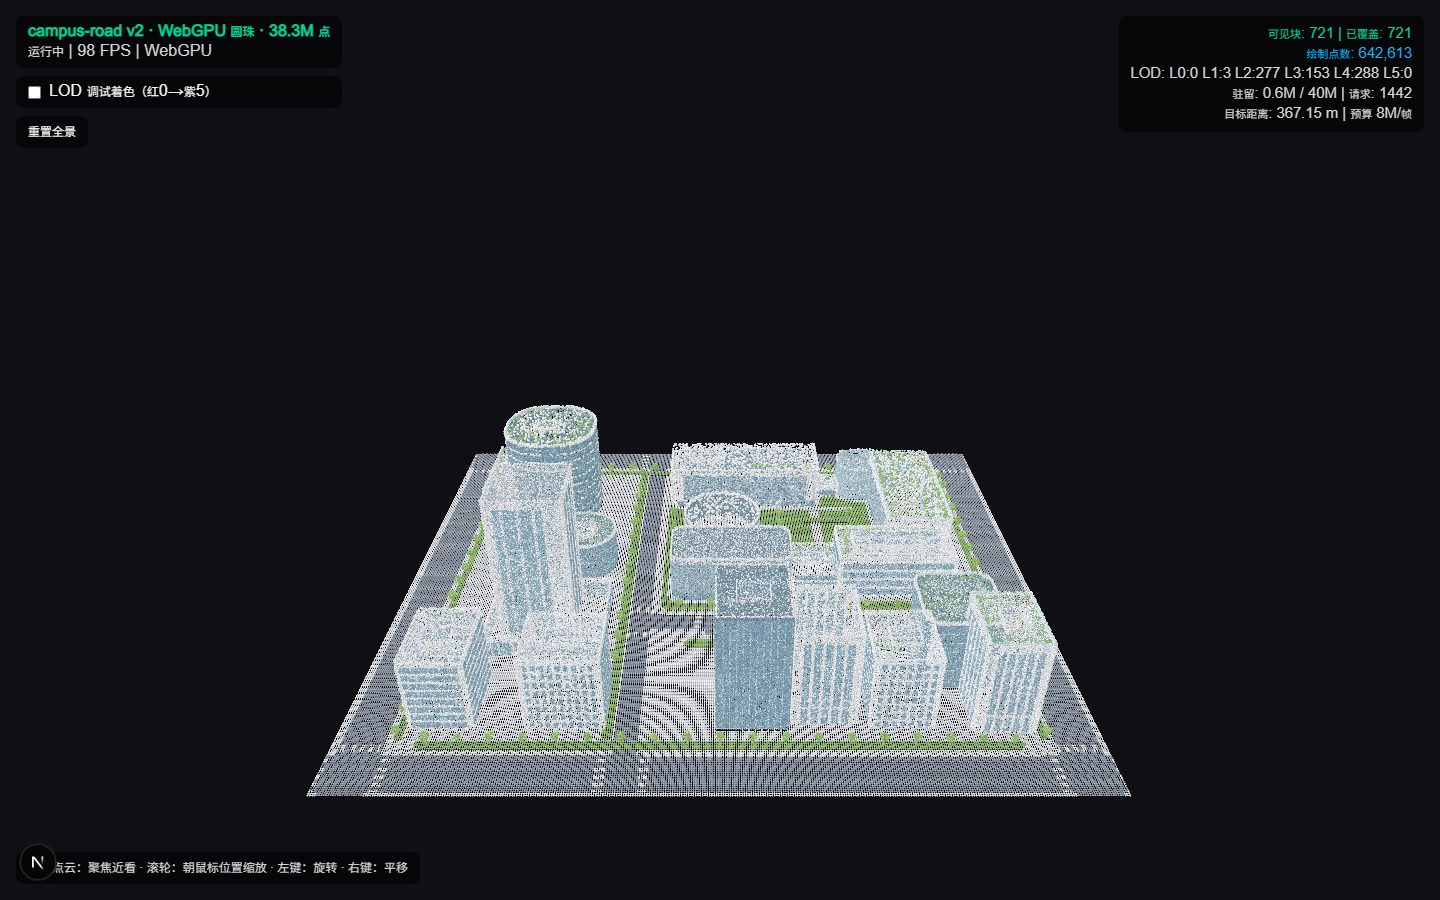
图 1:WebGPU 点云查看器全景效果,当前视角提交约 64.3 万个点实例。
点云优化不只是“减少点数”。更关键的是:数据如何组织、如何从二进制进入 GPU、如何按视角选出需要的细节,以及如何让加载、绘制和内存占用保持可控。本文以 L0 含 38,300,617 点的园区数据为例,从数据结构与 Three.js 渲染原理出发,逐步实现分块、LOD、预算调度和 WebGPU 圆珠渲染,最后展示真实页面效果与性能评估。
一、为什么要进行点云渲染优化?
1.1 从车道级点云标注的业务需求出发
公司最近在做车道级点云标注项目,其中一个重要问题就是点云的加载与显示效率。标注人员需要在道路场景中反复平移、旋转、缩放,查看车道线、路沿以及周边结构。如果每次切换区域都要长时间等待,或者放大以后出现缺块、细节迟迟不更新,操作连续性就会被打断。
对这类应用来说,“能把点画出来”只是起点。我们更关心的是:能不能尽快看到当前作业区域,靠近时能不能补充足够细节,连续切换视角后内存会不会持续增长。
因此,本次优化从业务中的加载问题出发,将数据组织、请求调度和 Three.js 渲染作为一个完整链路来处理。本文使用园区道路样例验证这条技术路线,不把样例展示等同于完整标注系统的业务验收,也不声称已验证车道级标注精度。
1.2 点云是三维应用中的基础数据形态
点云由空间采样点及其颜色、强度、类别等属性组成,可以表达道路、建筑、设备和自然环境的三维结构。除道路场景标注外,它也广泛用于测绘成果浏览、数字孪生、建筑与工厂扫描、机器人环境感知、三维重建以及工业检测。
这些应用的业务目标不同,但经常面对同一组工程问题:数据范围大、采样密度高、局部细节重要,而终端能够承担的下载量、内存和每帧绘制成本有限。
真正需要解决的不是“无条件显示更多点”,而是让存储中的海量点云,按当前任务和视角转换为有限、可解释的工作集。
1.3 理解点云渲染,也是理解 Three.js 性能的过程
点云很适合用来串起三维渲染中的关键知识:二进制数据如何成为 BufferAttribute,空间包围盒如何参与视锥裁剪,相机距离如何转化为 LOD 精度需求,几何提交和像素填充如何影响每帧成本,以及异步加载与缓存如何维持交互连续性。
理解这条链路,才能区分问题究竟出在网络、解码、CPU 调度、GPU 几何处理还是片元着色,而不是把所有卡顿都归因于“点太多”。这些方法也能迁移到大场景模型、地形、实例化物体和其他 Three.js 可视化项目。
二、本次优化预期:面向百亿点,先验证千万级工作集
2.1 数据规模目标与当前验证范围
长期目标是支持总量达到 100 亿点的数据集按需浏览与加载。这里的“支持 100 亿点”,不是把 100 亿点同时下载到浏览器,更不是要求每帧绘制 100 亿点,而是让用户可以在这样的数据集中选择作业区域,并持续获得当前视角需要的数据。
按本文当前格式估算,100 亿点的 9 B 原始记录约为 90 GB;展开为 24 B 的位置与颜色属性后约为 240 GB,还没有计入多级 LOD、GPU 副本和临时缓冲。这说明全量装入内存的路线不适合浏览器,必须采用分区、分层索引与流式工作集管理。
鉴于当前存储条件、测试数据和实现阶段,本文先使用 约 4000 万点的数据集开展验证,准确的 L0 点数为 38,300,617,划分为 721 个 Tile。当前全景实际绘制约 64 万点、3 米近景约 310 万点,并不是每帧绘制全部 3830 万点。
百亿级仍是后续架构与压测目标。当前结果只证明这份千万级样例上的实现效果,不能直接外推为百亿级已经落地。
2.2 加载速度与交互目标如何定义
我们预期的加载体验是:先快速获得可操作的粗略场景,再逐步补齐局部细节,而不是等整份数据加载完成才显示。 因此,加载速度需要拆成三个阶段:
- 首次可见时间:从进入页面开始,到目标区域出现首批可辨认点云。
- 首屏覆盖时间:到当前视锥候选块都获得粗级覆盖,而不是只出现一个孤立块。
- 细节收敛时间:相机停止变化后,到当前目标 LOD 加载与替换完成。
为使后续测试可以验收,建议先采用下列阶段性目标。它们是待确认、待测试的工程目标,不是已经达到的结果,也不是脱离网络和硬件条件的性能承诺。
| 维度 | 建议的阶段性目标 | 本文当前状态 |
|---|---|---|
| 数据规模 | 面向 100 亿点总量做按需加载设计 | 已验证约 3830 万点样例,百亿级未测 |
| 首屏体验 | 在约定基准设备、数据源与缓存条件下,首次可见 ≤2 秒、粗级覆盖 ≤5 秒 | 尚未采集对应计时,不能宣称达标 |
| 视角切换 | 先保持已有表示,再补新区域;在约定测试路径与网络条件下,停稳后目标 LOD 收敛 ≤2 秒 | 已验证稳态覆盖与升降级,尚未系统测量收敛时间 |
| 交互连续性 | 面向 60 FPS 优化,并关注 P95 帧间隔,建议以 ≤33.3 ms 作为阶段性长帧目标 | 目前仅有无头浏览器帧回调数据,部分近景 P95 为 33–37 ms,未全面达到该目标 |
| 工作集 | 当前阶段将每帧实际点实例限制在 800 万预算内,离屏资源可回收 | 已有预算与离屏回收;尚无严格字节级内存上限 |
| 标注可用性 | 作业区域不因预算分配被整块隐藏,细节与拾取结果能满足标注需求 | 已验证样例块覆盖,尚未完成标注精度与拾取延迟验收 |
正式验收时,需要固定设备、网络带宽与延迟、缓存冷热状态、视口尺寸、初始视角及测试路径。首屏计时包含索引获取、解码和首帧显示,细节收敛计时从相机停稳开始;不同口径不能混成一个“加载耗时”。正文末尾仅报告已完成的测量。
三、实现技术路线:数据分层与视角驱动调度
整体方案不是单独替换一个渲染 API,而是将离线数据生产与在线渲染连接起来:
点云数据
  → 空间分块 Tile
  → 多级 LOD 与量化记录
  → 索引 / AABB / spacing / 文件清单
  → 根据相机矩阵进行视锥裁剪
  → 结合距离、FOV、视口高度选择期望 LOD
  → 覆盖优先的全局点数预算
  → 有优先级、有并发限制的异步请求
  → 解压与反量化,构造 Three.js 实例属性
  → WebGPU 点片 / 圆珠绘制
  → LOD 替换与离屏工作集回收
3.1 数据端:为局部加载创造条件
先将数据组织成空间 Tile,每个 Tile 提供真实 AABB、量化原点和多个 LOD。位置使用局部 Int16 量化,颜色使用 UInt8 存储;通过索引在加载点记录之前就知道块的位置、各级点数和采样间距。
这一步解决“数据能否独立选择、独立传输与独立释放”。如果只有一个全量文件,后端与前端都很难做到低成本的局部访问。
3.2 调度端:把相机视角转换成数据请求
首先用视锥剔除完全位于视野外的块,再根据相机距离和屏幕空间误差计算需要的 LOD。将期望精度交给预算分配器,得到设备当前允许的目标精度,最后只请求缺少或需要替换的数据。
这一层解决“现在需要哪些块、每块需要多细、谁先加载”。它也是降低无用请求与无用绘制的主要位置。
3.3 渲染端:批量处理,而不是逐点创建对象
数据到达后解码为连续属性数组,用 Three.js 的实例化几何批量提交。对于需要可调尺寸的 WebGPU 点云,采用共享四边形加实例位置与颜色,利用片元着色实现圆形轮廓和球面明暗。
这一层解决“如何把被选中的点交给 GPU”。圆珠是视觉表达选项,并不是无成本的性能优化;更好的外观可能增加三角形数量与片元计算。
3.4 资源端:让漫游成本不随历史访问无限累积
通过合法的 LOD 升降级、实际绘制数量限制以及离屏回收,避免看过近景后一直保留不必要的细数据。长期百亿级目标还需要补充分层空间索引、元数据分页、分包范围请求、Worker 解码和严格字节预算。
下面按这条路线,依次展开数据结构、Three.js 渲染、相机驱动的 LOD 请求与视锥裁剪,最后对照新旧实现,给出真实页面效果和性能评估。
四、先建立认识:点云与三角网格有什么不同
点云只记录离散点的位置与颜色等属性,不像三角网格那样通过顶点连接关系形成表面,因此其显示质量取决于采样密度、LOD 调度与点的屏幕尺寸,而不是增大点尺寸就能补出真实几何细节。
五、存储结构:从一条 9 字节点记录开始
本案例将每个点存为 6 字节的局部量化坐标(Int16 XYZ)与 3 字节的颜色(UInt8 RGB),合计 9 字节,加载后依据 Tile 的原点和比例恢复坐标,并展开为供 Three.js 使用的 Float32 位置、颜色数组,因此运行时属性为 24 字节/点,不能用压缩文件大小推断内存占用。
六、空间结构:Tile 负责“在哪里”,LOD 负责“画多细”
6.1 为什么不能只有一个巨大 BufferGeometry
一个全量几何体虽然 draw call 少,但只要它的整体包围盒与视锥相交,渲染器就可能提交其中大量根本看不见的点。它也不利于按区域请求、替换和释放数据。
因此我们把场景划分为 721 个空间 Tile。每个 Tile 独立描述包围盒、量化参数和多级采样:
interface Tile {
  tileId: number;
  origin: [number, number, number];
  scale: number;
  boundsMin: [number, number, number];
  boundsMax: [number, number, number];
  lods: Array<{
    level: number;
    points: number;
    spacing: number;
    file: string;
  }>;
}
这是便于阅读的概念结构,生产索引可用紧凑数组存储。
其中:
origin用于反量化,不一定是几何中心;- AABB 用于空间查询与视锥裁剪;
points用于请求大小估算与预算分配;spacing表示名义采样间距,用于估计屏幕误差;file指向对应级别的点记录。
当前案例是扁平 Tile 索引 + 每 Tile 多级 LOD,并未实现运行时八叉树遍历。不能因为有 LOD,就把它称为八叉树点云引擎。
6.2 LOD 是不同采样密度,不是不同视角的模型
L0 最细,编号越大越粗。同一个 Tile 的各 LOD 表示同一空间范围,通常只绘制其中一级,避免叠加绘制造成重复点与过度绘制。
| 层级 | 实际记录点数 |
|---|---|
| L0 | 38,300,617 |
| L1 | 9,575,321 |
| L2 | 2,393,998 |
| L3 | 606,306 |
| L4 | 168,525 |
| L5 | 120,907 |
| 全部层级记录之和 | 51,165,674 |
3830 万表示最细层记录数,5117 万表示各 LOD 存储记录之和,后者不能解释成独立原始点总量。
对分布在建筑表面、道路表面的采样而言,间距扩大两倍,点数常近似降到四分之一,因为这是近似二维表面采样。若是均匀三维体积采样,比例可能接近八分之一。实际数量还受边界、遮挡、特征保留和每块最小点数约束影响,不能机械套用公式。
常见离线 LOD 生成方法包括体素下采样、随机采样和保特征采样:
- 体素采样更容易控制空间均匀性,但可能削弱细线和小物体;
- 随机采样实现简单,却可能让局部小结构消失;
- 保特征采样会优先保留立面、边缘等内容,但生产逻辑更复杂。
这里介绍的是通用方法,不据当前索引反推生产器一定采用了其中哪一种。运行时必须把实际点数与 spacing 作为数据契约读取。
6.3 空间树与分包是两个不同维度
更大场景通常需要八叉树或分层 Region:父节点提供大范围粗表示,子节点按需展开,避免每轮扫描全部 Tile。
而 Pack 是传输与存储组织,把多个块打包,以减少文件数,并支持按范围读取。空间树决定选谁,Pack 决定从哪里、读多少字节。
当前项目仍按 Tile/LOD 下载完整 gzip 文件,索引中的打包流偏移不能再用于切片这个独立文件。分层索引和 Pack/Range 请求属于扩展方向,不是本案例已经完成的能力。
七、Three.js 如何把这些数据变成画面
7.1 三个角色:Geometry、Material、Object3D
可以把 Three.js 的渲染组织理解成三层:
| 对象 | 职责 | 点云中的内容 |
|---|---|---|
| BufferGeometry | 描述几何属性与缓冲布局 | 位置、颜色、索引、实例属性 |
| Material | 决定顶点处理与片元外观 | 颜色、点尺寸、圆形裁剪、明暗 |
| Points / Mesh | 把几何和材质放进场景 | 变换、可见性、绘制类型 |
基础点云写法如下:
const geometry = new THREE.BufferGeometry();
geometry.setAttribute("position", new THREE.BufferAttribute(positions, 3));
geometry.setAttribute("color", new THREE.BufferAttribute(colors, 3));

const material = new THREE.PointsMaterial({ vertexColors: true });
const cloud = new THREE.Points(geometry, material);
scene.add(cloud);
itemSize=3 表示每个属性元素包含三个分量。渲染器把属性上传为 GPU 缓冲区,并根据几何与材质生成绘制所需的管线。
它不是“一个点一个 JavaScript 对象”,而是“一个批次引用一组连续属性”。这正是千万级数据可管理的前提。
但一个 Tile 一个对象也有成本:721 个可见 Tile 大致意味着数百次点云绘制调用。不能把所有点合成一个对象,也不能无限细分对象,需要在空间裁剪粒度和提交开销之间折中。
7.2 从世界坐标到屏幕坐标
渲染的核心变换是:
clipPosition = Projection × View × Model × localPosition
ndcPosition  = clipPosition.xyz / clipPosition.w
模型矩阵把局部坐标放到世界中,视图矩阵把世界转换到相机坐标,投影矩阵把三维范围映射到裁剪空间。
CPU 侧调度依赖同一套几何关系。若 CPU 包围盒与 GPU 顶点坐标不一致,就可能出现“数据存在、请求成功,却被错误隐藏”的现象。
近景不能只投影块中心来判断可见性:块中心可能在屏幕外,但块的一部分仍覆盖画面。应使用完整 AABB:
const projectionView = new THREE.Matrix4().multiplyMatrices(
  camera.projectionMatrix,
  camera.matrixWorldInverse
);

frustum.setFromProjectionMatrix(projectionView, camera.coordinateSystem);
const inView = frustum.intersectsBox(tileBounds);
包围盒要来自真实范围,而不是把量化原点误当成几何中心。WebGPU 与 WebGL 的坐标约定也应交给正确的 camera.coordinateSystem 处理。
7.3 WebGPU 不会自动扩大原生点
Three.js r180 的 PointsNodeMaterial 源码明确指出:WebGPU 原生点图元固定为 1 像素。对于 THREE.Points,单纯调整 size 或 sizeNode,不能得到任意大小的点。[1]
因此,本项目从原生点切换到实例化四边形。
共享几何:4 个顶点 + 6 个索引
实例属性:instancePosition、instanceColor
每实例:一个面向相机的四边形
主要结构如下,省略了尺寸节点与片元着色代码:
const geometry = new THREE.InstancedBufferGeometry();
geometry.setAttribute("position", new THREE.Float32BufferAttribute([
  -0.5, -0.5, 0,
   0.5, -0.5, 0,
   0.5,  0.5, 0,
  -0.5,  0.5, 0
], 3));
geometry.setIndex([0, 1, 2, 0, 2, 3]);
geometry.setAttribute("instancePosition",
  new THREE.InstancedBufferAttribute(positions, 3));
geometry.setAttribute("instanceColor",
  new THREE.InstancedBufferAttribute(colors, 3));
geometry.instanceCount = pointCount;
普通顶点属性随顶点变化,实例属性随实例变化。同一份小四边形被多次使用,每次读取不同的位置和颜色,而不是创建几百万个 Mesh。
本案例配合 PointsNodeMaterial 的非 Points 路径,实现朝向相机的点片。每个点实例实际绘制两个三角形:三百万点约对应六百万个点片三角形,不能再把它等同于三百万个原生点图元。
7.4 圆珠来自片元计算,而非球体网格
把四边形 UV 映射到 [-1,1],丢弃圆外片元,计算虚拟半球法线:
q = uv × 2 - 1
r² = dot(q, q)
若 r² > 1,discard
n = (q.x, q.y, sqrt(max(0, 1-r²)))
最终颜色 = 原始颜色 × 明暗系数 + 高光
这就是 sphere impostor:用便宜的点片模拟球体外观。它不需要为每个点生成球体网格。
当前实现仍写入点片平面深度,没有按球面重建深度,因此遮挡与交叠不完全等同于真实球体。圆珠之间的空隙也不会自动成为连续表面。
八、调度原理:从“看得见”到“值得画”
8.1 SSE 把采样间距转换成屏幕误差
距离越远,同样的空间间隔投影到屏幕越小。透视相机的近似关系为:
focalPixels = viewportHeight / (2 × tan(fovY / 2))
errorPixels = spacing × focalPixels / max(distance, epsilon)
其中 viewportHeight 使用逻辑像素时,阈值也按逻辑像素理解;DPR 在实际点片尺寸和光栅化阶段保持一致,避免重复乘算。
当前阈值为 2.5 像素,按粗到细寻找第一个满足条件的 LOD;都不满足时使用最细级:
for (const lod of coarseToFine) {
  if (lod.spacing * focalPixels / Math.max(distance, 0.05) <= 2.5) {
    return lod.level;
  }
}
return finestLevel;
本案例 distance 取相机到 AABB 的最近距离,避免大块中心较远、近端表面却已贴近相机时仍选过粗 LOD。这是保守近似,不是逐点误差或遮挡精度保证。
spacing 也必须可靠。不同 Tile 允许拥有不同基础间距,不能把所有 Tile 强行套成同一组常数;名义采样间距不等于每对相邻点的精确距离。
8.2 先保留粗覆盖,再消耗细节预算
SSE 只回答“应该有多细”,没有回答“设备是否承受得住”。因此还需要全局预算。
当前每帧点实例预算为 800 万,分配分为两步:
- 给可见 Tile 预留最粗有效表示。
- 使用剩余预算逐级细化,同一级内优先处理近处 Tile。
可见集合 → 粗级保底 → 计算剩余预算 → 分层细化 → 得到目标 LOD
全场景 L5 合计 120,907 点,仅为 L0 的约 0.316%,所以本案例能够较低成本地保留全景覆盖。
如果直接从近到远吃完预算,再把剩余 Tile 隐藏,远处就会出现大块空白。覆盖优先把“有没有”和“精不精细”分开处理。
但不能承诺任意预算都能覆盖任意数量的 Tile:当最粗表示本身超预算时,需要更高层父节点或进一步空间均匀采样。
8.3 目标 LOD 与当前几何是两个状态
网络请求是异步的,调度器决定使用 L2 时,GPU 上可能仍是 L0。Tile 状态不能只有一个 lod:
interface TileRuntime {
  currentLod: number; // 当前已上传几何
  targetLod: number;  // 调度结果,可存于独立 assignments 映射
  loading: boolean;
  lastUsed: number;
  residentPoints: number;
}
这是概念上的状态拆分,实际实现将目标级放在独立分配表中。
替换规则是:没有几何时先请求粗级;已有几何时保留旧表示;新结果返回后检查是否仍匹配目标,再完成替换。既要允许升级,也要允许合法降级。
为防止下载粗级期间旧细级导致预算失真,实际绘制数量还需要限制:
geometry.instanceCount = Math.min(residentPointCount, assignedPointCount);
不过,按数组前 N 个点截断可能造成暂态空间分布不均。更好的方案是保留粗级缓存,或者离线构建具有渐进空间均匀性的点序列。本文的稳态覆盖结果,不代表切换过程已经完全无跳变。
8.4 工作集管理控制的是生命周期
当前实现离屏 15 秒后可释放块;驻留超过 4000 万点时,按最近使用时间优先释放离屏块。
scene.remove(cloud);
cloud.geometry.dispose();
cloud.material.dispose();
只从 scene 移除对象并不代表释放几何资源。若材质共享,还应采用引用计数,不能在一个 Tile 淘汰时把其他 Tile 共用材质一并释放。
4000 万只是当前回收阈值,不是硬显存上限:它没有完整约束在途解码、待上传数据和所有可见块。仅 4000 万点的 Float32 属性已经约 915.53 MiB。
严格的内存控制需要按字节准入:
已驻留 + 在途解码预留 + 待上传预留 + 本次申请 <= 内存预算
8.5 相机发生变化后,究竟请求哪个 LOD 文件?
相机本身不会直接返回 LOD,也不是每次移动都请求全部数据。当前实现把一次视角变化拆为“空间筛选 → 精度选择 → 预算修正 → 请求差异”四步:
旋转 / 平移 / 缩放 / 窗口变化
  → 更新相机矩阵,重建视锥
  → 用视锥与各 Tile 的 AABB 求交,得到候选块
  → 计算相机到候选块的距离,用 SSE 选出期望 LOD
  → 按全局预算修正为目标 LOD
  → 对比已加载级别,仅请求缺失或需要替换的数据
  → 解压、反量化、上传;仍符合目标才应用结果
方向决定哪些块进入候选集合,位置、FOV 和视口高度决定需要多细;预算决定最终允许加载多细。 相机只旋转、位置不变时,某个仍在视野内的 Tile 距离不变,当前距离型 SSE 不一定改变;但是候选集合和竞争预算的其他 Tile 会改变,因此最终分配仍可能变化。
用当前测试视口说明:高度 900、垂直 FOV=55°,焦距约为 864.4 逻辑像素。假设某个 Tile 的 spacing 序列为 0.15、0.3、0.6、1.2、2.4、4.8 米,阈值为 2.5 像素:
- 距离 300 米:L3 的误差约 3.46 像素,不满足;L2 约 1.73 像素,选择 L2。
- 距离 60 米:L1 约 4.32 像素,不满足;L0 约 2.16 像素,选择 L0。
- 距离 3 米:即使 L0 也约 43.22 像素,仍只能选最细 L0,不能凭空产生额外细节。
这是单个 Tile、预算调整前的计算示例,不是整场景 LOD 分布;另一类 Tile 的基础 spacing 可能为 0.05 米,必须使用它自己的元数据。
以 tileId=87、目标 L2 为例,加载器查找该 Tile 的 LOD 记录与 manifest,优先读取对应的 gzip 文件;无压缩路径为 lod2/87.bin。取得数据后依据点数、量化原点和 scale 解码。当前是完整 Tile 文件读取,不是从全量 L0 临时筛出 L2,也不是已经实现了通用 Range 分包读取。
请求决策可概括为下面的伪代码:
if (!tileIsVisible) {
  hideResidentGeometry(); // 不立即删除,可留待回收或再次进入视野
} else if (!hasGeometry && !loading) {
  enqueue(coarsestAvailableLod); // 先建立覆盖
} else if (currentLod !== targetLod && !loading) {
  enqueue(targetLod); // 同时允许细化和降级
}
当前队列最多 8 个并发,完全没有几何的块优先,再按距离排序。相机持续变化时会重新生成待处理队列;已经发出的请求不会自动全部取消,但结果返回后会检查目标,避免过时数据随意覆盖当前状态。无几何时可先接受有效候选块的兜底结果,再由下一轮收敛到目标级。
相机控制器的 change 事件只标记需要更新。动画循环在有变化时以约 60 ms 的最小间隔重新调度,并每约 200 ms 做周期更新;这是调度检查频率,不是给渲染帧率设置 60 ms 上限。
8.6 视锥裁剪如何判断一个空间块该不该画?
透视相机的可见区域是一个截头锥体,由左、右、上、下、近、远六个平面围成。Three.js 从 Projection × View 矩阵提取这些平面,再检查 Tile 包围盒是否完全落在任意一个平面的外侧。
将一个平面写为 n·x + d = 0,法线朝向视锥内部。对于 AABB,根据法线各分量正负选择使 n·x 最大的角点 p:
const p = new THREE.Vector3(
  normal.x >= 0 ? box.max.x : box.min.x,
  normal.y >= 0 ? box.max.y : box.min.y,
  normal.z >= 0 ? box.max.z : box.min.z
);

// 最靠近内侧的角点仍在外侧,说明整个盒子都在这个平面外
if (normal.dot(p) + planeConstant < 0) {
  return false;
}
对六个平面重复这一过程。只要一个平面能排除整个盒子,就剔除;否则保留为候选。这是保守检测:可能保留少量实际上没有贡献的块,但不能因为中心点离开画面就把相交的块整块删除。实际代码直接调用 frustum.intersectsBox(),无需手写六平面循环。
本案例的坐标转换还包含 Z 轴反向:renderZ = -(dataZ - originZ)。所以包围盒的渲染 Z 最小值应由数据 Z 最大值转换而来,反之亦然。GPU 顶点和 CPU 包围盒必须保持一致。
还要区分三件事:
- CPU 块级视锥裁剪:不请求、不提交完全在视野外的 Tile,减少网络、解码与几何提交工作。
- GPU 图元裁剪:已提交点片中超出裁剪体的部分由图形管线处理,不能追回此前的请求、上传与顶点工作。
- 遮挡剔除:判断块是否被前面的建筑挡住。当前未实现专门的块级遮挡剔除,视锥内但被遮挡的点仍可能提交,最终依赖深度测试。
实例化四边形的基础几何只有原点附近的小方片,普通自动包围体未必反映全部实例位置,因此当前对象设置 frustumCulled=false,由调度器使用真实 Tile AABB 决定可见性。这不是关闭一切裁剪,而是避免渲染器拿错误的小包围体做二次剔除。
九、把原理对应到性能瓶颈
| 瓶颈 | 为什么发生 | 当前措施 | 后续改进 |
|---|---|---|---|
| 网络与解码 | 小文件多、gzip 完整解压、属性转换 | 8 并发,缺失块优先 | Pack/Range、请求取消、Worker |
| CPU 调度 | 全量 Tile 遍历、排序与状态管理 | 721 块规模下节流更新 | 分层空间索引、分页元数据 |
| GPU 提交 | 每个 Tile 一个渲染对象 | Tile 内实例化,避免逐点对象 | 批处理与更合理的块粒度 |
| 顶点处理 | 每个点片需要两个三角形 | SSE 与 8M 实例预算 | 按设备与帧时间反馈调预算 |
| 像素填充 | 大圆珠、重叠和复杂片元着色 | 点片尺寸限制,半径系数 0.7 | 投影面积预算、遮挡策略 |
| 内存峰值 | Float32 展开、GPU 副本、并发替换 | 离屏淘汰与工作集阈值 | 压缩属性、严格字节预算 |
点数不是唯一成本。一个远景点只覆盖几像素,一个近景圆珠可能覆盖几百甚至更多像素;即使实例数相同,片元负载也不同。
半径变为 70% 时,理想圆面积变为 49%,但不能推导 GPU 耗时必然降低 51%。深度测试、重叠、discard 和瓶颈位置都会改变收益。
同样,renderAsync() 返回的 Promise 不等价于 GPU 已完成全部工作。防重入能约束应用层提交流程,但 GPU 时间要单独测量。
9.1 新旧版本对比:哪些是已经落地的优化?
这里的“旧版”指本项目此前的查看器实现,不是一个虚构的完全没有分块、LOD 或回收的基线。旧版已经具备这些模块,主要问题是选级、预算、剔除与状态切换存在缺陷。新版的实际改动如下:
| 环节 | 旧版实际行为 | 新版实际改动 | 减少了什么成本,或修复了什么问题 |
|---|---|---|---|
| SSE 与距离 | 使用块中心距离,结合距离档位,并对 spacing 统一施加推导下限 | 使用真实 AABB 最近距离,尊重各 Tile 有效 spacing,选最粗满足 SSE 的级别 | 减少不必要的细级请求和绘制;贴近块表面时允许正确细化,近景成本也可能上升 |
| 预算分配 | 按近中远固定比例划分配额,一段用完就隐藏剩余块 | 先预留粗覆盖,再共享剩余预算逐级细化 | 减少配额闲置和整块缺失;这是质量与资源利用优化,不保证比直接隐藏块更快 |
| 实际提交 | 目标粗级尚在加载时,旧细级仍可能全部绘制 | 以 instanceCount 限制真实提交数量 | 抑制 LOD 切换时的几何负载峰值,而不只是限制计划点数 |
| LOD 降级 | 拒收更粗结果,拉远后可能无法真正退回粗数据 | 按当前目标验收结果,允许合法升降级 | 减少返回远景后的持续绘制负担及细级驻留 |
| 包围体裁剪 | 曾使用中心点投影,后改球体但中心仍可能是量化原点 | 使用与解码坐标一致的真实 AABB 做六平面测试 | 修复近景误剔除;正确保留可见块可能增加提交量,不能单列为提速收益 |
| 离屏淘汰 | 超时回收还受驻留达到阈值一定比例的条件限制 | 离屏超时或驻留超过阈值时回收候选块 | 减少不再使用的数据长期驻留,但重访时可能需要重新请求 |
| 并发与提交 | 请求并发上限为 24,异步渲染可能重入 | 请求并发上限为 8,renderAsync 增加防重入 | 降低突发解码和应用层提交重叠风险;不代表首屏更快,也不等于等待 GPU 完成 |
| 点外观 | WebGPU 原生 1 像素点,size 设置不能获得大点 | 实例化四边形,圆形裁剪与半球高光 | 改善可调点尺寸与圆珠表达,但增加三角形和片元成本,属于画质改进 |
真正能够解释“快在哪里”的,是减少无必要的 LOD 数据、约束实际提交峰值,以及允许拉远后把细数据降下去。 修复缺块和改成圆珠则主要解决正确性与视觉表达,不能混写成性能加速。
当前重复测试中,全景提交 642,613 点,3.04 米近景提交 3,098,269 点;返回全景后提交与驻留都恢复到 642,613 点。这证明新版可以按视角改变工作量,并在该路径中完成降级。
但这些数字不是旧版与新版的同条件 FPS 对照。L0 的 38,300,617 点只是完整精度规模,不能把它当成每个旧版视角都曾实际绘制的数量。已有数据支持“成本如何被控制”,尚不支持“新版整体快了多少倍”。后文性能表是新版测量,不是伪造的 A/B 加速表。
十、最终页面效果
下面三张图来自实际运行页面,使用同一圆珠尺寸系数 0.7、1440 × 900 视口和与后续测量相同的相机位置。截图与性能采样分开执行,避免截图操作干扰采样。
10.1 全景:保留整体结构,只提交必要细节
全景效果见文章开头的图 1。全景提交 642,613 个点实例,721/721 个可见块均有覆盖。这里的“覆盖”指块有实例参与绘制,不代表所有表面无孔洞,也不表示每个点都会通过深度测试最终可见。
10.2 近景:LOD 细化与圆珠外观
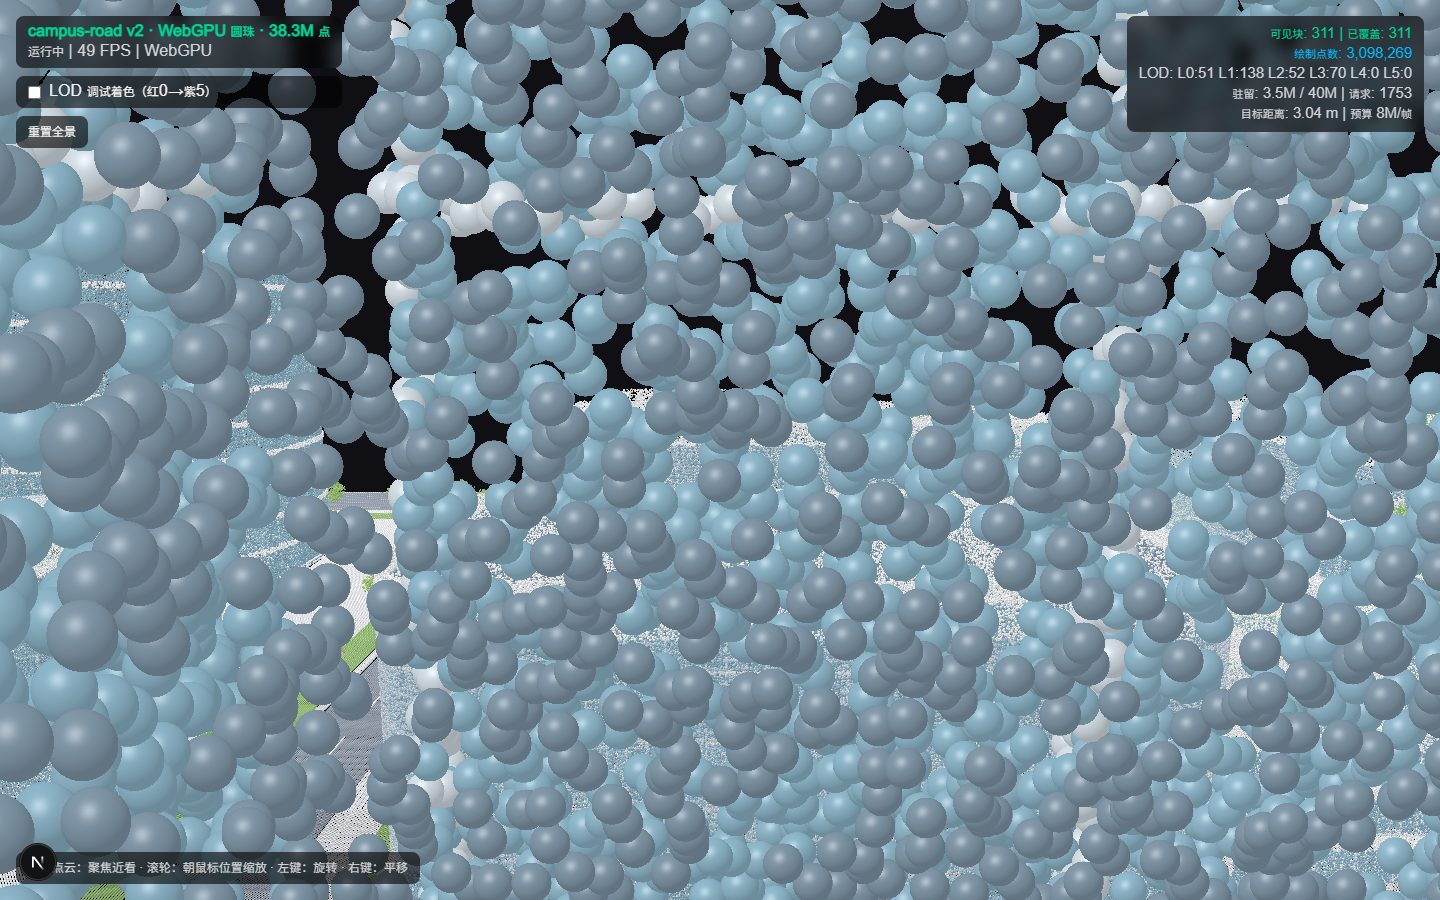
图 2:相机到控制目标约 3.04 米,提交 3,098,269 个点实例,311/311 块有覆盖。圆珠的轮廓、明暗和高光清晰可见,但也能看到颗粒与孔隙。这是离散点片表达,不是连续建筑网格;图中效果说明方案的表达边界,而非证明已实现高保真表面重建。
10.3 贴近:观察点片遮挡与尺寸上限
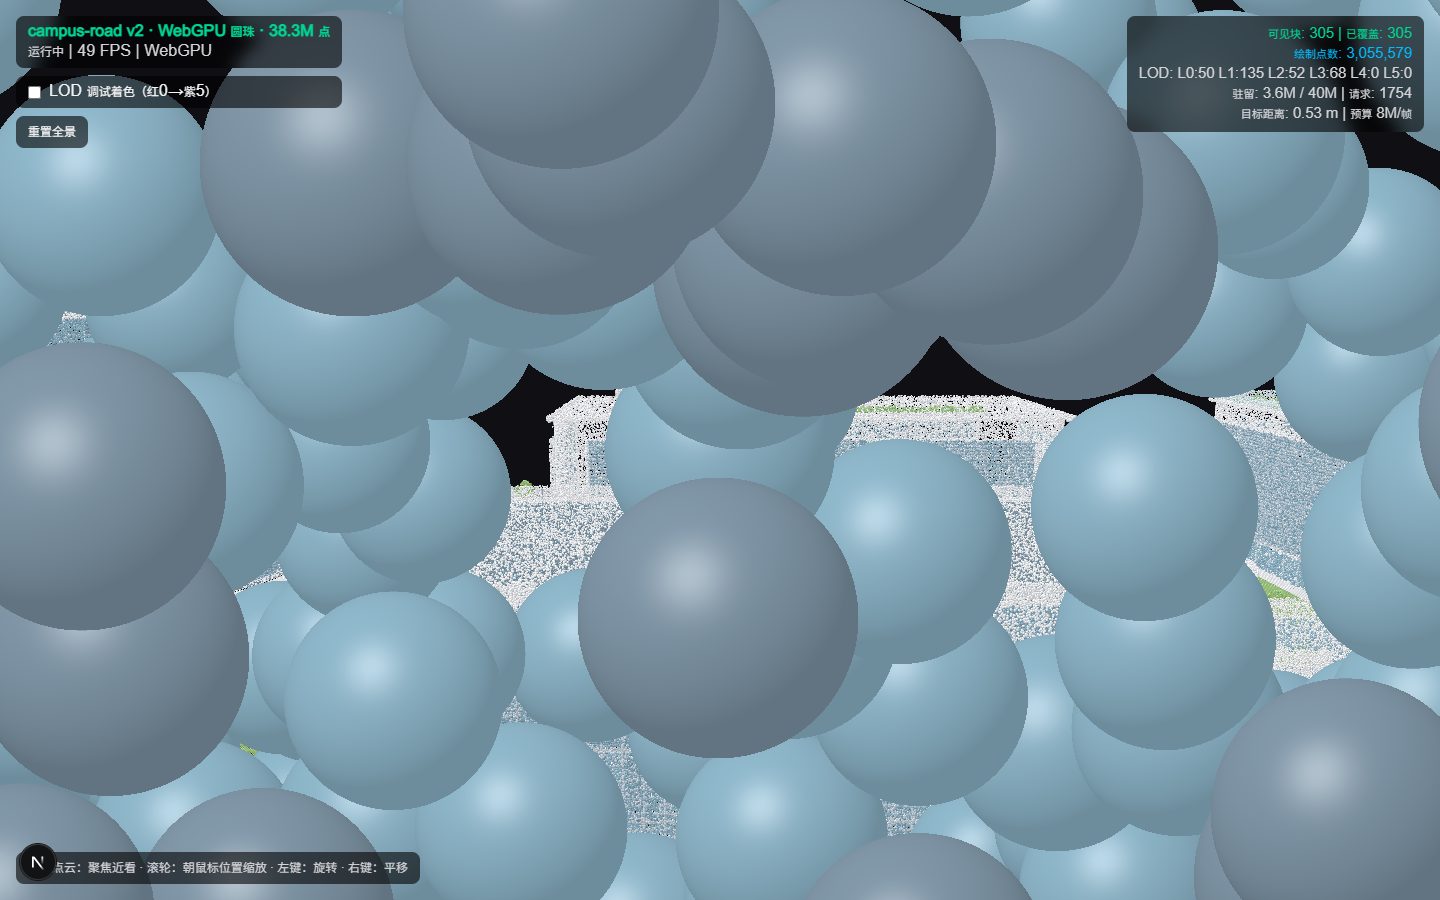
图 3:相机到控制目标约 0.53 米,提交 3,055,579 个点实例,305/305 块有覆盖。极近距离下,仿球体遮挡与点片边界更明显。目标距离不是相机到所有表面的最近距离。
截图 HUD 中的 FPS 是拍摄当时的短窗口观测,不替代下面的重复采样。驻留点数也可能因停留时间与离屏淘汰发生变化。
十一、性能评估:数量、帧间隔和资源成本分开看
11.1 环境与测量方法
| 项目 | 条件 |
|---|---|
| CPU | Intel Core i9-13900HX,24 核 / 32 线程 |
| 内存 | 约 16 GiB |
| 操作系统 | Windows 11,10.0.26300 |
| 浏览器 | Headless Chromium 156.0.0.0 |
| 适配器查询结果 | Intel,gen-12lp |
| 渲染器 | Three.js r180 / WebGPU |
| 视口 | 1440 × 900,DPR=1 |
| 运行环境 | Next.js 开发服务,本地数据 |
| 版本 | 圆珠点片,尺寸系数 0.7 |
| 采样 | 等待 LOD 收敛;每个静态视角测 3 次,每次约 5 秒 |
机器还安装了 RTX 4060 Laptop GPU,但浏览器适配器查询返回 Intel,不能把结果标注成独显成绩。该查询不是 GPU 硬件时间计数器。
测试记录 requestAnimationFrame 回调频率、间隔分位数、实际实例数、驻留点数和覆盖数量。无头模式下的回调频率不等于显示器实际呈现 FPS,也不是 GPU 帧耗时。
11.2 提交数量与工作集
| 场景 | 可见 / 已覆盖块 | 提交点实例 | 驻留点数 |
|---|---|---|---|
| 全景 | 721 / 721 | 642,613 | 642,613 |
| 3.04 米近景 | 311 / 311 | 3,098,269 | 3,537,478 |
| 0.53 米贴近 | 305 / 305 | 3,055,579 | 3,127,853 |
| 返回全景后 | 721 / 721 | 642,613 | 642,613 |
全景实际提交量相对于 L0 总记录数减少约 98.32%,3.04 米近景减少约 91.91%。这是绘制数量比较,不是同画质性能提升比例,也不是严格 A/B 加速比。
全景约 64 万点片对应约 128 万个点云三角形,3 米近景约 310 万点片对应约 620 万个三角形。与此同时,可见 Tile 数减少,所以点云 draw call 变少。可见draw call 更少,不一定更快:点实例数和像素填充成本可能同时增加。
返回全景后,驻留与提交数量回落到 642,613,证明这条测试路径中的 LOD 降级与资源替换确实完成,而不是只改变 UI 统计。
11.3 帧回调频率与长帧
| 视角 | 三次回调频率,次/秒 | P50 间隔 | 三次 P95 间隔 |
|---|---|---|---|
| 全景 | 87.37 / 86.37 / 86.00 | 12.5 ms | 12.6 / 12.6 / 12.6 ms |
| 3.04 米 | 52.82 / 53.19 / 53.06 | 16.7 ms | 37.4 / 37.3 / 37.4 ms |
| 0.53 米 | 54.13 / 54.06 / 54.32 | 16.7 ms | 33.4 / 33.5 / 33.4 ms |
近景 P95 达到 33–37 毫秒,说明仍存在长帧,不能宣称“稳定 60 FPS”。两组近景点数接近,回调频率也接近,但没有 GPU 时间与瓶颈剖析证据,不能据此断言单一瓶颈就是填充率。
测试中渲染器内部调用计数约为 rAF 次数的两倍。内部 pass 会影响调用统计,因此不能直接将 renderer.info.calls 的增量当作应用 FPS。[2]
11.4 资源估算与尚未验证的部分
800 万点按当前 24 B/点属性格式,对应约 183.11 MiB 属性数据;4000 万驻留点对应约 915.53 MiB。两者都只是属性体积估算,不是已实测的 GPU 内存峰值,也不能相加当作两个独立工作集。
本次验证证明:
- 该数据集的三个稳态视角都能完成可见块覆盖;
- LOD 调度能将全景与近景的提交数量控制在不同量级;
- 返回全景后能够完成降级;
- 当前近景仍有长帧与明显的点片画质边界。
本次尚未覆盖:公网冷启动、生产构建、移动设备、长时间连续漫游、真实 GPU timestamp、端到端输入延迟,以及同画质旧版 A/B 对照。
十亿点按 24 B/点就需要约 22.35 GiB 属性数组。要扩展到该规模,应继续引入分层索引、按需加载元数据、Worker 解码、压缩属性、字节级预算与请求取消。当前 721 个 Tile 的实测,不能直接证明十亿点可用。
结语
理解 Three.js 点云性能,可以抓住三条主线:
- 数据结构决定选择粒度:量化减少存储,Tile 支持空间管理,LOD 提供不同精度,空间层级让选择成本不随全量数据线性增长。
- 渲染结构决定执行成本:BufferGeometry 管属性,实例化避免逐点对象,材质决定点片形状与片元计算;WebGPU 不会消除所有成本。
- 调度把质量转化为资源分配:SSE 给出细节需求,预算约束提交量,缓存与回收限制工作集,性能评估验证这些策略是否真正生效。
千万级点云的核心不是一次性画完千万个点,而是让每一帧都能解释清楚:为什么选择这些块、为什么使用这些精度、为什么资源成本没有失控。
参考与复现说明
- 数据:campus-road v2 spacing-fix,L0 38,300,617 点,721 个 Tile;各级点数直接来自索引统计。
- 性能样本:2026-11-05,圆珠尺寸系数 0.7;三个固定视角各 3 × 5 秒,截图在相同视角另行拍摄。
- 数据解码与调度实现:
lib/pc/campus.ts、lib/pc/campus-lod.ts;Three.js 页面实现:app/campus/page.tsx。 - 自动化记录:
campus-article-benchmark.json;测量入口:benchmark-campus-article.cjs。文件名用于描述案例,不表示代码仓库已公开。 - [1] Three.js r180,PointsNodeMaterial:github.com/mrdoob/thre…。本文按安装的 r180 源码验证,不外推其他版本。
- [2] Three.js r180,渲染统计 Info:github.com/mrdoob/thre…。