扫盲:什么是ReAct
2022年,普林斯顿大学和谷歌的研究团队提出的ReAct范式,通过构建“推理-行动-观察”(TAO)的闭环机制,首次实现了语言模型推理能力与外部环境交互能力的深度协同。 ReAct = Reasoning(推理)+ Acting(行动),本质是一种让语言模型通过与外部工具、环境动态交互完成复杂任务的智能体架构范式。其核心目标是打破传统语言模型“输入-输出”的单向链路,构建“感知-决策-执行-反馈”的智能闭环,使模型从“被动应答者”升级为“主动问题解决者”。
问题: 你们用 ReAct 做过 Agent 吧?讲讲 Thought、Action、Observation 这个循环。模型一直重复调同一个工具,线上你们怎么发现,怎么让它停下来?
动笔前我先把 ReAct 的循环骨架搭出来跑了一遍。故意让模型每轮都返回同一个查订单动作,看它自己能不能停。没加护栏那版,跑满 12 步上限,工具被调了 12 次,一个答案都没吐出来。
ReAct 的面试答案,多数人背到三个名词就停了,面试官接着问的常常是循环怎么收。背定义接不住这一问。下面这版能直接背,代码也能直接跑。
二、ReAct面试题在考什么
面试官先看你有没有真跑过。能说出循环跑了十步还在原地打转的人,和只能背三个名词的人,差别在调过线上没有。
再往下是终止条件。一个 ReAct 循环停下来有两条路,模型自己给出 Final Answer,或者外部护栏强制掐断。LangChain 的 AgentExecutor 里 max_iterations 默认 15,官方文档专门写了一句,设成 None 可能死循环。这句话就是留给追问的。
三、分层答案,从认知到落地
最底下是认知层。ReAct 让模型把推理轨迹和动作交替写出来,Thought 记当前判断,Action 选工具,工具跑完把结果作为 Observation 回灌进上下文,模型再决定下一步。论文里这套写法接了一个 Wikipedia API,靠真实返回的页面压住 CoT 常见的幻觉和错误传播。出处是 Yao 等人 2022 年 10 月挂上 arXiv 的 ReAct 论文,编号 2210.03629,2023 年 3 月的 v3 是 ICLR 定稿版。
往上是原理层。交替写轨迹的好处是每步都拿环境反馈对一遍,前面想歪了后面有机会拐回来。论文在 HotpotQA 和 Fever 上验证了这点,在 ALFWorld 和 WebShop 两个交互任务上,只用一两个 in-context 示例,绝对成功率比 imitation 和 RL 基线高出 34% 和 10%。这几个数字我照着摘要原文抄的,面试报出来比说效果挺好有底气。
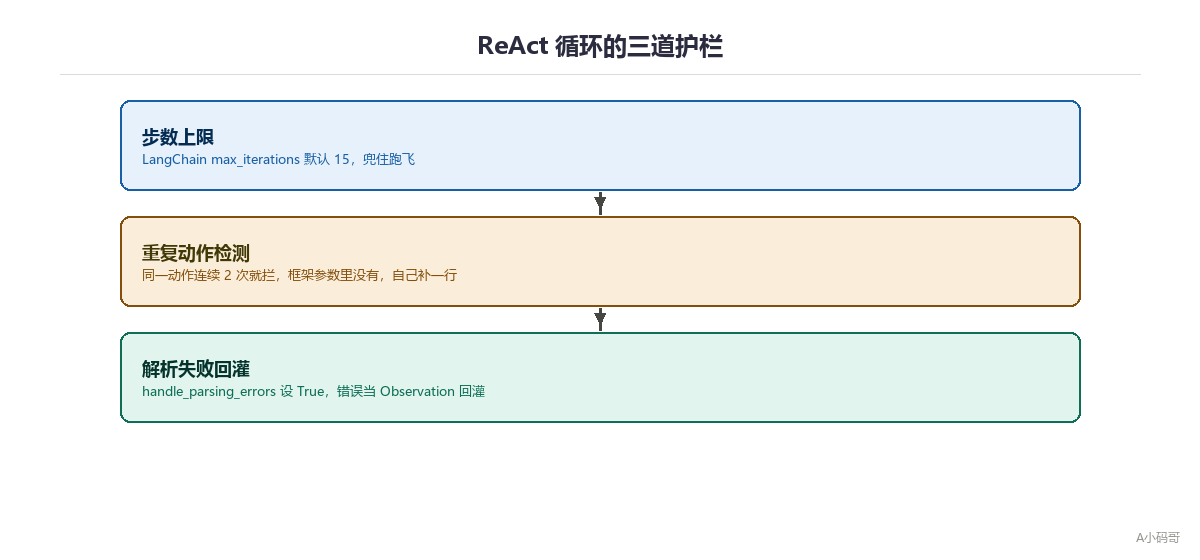
工程层最要紧,面试的差距多半在这里。循环得有硬边界,我自己写会加三道护栏,步数上限、重复动作检测、解析失败回灌。LangChain 给了其中两道,max_iterations 管步数,handle_parsing_errors 管格式错。重复动作检测在 AgentExecutor 的参数清单里没有,OpenAI Agents SDK 超了 max_turns 抛 MaxTurnsExceeded,同样只数步数。同一个动作调了八遍这种事,得自己补一行判断。
四、追问与应答
面试官常问,光加步数上限够不够。
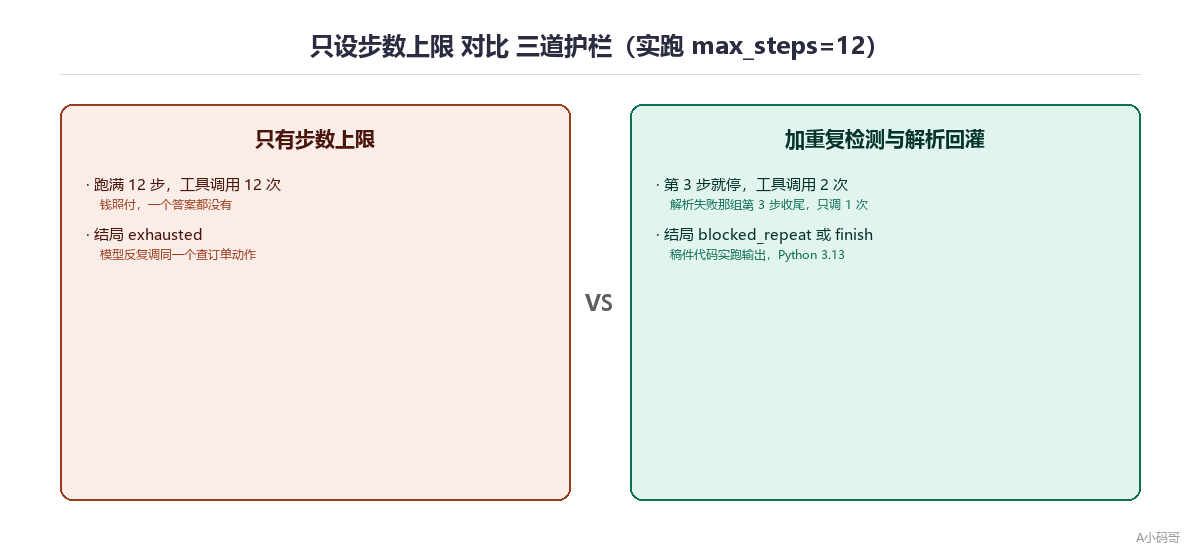
不够。我那段实跑里,12 步上限跑满,工具调用 12 次,钱照付,答案一个没有。加一行重复检测,第 3 步就拦下,工具只调 2 次。步数上限兜住跑飞,重复检测负责早点停,作用不重叠。
还可能问,解析失败要不要直接报错。
别抛异常。把解析错误整理成一句 Observation 回灌,多数模型下一轮就改回格式。这正是 handle_parsing_errors 设成 True 干的事。我那个 demo 第一轮让模型自由发挥,第二轮就归位,第三步正常收尾。max_execution_time 也建议配上,它管墙钟时间,能防挂死,可重复调用每次都很快,时间没到钱已经花完了。
五、代码示例与执行流程
下面这段纯标准库就能跑,用脚本化输出模拟模型,不依赖任何 API Key。三组对照各走一遍护栏。
# 纯标准库,用脚本化输出模拟模型,不依赖任何 API Key
class ParseError(Exception):
    pass


def parse(text):
    # 只认行首标记,Thought 里提到工具名不会被误当 Action
    marks = [l for l in text.splitlines()
             if l.startswith(("Action:", "Final Answer:"))]
    if not marks:
        raise ParseError("缺少 Action 或 Final Answer 行")
    last = marks[-1]
    return ("finish" if last.startswith("Final") else "action",
            last.split(":", 1)[1].strip())


def react_loop(model, max_steps=12, repeat_limit=None):
    """返回 结局、步数、工具调用次数。history 每轮回灌模型。"""
    history, calls, last_action, streak = [], 0, None, 0
    for step in range(1, max_steps + 1):
        try:
            kind, payload = parse(model(step, history))
        except ParseError as e:
            # 解析失败不中断,把错误当 Observation 回灌,让模型下一轮改格式
            history.append(f"Observation: 解析失败,{e}")
            continue
        if kind == "finish":
            return "finish", step, calls
        # 先判重复再调工具,重复的这一次不付工具钱
        if repeat_limit and payload == last_action:
            streak += 1
            if streak >= repeat_limit:
                return "blocked_repeat", step, calls
        else:
            streak = 0
        last_action, calls = payload, calls + 1
        history.append(f"Observation: {payload} -> 未找到记录")
    return "exhausted", max_steps, calls


def stuck(step, history):
    return "Thought: 再查一次\nAction: search_order(A1001)"


def recover(step, history):
    if step == 1:
        return "我先查一下订单 A1001 的状态。"
    if step == 2:
        return "Thought: 按格式重来\nAction: search_order(A1001)"
    return "Thought: 给结论\nFinal Answer: 未查到该订单,建议人工核对"


for name, model, kw in [
    ("只有步数上限", stuck, {}),
    ("加重复动作检测", stuck, {"repeat_limit": 2}),
    ("解析失败回灌", recover, {}),
]:
    end, steps, calls = react_loop(model, **kw)
    print(f"{name}: 结局={end} 步数={steps} 工具调用={calls}")
实跑输出(Python 3.13)
-- 只有步数上限:
结局=exhausted 步数=12 工具调用=12

-- 加重复动作检测:
结局=blocked_repeat 步数=3 工具调用=2

-- 解析失败回灌:
结局=finish 步数=3 工具调用=1
第一行是只设步数上限的代价。第二行把重复检测打开,连续两次同一个动作就拦,工具少调十次。第三行演示解析失败回灌,模型第一轮输出自由发挥,收到错误提示后改回格式,第 3 步给出答案。
parse 里用 startswith 只认行首标记,这个写法有讲究。换成 in 去匹配,Thought 里提一句工具名就会被误当成动作,这类错误在线上很隐蔽。重复检测也放在调工具之前,等工具跑完再判,那一次已经付过钱了。
六、加分项与踩坑点
加分项。提一句 early_stopping_method,默认 force 只返回一句达到迭代上限的说明,设成 generate 会让模型基于已走的步骤最后生成一次答案,体验好,多一次调用。再提一句 OpenAI Agents SDK 的 error_handlers 收 max_turns,能返回兜底输出,官方页面没写默认 turn 数,别在面试里编一个。护栏触发时记一条日志,重复动作次数是很便宜的健康指标。
踩坑点。第一,解析别用 in 匹配 Action,行首 startswith 才稳。第二,重复检测要放在调工具之前。第三,步数上限别照抄 15,复杂任务 15 步不够,简单任务 15 步够烧掉一堆 token,按业务配,再叠一个时间上限。第四,别把 max_turns 当成工具调用次数,官方文档写了一次 run 里可能包含多次 LLM 调用。
三个核心要点
ReAct 循环得有硬边界,靠模型自己喊停不靠谱。
三道护栏直接背,步数上限、重复动作检测、解析失败回灌。
实测只设 12 步上限,工具白调 12 次;加了重复检测,第 3 步就停。
我正在整理一份《大模型面试高频题库与详解》,做好后会在公众号开放领取。关注 A小码哥,回复「AI面试题」即可第一时间获取。