同一段中文、同一份字节流,只换解码方式:逐块 new TextDecoder() 解出 20094 个乱码字符,换成 stream:true 一个都不剩。
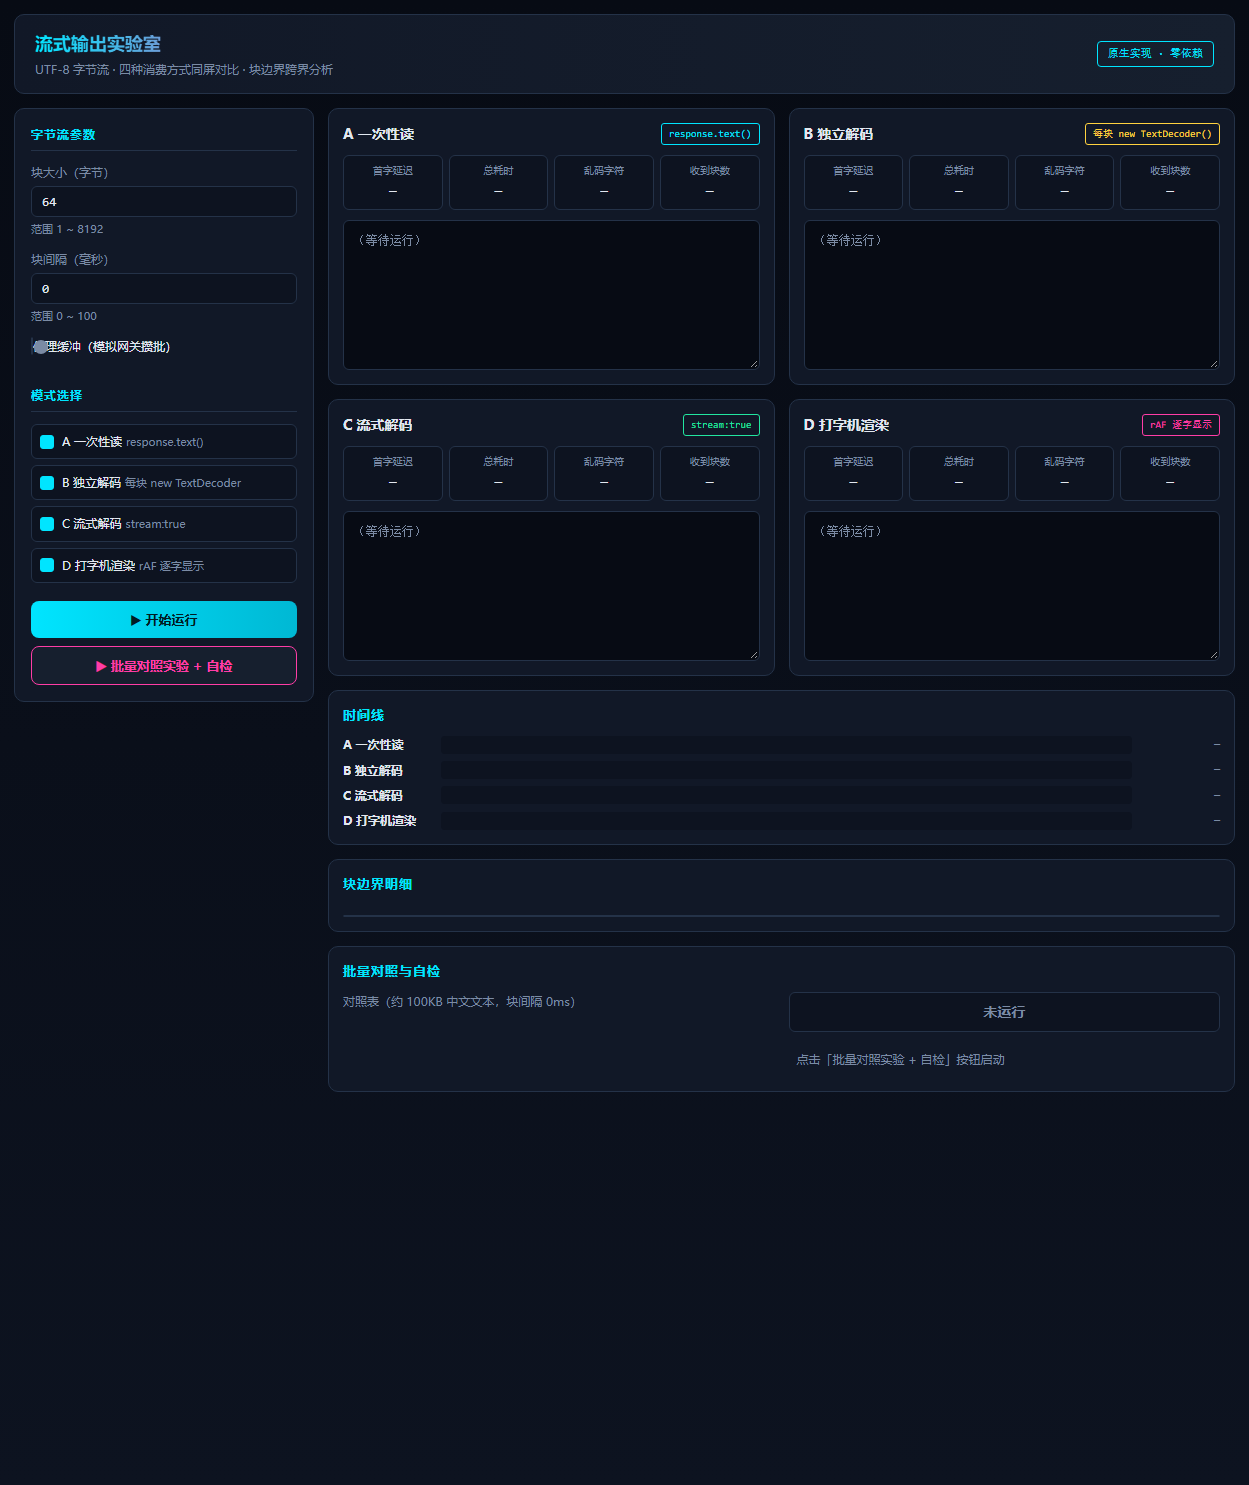
我把两种读法摆进同一个页面,参数随手改,数字当场出。
一、为什么值得看:字节按块到,字符跨块走
流式输出的底层是字节流。
服务端把中文编码成 UTF-8 字节,切块发出去,浏览器用 fetch 一块一块读回来。
问题在于,块是字节的边界,不是字符的边界。
一个中文字符占 3 个字节,一个数字或空格只占 1 个。
块大小固定,字符长度不固定,两者对不齐时,一个字符就被切成两半,一半在上一块,一半在下一块。
每块都新建解码器去 new TextDecoder().decode(chunk),遇到半截字节只能吐一个替换字符 U+FFFD,乱码就是这么来的。
换成 new TextDecoder("utf-8", {stream:true}),解码器会把上一块没解完的字节留在手里,等下一块补上。
第二种现象是一段一段蹦。
浏览器交给你的块,不一定等于服务端发出去的块,中间的网关和缓冲区会把小块攒成大批次再交出来。
页面上的「代理缓冲」开关模拟的就是这个,攒批打开,文字就一次蹦出一大段。
二、准备环境:打开码道 Web 就能用
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source…
登录之后直接在对话窗口里说需求,不需要装任何软件。
下面这段是我实际发给码道的需求,复制过去就能生成同一个应用。
用 HTML 做一个单文件网页应用「流式输出实验室」,不要任何外部依赖,界面中文、深色科技风。

页面内部自己生成一段中文长文本的 SSE 字节流:用 TextEncoder 编成真实 UTF-8 字节,按可调的块大小和块间隔真实切块,通过 ReadableStream 交付,再用四种方式读同一份字节流,同屏对比:

A 一次性读:await response.text() 全部读完再渲染,记录首字延迟。
B 逐块读但每块独立解码:每收到一块就 new TextDecoder().decode(chunk) 追加,记录乱码字符数。
C 逐块读加流式解码:new TextDecoder('utf-8',{stream:true}),记录乱码字符数。
D 逐块读加流式解码加打字机渲染:按 requestAnimationFrame 逐字显示。

要求:
1. 每个模式实时显示输出区、首字延迟、总耗时、乱码字符数、收到块数。
2. 块大小 1~8192 字节、块间隔 0~100 毫秒可调;加一个「代理缓冲」开关,打开时把前若干块合并成一批交付。
3. 块边界分析面板:逐块显示字节数,用真实字节判断末尾是否把一个中文字符切开,统计跨界块数与跨界率。
4. 批量对照实验:固定约 100KB 中文文本,块大小取 1、16、256、4096,各跑一遍独立解码与流式解码,记录乱码字符数与解码耗时,生成对照表,并执行 12 项页内自检。
5. 参数校验:块大小、块间隔非法时给中文提示并回退到上一次有效值。
6. 左侧参数面板,右侧四种模式对比区,下方时间线、块边界明细与对照表。

完成后打开预览,让我直接看到运行效果。
三、码道做了什么:四种读法塞进一个页面
码道吐出一个单文件 index.html,35 KB 左右,零依赖、零网络请求,双击就能跑。
四种读法是这么分工的:
- A 一次性读:
await response.text(),全部读完再渲染,首字延迟必然等于总耗时。 - B 独立解码:每块新建
TextDecoder,解出什么就追加什么。 - C 流式解码:一个解码器从头用到尾,
stream:true。 - D 打字机渲染:解出来的字符按
requestAnimationFrame一个个往外放。
配套还有个块边界面板,逐块列出字节数,并用字节本身判断这块末尾有没有切开中文字符。
字节判断的规则很朴素:从块尾往前数续字节 0x80 到 0xBF,再往前找一个首字节,首字节声明的长度和实际剩下的字节数对不上,就是切开的。
四、验证与踩坑
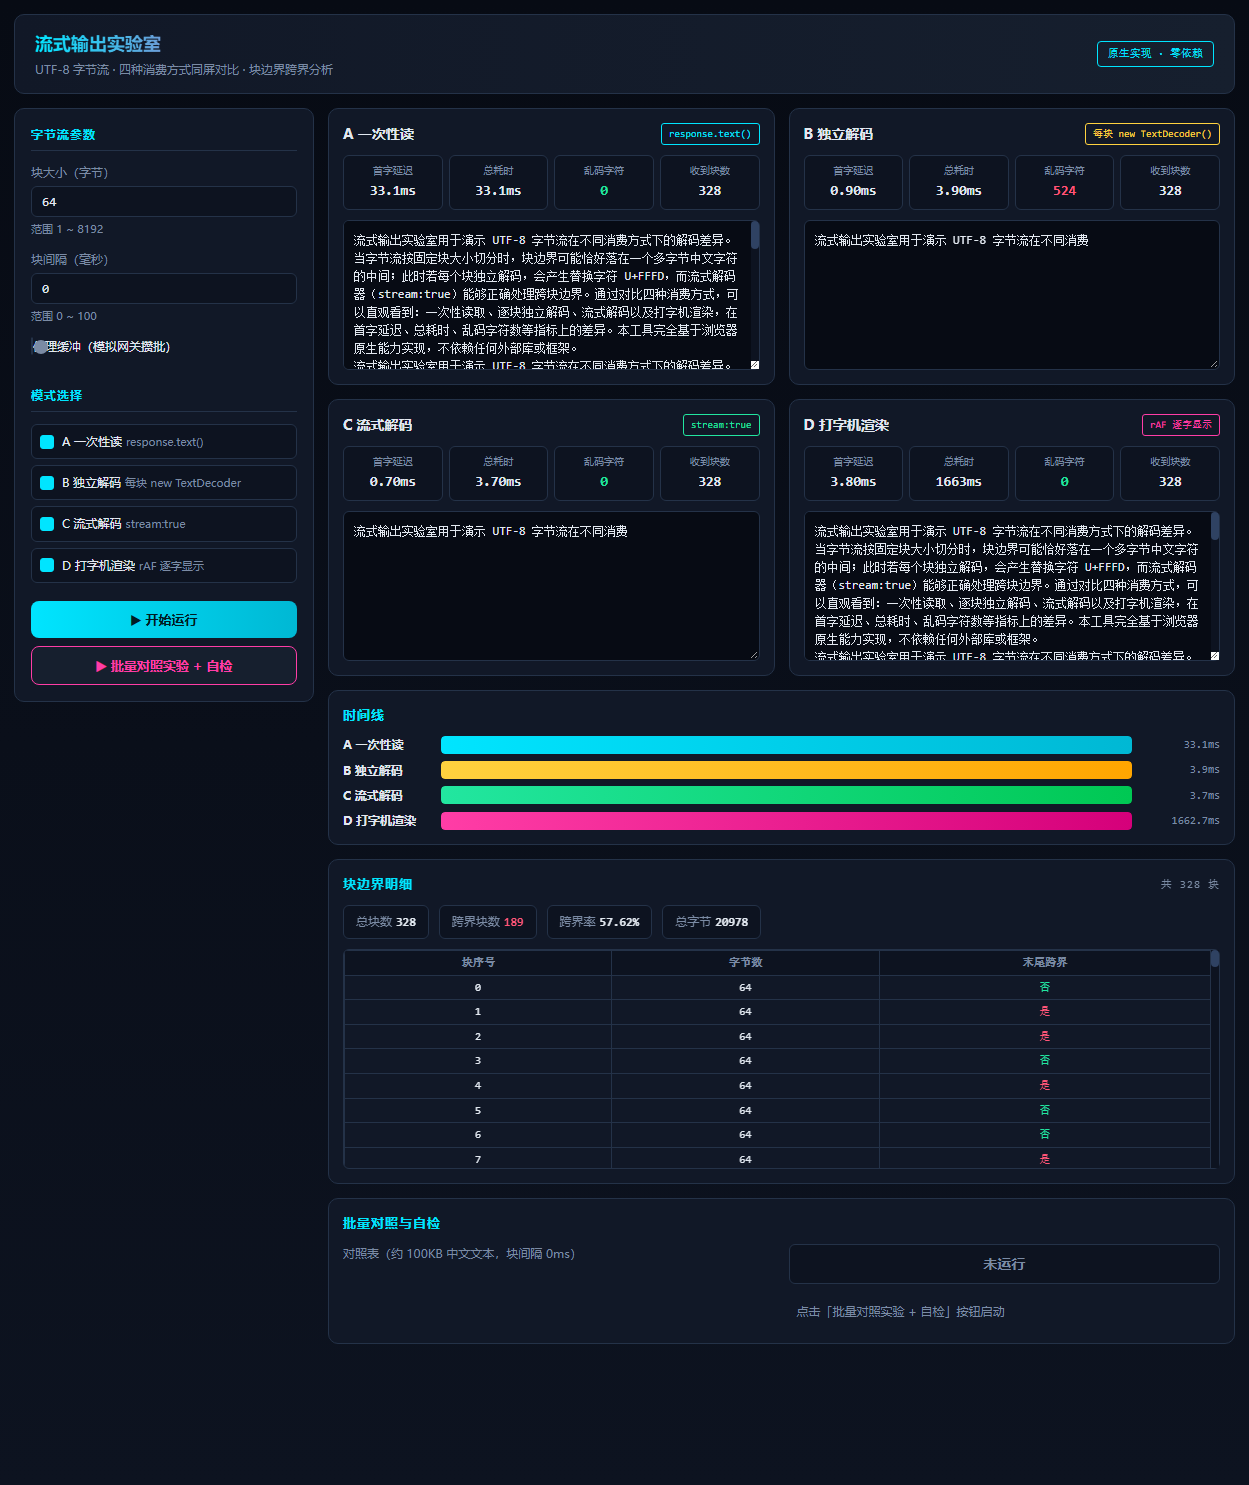
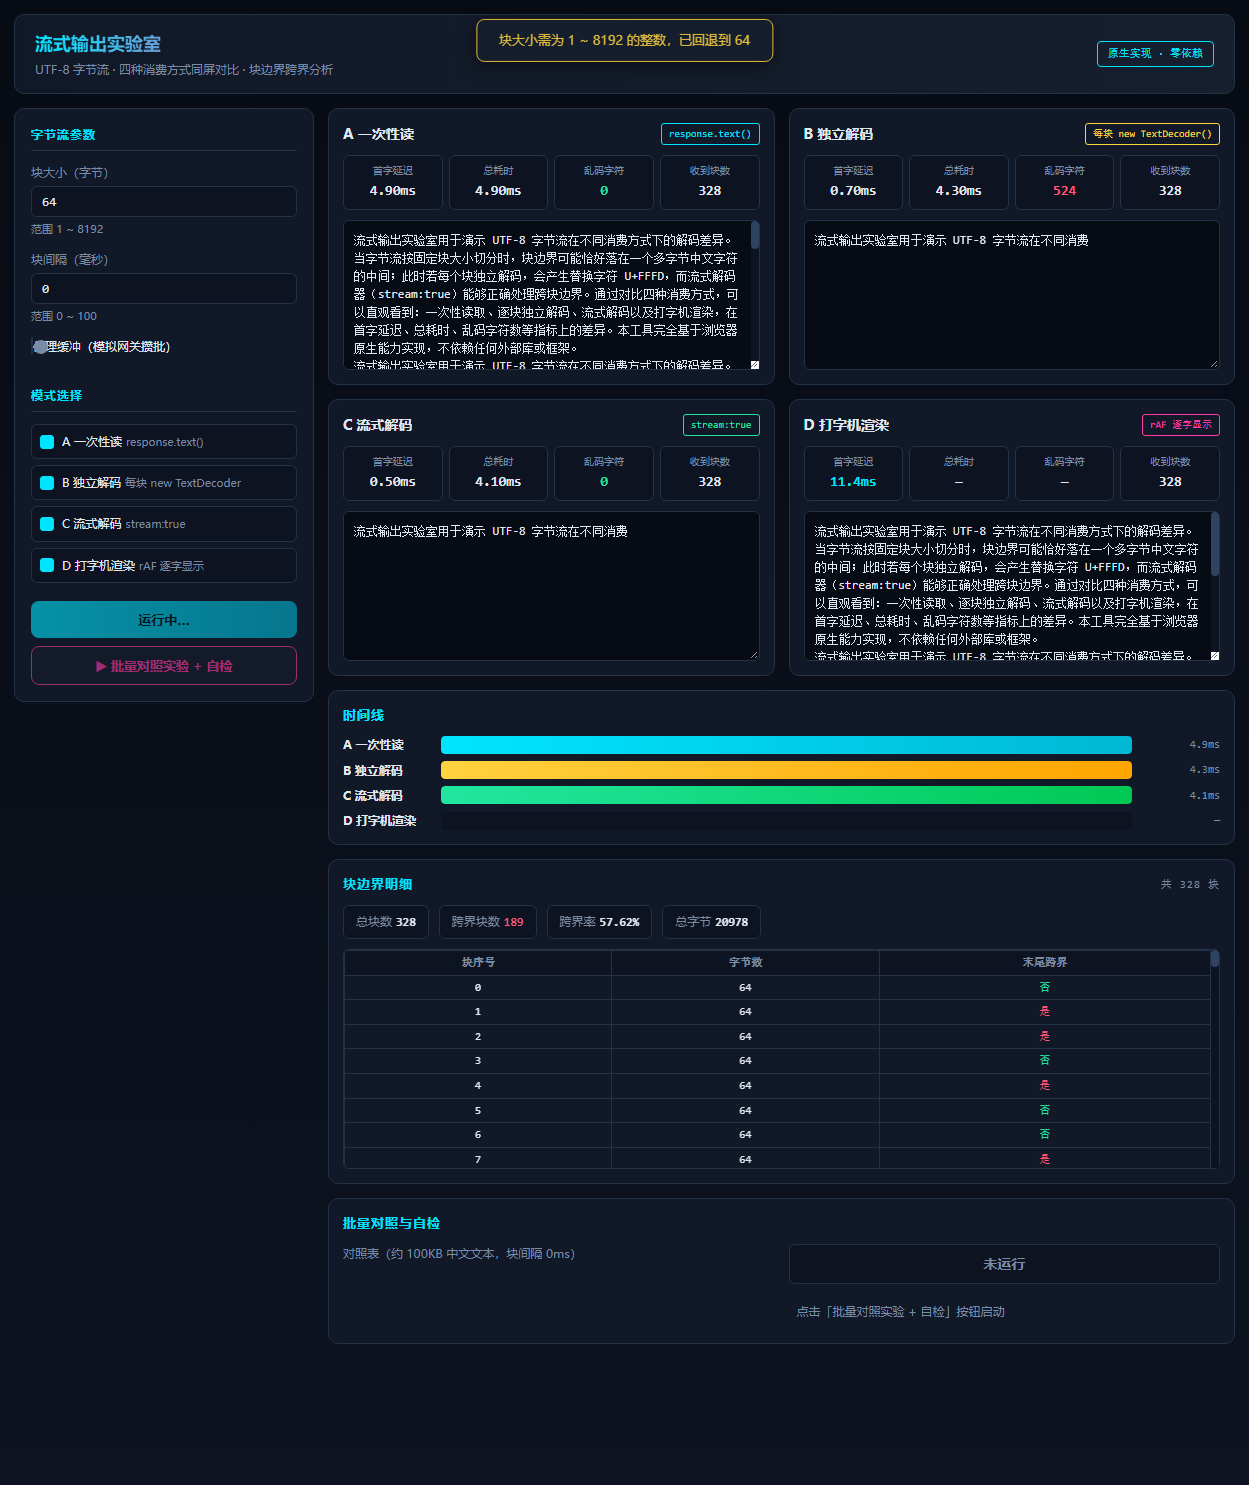
先看默认参数:块大小 64 字节、块间隔 0ms,文本共 20978 字节,切出 328 块。
| 读法 | 首字延迟 | 总耗时 | 乱码字符 | 收到块数 |
|---|---|---|---|---|
| A 一次性读 | 33.1ms | 33.1ms | 0 | 328 |
| B 逐块独立解码 | 0.90ms | 3.90ms | 524 | 328 |
| C 流式解码 | 0.70ms | 3.70ms | 0 | 328 |
| D 打字机渲染 | 3.80ms | 1663ms | 0 | 328 |
A 卡片只有一行数字能看:首字延迟 33.1ms,总耗时也是 33.1ms,用户在这 33.1ms 里盯着空白。
B 卡片首字来得最快,但它交出来的正文里有 524 个替换字符。
C 卡片首字 0.70ms、乱码 0,是四项里唯一又稳又准的。
D 卡片是打字机效果,代价写在明面上:总耗时 1663ms,是 C 的 450 倍。
块边界面板给出更底层的数字:328 块里 189 块的末尾落在字符中间,跨界率 57.62%。
把块大小改成 1 更直观,20978 个块、乱码 20094 个,几乎每个字节都变成替换字符。
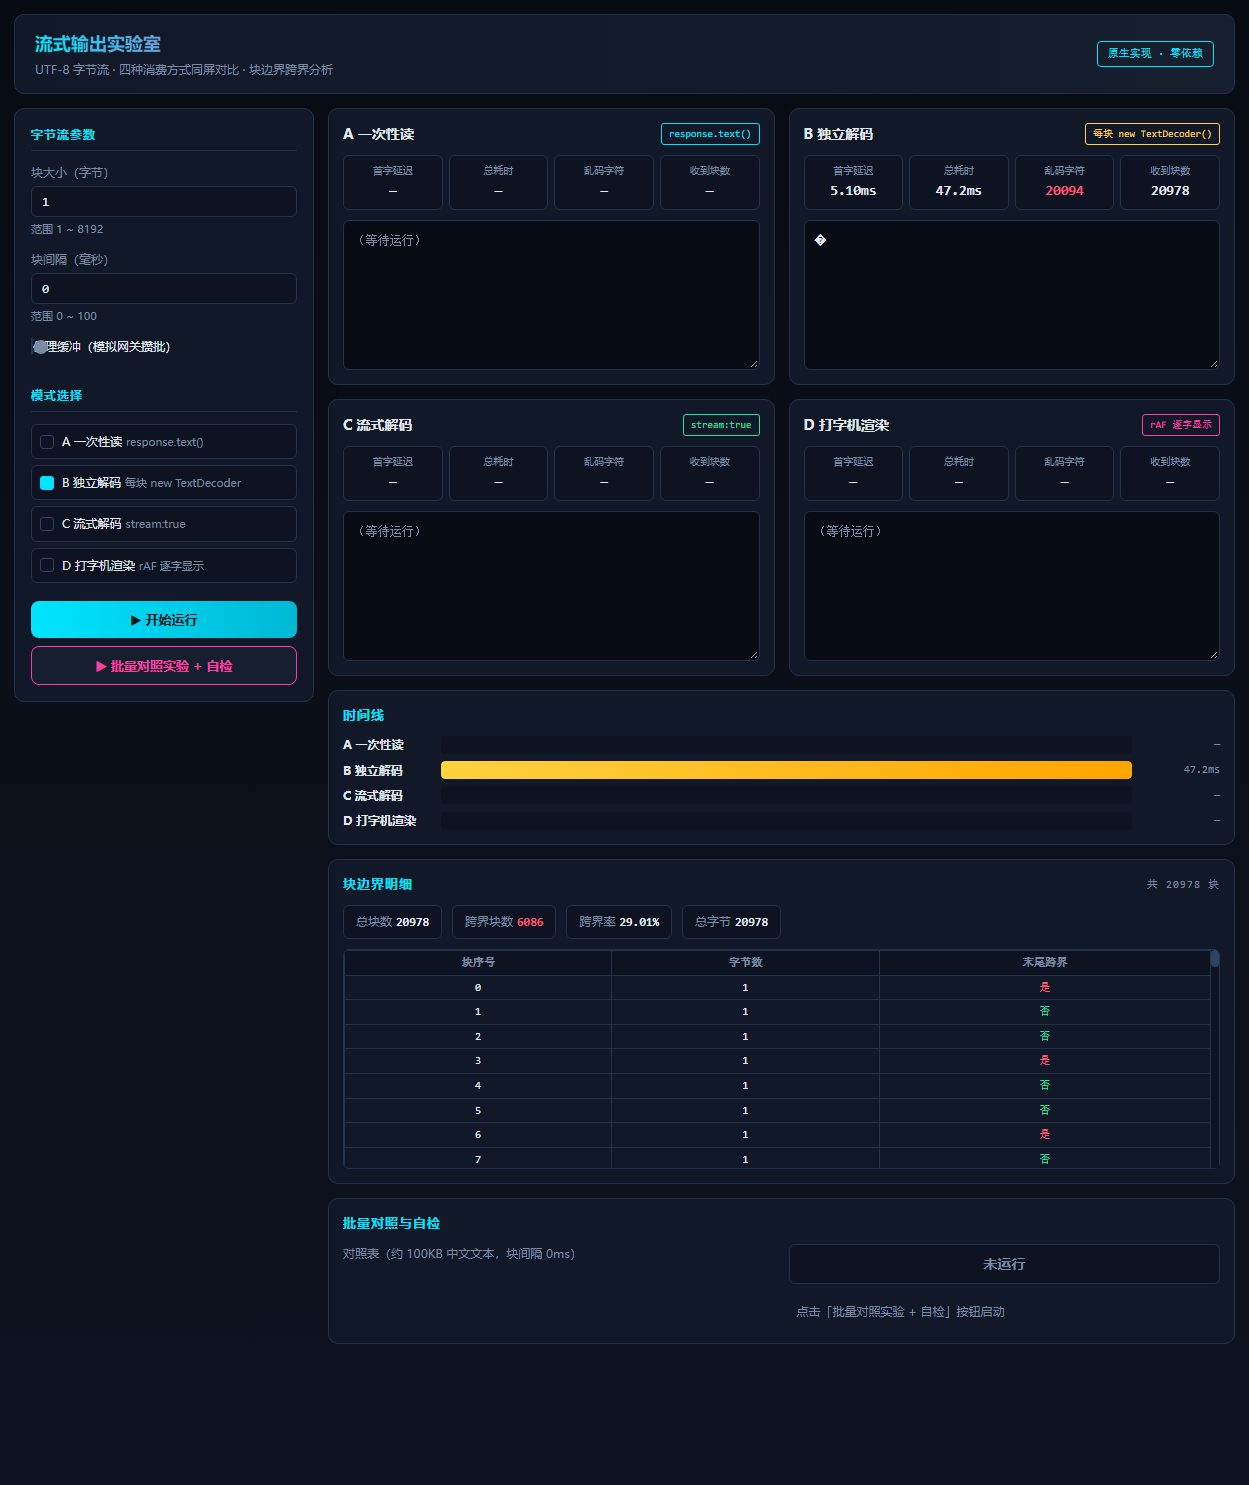
块边界面板还给出一个反直觉的结论:跨界率最高的不是块最小时。
| 块大小 | 块数 | 跨界块 | 跨界率 |
|---|---|---|---|
| 1 | 20978 | 6086 | 29.01% |
| 64 | 328 | 189 | 57.62% |
块大小 1 时每块只有一个字节,它落在字符中间的概率反而低,因为大量的 ASCII 字节本来就自成一块。
排得上用场的数字来自批量实验:固定 100KB 中文文本,四种块大小各跑一遍独立解码与流式解码。
| 块大小 | 块数 | 跨界块 | 跨界率 | 独立解码乱码 | 独立耗时 | 流式乱码 | 流式耗时 |
|---|---|---|---|---|---|---|---|
| 1 | 102422 | 29714 | 29.0% | 98106 | 223.6ms | 0 | 159.2ms |
| 16 | 6402 | 3716 | 58.0% | 10215 | 16.4ms | 0 | 16.6ms |
| 256 | 401 | 229 | 57.1% | 642 | 1.8ms | 0 | 1.5ms |
| 4096 | 26 | 10 | 38.5% | 29 | 0.3ms | 0 | 0.4ms |
流式那两列永远是 0,独立解码那一列随块变小而爆炸。
顺手说一句耗时:独立解码在 100KB 文本上还比流式解码慢了 40%,多出来的开销全花在反复构造解码器和处理替换字符上。
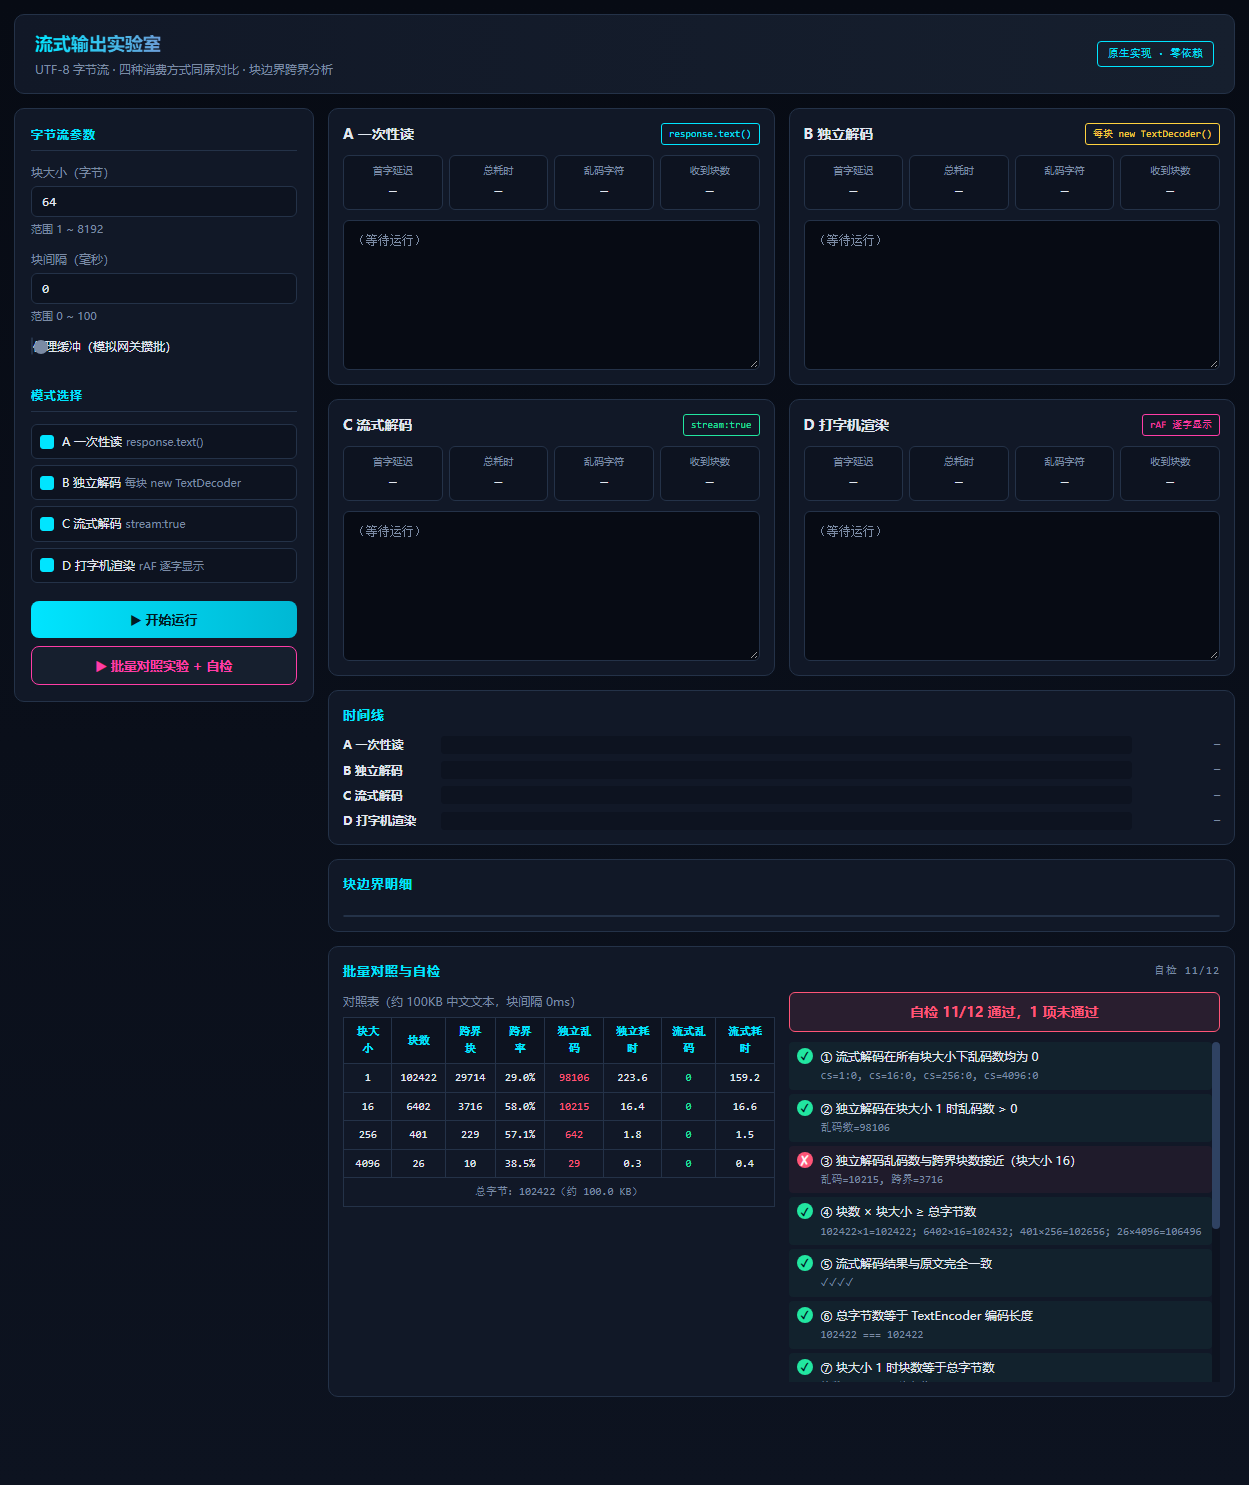
自检这块有一条真实边界,我不想藏。
12 项自检只过了 11 项,挂掉的是第 3 条:「独立解码乱码数与跨界块数接近」。
实测是乱码 10215、跨界 3716,差了 2.75 倍,不是「接近」。
原因不难想:一个字符被切开一次,会吐出两个以上的替换字符。尾部那半截算一个,下一块开头的每个续字节也算一个。
所以我用 Python 把同一件事重算了一遍,作为交叉验证。
raw = text.encode("utf-8")
chunks = [raw[i:i+cs] for i in range(0, len(raw), cs)]
indep = "".join(c.decode("utf-8", "replace") for c in chunks)
print(cs, len(chunks), indep.count("\ufffd"))
cs=1 时同样得到 98106 个替换字符,和页面上的数字逐位一致。
cs=16 时 Python 给 10206,页面给 10215,差在最后一块和跨界判定的细节上,比值两边都是 2.5 上下。
结论是自检第 3 条的公式写错了,不是页面算错了。乱码数约等于跨界块数的 2.5 倍,写成「接近」自然会挂。
失败路径我也点了一遍:块大小填 0,页面顶部弹出「块大小需为 1 ~ 8192 的整数,已回退到 64」,输入框回到 64,实验不启动。
块间隔填 200 也是同样处理,提示「块间隔需为 0 ~ 100 的整数」,上一次的结果原样留着。
五、本地复现
index.html 是单文件,下载下来双击就能跑。
想换个干净环境验证,起个静态服务器即可。
python -m http.server 8080
# 浏览器打开 http://localhost:8080/index.html
我自己的验收动作是三条:默认参数跑一遍读四张卡片的读数,块大小改 1 看乱码数量级,再填一次非法值确认提示原文。
六、使用码道体会
- 把「怎么验收」写进需求。我在需求末尾加了「完成后打开预览」,省掉了一轮「做好了没」的来回。
- 要对比的方案写成编号清单。四种读法、块边界面板、批量实验各占一条编号,页面就按编号长出来了。
- 让页面自己举证。12 项自检是需求里点名的,跑完直接打在页面上,比嘴上说「测过了」有用。
- 失败路径提前点名。我写了「非法时给中文提示并回退到上一次有效值」,页面就给了中文提示;不写,大概率只给一个
alert。 - 单文件交付最省事。零依赖、零构建,
file://能跑,发给别人也不用配环境。 - 自检公式也可能写错。这次挂掉的那条就是我自己在需求里拍的公式,页面照着实现了,结果被真数字打回来。
直接下载试玩
这个 Demo 已经完整开源,源代码、全部截图都在公开仓库里:
- Demo Park 仓库:atomgit.com/deli007/dem…
- 本案例目录:atomgit.com/deli007/dem…
打开链接进入 codearts-sse-stream-lab,把 index.html 下载到本地用浏览器打开即可,无需安装任何依赖。
七、总结
流式输出看起来是「后端一段段推」,落到浏览器手里其实是「一堆不保证对齐的字节块」。
块边界和字符边界对不齐,独立解码就会批量产出 U+FFFD;一个 stream:true 就能解决。
同一份 100KB 文本,块大小 16 字节时独立解码出 10215 个乱码字符,块大小 4096 时降到 29 个,流式解码在四种块大小下全是 0。
页面上那两个开关值得自己拉一拉:块大小调到 1 看乱码数量级,代理缓冲打开看文字怎么一次蹦一大段。
丢给服务端一句话就能修好的事,别让前端在渲染层数半天。