Reddit 的登录墙实验
这个决定的背后是搜索流量结构的根本变化。2024 年 Reddit 与 Google 签署了每年价值 60 万美元的独家内容授权协议,换取搜索引擎对 Reddit 用户生成内容的访问权限。协议本身创造了收入,但也加速了 AI 搜索对原生流量的侵蚀。
AI 搜索正在吃掉搜索引擎流量
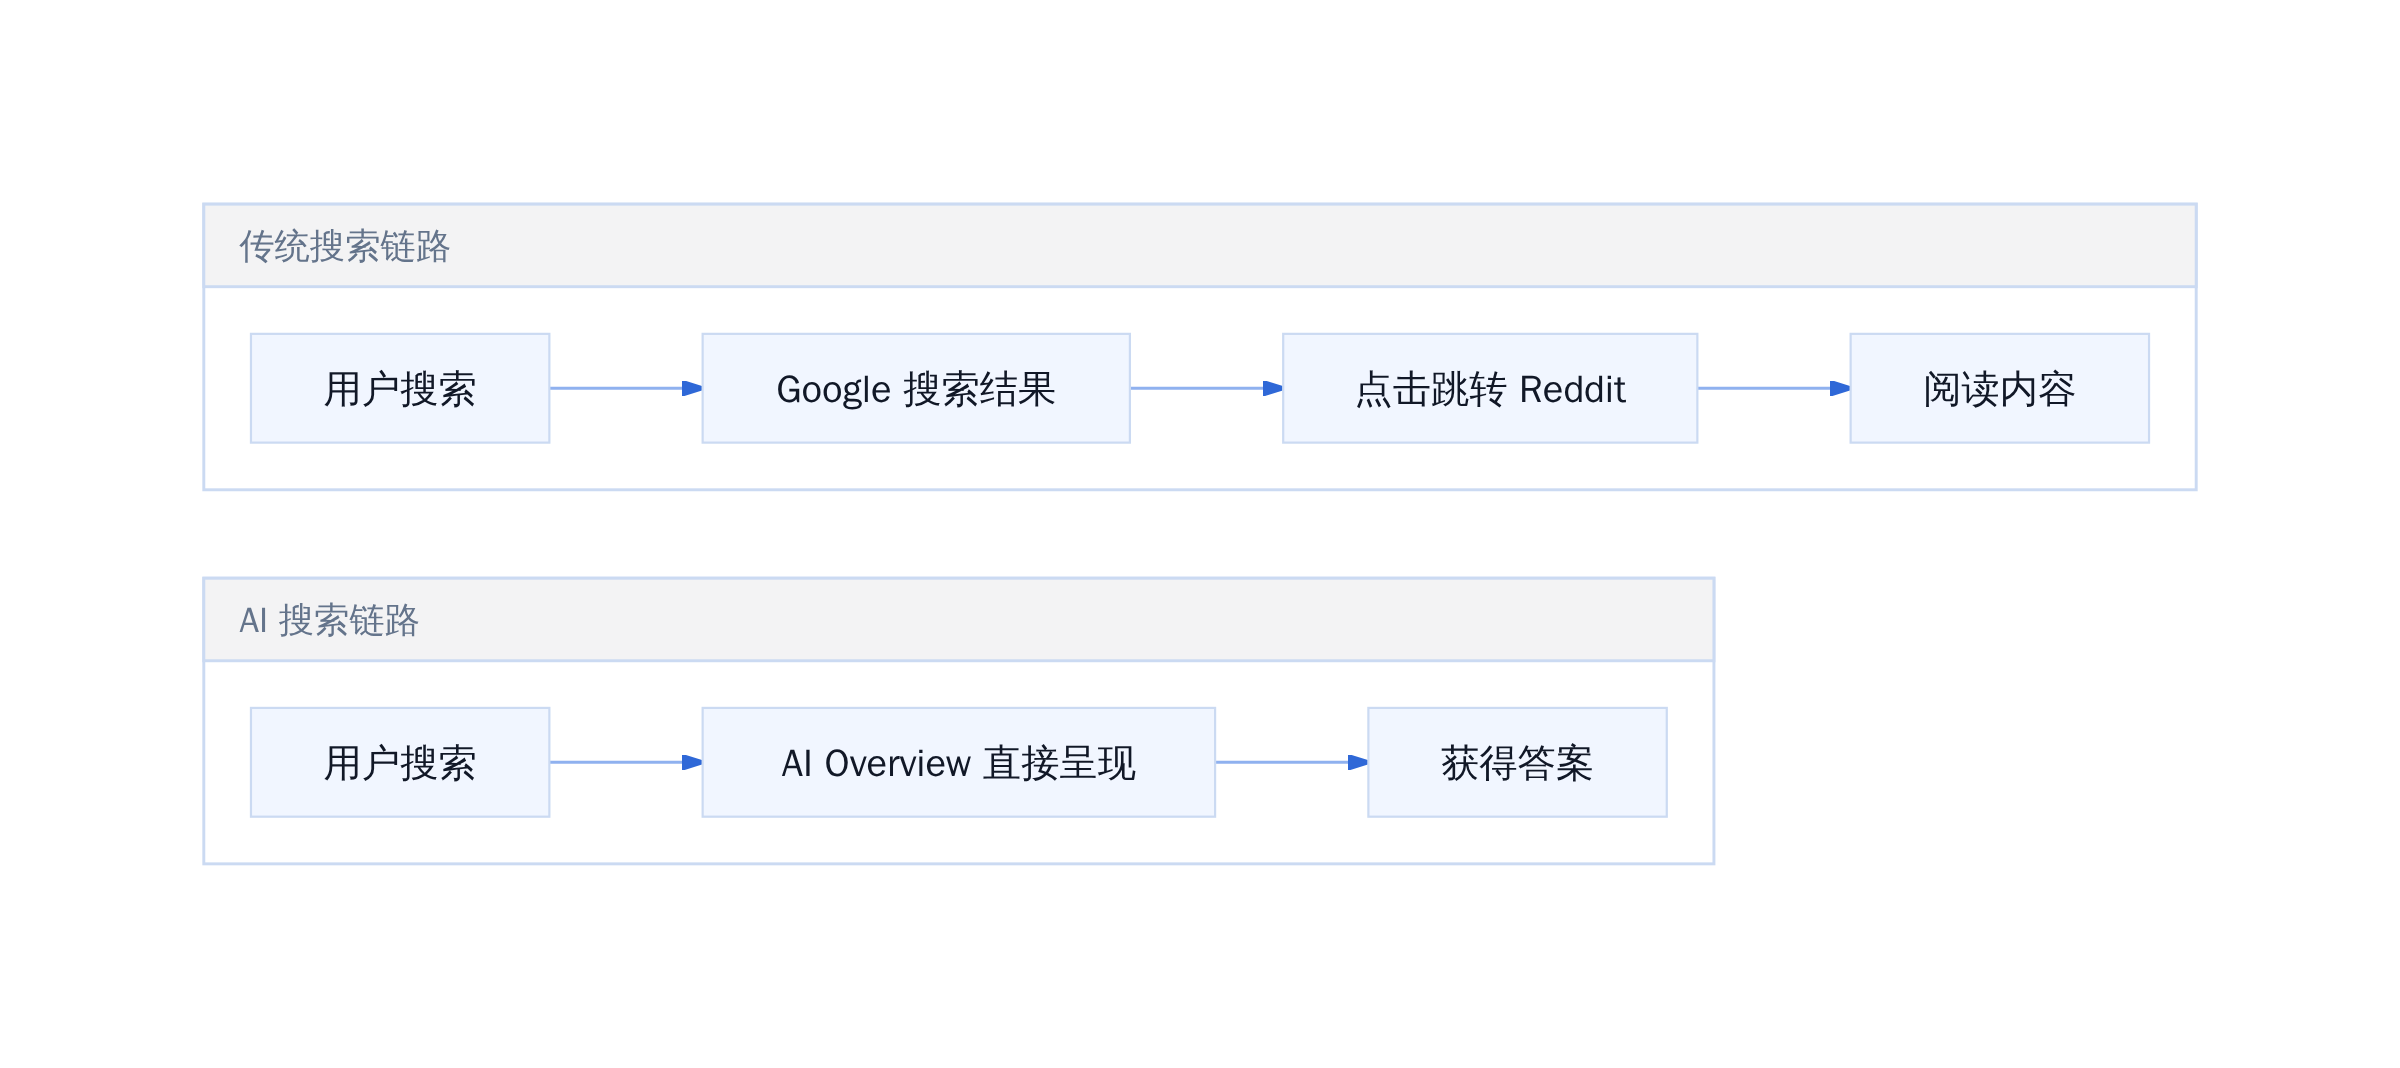
传统的搜索引擎结果是「十个蓝色链接」,用户需要点击跳转才能获取信息。AI 搜索概览则直接在结果页汇总答案,用户无需离开搜索页面。这种模式对内容平台意味着两件事:点击率下降,以及训练数据的免费获取。
2025 年的数据显示,零点击搜索占比已达到 69%。更准确地说,AI Overview 这类功能让搜索引擎变成了答案提供者,而不是导向站点的通道。Reddit CEO Steve Huffman 在财报电话会上明确提到了这一点,他警告称 Google 的 AI 概览功能正在显著减少对 Reddit 的直接访问。
这不仅是 Reddit 的问题。内容平台普遍面临同一困境:自己的内容被用于训练模型,产生的答案却不再回流到源头。
AI 搜索对 Reddit 流量的双重侵蚀
登录墙的算账逻辑
转向登录为主,Reddit 同时解决两个问题。
第一个是数据保护。AI 公司需要高质量的人类对话数据来训练模型,Reddit 的内容恰恰是最适合的自然语言语料之一。当这些数据被免费抓取并转化为商业产品时,Reddit 既失去了流量,也失去了议价能力。登录墙切断了自动化爬虫的访问路径,让数据重新成为可管理的资产。
第二个是广告变现。未登录用户虽然能浏览内容,但无法触发完整的广告展示链路。登录用户的行为数据更完整,广告主愿意为此支付更高溢价。Huffman 提到,Reddit Answers 的周活跃用户已从 100 万增长至 600 万,这个产品本身就依赖用户登录状态来提供个性化答案。
坦白讲,登录墙是一把双刃剑。它会赶走部分只想快速浏览的用户,也会让平台显得不够开放。但权衡之后,Reddit 选择的是长期变现能力而非短期流量规模。

登录墙的双重收益结构
边界:什么时候能走,什么时候不该走
Reddit 的决策并非通用最优解。它的社区属性决定了内容价值高度依赖用户身份和互动深度,这让它有资本做登录墙。但对于资讯类或工具类网站,用户搜索的是即时答案而非社区讨论,强制登录反而会直接流失。
更准确地说,这个策略适用于以下条件:平台拥有足够独特的用户生成内容,这些内容难以被其他来源替代;平台已有成熟的会员或广告变现体系;流量下滑主要来自 AI 搜索而非其他渠道。
Reddit 选择在美国以外市场先测试,这一步本身就说明了对本土用户流失的顾虑。美国是其核心市场和收入来源,贸然全量上线风险过高。
另一个边界在于 AI 数据市场的规模。霍夫曼提到,其他公司对 Reddit 数据的兴趣正在增长,AI 数据市场是一个不断扩大的机遇。这意味着登录墙不只是防御手段,更是为未来的数据授权谈判做准备。如果 AI 公司愿意为高质量语料付费,Reddit 完全可以把数据作为独立产品出售,而不再依赖搜索引流。

登录墙策略适用边界
##Reddit的登录墙实验这个
可执行判断
对于内容平台的决策者,当前阶段的行动路径可以拆成三步。
第一,盘点自己的流量来源结构。如果超过 30% 的入口来自搜索引擎,且最近半年呈下滑趋势,登录墙的讨论就该提上日程。如果流量主要来自直接访问或社交媒体,优先级则不同。
第二,测试而非全量。Reddit 选择境外先行就是典型的渐进式策略。可以选择一个小语种市场或低 DAU 地区做灰度,观察登录率、留存率和广告收入的联动变化,再决定是否扩大。
第三,把数据当作产品来设计,而不是当作防护墙。登录墙只是第一步,下一步是明确数据的使用边界、定价模型和授权对象。AI 公司愿意付费的前提是可预期的合规访问,而不是黑箱里的爬虫博弈。
更狠的是,每年能省下一个亿——如果算的是放弃被免费抓走的授权收入。
这个判断适用的边界是:平台拥有足够密度和独特性的高质量 UGC,且 AI 搜索对原生流量的侵蚀已成趋势。如果这两个条件不成立,强行上登录墙只会加速衰退。
{ "title": "Reddit 宣布转向以登录为主的体验,以应对 AI 搜索带来的流量下滑", "summary": "Reddit Q3 财报透露的关键信号:AI 搜索正在蚕食传统搜索引擎引荐流量,平台选择用登录墙保护数据资产并重新定价。这篇文章拆解其背后的算账逻辑、已验证的路径,以及不同场景下的取舍边界。", "opening_hook": "Q3 财报显示 Reddit 全球日活 1.303 亿,美国日活却同比下降 2%。", "outline_markdown": "## 登录墙不是第一道防线
数据已经被卖过一次了
这次为什么不同
AI 搜索吞掉的是什么流量
零点击搜索的增长曲线
蓝链接时代的终结
变现账怎么算
Reddit Answers 的数据
从卖流量到卖数据授权
边界在哪里
什么时候该建墙
什么时候不该
登录墙不是第一道防线
先把时间线理清楚。Reddit 和 Google 早在 2024 年就签了一份每年 60 万美元的独家内容授权协议。这说明他们并非不知道数据被 AI 抓取的价值——只是当时的价格不够高。
CEO Steve Huffman 在致股东信中提到一个细节:Reddit Answers 每周活跃用户从上一季的 100 万涨到 600 万。这不是一个边缘功能,这是他们正在重造的入口。
这次的转向本质上是两件事同时发生。第一,登录墙让未认证的爬虫拿不到干净的内容;第二,他们把用户从"搜索结果里的答案"变成了"Reddit 平台上的活跃用户"。
这两件事加起来,才是变现逻辑的改变。
数据已经被卖过一次了
2024 年的 Google 协议本质上是一种批发模式。Google 拿内容,用户通过 Google 搜索找到 Reddit 帖子。流量归 Google 管,Reddit 拿授权费。
问题是,Google 后来推出了 AI Overview。用户在搜索结果页面就能看到摘要,不再需要点击进入原始页面。
这就像你租了一间店,房东突然在街上搭了一个展台,把商品摆出来让人看一眼就走,进店的人越来越少。
Huffman 在财报电话会议上说了原话:"其他公司对 Reddit 的数据越来越感兴趣,希望将其用于不同目的和不同规模,AI 数据市场是一个不断扩大的机遇,可以容纳多家合作伙伴。"
翻译成人话:数据值钱,但之前卖便宜了。
这次为什么不同
区分两种不同的 " 登录 " 场景。
第一种是社区型登录墙,典型代表是 Medium 和 Substack。目的是过滤垃圾内容、保护创作者收益。用户自愿注册,门槛低。
第二种是平台型登录墙,这次 Reddit 走的方向。目的是控制数据出口、重新谈判授权价格。用户不注册就看不到核心内容。
第二种更狠。它对 SEO 的影响是即时的——Google 爬虫爬不到,AI 模型也吃不到。但它的副作用同样明显:新用户进入成本变高,内容传播速度变慢。
Reddit 的选择是赌用户愿意为了 " 看到完整讨论 " 而注册。这个赌注有没有赢,要看美国以外市场测试的结果。
参考文献
- Reddit Q3 2025 Earnings Report: www.reuters.com/technology/…
- Reddit CEO Steve Huffman on AI Search Impact (CNBC Interview): h5.ifeng.com/c/vivoArtic…__
- Reddit Answers Growth Data (Shareholder Letter): hk.finance.yahoo.com/news/股價狂飆17…
- Zero-Click Search Statistics 2025: www.reddit.com/r/GrowthHac…
- Google-R
延伸入口
- 原文归档:tobemagic.github.io/ai-magician…
- 公众号:计算机魔术师