

一个 Agent 失败,别急着杀掉所有兄弟任务
多 Agent 并行最常见的异常策略,往往只有一句:任何子任务失败,取消全部任务。
它实现简单,也显得足够安全。但如果三个 Agent 分别负责代码审查、文档整理和配图,配图服务超时,为什么已经完成的审查结果也要作废?为什么与配图无关的文档必须重跑?
问题不在于取消太激进,而在于系统没有“故障域”。它只知道这些任务属于同一个根节点,却不知道哪些结果必须共同成立,哪些结果可以独立验收。
我的观点很简单:失败域应该比任务树小。取消传播由依赖关系决定,不由“是不是兄弟节点”决定。
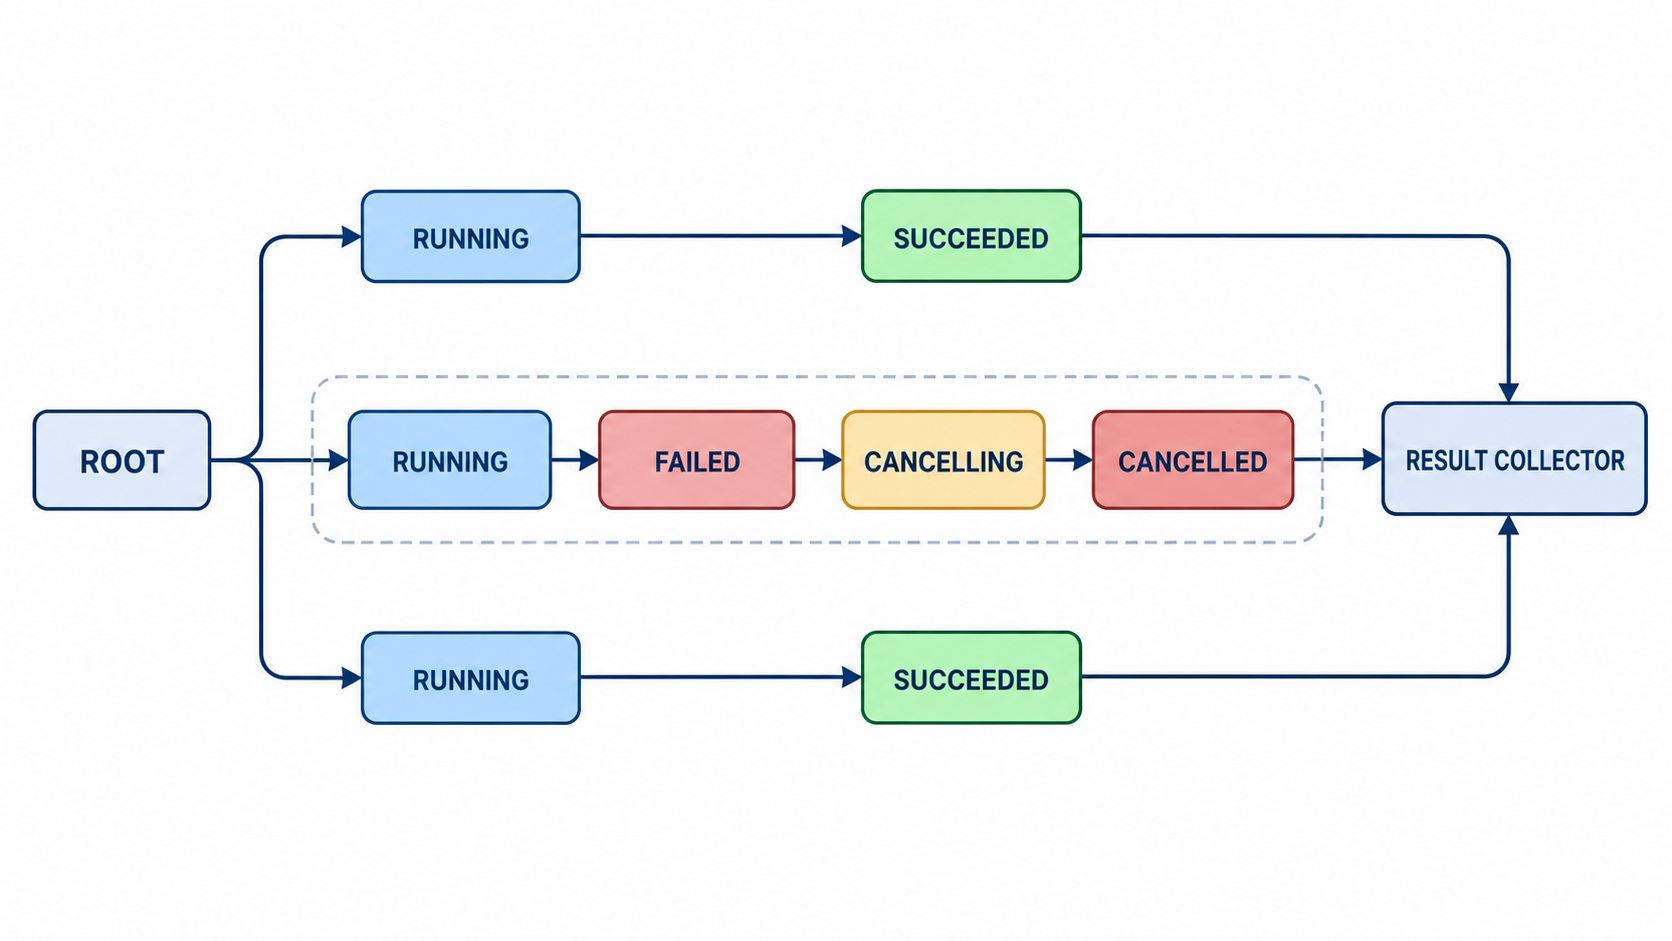
两种统一策略都会出错
“任何失败都全局终止”适合同一个原子目标。比如一次上线验收由迁移、校验和切流组成,安全校验失败后,继续切流当然没有意义。
但对可独立交付的任务,它会制造取消风暴:一个分支失败,已经完成的结果被丢弃,仍在运行的兄弟被中断,下一次执行又从头再来。
“失败永不向外传播”也不是答案。若发布 Agent 无视安全检查失败继续工作,所谓隔离只是把错误藏起来。
所以调度器至少需要三种关系:
FAIL_FAST:同一原子目标,任一关键节点失败就停止组内其他任务;SUPERVISE:兄弟结果可独立验收,一个失败不自动取消其他节点;FIRST_WINS:多个候选竞争同一个结果,首个成功后停止其余候选。
Python 的 TaskGroup 展示了 fail-fast 的一面;Kotlin 的 SupervisorJob 展示了兄弟隔离;Temporal 的 Pick First 则把“已有胜者”作为取消其他候选的理由。重点不是照搬某个运行时,而是让每个任务组明确选择语义。
取消不是一次状态赋值
很多系统调用 cancel() 后立刻写入 CANCELLED。UI 变绿了,执行器却可能仍在运行,甚至正准备提交一个外部动作。
取消更像协议:
RUNNING
  ↓ request cancellation
CANCELLING
  ↓ executor acknowledges and cleans up
CANCELLED
如果执行器没有确认,系统就不能假装任务已经停下。一个诚实的 CANCELLING 或 UNKNOWN,比错误的确定性更有用。
取消记录还应包含范围和原因:
interface Cancellation {
  scopeRoot: string;
  reason: "dependency_failed" | "result_satisfied" | "user_requested";
  requestedAt: string;
  acknowledgedAt?: string;
}
原因很关键。竞速中落败的候选是正常取消,不应该污染失败率;用户主动停止和依赖失败,也需要不同的复盘与重试策略。
不要让根节点只返回 true 或 false
如果三个独立任务中两个成功、一个失败,根任务到底算什么?只返回失败,会把可用结果隐藏;只返回成功,又会掩盖缺口。
更好的结果收集器返回一个组合交付:
interface GroupResult {
  completed: ArtifactRef[];
  failed: FailureRecord[];
  cancelled: CancellationRecord[];
  completeness: "complete" | "partial" | "unusable";
}
这样父任务可以根据验收规则决定:部分交付、等待人工补齐,还是整体失败。开发者也能看到真正发生了什么,而不是在一个红色根节点下面猜测哪些成果被系统扔掉了。
最难的边界是外部副作用
任务树可以被取消,已经发送的邮件不能被“取消状态”收回来。支付、发布、写库同样如此。
因此局部取消不能承诺回滚现实世界。副作用节点必须保存执行事实、幂等键和外部回执;取消与回执竞态时,迟到的事实仍然要被记录。状态不确定时停下来核对,比把整个子树重新跑一遍安全得多。
这也解释了为什么 CANCELLING 是必要状态:调度器发出的只是意图,执行器和外部系统的真实终态还没有被确认。
最后
任务树解决了“谁委派给谁”,故障域解决“谁应该为谁的失败付出代价”。
可靠的多 Agent 调度,不是让失败永远不传播,也不是一遇到异常就拉下总闸。它应该保留仍有价值的兄弟结果,只停止已经失去继续价值的分支,并对无法撤销的外部动作保持诚实。

