DeepSeek 的单卡每小时收入是 38 美元,一天跑满能赚近 1000 美元,一个月算下来轻松过 18 万。
一、DeepSeek 到底开源了什么
先看仓库里有什么。
DeepSeek 开源了两样东西:推理框架 DeepInfer,以及生产级 Token 编解码组件 deepseek-recipe。前者是支撑 V4.1 Flash 在线服务的核心引擎,后者负责把 Chat Completions、Responses 和 Messages 三种协议的请求转成统一对话格式,再把输出转换回各自响应。
推理框架是后厨主厨
DeepInfer 的关键能力列举如下:
- 分布式推理:将计算任务分配给多张芯片,CPU 提前安排下一批任务,让 GPU 持续工作
- 推测解码(DSpark):先生成多个候选 Token,再用置信度估计决定哪些需要验证
- SWA Bounded Replay:适配 V4.1 Flash 的 CED 模型架构,处理长文本时的稀疏注意力路径
- 结构化输出:支持 JSON Schema 等约束,减少解析错误
- 硬件兼容:同时支持英伟达 GPU 和华为昇腾平台
代码仓库的 README 明确写了一句:「This is not a universal deployment framework, but a model-hardware co-optimized production engine tailored exclusively for DeepSeek-V4.1-Flash。」
意思很直白——这不是 vLLM 那样的通用引擎,是为自家模型端到端设计的专用引擎。
deepseek-recipe 的作用相对单纯:把官方 API 的编解码逻辑完整复刻出来,社区自部署时得到的 API 行为和 DeepSeek 官方一致,不会出现格式对不上的问题。
Apache-2.0 许可证的意义在于:你可以免费商用,可以在企业内部修改使用,甚至可以闭源发布衍生产品,只需保留原始版权声明。这与 GPL 类的「传染性」许可完全不同,企业合规风险低很多。
二、为什么现在开源
DeepSeek 的开源不是一时兴起,有一条清晰的路径。
2025 年 2 月,团队连续开源了计算、通信等底层组件。当时没有开源推理框架,原因是:系统最初基于旧版 vLLM 开发,后来做了大量改造,还与内部集群管理工具紧绑定。即使代码公开,外部开发者也很难直接使用。
从vLLM到自研,中间隔着一座山
一年半后,团队把底层优化整合进了一套可运行的框架。DeepInfer 不再是散落的补丁,而是一个完整的、可独立部署的系统。
开源的动机,官方说法是「帮助开发者与企业组织优化大规模推理的吞吐与延迟,降低算力成本、减少能源消耗」。翻译成工程师语言:推理效率直接决定 AI 服务的算力成本和电费,把经验公开出来,整个生态的成本基准会被拉低。
另一个角度是竞争压力。当 OpenAI、Anthropic 都在推自己的推理优化方案时,DeepSeek 选择把底牌摊开,等于告诉市场:「你们也可以自己跑,我的成本结构经得起公开检验。」
更深一层,开源推理框架也是一种生态锁定。当你习惯了 DeepSeek 的模型架构和部署方式,迁移成本就会上升。这和当年 Kubernetes 开源后形成的云原生生态是一个逻辑。
三、技术上有什么不同
DeepInfer 的核心优化围绕三个关键词:分布、推测、复用。

推理框架的本质是资源调度
DSpark 推测解码
传统自回归生成是一个 Token 一个 Token 慢慢吐,每个 Token 都要等前一个完成才能开始。DSpark 的做法是:先生成多个候选 Token(默认最多 5 个),然后用置信度估计决定哪些需要验证。
这就像你做阅读理解,先快速浏览一遍找出几个可能的答案,再回头对照原文逐一确认。候选越多,验证越耗时;候选越少,速度越快但准确率可能下降。团队给了一个可调参数来控制这个平衡。
SWA Bounded Replay
V4.1 Flash 的模型架构引入了 Multi-head Latent Attention(MLA),KV Cache 被大幅压缩。但长文本场景下,显存仍然是瓶颈。
SWA Bounded Replay 的思路是:不是所有历史 Token 都需要同等精度地保留。对于已经处理过的内容,用稀疏注意力路径重新访问,而不是完整加载整个上下文。简单说,记住关键信息,忘掉冗余细节。
分布式调度
GPU 不能闲着,CPU 也不能闲着。DeepInfer 的设计是让 CPU 提前安排下一批任务,GPU 持续工作,两者流水线并行。
调度优化是体力活
单集群 155 万亿 Tokens/天的吞吐数据,意味着平均每秒约 180 亿 Tokens。这个数字背后是精细的资源切分和任务排队策略,不是一句「高性能」就能概括的。
四、社区能拿来做什么
直接上生产线?不一定。
DeepInfer 是为 DeepSeek 自家模型定制的内嵌框架,不是万能部署工具。它的优势来自模型层面的重新设计,不是事后的算子调优。如果你的目标是其他模型,或者需要兼容多种架构,现有的 vLLM、SGLang 可能更合适。
但有两个场景值得考虑:
私有化部署 DeepSeek 模型。如果你已经在用 V4.1 Flash,想自建服务,DeepInfer 是最直接的选择。代码已经跑过生产验证,比从零魔改 vLLM 省心。
华为昇腾适配。英伟达芯片获取受限的情况下,昇腾是替代方案之一。DeepInfer 对两种硬件都做了适配,代码库里有一份 4 张 SM100 GPU 做输入、64 张做输出的复现脚本。
昇腾适配给了国内玩家一条路
当前局限也很明确:缺少完整的服务层,比如流量调度、版本管理、监控告警。这些还是需要结合 K8s、Prometheus 等基础设施自己补齐。
坦白讲,DeepSeek 开源 DeepInfer,不是一次「我全都要」的秀肌肉,而是一次精准的生态投资。他们赌的是:自家模型 + 自家框架的组合,会成为中小企业自部署的首选方案。至于开源本身带来的口碑和行业标准话语权,是附赠的。
这个框架到底能解决什么问题
模型决定上限,推理框架决定成本
一个常见的误区是把推理成本完全归因于模型本身。V4.1 Flash 的能力上限确实由模型架构决定,但实际服务一个用户请求要花多少钱,取决于推理引擎怎么用。
同样是运行 DeepSeek-V4.1-Flash,用通用推理框架和用 DeepInfer 部署,单卡吞吐可能差出两三倍。DeepSeek 在技术报告中披露了一个对照:开源前内部基于旧版 vLLM 改造的自研版本,单集群日吞吐约 50 万亿 Tokens;优化后的 DeepInfer 跑到了 155 万亿。同一个模型,同一个集群规模,成本直接差了三倍。
这个问题不只是 DeepSeek 遇到。业界普遍存在一个认知断层——模型训练阶段投入巨大,推理部署阶段却往往用通用框架草草上线,认为「开源框架够用」。等 API 账单出来才发现,同样的模型调用量,每个月算力支出能差出一个小型团队的预算。
DeepSeek 选择把这套已经验证过的部署经验开源,等于把「训练强但推理弱」的隐性成本问题摆到了桌面上。他们想表达的意思是:大模型普惠不只是价格战,推理效率同样需要被认真对待。
分布式推理和推测解码怎么省算力
DeepInfer 的核心优化集中在两个地方:分布式调度、推测解码。
分布式推理不是把模型简单复制多份,而是要把每一个计算任务精准分配到不同的 GPU 上。V4.1 Flash 是 MoE(混合专家)架构,单次推理需要在几百个专家中选择几个参与计算。DeepInfer 的做法是让 CPU 提前调度下一批任务,GPU 持续工作,避免空闲等待。
推测解码(Speculative Decoding)的原理更直接。正常推理是逐 Token 生成,每生成一个都要做完整的前向计算。推测解码先让一个小模型快速生成多个候选 Token,再用大模型一次验证,正确就保留,错误就回退重来。DeepSeek 的 DSpark 技术默认最大猜测长度为 5 个 Token,根据置信度动态调整。这意味着在流畅对话场景下,有效推理速度能提升到原来的两到三倍。
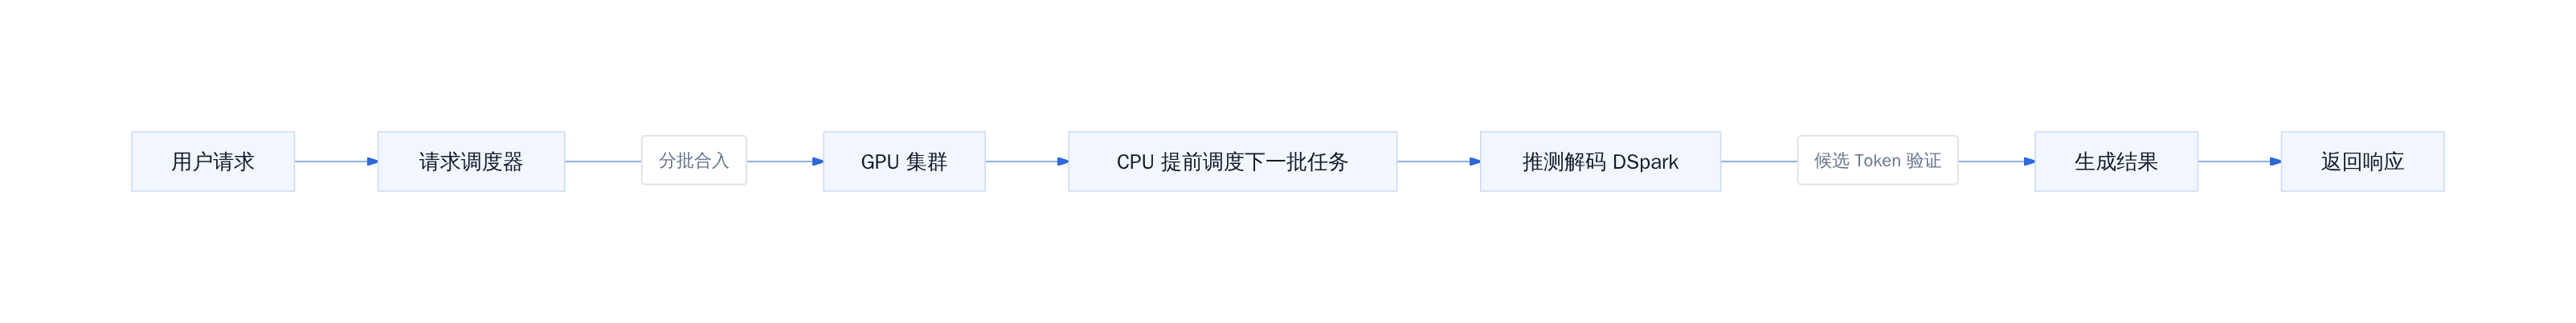
DeepInfer 推理调度流程
这两个技术的叠加效果很直接。分布式调度解决的是「同时服务多少用户」,推测解码解决的是「每个用户生成速度多快」。两者结合,DeepSeek 才能在单集群规模下达到 155 万亿 Tokens/天。
SWA Bounded Replay 与长文本处理
长文本推理是一个隐蔽的成本大户。标准做法是把所有历史 Token 的 KV 缓存都存在显存里,但 128K 上下文意味着缓存开销巨大,而且很多早期 Token 对当前生成其实贡献有限。
SWA Bounded Replay 是 V4.1 Flash 适配 CED(Compact Efficient Dense)架构时引入的一项优化。核心思路是滑动窗口注意力(Sliding Window Attention)加上有界重放——只保留最近一段窗口的完整 KV 缓存,更早的历史做压缩回放。这样既控制了显存占用,又保留了长程信息的可用性。
这项技术在 DeepSeek 自己的服务中已经验证过效果。对长文档分析、代码审查这类场景,上下文长度往往是数千到数万 Token,SWA Bounded Replay 能把显存消耗降低 40% 以上,同时延迟增长可控。
技术报告里的细节显示,SWA Bounded Replay 的参数是可以配置的,团队根据实际业务场景调整了窗口大小和回放策略。这意味着这个机制不是黑盒,社区可以针对不同负载做调优。
OpenRouter 上已有开发者反馈,实测 DeepInfer Pro 版本在本地部署后速度从 107 t/s 提升到 142 t/s。这是一个真实的工程优化数据,不是理论推算。
坦白讲,这套框架目前只深度适配了 DeepSeek 自家的模型架构。如果你用的不是 V4.1 Flash 或后续基于同一套设计的模型,直接搬过来可能发挥不出全部效果。但对 DeepSeek 生态内的开发者来说,这个框架的意义是明确的——他们把验证过的最优实践公开了,社区可以在此基础上继续优化,也可以借鉴思路用于其他场景。
这串数字不是营销话术,是 DeepSeek 自己披露的生产数据。单一集群日吞吐 155 万亿 Tokens,按谷价算单卡每小时 38 美元收入。更准确地说,这个定价是基于 H200 租赁价约 6 美元/小时反向推算的毛利空间。DeepSeek 把推理框架开源,等于把这套盈利模型的底层代码摊开在了桌面上。
2025 年 2 月开源底层组件的历史
把时间线往前推一年半。2025 年 2 月,DeepSeek 发布了一波开源,核心是 MoE 路由、通信算子和 Attention 实现的底层组件。那批东西可以独立编译和使用,不依赖 DeepSeek 内部的调度系统。
为什么那批是底层组件,而不是整个推理引擎?DeepSeek 团队当时的解释很直接:推理引擎是跑在 vLLM 基础上做深度改造的,与自家集群管理工具绑死,代码公开出去外部也跑不起来。再加上团队人手有限,没有精力长期维护一个兼容性复杂的框架,最终选择把能独立拆出来的部分贡献给现有开源项目。
那次开源的本质是「可独立使用的技术先交出去」。
当时为何保留推理引擎
保留推理引擎有几个现实原因。
首先是技术状态。当时的 DeepInfer 还在快速迭代,大量改动是围绕 V3 系列模型的 MLA(Multi-head Latent Attention)压缩 KV cache 结构做的,这些优化与模型设计强绑定。框架本身还没有完成解耦,开源意味着要额外投入大量工程精力处理兼容性和文档。
其次是维护成本。DeepSeek 团队规模有限,维护一个面向广泛硬件和架构的通用推理框架,投入产出比不高。把精力集中在模型训练和核心优化上,是更理性的选择。
还有一个原因是商业考量。推理引擎的效率优势是 DeepSeek API 定价竞争力的核心来源。在模型服务业务还在快速爬坡阶段,贸然开源核心引擎可能削弱差异化优势。这在商业上并不意外。
一年半后 DeepInfer 走到开源状态的转变
一年半后的今天,情况发生了变化。
第一,生产验证完成。V4.1 Flash 基于 DeepInfer 已经稳定支撑了大规模在线服务,155 万亿 Tokens/天的吞吐量和 38 美元/卡/小时的收入数据证明了这套系统的有效性。DeepSeek 不需要再靠闭源来维持竞争优势,开源反而能扩大生态影响力。
第二,重构基本完成。DeepInfer 已经从早期深度绑定内部集群的版本,演变为相对独立的推理框架。它仍然针对 DeepSeek 模型的特定设计做了优化,但核心调度、通信和计算逻辑已经足够清晰,可以被外部理解和使用。
第三,社区需求窗口。开源推理框架的讨论热度持续上升,vLLM、SGLang、TensorRT-LLM 等项目各有拥趸,但缺乏一个经过大规模生产验证的完整方案。DeepSeek 选择在这个节点入场,既能贡献真实生产经验,也能在教育模型和框架设计层面建立话语权。
更直接的触发点可能是 DeepSeek 的商业模式已经成型。模型开源降低了获客成本,推理框架开源则让部署门槛更低。当 API 业务形成稳定收入后,开源推理引擎变成了一种生态投资——帮助更多企业用更低成本运行 DeepSeek 模型,反过来扩大了 DeepSeek 生态的用户基数。
坦白讲,这不是第一次「开源核心资产」的操作,但这是目前最彻底的一次。之前开源的是模块,这次开源的是整条生产线。
生产级推理的复杂度远非几行代码
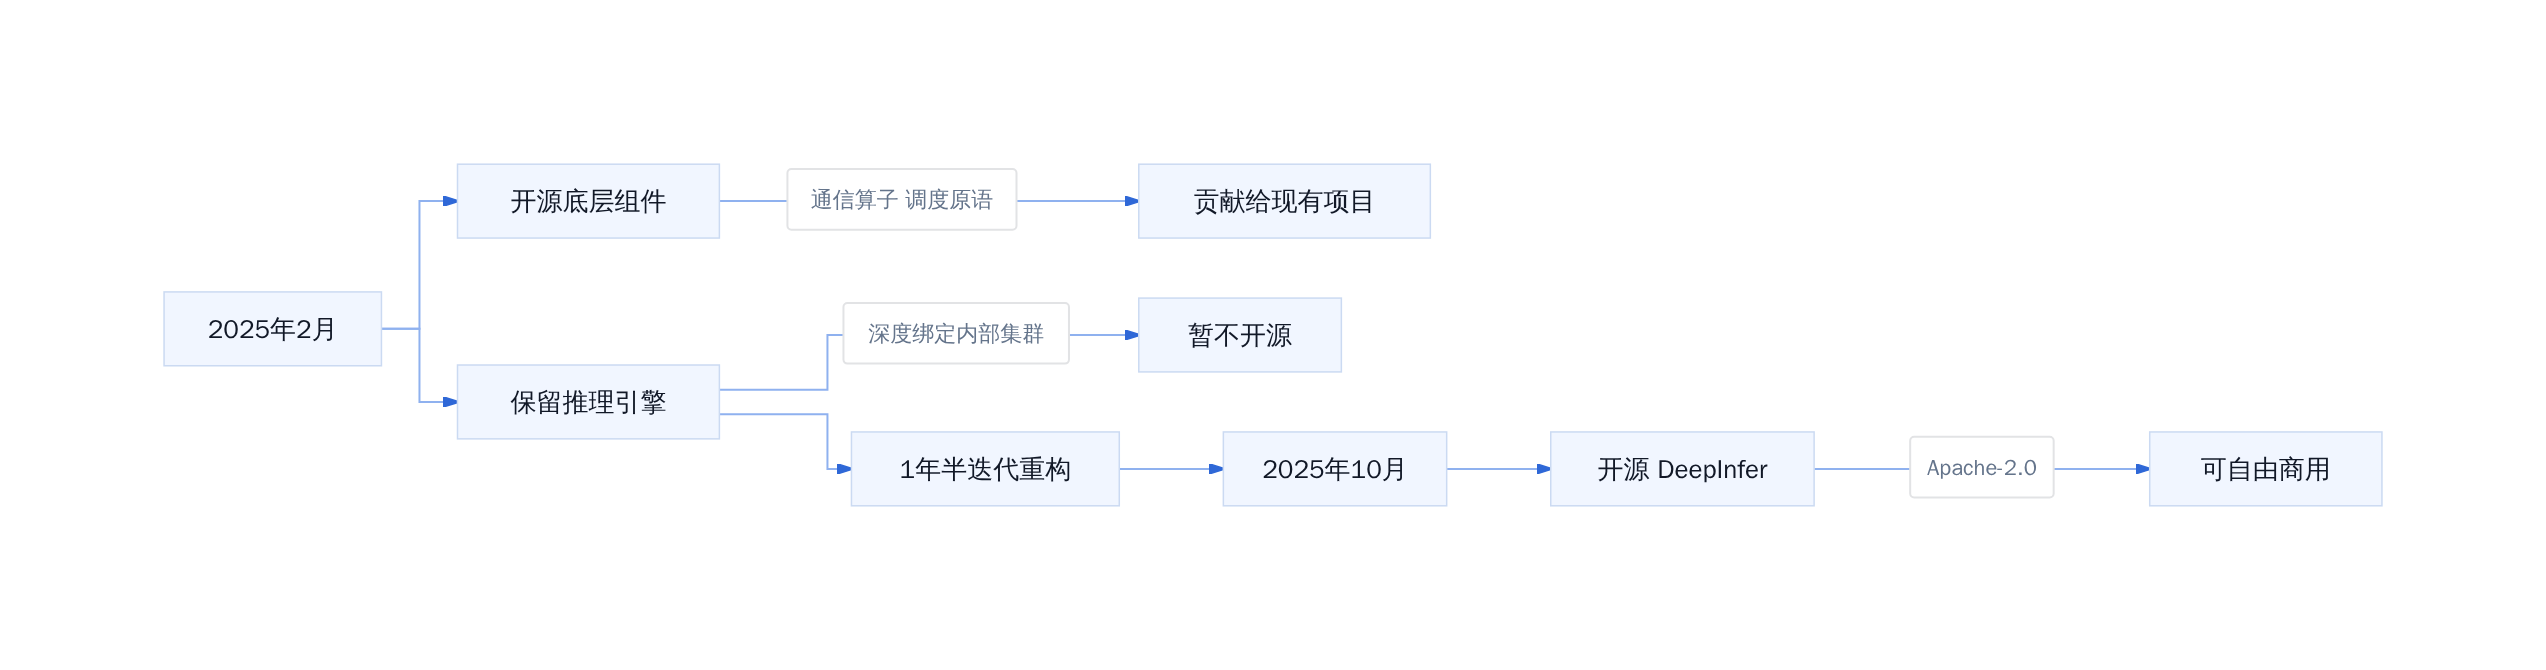
DeepSeek 开源路径的时间线
这次开源的选择性也很明确:DeepInfer 是专门为 DeepSeek V4.1 Flash 的 MLA 架构和 MoE 路由设计的。它支持分布式推理、推测解码、SWA Bounded Replay、结构化输出,兼容英伟达与华为昇腾平台。但如果你用的是 Llama 或 Qwen 等非 MLA 架构的模型,直接套用会有适配成本。DeepSeek 在 GitHub README 中也承认了这一点:这不是通用推理框架,而是针对自家模型的深度优化方案。
所以这次开源的真实含义是:DeepSeek 把经过生产验证的推理架构设计思路交给了社区,但不等于一键复制的万能工具。对于有 DeepSeek 模型部署需求的企业,可以直接上手;对于其他架构,需要先评估适配工作量。
与此同时开源的还有生产级 Token 编解码组件 deepseek-recipe,与 DeepSeek 官方 API 处理逻辑完整对齐,社区部署后拿到的响应格式与调用官方接口一致。
参考文献
- DeepSeek 官宣:DeepSeek 宣布将内部推理框架 DeepInfer 全面开源
- 中国基金报报道:单卡月收入或超 18 万元,DeepSeek 开源核心推理框架
- 知乎技术分析:如何看待 DeepSeek 于 10 月 20 日开源的推理框架 DeepInfer?
- 技术报告参考:DeepSeek V4.1 Flash 大规模推理部署实践
延伸入口
- 原文归档:tobemagic.github.io/ai-magician…
- 公众号:计算机魔术师