作者介绍
胡庭恺,西南大学电子信息工程学院,计算机科学与技术专业在读博士研究生,主要研究方向为无监督毫米波雷达SAR成像,长期致力于毫米波雷达与深度学习的交叉融合研究,尤其关注技术成果的工程转化能力与商业化落地潜力。亦在探索AI Agent技术在电子信息工程领域的赋能场景与应用实践。
引言
训练机器人,不必让它在真实世界里把所有的坑都踩上一遍。
在 Isaac Sim 这类物理引擎里,机械臂可以成千上万次地抓取、跌倒与重来。地面的摩擦力、关节的机械公差、动态的光照变化,都化作了随时可调的参数矩阵。模型在真正进入物理世界之前,已经先在虚拟环境里见过足够多的扰动。
自动驾驶也是如此,在 CARLA 里的暴雨浓雾可以随调随用,也可以模拟盲区突然窜出的行人,不需要冒风险去实地涉险。
当然,虚拟环境不等于真实世界,现阶段仍然存在 Sim-to-Real 的漂移鸿沟。但对于需要海量训练样本的机器人和视觉语言模型而言,仿真至少提供了一条可行路径:把那些昂贵、危险且难以复现的长尾工况,先搬进计算机里。
如今频繁被提及的 AI 雷达,其实也面临同一个问题。
雷达 并不缺仿真工具,真正缺少的,是一套能够以足够低的成本、足够高的效率,持续为 AI 模型生产多样化训练数据的仿真体系。
传统仿真的数据瓶颈
早在深度学习普及之前,工程师就已经长期依赖电磁计算、射线追踪和雷达目标模拟器,推算车辆、行人或墙面在特定场景下会产生怎样的回波。
车载雷达从简化的点目标模型一路走到高精度电磁散射模型,虚拟测试已经积累了几十年。
可既然雷达仿真已有多年积累,为什么这些仿真没有像机器人和自动驾驶那样,顺势“喂”出一个 雷达 Foundation Model?
根源在于“验证算法”和“训练模型”,对应的是完全不同的工程诉求。
传统仿真服务的是“算法验证”。
它围绕特定场景下的特定目标配置展开,追求在物理规律约束下对电磁回波进行严谨的正向计算。而现代深度模型的胃口则完全不同,其需要的是庞大的样本体量、极高的场景多样性,以及足够低的边际生产成本。
这种对数据规模的需求正在快速增长。
2022 年,法雷奥旗下 Valeo AI 团队开源了 RADIal 数据集,体量为 2.5 万帧、约两小时 [1]。
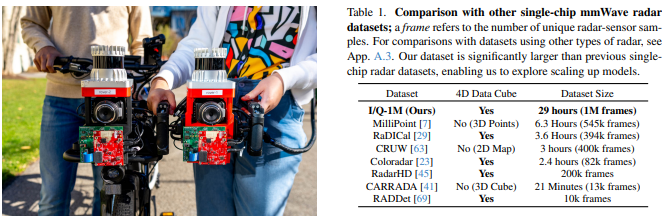
到 ICCV 2025,卡内基梅隆大学 WiseLab 实验室发布的 I/Q-1M 数据集已扩展至 100 万帧、约 29 小时,并借此训练出面向单芯片雷达的通用 Transformer 模型 GRT [2]。
如果只比较样本数量,两者相差约 40 倍。
当然,两套数据集的雷达Configuration、任务和采集方式并不完全相同,这个数字并不能简单理解为雷达数据集在三年间实现了严格意义上的“40 倍增长”。
但它至少说明了一件事:随着雷达开始进入 Representation Learning 和 Foundation Model,模型对数据规模的需求正在明显提升。
若按缩放定律估算,要彻底激发雷达基座模型的泛化潜力,行业可能需要储备上亿帧、数千小时量级的原始射频数据。
如果雷达 Foundation Model 继续走向更大规模的数据训练,这些数据从哪里来?
纯靠实测来填补这个缺口并不现实。几千个小时的路测背后,是恶劣工况的漫长等待、多传感器的时空同步对齐、精密外参标定与稠密标注,工程代价极其高昂。
而且单纯以物理里程堆砌数据,也很难完全避免特征同质化。**那数据规模缺口能不能靠传统仿真来补?**传统仿真看似省去了等待,代价却会转移到场景构建上。
车身的金属曲率、沿街墙面的介电常数、天线阵列方向图、地面与障碍物的多次多径反弹,都需要在事前交代清楚。路测环节省下来的时间,很可能又转化成前序繁重的几何建模与材料赋值。
问题并不是传统仿真不能生成数据。而是当目标从“验证若干特定场景”,变成“持续生产百万乃至更大规模的训练样本”之后,高保真度、场景多样性、数据规模与生成成本之间开始变得很难同时兼顾。 而且传统仿真的重手工流程,根本供不起大模型吞食的数据通量与边际成本。
随着 AI 逐步进入毫米波雷达感知,数据采集、标注、仿真和模型训练正成为越来越重要的研究方向。
SuperRadar 开发者社区正在通过 AI Radar Kit 推动雷达数据、算法和 AI 的融合开发,并持续关注数据集构建、仿真训练与模型评估等技术问题。
对于希望进入 AI Radar 领域的研究者和开发者,SuperRadar 也在提供更多技术交流与实践入口。
AI 如何让雷达仿真降本增效
过去,传统雷达仿真的吞吐量很大程度上受限于几何与材质资产的准备。
- 换测试目标,就可能需要重新制作精细 CAD;
- 换测试场地,又需要重新丈量尺寸并分配电磁参数。
Foundation Model 需要更大的数据规模,这种重人工的生产方式很难长期匹配。
近几年,雷达数据合成重新成为学术界关注的方向。推动这一轮变化的一个重要原因,是 AI 技术本身也开始降低传统仿真在场景构建上的门槛。
第一个变化来自计算机视觉。
图片和视频里已经存在海量的目标、人体动作和真实场景。姿态估计可以从中提取运动轨迹;单幅 RGB 也能通过 3D Gaussian Splatting、神经辐射场等技术恢复目标的三维几何。
场景获取的起点,正在从人工制作 CAD,逐渐变成直接从已有视觉数据中获取所需目标和环境。
2021 年,卡内基梅隆大学团队提出 Vid2Doppler,尝试将普通视频转换为多普勒雷达数据[3]。
北京邮电大学团队则将视频到雷达的映射从单一多普勒拓展到距离-多普勒等更丰富的物理特征[4],并在后续综述中把这股趋势定义为“合成时代” [5]。
第二个变化来自生成式模型。
传统物理仿真擅长计算确定场景下的结果,却不擅长描述真实信号里那些难以完整写进公式的随机性。
扩散模型提供了一种新的可能:直接学习复杂数据分布。
2023 年,加州大学圣迭戈分校团队的 RF Genesis 将射线追踪与扩散模型结合,尝试缓解不同用户、环境及硬件之间的泛化问题 [6]。
2024 年,清华大学、香港大学与华为联合团队的 RF-Diffusion,则进一步在复数射频信号的时频域学习原始数据的统计规律 [7]。
第三个变化来自视觉语言模型 VLM。
过去材质参数往往依赖人工赋值,现在 VLM 已经具备从图像理解物体类别与材料属性的能力。
例如,一张图片中的目标究竟是混凝土墙、金属车身还是其他材质,都可能成为后续 Physics-based Simulation 的先验信息。
哥伦比亚大学 2026 年提出的 Sim2Radar,就已经开始尝试利用 VLM 完成材质推断,再将结果送回物理模型计算雷达回波 [8]。
这些变化表明,雷达数据合成正在从少量、定制化的验证工具,逐步演化为具有规模化数据生产潜力的工具。
数据合成量变=质变?
这一技术变化也触发了我个人的研究工作。
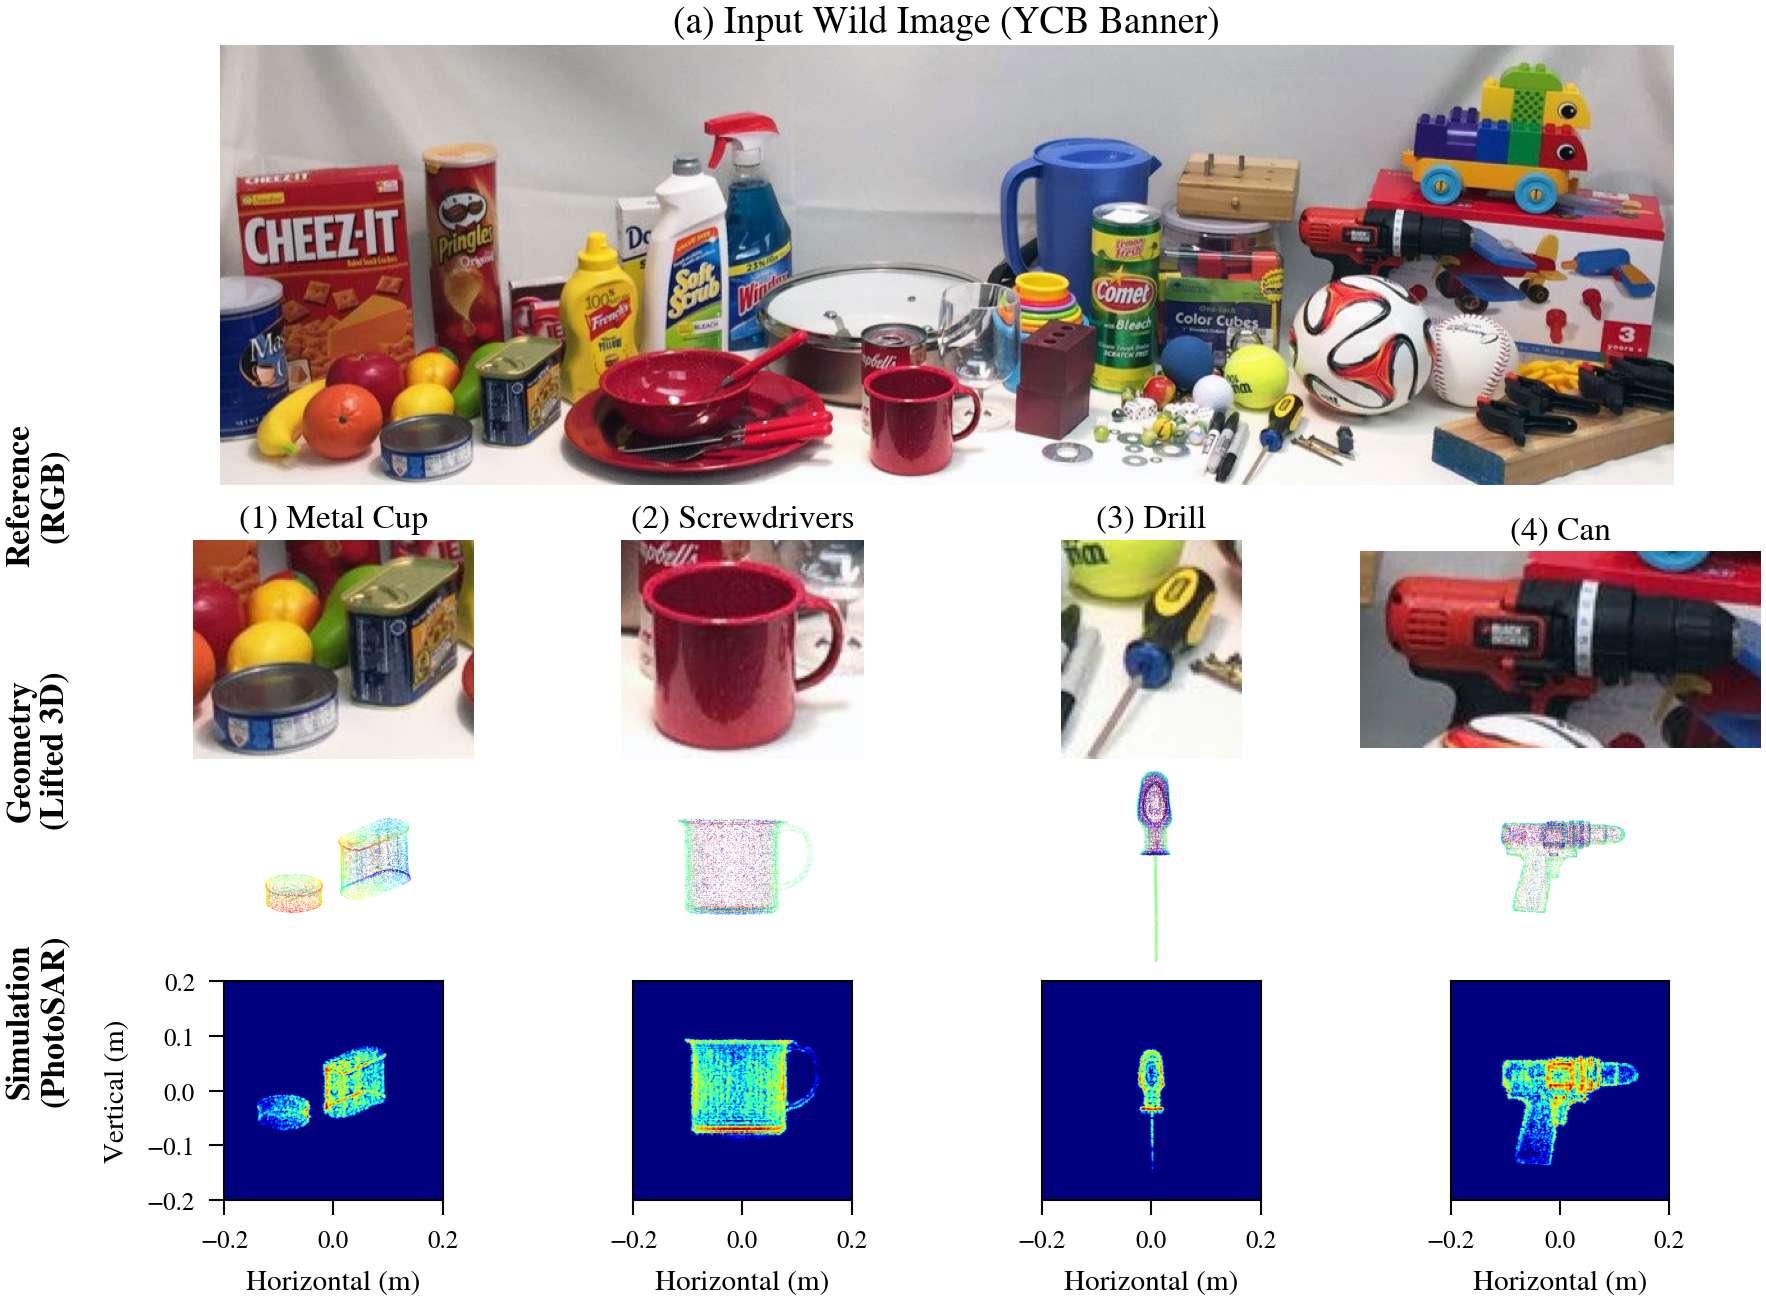
受 Meta 单目三维重建相关工作的启发,我们推进了一个名为 PhotoSAR 的项目,希望从单张 RGB 图片直接生成毫米波近场 SAR 回波数据,以缓解毫米波合成孔径雷达数据稀缺与场景单一的问题。
具体做法是先从照片重建物体的三维几何,结合反射和衍射规律,再通过 FMCW 雷达方程解算原始I/Q信号 [9]。
但问题很快就出现了。
即使这套链路可以持续生成大规模、多样化的合成数据,送入神经网络后,通常也只在那些重度依赖几何轮廓与视觉先验的下游任务上有效,比如SAR成像、目标检测或语义分割。
可一旦下游任务延伸至对相位极其敏感的深水区,比如微动识别或超分辨定位,模型从仿真到真实场景的表现往往大幅滑坡。
原因在于,毫米波雷达对世界的感知与可见光存在本质差异。
- 两堵视觉上完全相同的墙壁,内部材料构成与湿度的细微差别,会带来截然不同的反射衰减与透射特性。
- 微小的表面几何凹凸一旦接近毫米级波长,就会激发出剧烈的相位扰动。
- 地面与金属构件多次弹跳形成的多径散射,更会在空间中衍生出时隐时现的虚假目标。
- 如果底层物理因果存在系统性偏差,生成数据就可能对模型的特征学习形成误导。
更麻烦的是捷径学习: 如果仿真算法因为网格离散化、射线截断或几何简化,无意间引入了某种特定的系统性伪影,且这种伪影恰好与特定分类标签高度共现,深度模型就会迅速将其作为判别捷径来记忆。
其结果往往是模型在合成测试集上指标亮眼,一旦部署到真实物理场景,泛化性能就会出现非预期的崩溃。
PhotoSAR 给我的一个直接教训是合成得多并不自动等于合成得对。纯粹依赖黑盒数据生成模型,它的物理可靠性很难完全保证;但如果要求穷尽所有电磁细节,又会严重拖累计算效率与生成规模。
那么,Foundation Model 真正需要的究竟是什么样的合成数据?
我个人更倾向于一种分治思路:确定性的规律交给物理方程,难以显式描述的复杂性留给数据去学。
实测数据始终是锚定物理边界的基准,仿真环境则是定向攻坚长尾工况的杠杆,以少量高质量的真实路测标定误差边界,用仿真定向补齐短板,再放回现实世界严格求证。
但这条分界线究竟应该画在哪里,两边如何衔接,衔接之后又怎样验证,目前仍然是开放问题。
好在近几年已经有团队开始给出不同的探索。
CMU WiseLab 团队在 mmGen 中显式引入多径传播与天线增益计算[10]。
北航与清华大学智能产业研究院(AIR)等团队推进的 Ctrl-RS 通过波形参数嵌入实现了对合成信号形态的精确控制 [11]。该工作的早期预印本版本曾使用 SA-Radar 这一名称,后续版本已更新为 Ctrl-RS。
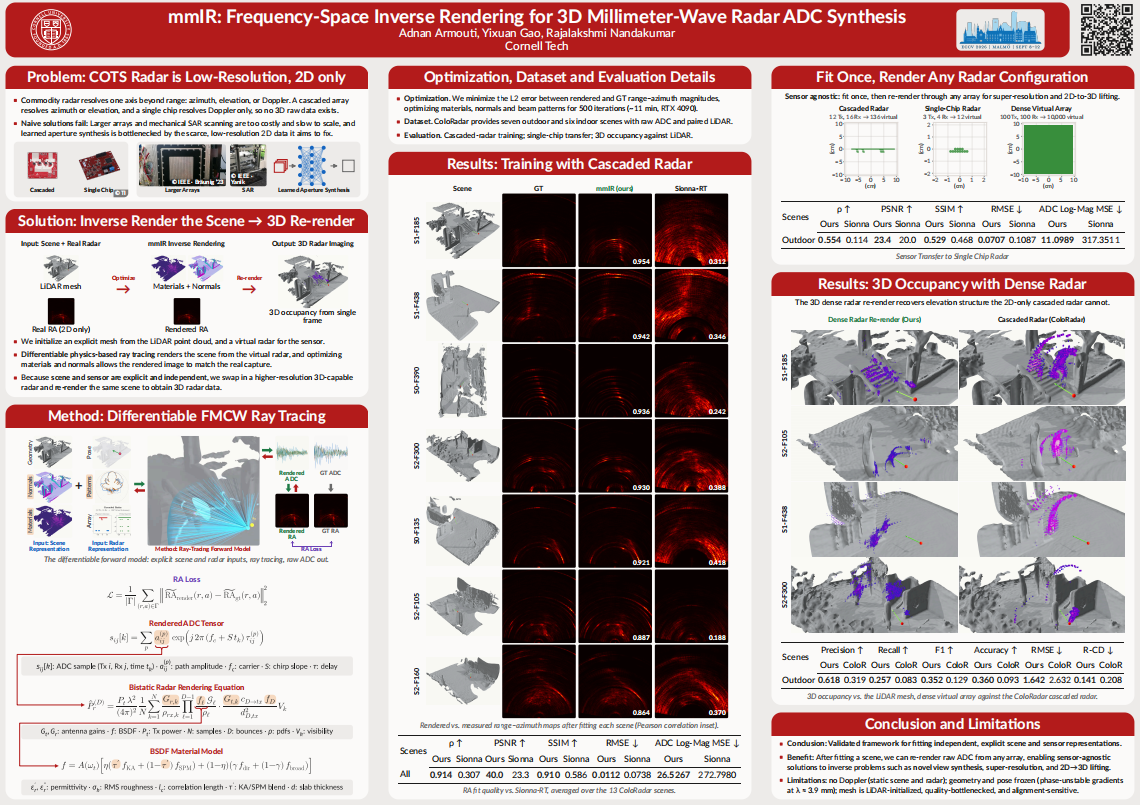
康奈尔大学的mmIR以LiDAR网格为几何骨架,通过可微逆渲染从真实FMCW ADC拟合物理材质与天线波束,再经相位相干MIMO前向模型联合建模多径、极化与衍射,正向合成ADC数据,且无需重训练即可迁移至不同雷达配置 [12]。
虚实数据如何协同?
如果从研究视角看这个问题,我暂时没有一个成熟的工业答案。
但聚焦当下,我认为有两个方向值得重点关注。
第一个方向是摸着自动驾驶和具身智能过河。
自动驾驶和机器学习在仿真训练、领域随机化、仿真到现实等问题上已经探索了很多年。
其中包括合成数据 与真实数据的比例怎样分配、什么时候提高仿真难度、怎样设计更动态的抗扰训练策略,以及不同任务难度应该如何安排。
雷达和视觉、机器人并不完全一样,这些方法不能直接照搬,但其中很多关于数据分布、长尾覆盖和稳健训练的经验,仍然具有较强的参考价值。
第二个方向是利用更加成熟的模态帮助雷达生产数据。
图片、视频、激光等模态已经积累了多年。
它们的数据获取成本相对更低,场景覆盖更加广泛,同时还可以提供几何、运动、语义 等毫米波雷达仿真所需要的先验信息。
Vid2Doppler、PhotoSAR、Sim2Radar、mmIR 等工作,本质上都在不同程度上体现类似的思路:先利用成熟模态获取环境和目标信息,再将这些信息转化为雷达数据。
至少从短期看,这可能是缓解雷达数据匮乏的一种现实补充。
从领域问题出发,我认为最难解决的仍是 sim2real 漂移。只要做仿真到实测迁移,都绕不开这个问题。具体来说,目前缺乏有效的evaluation机制,缺乏一个能判断合成数据在什么条件下会以什么方式误导模型的评估框架。
这可能是下一阶段雷达数据合成比单纯扩大数据规模更值得关注的问题。
写在最后
仿真反哺数据,归根结底,是希望通过 AI 为雷达Foundation Model建立一套能够持续补充训练样本的数据生产方式。
让模型不必在真实世界里把所有的坑都踩上一遍,而是先在计算机里见过更多扰动再回到真实世界接受验证。
现实数据仍然决定着真正的物理边界,仿真的价值更适合体现在补充数据分布、放大稀缺场景和针对模型薄弱环节进行定向训练。
欢迎一起探索
SuperRadar 社区正在推进的 AI 雷达,已经开始从雷达硬件、点云、ADC数据、数据等层面重新构建毫米波雷达的能力边界。相比传统毫米波雷达,当前雷达输出的点云密度、空间完整性和整体数据质量已经有了明显提升,能够保留下来并提供给后续算法使用的信息也更加丰富。
同时,我们也愿意与更多开发者一起,共建 AI 雷达生态,推动 AI 雷达应用,创新 AI 雷达市场,为智能时代的到来贡献力量,致力于服务 AI 雷达的同行者,共建繁荣生态。
从真实数据采集,到仿真合成、模型训练和 Sim-to-Real 评估,AI Radar 仍有许多值得研究的问题。
如果你正在研究毫米波雷达、AI 感知、雷达数据合成,或者对 Radar Foundation Model 感兴趣,欢迎关注 SuperRadar,与更多开发者一起交流探索。
参考文献
[1] J. Rebut, A. Ouaknine, W. Malik, and P. Pérez, “Raw High-Definition Radar for Multi-Task Learning,” in Proc. IEEE/CVF Conf. Comput. Vis. Pattern Recognit. (CVPR), 2022, pp. 17021–17030.
[2] T. Huang, A. Prabhakara, C. Chen, J. Karhade, D. Ramanan, M. O’Toole, and A. Rowe, “Towards Foundational Models for Single-Chip Radar,” in Proc. IEEE/CVF Int. Conf. Comput. Vis. (ICCV), 2025, pp. 24655–24665.
[3] K. Ahuja, Y. Jiang, M. Goel, and C. Harrison, “Vid2Doppler: Synthesizing Doppler Radar Data from Videos for Training Privacy-Preserving Activity Recognition,” in Proc. 2021 CHI Conf. Human Factors Comput. Syst., 2021.
[4] K. Deng et al., “Midas: Generating mmWave Radar Data from Videos for Training Pervasive and Privacy-Preserving Human Sensing Tasks,” Proc. ACM Interact. Mob. Wearable Ubiquitous Technol., vol. 7, no. 1, 2023.
[5] L. Xing et al., “The Dawn of Synthetic Era: Synthesizing mmWave Radar Data from 2D Videos for Human Sensing,” IEEE Communications Magazine, 2025.
[6] X. Chen and X. Zhang, “RF Genesis: Zero-Shot Generalization of mmWave Sensing Through Simulation-Based Data Synthesis and Generative Diffusion Models,” in Proc. ACM SenSys, 2023.
[7] G. Chi et al., “RF-Diffusion: Radio Signal Generation via Time-Frequency Diffusion,” in Proc. ACM MobiCom, 2024.
[8] E. Bejerano, F. Tondolo, A. Qayyum, X. Yu, and X. Jiang, “Sim2Radar: Toward Bridging the Radar Sim-to-Real Gap with VLM-Guided Scene Reconstruction,” arXiv:2602.13314, 2026.
[9] Y. Mo, T. Hu, C. Li, H. Xiong, and Z. Luo, “PhotoSAR: Synthesizing Object-Level Near-Field SAR Raw Measurements from a Single RGB Image,” in 2026 IEEE International Conference on Image Processing (ICIP), 2026.
[10] T. Huang et al., “One Snapshot Is All You Need: A Generalized Method for mmWave Signal Generation,” in Proc. IEEE INFOCOM, 2025.
[11] W. Xiao et al., “Controllable Radar Simulation with Waveform Parameter Embedding,” 2026.
[12] A. Armouti, Y. Gao, and R. Nandakumar, “mmIR: Frequency-Space Inverse Rendering for 3D Millimeter-Wave Radar ADC Synthesis,” 2026.