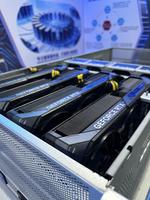
最近 AI 硬件圈子讨论热度很高,不少朋友在选型的时候纠结,搭建八卡集群到底选 RTX5090 还是 RTX4090D。 网上能搜到大量单卡跑分数据,但很少有人直接拉满两套完整八卡机器,持续跑一周真实 AI 负载。我在机房拿到两套配置相近的八卡整机,连续 7 天循环跑推理、绘图和轻量微调任务,把显存、吞吐、功耗、多卡稳定性这些维度测一遍,全部说大白话,只讲实测现象。
测试前提先说清楚:两套服务器,机箱、主板、供电链路、散热方案、多卡互联方案保持一致,唯一变量只有显卡。 一套:8×RTX 5090(Blackwell 架构,单卡 32GB GDDR7) 一套:8×RTX 4090D(Ada 架构,单卡 24GB GDDR6X) 测试环境:Ubuntu 22.04,CUDA 12.8,vLLM 用于大模型推理,ComfyUI 跑 Flux 绘图,训练用 peft 做 LoRA 微调。
重要说明:本次测试仅代表当前这套硬件 + 软件环境下的结果,不同框架、驱动版本、模型量化方式,测出的数据会有浮动,仅作选型参考,不是通用标准。
显存:两者最核心的差距
跑大模型,显存永远是第一道门槛。 RTX4090D 单卡 24GB,部署 70B 参数大模型,就算做量化处理,八卡张量并行分片之后余量依然很紧张。一旦输入超长上下文,很容易触发 OOM 显存溢出,要么降低并发 batch 大小,要么只能采用更高压缩量化,会轻微影响生成文本质量。
换成八卡 RTX5090,单卡多出 8GB 显存,优势很直观。同样 70B 模型,可以设置更大 batch,长文本场景不容易爆显存。跑 Flux 批量生成高分辨率图片的时候,4090D 八卡需要限制并发或者降低采样参数,5090 八卡的显存余量更充足。 这里提醒一点:多卡集群不能简单理解成 8 张卡显存直接相加,多卡通信会占用一部分可用显存,所以单卡显存的差距,在多卡场景下会被放大。
推理吞吐:并没有网传的翻倍提升
网上不少说法直接宣称 5090 性能是 4090D 两倍,这次实测下来达不到这个水平。 FP8 量化,vLLM 跑 70B 大模型推理:八卡 5090 集群吞吐相比八卡 4090D,提升大约 35%~45%。 Flux 文生图批量任务场景,性能差距会更大一点,最高接近 50%。 切换到 FP16 高精度推理,性能差距缩小至 25%~30%。
为什么达不到翻倍? 八卡集群的瓶颈不只是 GPU 本身算力,PCIe 通道、多卡通信开销、CPU 调度都会拖累整体性能。显卡数量越多,通信损耗占比越高。单卡跑分看着差距巨大,堆成八卡整机之后,整体性能增益会打折扣。很多单卡测评不会提到这个点。
整机功耗,长期使用必须算这笔账
RTX5090 单卡标称 TDP 575W;RTX4090D 单卡 TDP 425W。八卡满载时整机功耗差异很明显。 八卡 5090 整机满载功耗显著高于八卡 4090D。如果是 7×24 小时持续跑推理业务,电费是一笔持续支出。选型的时候要权衡:是优先更高的业务吞吐,还是控制长期电力成本。
7 天不间断压测:多卡稳定性表现
连续 7 天不间断循环跑任务,两套机器都没有出现掉卡故障。 但有个很现实的细节:八卡 5090 对机房散热要求更高。机房进风温度稍微升高,显卡温度就会快速上涨,触发 GPU 自动降频,性能跟着下滑。4090D 八卡整机散热压力更低,常规机房环境更容易稳定维持满负载运行。 自建机房要上八卡 5090,风道设计需要重点优化;托管机房使用,需要提前确认机柜制冷能力是否满足。
选型怎么判断?纯场景匹配建议
✅ 适合考虑八卡 RTX5090 的场景
- 业务经常跑 70B 及以上大参数量模型,大量长上下文请求;
- 需要批量 Flux 高分辨率图像生成,显存占用高;
- 业务对推理吞吐要求高,硬件预算充足,机房制冷条件达标。
✅ 适合考虑八卡 RTX4090D 的场景
- 主要跑 7B、13B 这类中小参数模型,量化后 24GB 显存足够承载业务;
- 成本敏感,需要长时间不间断运行,希望控制电费开销;
- 机房制冷条件普通,不想额外投入散热改造。
一句话总结:新卡不等于无脑首选。算力集群选型不能只看纸面跑分,要结合自身业务模型、并发量、电费预算、机房条件综合判断。5090 不是全方位碾压 4090D,场景不合适,性能优势发挥不出来。
写在最后
网上大量相关讨论基本都是单卡跑分对比,很少有人拿两套完整八卡机器做长时间连续压测。 本次测试硬件由外部提供用于技术性能测试,本文只记录硬件实测数据,不推销服务器、算力租赁、托管投资类产品,不做任何收益承诺。测试数据仅适用于本次软硬件环境,仅供 AI 从业者硬件选型参考。
如果你正在搭建八卡集群,可以在评论区聊聊你的模型和业务场景。