你有没有用过可视化编排平台?拖拖拽拽,把节点连起来,点一下运行——画布上的节点一个个亮起来,像多米诺骨牌一样往前跑。
这个过程看起来很简单,对吧?但你有没有想过:你拖出来的那堆节点,平台是怎么知道先跑哪个、后跑哪个的?
大多数人的第一反应是:"这有什么好想的?从起点开始,顺着连线往下跑不就行了?"
没那么简单。你画的画布是一张图——节点是点,连线是边。但图是有方向的,而且可能很复杂:有分叉、有汇合、有并行。运行的时候,你怎么知道哪些节点可以同时跑、哪些节点必须等上游完成?
答案是:拓扑排序。
但问题来了——这个排序是什么时候做的?是你点"保存"的时候就排好了,还是每次点"运行"的时候再现算?
别小看这个区别。这就是"跑一步算一步"和"编译期与运行期分离"的根本差异。
一、自由拖拽出来的画布,不是可执行的图
先讲清楚一件事:你在画布上拖出来的那堆东西,不是一个可执行的图。
它只是一堆节点和连线的集合——就像你把零件摊在桌上,还没组装。你点一下"运行",平台要做的第一件事,就是把这堆零件组装成一个可以跑的东西。
这个"组装"的过程,就是编译。
编译的时候要做什么?
第一件事:拓扑排序。 把节点排成一个正确的顺序——排在前面的节点跑完了,后面的节点才能开始。这是最基本的:你不能先跑第三步,再跑第一步。
第二件事:环路检测。 看看这个图里有没有环——如果有 A→B→C→A 这样的环,那这个工作流就死循环了,永远跑不完。检测到环,直接拒绝保存。
第三件事:起终点校验。 看看有没有孤立节点——一个节点既没有上游也没有下游,孤零零地挂在那里,这是个错误。再看看有没有起点——没有起点的工作流,谁来触发它?
第四件事:连线编译。 节点之间的连线,不是简单的"从A到B"——它实际上是在说:"B节点的某个参数,取A节点的某个输出字段的值"。这个字段级的取值路径,要编译成可以直接读取的格式,存到数据库里。
这四件事做完了,你的画布才从"一堆零件"变成"一个可以跑的程序"。
二、保存的时候编译,还是运行的时候编译?
这里有个关键的设计选择:这些编译工作,是点"保存"的时候做,还是点"运行"的时候做?
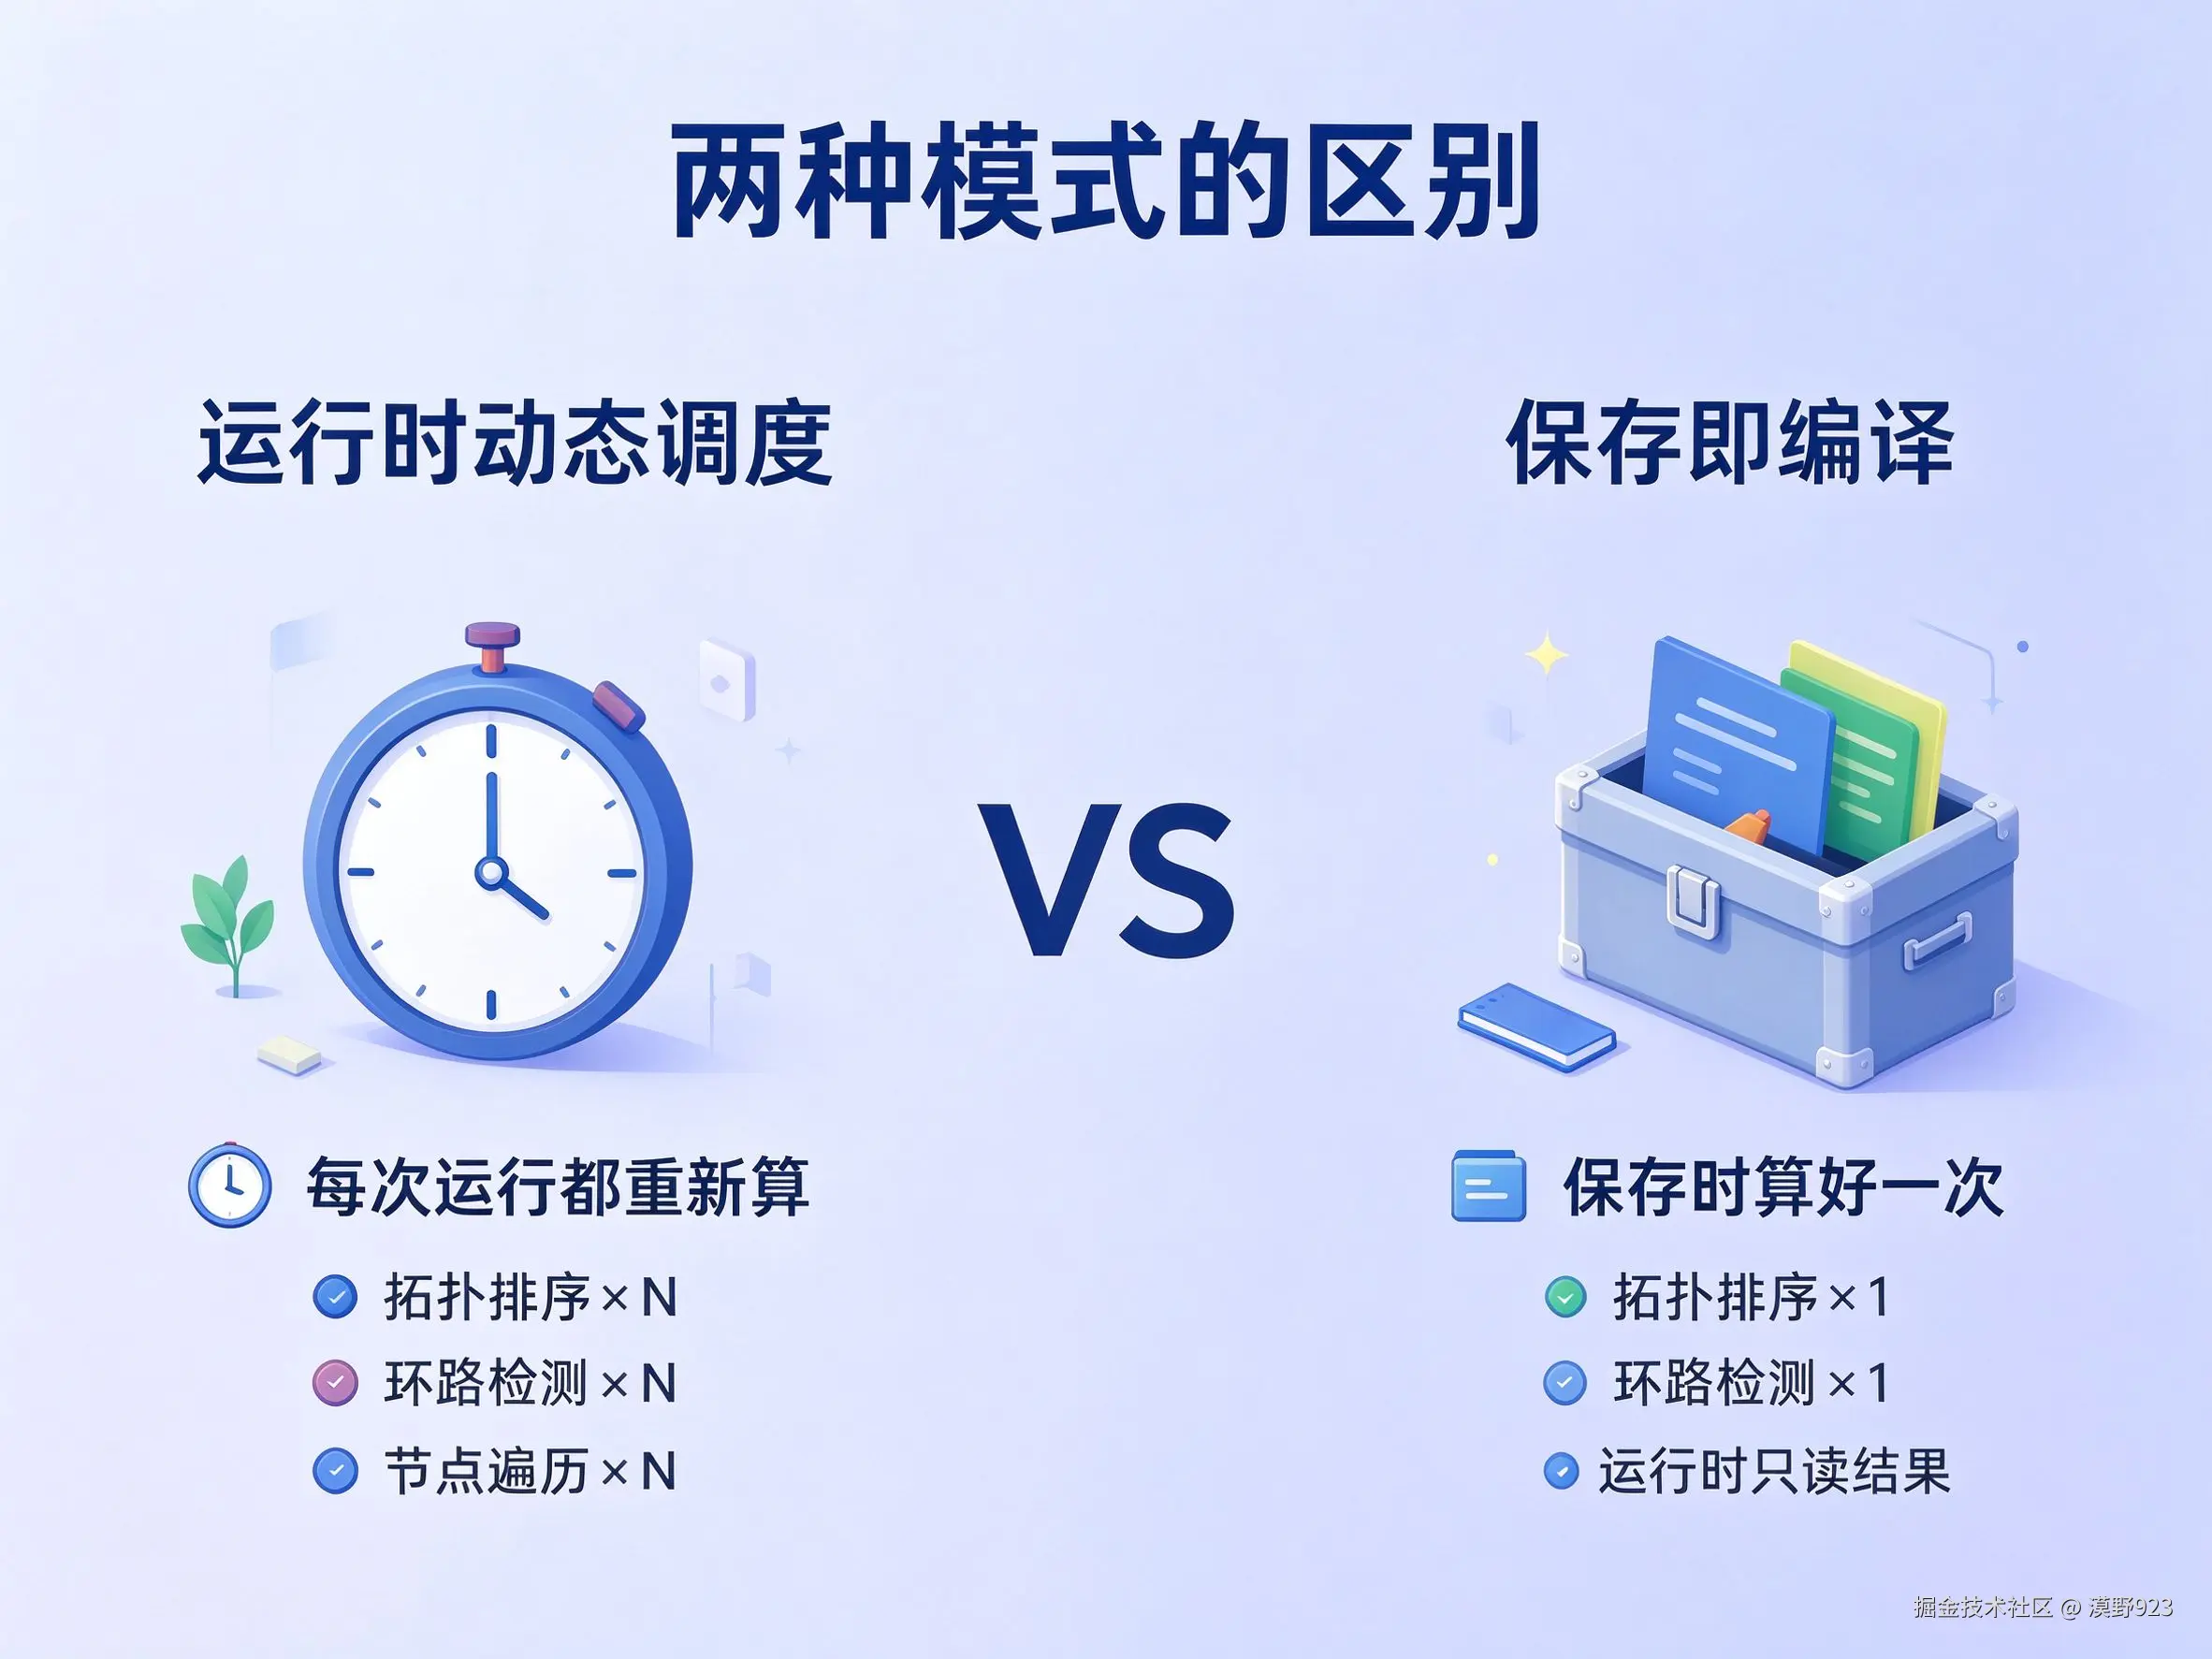
大多数平台的做法是:运行的时候现算。你点"运行",引擎开始工作——先做一遍拓扑排序,找就绪节点,跑起来,跑完了通知下游,然后再找下一批就绪节点……每一次运行,都重新算一遍。
这有什么问题?
第一个问题:重复计算。同一个画布,你跑了十次,拓扑排序就算了十遍。但画布没变的话,排序结果不应该是一样的吗?为什么要算十遍?
第二个问题:错误暴露太晚。你画了一个有环的图,点保存的时候没报错——因为保存的时候没做环路检测。等到你点运行的时候,引擎跑起来了,跑了一半发现"哎,怎么又绕回来了",这时候才报错。但这时候你已经跑了一半了,浪费了资源,排查也麻烦。
第三个问题:运行时压力大。每次运行都要先做一遍拓扑排序、环路检测、节点遍历——这些计算量加起来,虽然单次不大,但架不住高频调用。
我们的做法不一样:点"保存"的时候,就把所有编译工作做完了。
你点保存的那一刻,平台就在后台跑一遍完整的编译流程:
- 拓扑排序,确定执行顺序
- 环路检测,有环直接拒绝保存
- 起终点和孤立节点校验,有问题直接报错
- 连线编译成字段级取值路径,存到数据库
- 版本号自动递增
全部通过了,保存才成功。任何一步有问题,直接告诉你"这里有个环"、"这里有个孤立节点",改完了再保存。
运行的时候呢?运行时只读预计算好的结果——执行顺序已经排好了,节点之间的取值路径也编好了,引擎只要按顺序跑就行。零重复计算。
三、编译期与运行期分离,到底好在哪?
把编译工作放到保存的时候做,听起来只是"提前算了一下",但它带来的好处不止是省计算。
第一个好处:错误提前暴露。
你画了一个有环的图,点保存的时候就告诉你"这里检测到循环依赖"——你当场就改了。不用等到跑了一半才发现,浪费资源,还得排查是哪一步出了问题。
这就像写代码——编译器在你保存的时候就告诉你"这里少了个分号",而不是等你运行的时候才报错。前者是现代编程工具的基本体验,后者是 60 年前的汇编时代。
第二个好处:运行时更轻。
运行的时候,引擎不需要再做任何图结构计算——拓扑排好了,取值路径编好了,它只要按顺序跑节点就行。运行时的逻辑非常纯粹:找就绪节点 → 跑节点 → 标记完成 → 检查下游有没有可以跑的。
这意味着什么?意味着运行时可以做得很薄——甚至可以做成无状态的。你不需要在运行时维护整张图的结构,你只需要知道"这个节点的上游都完成了吗"。
第三个好处:版本管理更干净。
每次保存,版本号递增一次。你保存了几个版本,就有几个编译好的结果。运行的时候选哪个版本,就用哪个编译结果——不需要重新编译。
这就像代码的版本管理——你提交了一次代码,CI 就帮你编译好,存成一个构建产物。运行的时候直接用构建产物,不需要每次运行都重新编译一遍源码。
第四个好处:性能可预测。
因为编译是在保存的时候做的,所以运行时的性能是可预测的——节点执行时间加起来就是总时间,没有额外的编译开销。你做性能调优的时候,不需要考虑"这次运行又花了多少时间在拓扑排序上"。
四、行业里大家都怎么做?
其实"可视化图要做拓扑排序"这件事,行业里大家都在做——Langflow、ComfyUI、RAGFlow、n8n,都是用 Kahn 算法做拓扑排序和环路检测。这不是什么新鲜东西。
但关键差异在于:是保存的时候做,还是运行的时候做?
ComfyUI 的做法是:你提交整个图到队列,服务器验证一遍,然后处理——这是运行时做的。
Langflow 的做法是:图构建好之后,拓扑排序确定执行层——大概率也是运行时做的。
大多数可视化编排平台,都是"运行时动态调度"的模式——每次运行的时候,引擎遍历图,找就绪节点,执行,然后通知下游。
我们的做法是"保存即编译"——保存的时候就把所有静态计算做完,运行时只读结果。
这不是谁比谁好的问题,是设计取向的不同。
运行时动态调度的好处是什么?灵活——你可以在运行的时候动态修改图结构,可以做条件分支、动态加载节点。代价是什么?运行时重,每次都要重新算。
保存即编译的好处是什么?快——运行时零额外计算,性能可预测。代价是什么?不够灵活——图结构在保存的时候就定死了,运行的时候不能改。
那我们为什么选保存即编译?
因为我们的场景是企业级生产运行时。在生产环境里,性能和稳定性比灵活性更重要——你不希望一个高频调用的接口,每次都要先花几十毫秒做拓扑排序。而且生产环境里,图结构一旦上线,就不应该随便改——改了就要重新发布版本。
这就是编译期与运行期分离的意义:把静态的、可以提前算的事情,都放到编译期做;把动态的、每次都不一样的事情,留给运行期。
五、一个朴素的道理
其实这件事说穿了,就是一个程序员很熟悉的道理:编译期和运行期要分离。
写代码的时候,你不会把所有事情都放到运行时做——语法检查、类型推导、常量折叠,这些都是编译器在你保存的时候就做完的。运行的时候,CPU 只管执行机器码,不需要再检查你的代码对不对。
可视化编排也是一样的。画布就是你的"源代码",保存就是"编译"——拓扑排序、环路检测、取值路径编译,这些都是"编译期"的事情。运行的时候,引擎只要执行编译好的结果就行。
这个道理不新鲜,计算机科学里已经讲了几十年了。但在可视化编排这个领域,大多数平台还停留在"跑一步算一步"的阶段——就像写代码不用编译器,直接一行行解释执行。
我们把这个老道理,用到了可视化编排平台上。就这么简单。
六、回到起点
回到开头那个问题:你拖出来的画布,平台是怎么知道先跑哪个、后跑哪个的?
答案是:保存的时候就排好了。
你点"保存"的那一刻,平台在后台做了完整的编译——拓扑排序确定执行顺序、环路检测拒绝死循环、起终点与孤立节点校验、连线编译成字段级取值路径入库。全部通过了,保存才成功。
运行的时候,引擎只读预计算好的结果——按顺序跑节点,跑完一个标记一个,然后检查下游有没有可以跑的。零重复计算,错误提前暴露,性能可预测。
这就是"保存即编译"——把编译器的老道理,用到可视化编排上。
如果你也在做一个可视化编排平台,不妨问自己一个问题:你的拓扑排序,是保存的时候做,还是每次运行的时候再算一遍? 如果答案是后者,那你可能正在重复造轮子——而且造的是 60 年前的轮子。
这篇文章讲的是我们在策熔平台上做可视化编排时的一个工程决策——保存即编译,编译期与运行期分离。如果你也在搭类似的系统,欢迎在评论区聊聊你的做法。