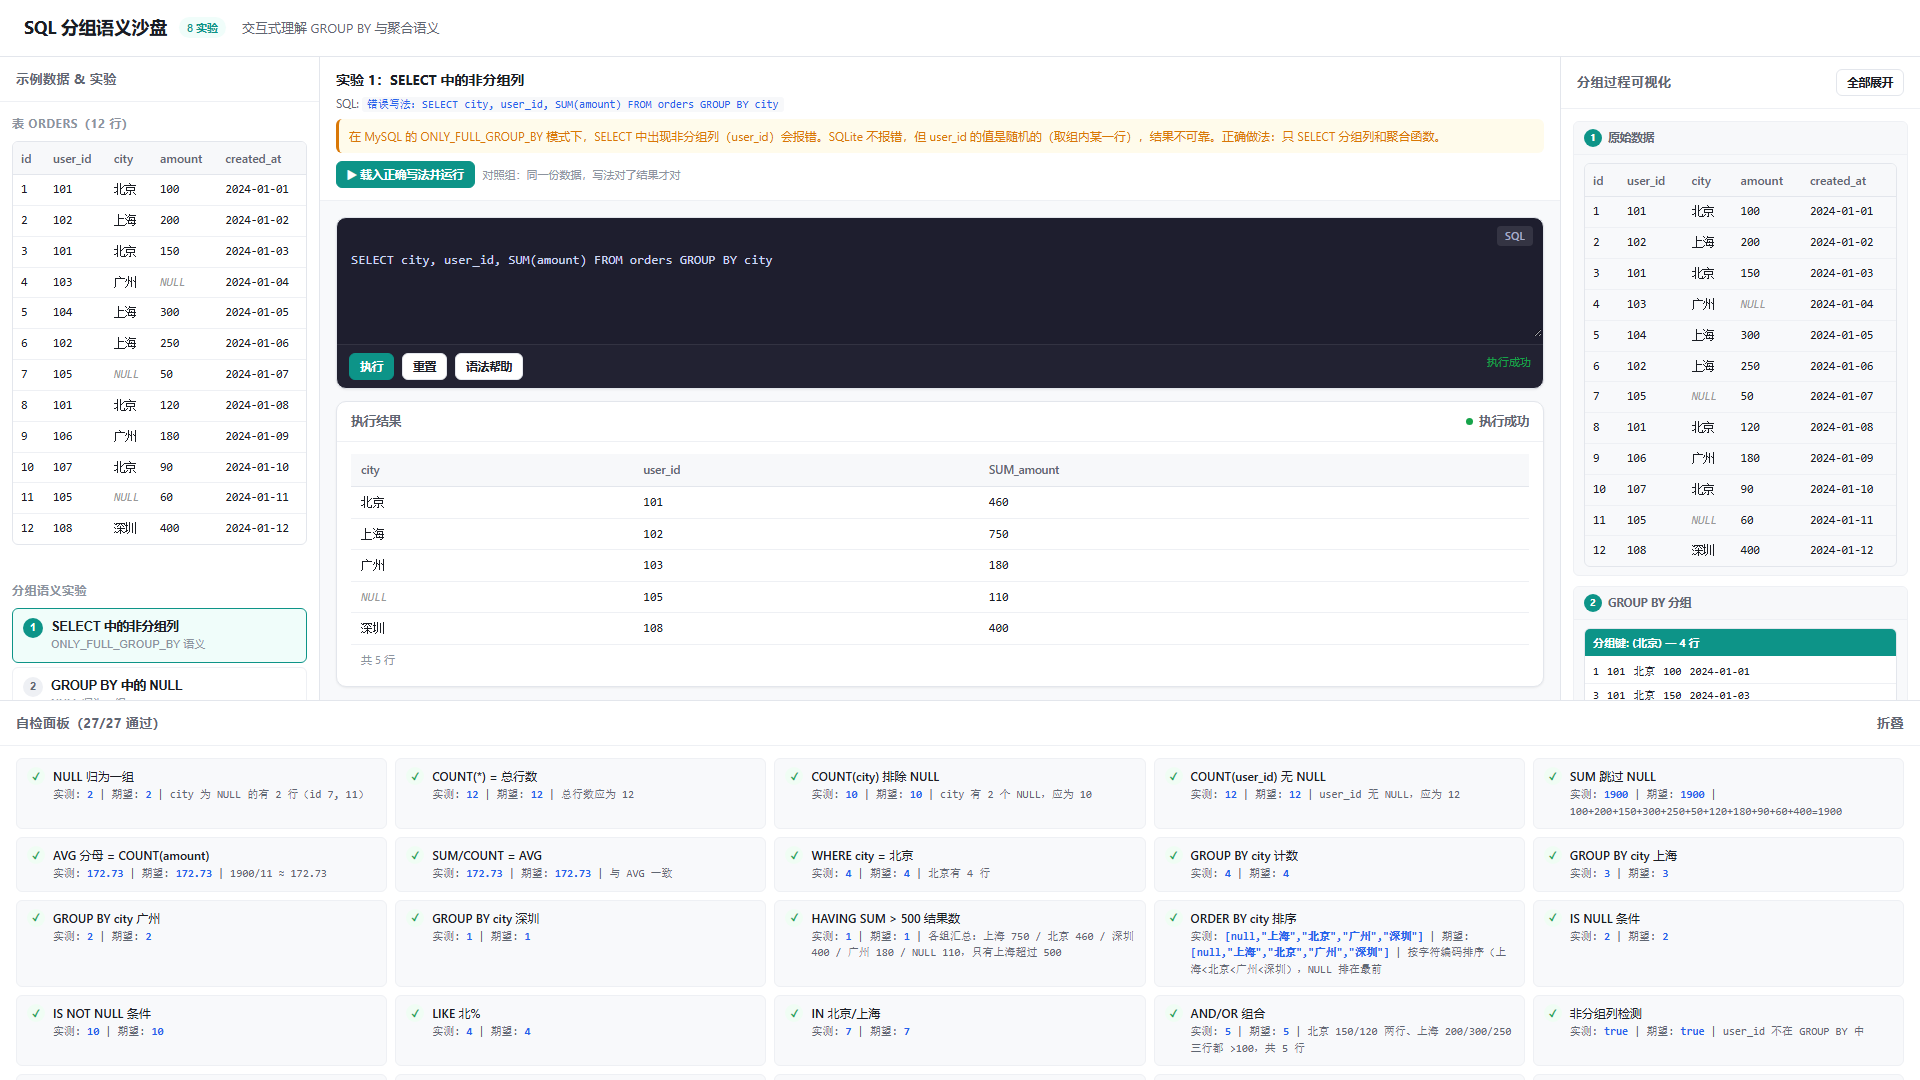
同一句 SELECT city, COUNT(*) FROM orders GROUP BY city,在 MySQL、SQLite 和大多数人的直觉里,可以给出三个不一样的答案。
分歧点只有三个:NULL 怎么归组、COUNT 数的是什么、AVG 除以谁。
这些规则你大概都背过,我也没有例外。区别是我这次把它们做成了一个能点的沙盘,再一条条对了一遍,结果发现自己记的那几处里,有两处是错的。
沙盘里只有 12 行订单数据,8 个分组语义实验,一句 SQL 进去、一行结果出来。
右栏会把执行过程摊开:原始数据、WHERE 过滤、GROUP BY 分组、聚合计算、HAVING 过滤、ORDER BY 排序。
每一步都能点开,看哪些行被留下、哪些被丢掉、哪些值被跳过。底部挂着 27 条自检断言,每条都带实测值和期望值,打开就是全绿。
我把 8 个实验挨个点了一遍,又把 27 条断言逐条对着 12 行数据算了一遍,翻出 14 处真缺陷,其中 3 条断言自己就是错的。
| 指标 | 实测值 | 是怎么算出来的 |
|---|---|---|
COUNT(*) | 12 | 12 行全算,不看 NULL |
COUNT(city) | 10 | city 有两个 NULL,被跳过 |
COUNT(amount) | 11 | amount 有一个 NULL,被跳过 |
SUM(amount) | 1900 | 11 个非 NULL 金额相加 |
AVG(amount) | 172.727 | 1900 ÷ 11,分母不是 12 |
SUM(amount) / COUNT(*) | 158.333 | 分母写错的对照组,差了 14 |
COUNT(DISTINCT city) | 4 | 去重后 4 个城市,NULL 一个不算 |
COUNT(DISTINCT 城市拼接用户) | 7 | 拼接去重后 7 个组合,NULL 拼接仍是 NULL |
| 自检断言 | 27 / 27 通过 | 全部渲染在页面底部 |
| 8 个实验 | 8 / 8 跑通 | 含报错路径与正确写法对照 |
公开仓库:atomgit.com/deli007/dem…;本案例目录:atomgit.com/deli007/dem…。
成品是一个 index.html,双击就能跑,不联网、不引第三方库、没有构建步骤。
边界也交代一句:这是个教学沙盘,不是 SQL 编辑器,也不是数据库。
它只认 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY,而且只有一张写死的 orders 表。
JOIN、子查询、窗口函数都不在范围里。实验 6 讲的「每组最新一行」正好需要 JOIN,我只能把正确写法当只读对照贴在页面上,不让它跑。
为什么值得看:这三条规则决定了报表数字对不对
分组在业务里出现得太频繁了:日报按城市汇总、月报按用户去重、漏斗按天分桶。
写错的地方很少在语法上,语法错了数据库会直接报错。真正坑人的是能跑通、不报错、数字却偏了的那一种。
COUNT(city) 比 COUNT(*) 少 2,报表上看起来像「有两单没填城市」,其实是我选错了列。
AVG(amount) 的分母少算一行,平均值就偏高一点,而且没有任何提示。
这 12 行数据是我特意留白的:两个城市为空,一个金额为空。位置就摆在那里,谁都能一眼看到。
我把这两个 NULL 的位置先标在纸上,再去对每一条断言——凡是涉及 NULL 的,都单独手算一遍再和页面对。
一、先看结果:NULL 自己凑成一组
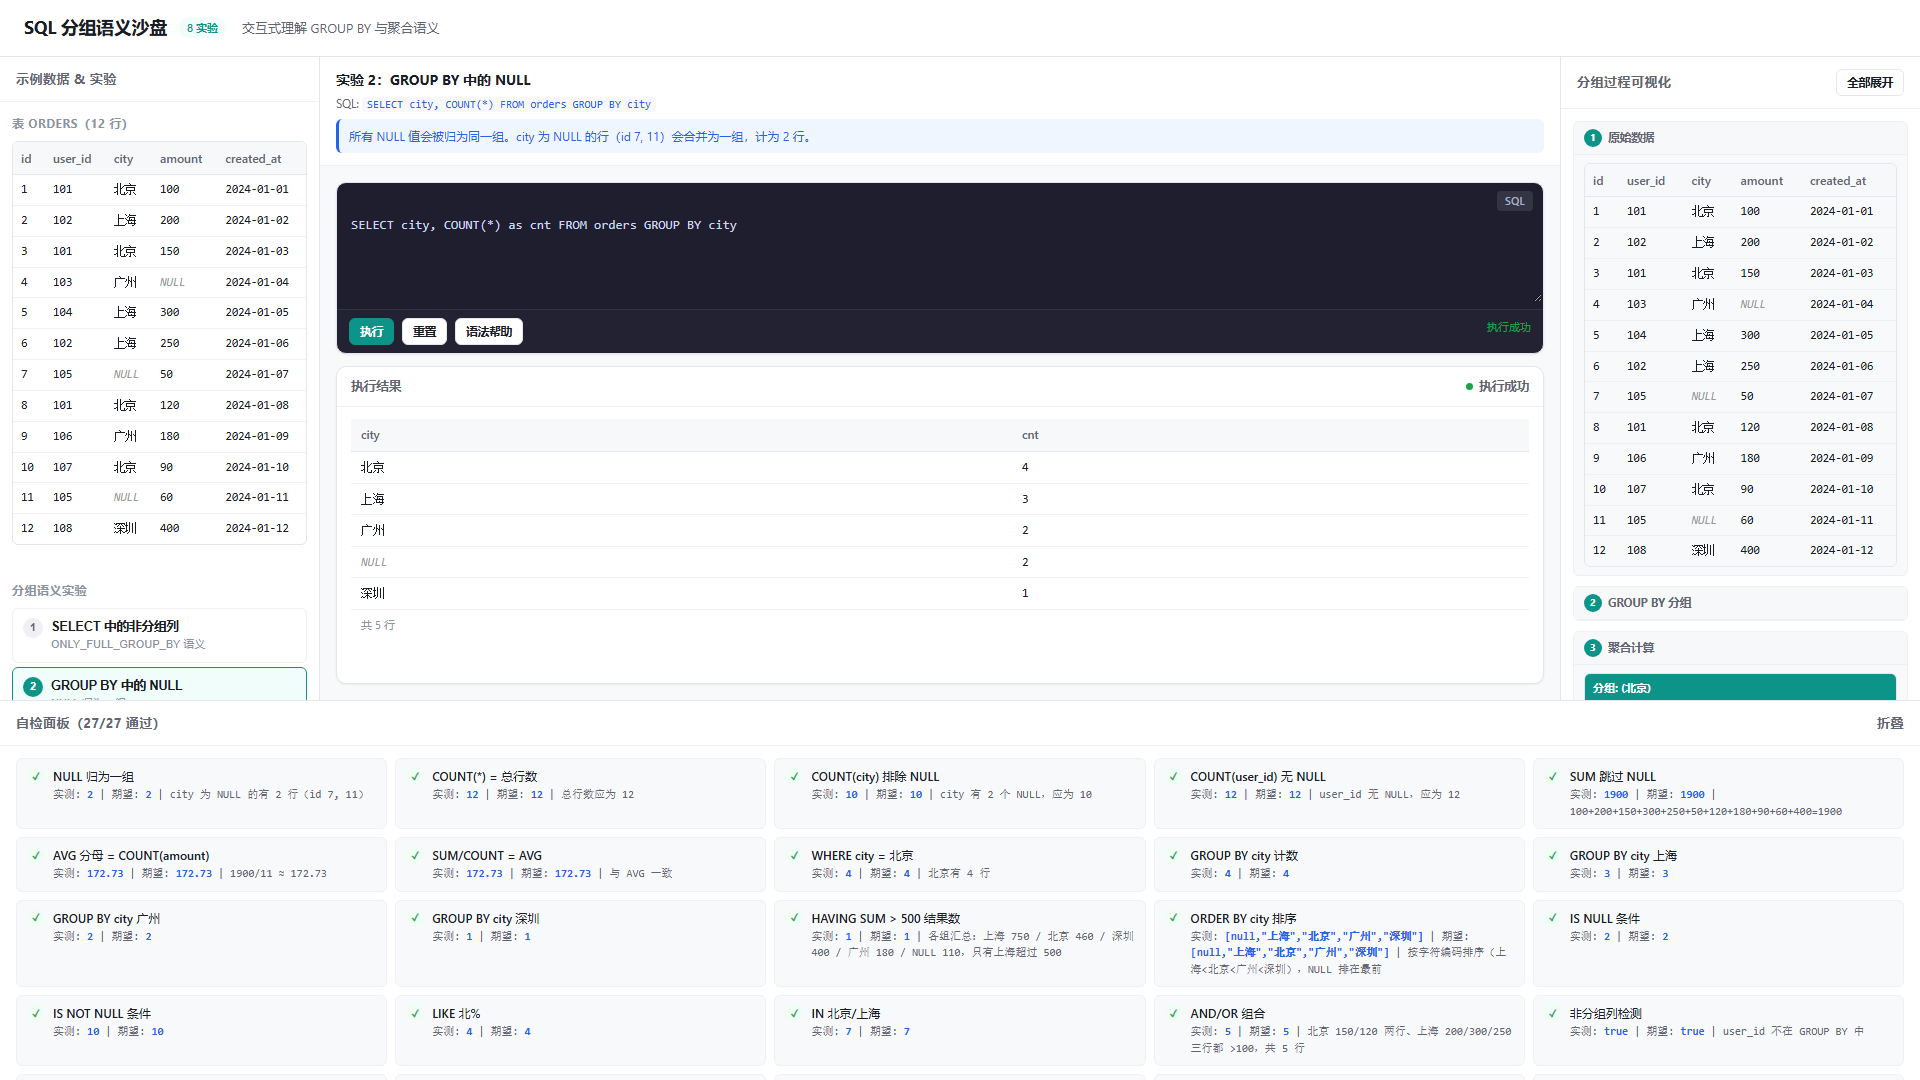
北京 4、上海 3、广州 2、NULL 2、深圳 1,五组加起来 12,行数对得上。
容易想反的是 NULL 那一组。既然 NULL = NULL 在 SQL 里不成立,那两行空城市的订单看起来应该各成一组。
实际不是。GROUP BY 把所有 NULL 当成同一个值,归进同一组,所以这里是 5 组、不是 6 组。
我一开始也是按 6 组去数的,直到右栏把「分组键: (NULL) — 2 行」打在我眼前。
这个行为不是 SQLite 的癖好,MySQL、PostgreSQL、Oracle 都一样:分组的时候 NULL 彼此相等,比较的时候 NULL 彼此不等。
二、四个想当然:COUNT 数什么,AVG 除以谁
COUNT(*) 数是行数,COUNT(列) 数的是非 NULL 值的个数。 同一张表,COUNT(*) 是 12、COUNT(city) 是 10、COUNT(amount) 是 11。三个数字三个含义,写哪个都有它的道理,写错的那个不会报错。
AVG 的分母是 COUNT(列)。 AVG(amount) 等于 1900 除以 11,得 172.727。它不会把空值当 0 补偿,少的那一行直接不进分母,所以平均值比你按 12 行算的高。
我把 SUM(amount)/COUNT(amount) 和 AVG(amount) 并排跑了一遍,两个数一模一样,都是 172.727。
分母换成 COUNT(*) 才得到 158.333,差了 14 块。
COUNT(DISTINCT 列) 不数 NULL。 城市去重后是 4 个,不是 5 个。很多人以为 DISTINCT 会把 NULL 当成一个特殊值留下来,实际上 COUNT 这一层先把 NULL 滤掉了。
拼接表达式里的 NULL 会一路传下去。 city || user_id 把城市和用户拼起来去重后是 7 个组合;城市为空的那两行拼出来还是 NULL,直接被跳过。
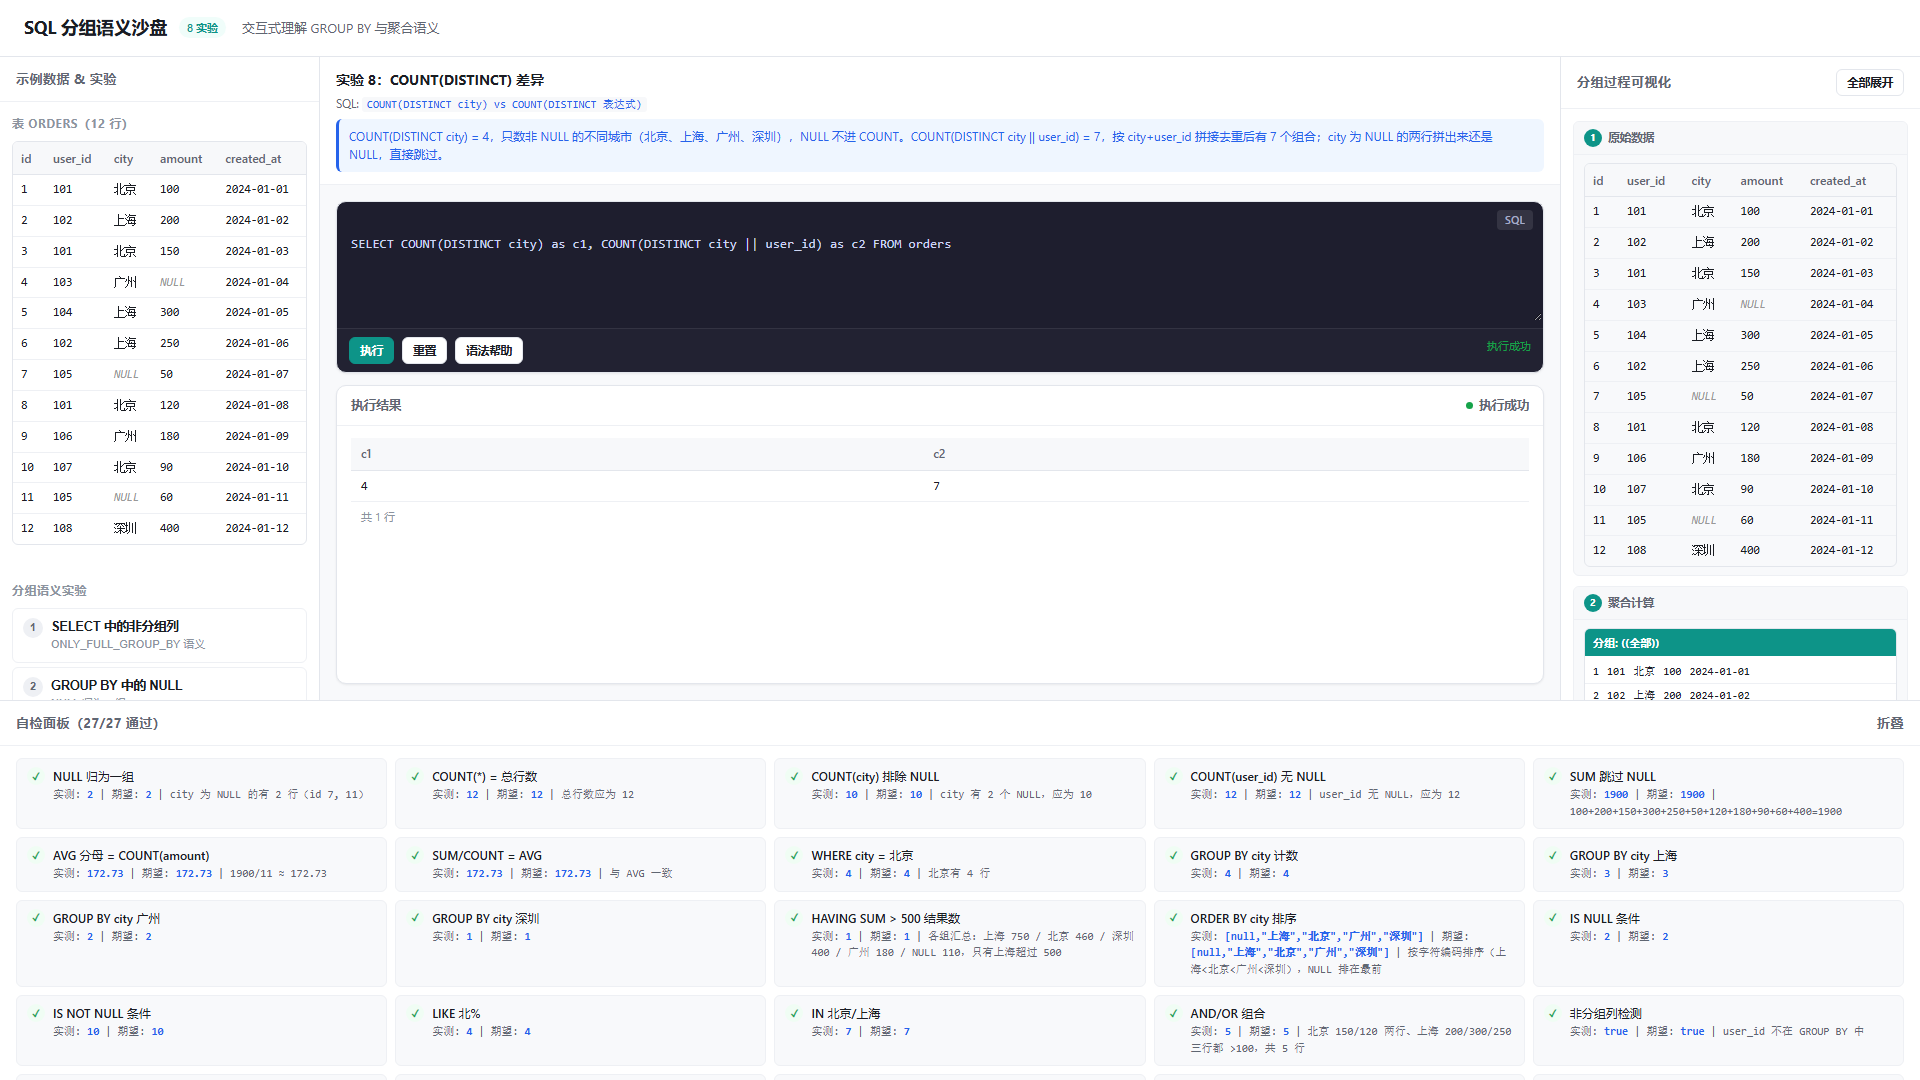
四个坑里有三个的后果是一样的:数字偏小或者偏大,但页面不告诉你。
三、WHERE 和 HAVING 的分界线
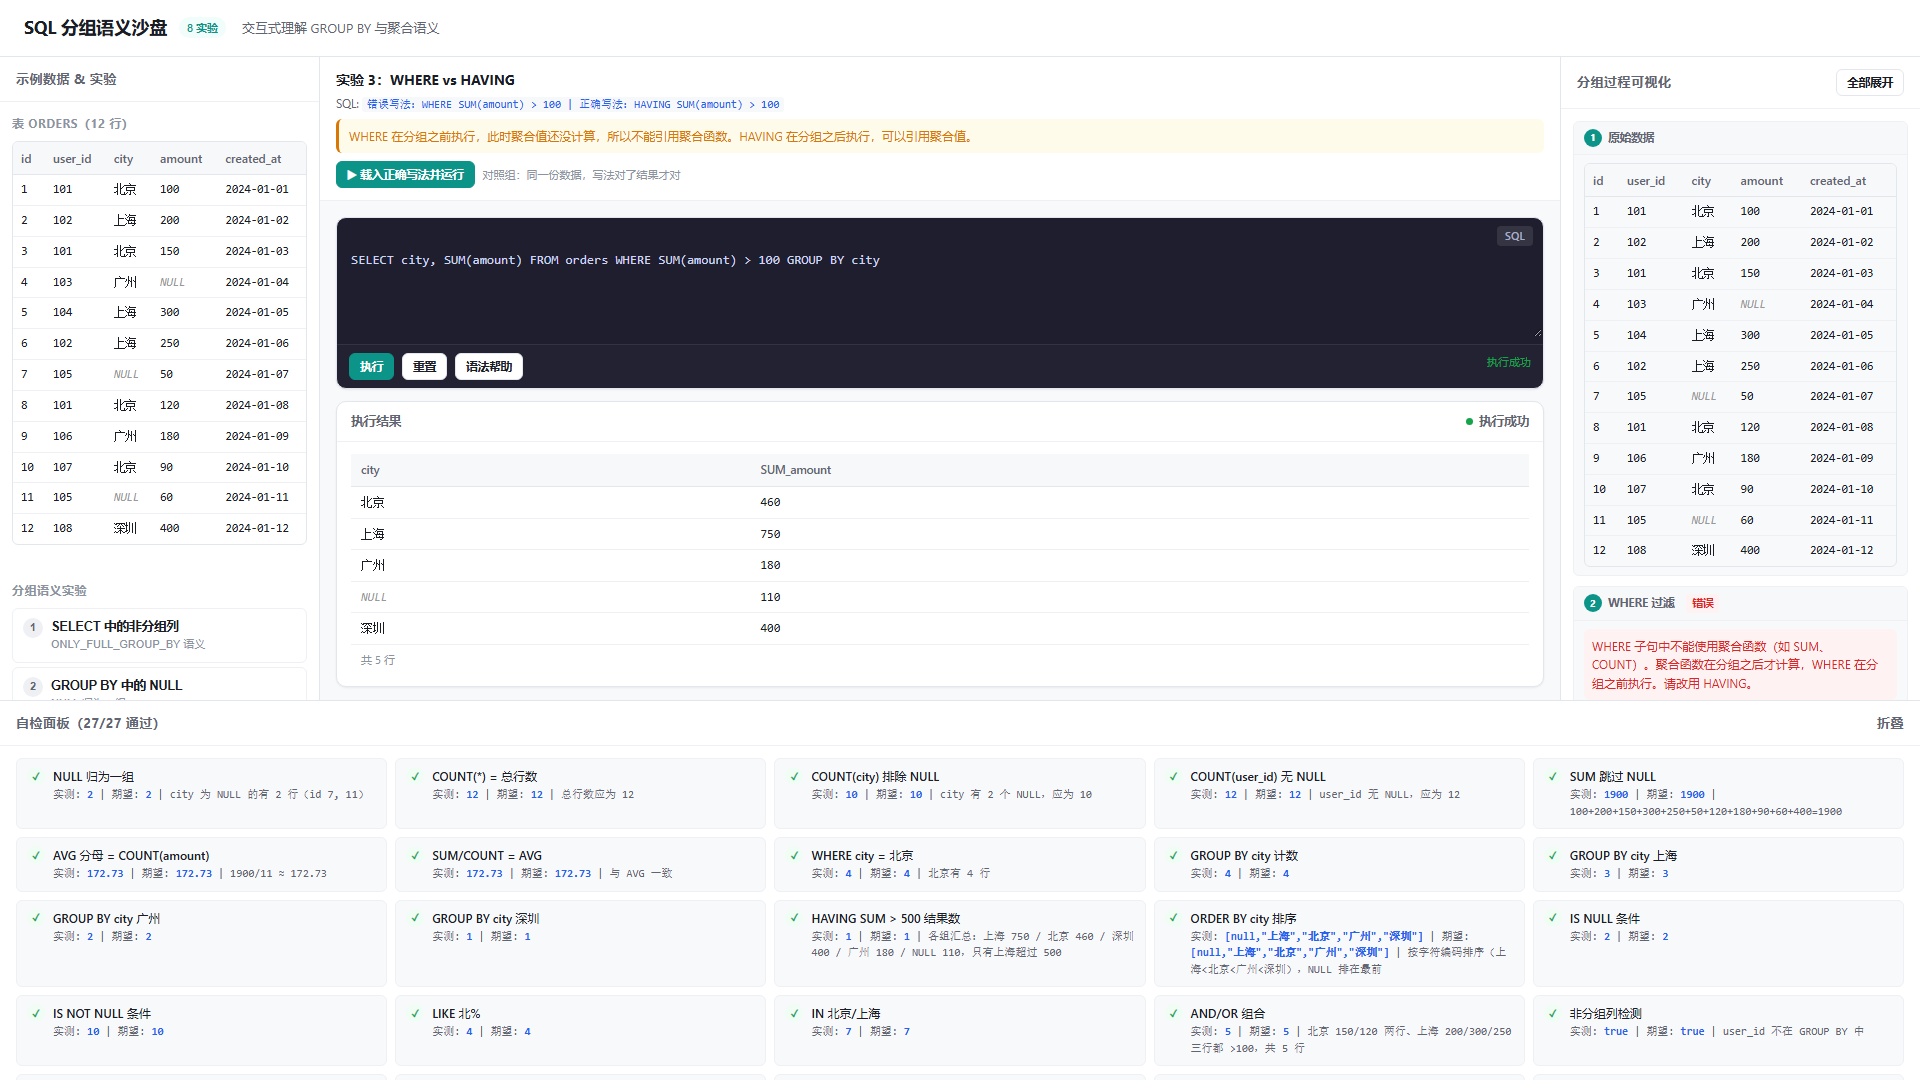
实验 3 故意把聚合函数写进 WHERE:SELECT city, SUM(amount) FROM orders WHERE SUM(amount) > 100 GROUP BY city。
沙盘不装作能跑。它在执行过程里把这一步标成错误,并给出提示原文:
WHERE 子句中不能使用聚合函数(如 SUM、COUNT)。聚合函数在分组之后才计算,WHERE 在分组之前执行。请改用 HAVING。
点实验说明区的「载入正确写法并运行」,同一份数据换成 HAVING SUM(amount) > 100,五组全部通过。
最小的一组是 NULL 组,合计 110,也在 100 之上。
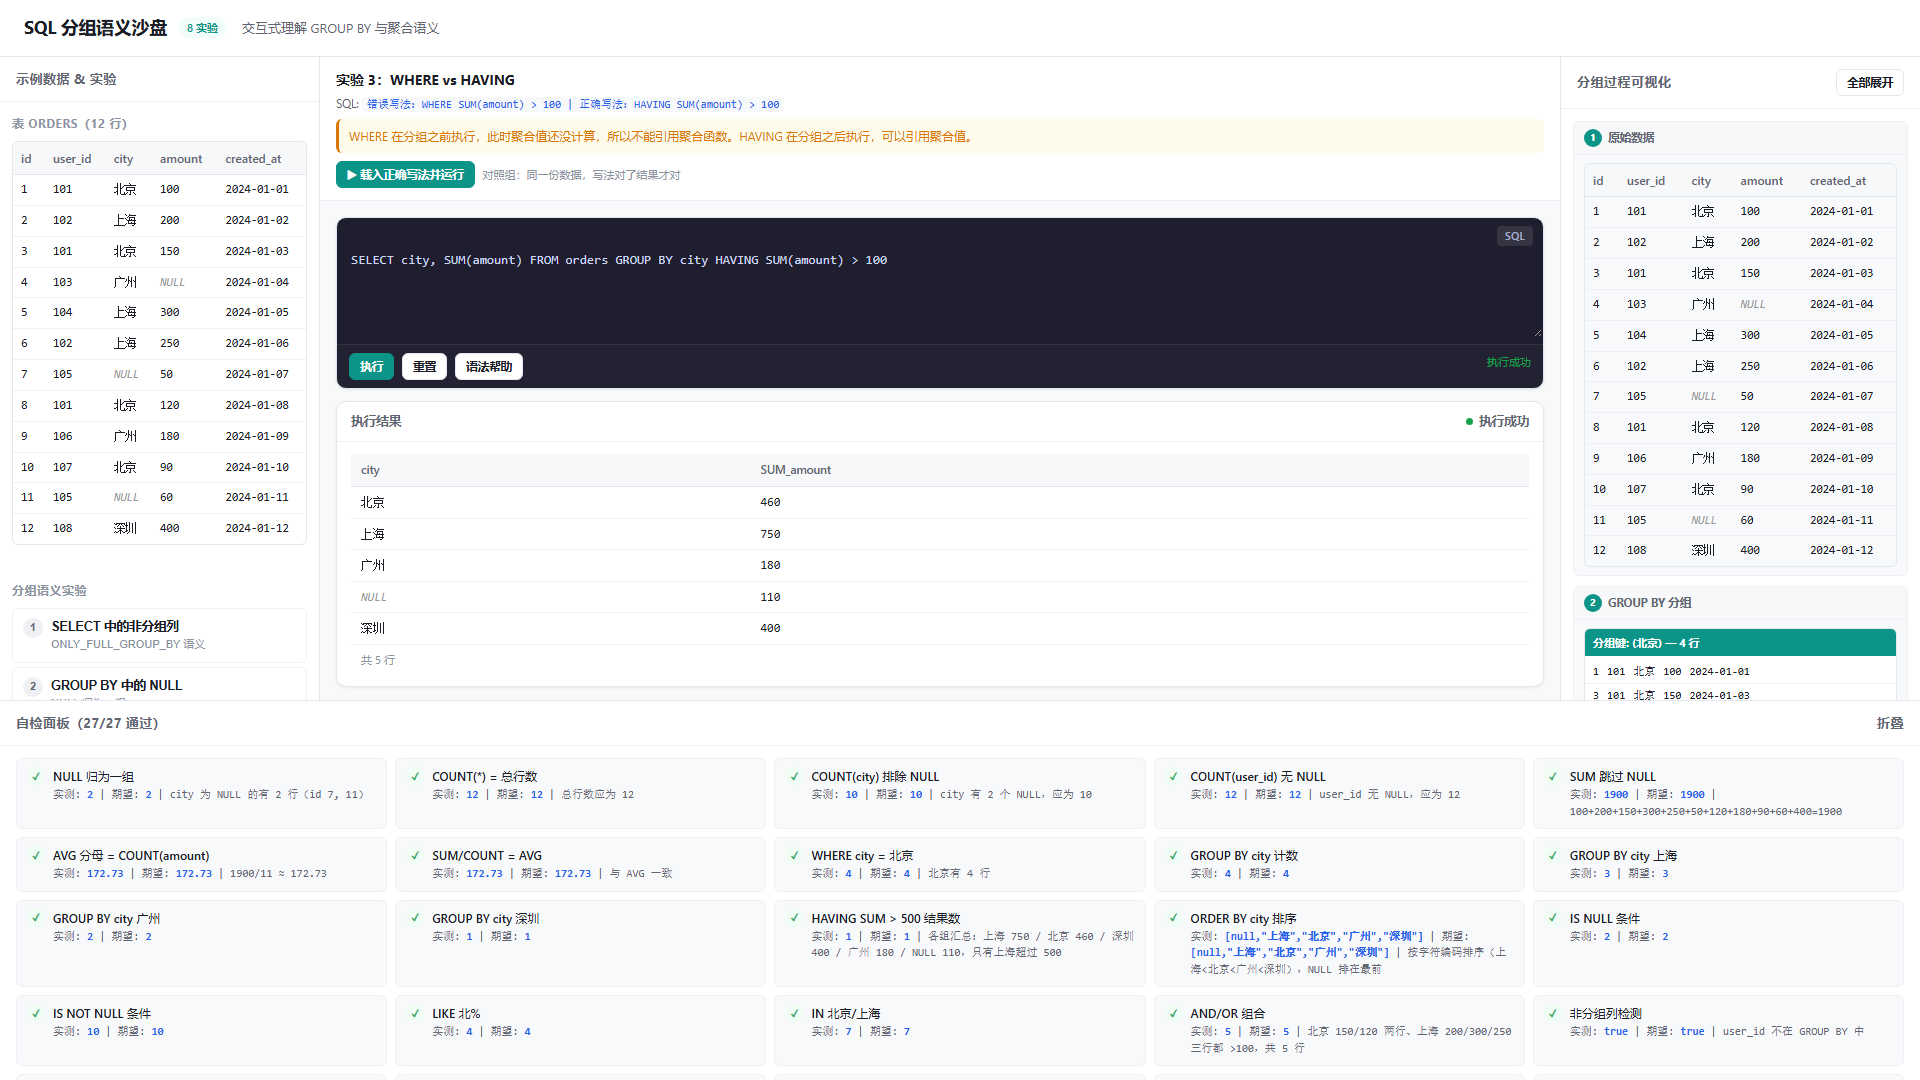
一句话记住:WHERE 过滤的是行,HAVING 过滤的是组。
位置写错,MySQL 会直接报错;SQLite 有时会给出一个含糊的答案,看起来像能跑。
我把两种写法并排跑了一遍,同一份 12 行数据、同一句聚合,位置一换,从报错变成 5 组。
四、交付之后我改了十四处
页面刚拿到手的时候,底部自检面板是一条都不显示的。不是面板写坏了,是自检跑到第 7 条抛了异常,后面的渲染全都没执行。
我把页面在本机打开,把每条断言、每个实验的 SQL 单独喂给引擎跑了一遍,一共拽出 14 处问题。
| # | 现象 | 根因 | 改法 |
|---|---|---|---|
| 1 | 实验 8 的拼接去重一句报「语法错误:期望 ),在位置 13」,一点就红 | 聚合函数的参数只按「单个列名」解析,拼接和算术没有对应的语法分支 | 新增 parseValueExpr(),聚合参数支持完整的拼接与算术链 |
| 2 | SUM(amount)/COUNT(amount) 报「语法错误:缺少 FROM 子句」 | SELECT 表达式只认列名和聚合函数,除号之后的内容被当成多余字符 | 抽出 parseBinaryTail(),SELECT 里支持加减乘除取模 |
| 3 | HAVING SUM(amount) > 500 直接语法错,实验 1 的对照写法跑不了 | 条件解析只认「列名开头」,聚合函数开头的条件走不进任何分支 | 在条件解析最前面加聚合函数分支 |
| 4 | WHERE 里写聚合函数只会抛异常,永远拿不到「请改用 HAVING」的提示 | 上一处缺口拦在解析阶段,页面里那段提示代码成了死代码 | 同上,解析通了以后提示才真正生效 |
| 5 | WHERE (city = '北京' OR city = '上海') AND amount > 100 报「期望条件表达式」 | 括号被词法器标成标点,解析器有两处却按运算符判断,括号分支从来没被执行过 | 两处判断改成看符号本身,不看类型 |
| 6 | SELECT amount * 2 as d ... 返回 4 个空对象 | 不带聚合、不带 GROUP BY 的结果构建只处理星号、列名和别名,计算列没有落点 | 三条结果构建路径都补上二元表达式分支 |
| 7 | COUNT(DISTINCT city) 得到 10,不是 4 | DISTINCT 解析出来了,标记却被丢掉,去重从未生效 | 在聚合求值里实现去重取值,五个聚合函数都走 |
| 8 | ORDER BY city 把 NULL 排在最后 | 比较函数把 NULL 当成了最大值 | 改成 NULL 最小、排在最前,与 SQLite、MySQL 一致 |
| 9 | 断言「HAVING 大于 500 得到 3 组」永远是红的 | 数据里只有上海的 750 超过 500,北京 460、深圳 400、广州 180、NULL 组 110 都不够 | 期望值改成 1,并把五组汇总写进断言说明 |
| 10 | 断言「ORDER BY city 得到 北京、上海、深圳、广州、NULL」永远是红的 | 期望值按拼音写的,而 SQLite 的 BINARY 排序按字符编码:上海、北京、广州、深圳 | 期望值改成编码顺序,NULL 在最前 |
| 11 | 断言「AND/OR 组合得到 4 行」永远是红的 | 北京 150 和 120、上海 200 和 300 和 250,五行都大于 100,实际是 5 行 | 期望值改成 5 |
| 12 | 实验 8 的说明写「COUNT(DISTINCT city) 是 5、拼接后是 10」 | 把 NULL 也算进了去重结果,拼接那一项是估的 | 改成 4 和 7,并写清 NULL 不进 COUNT |
| 13 | 右栏「分组过程可视化」步骤一多,就只剩编号和标题,正文被切掉 | 右栏是纵向弹性容器,步骤块自带内容裁剪,一旦被压缩正文就没了 | 给步骤块加上不收缩,超出部分交给容器滚动 |
| 14 | 实验 1、3、6 都写了「正确写法」,页面上却找不到它 | 这段数据定义了却没有任何地方渲染 | 实验说明区加「载入正确写法并运行」按钮,跑不了的那条改成只读对照 |
前 8 处是引擎的真缺陷,后 6 处是断言和说明里的错。后 6 处有一条规律:凡是「永远红」的断言,多半不是引擎坏了,是写的时候没对着数据算。
第 5 处最值得记一笔。它的表现是「括号里的条件不被认识」,但代码看起来完全正常。
括号分支写在那儿,判断也在那儿,只是比较的是 token 类型,而词法器给括号贴的是另一个类型。
这种死代码不报错、不告警,只有真正把 (city = '北京' OR city = '上海') AND amount > 100 跑一遍才会露出来。
我单独把这条喂进去之前,压根没想到括号是不可用的。
修完之后:27 条断言全绿,8 个实验全部跑通,node --check 也没报错。
五、本地怎么复现
仓库里就一个文件,浏览器直接打开即可;也可以起一个本地静态服务:
git clone https://atomgit.com/deli007/demo_park.git
cd demo_park/codearts-sql-groupby-lab
python -m http.server 8080
# 浏览器打开 http://localhost:8080/index.html
页面一加载就会跑一次自检,底部打出 27/27 全绿。点实验 3 的「载入正确写法并运行」,结果表会给出 5 行,右栏多出 HAVING 那一步。
想复现第 5 处的话,把括号分支的判断改回只认运算符类型,(city = '北京' OR city = '上海') AND amount > 100 会立刻报「期望条件表达式」。
失败路径也留了一条:实验 3 的错误写法不会白屏、不会给假结果,而是在执行过程里标红并给出中文提示原文,结果表照常展示数据。
这些数字都是我把页面在本机重新跑出来的,不是抄交付说明。
六、准备环境:进入码道 Web 版
这个页面是用码道做的。码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source… ,登录后就能在对话窗口输入需求,不需要装软件。
我的需求是一条消息说全的:单一 index.html、内置 12 行 orders 表且要有空值、8 个分组语义实验、一句 SQL 进去要能看到分组过程、底部渲染 27 条带实测值的自检断言、聚合函数写错位置要给中文提示且不许白屏、不引第三方库不联网。
末尾照例加一句「完成后打开预览,让我直接看到运行效果」,这一句能省掉一轮来回。
七、使用码道 Web 的体会
- 自检要一次性写进需求,而且要求它渲染到页面上。 这次 27 条断言里有 6 条是错的、3 条永远不可能通过;没有这块面板,这些错会一路带到读者手里。
- 「不许白屏、不许 NaN」这类约束要当需求写。 我每次都加,加了才有失败路径可看。
- 交付物必须自己重跑一遍。 自检面板一条都不显示这个现象,光读代码看不出来:函数在、调用也在,只是执行到第 7 条抛了异常。
- 把每条 SQL 单独喂给引擎,比读代码有效。 14 处里有一半属于「读起来没问题、跑起来不对」,只有把条件表达式单独跑一遍才会现形。
- 断言写错比引擎写错更常见。 三条永远红的断言,追根到底都是没对着数据算。数字先手算一遍,再交给页面去断言。
- 别把「它能跑」当成「它对」。 括号表达式在修之前是直接报错的,报错至少看得见;真正危险的是
COUNT(DISTINCT)那种悄悄返回 10 的。
说完不足
- 沙盘只支持一张写死的
orders表,列名和行数都不能改。它用来讲语义,不是用来查数据的。 - 引擎是给教学写的小解析器,不支持 JOIN、子查询、窗口函数,也不支持多表。实验 6 只能贴只读的正确写法。
- 聚合函数只有 COUNT、SUM、AVG、MIN、MAX 五个,没有 GROUP_CONCAT,也没有中位数。
- 排序用的是字符编码顺序,和 SQLite 的 BINARY 一致;中文不是拼音序,上海排在北京前面。要拼音序得自己在业务层处理。
- 页面里的自检断言只覆盖我列出的那些语义点,不等于全量 SQL 语义测试。换一套数据,断言里的期望值就会不对。