一、第一个被抓出来的 bug,单元测试是绿的
2026 年 7 月 14 日,我让 AI 第一次扫描自己的代码库。它标出的第一个高优先级问题,代码是这样:
# dca-engine.py 第 80 行
def get_regime_multiplier(regime: str) -> float:
    return {"normal": 1.0, "attention": 1.0, "warning": 1.5,
            "severe": 2.0, "extreme": 2.0}.get(regime, 1.0)
它自己的设计文档里写的是:
normal ×1.0 cautious ×0.8 warning ×0.6 severe ×0.4 extreme ×0.2
方向反了。设计意图是"市场越差投得越少",代码实现是"市场越差投得越多"。基础预算 6000 元,在市场进入最差那一档时会变成 10000 元。
麻烦的不是它错了,而是它错得非常安静:不抛异常、不打错误日志、单元测试全绿、每天输出的建议格式完美。它就是那么勤勤恳恳地,建议我在市场最差的时候多买一点。
我盯着这段代码看了一会儿,意识到一件事:靠"换个更强的模型"或者"把提示词写得更仔细",永远解决不了这类问题。问题不是它不够聪明,是我没有任何机制替我确认它做对了。
那天之后我给自己搭了一套东西:跑在晚上、无人值守的「自动发现问题 + 自动处置问题」闭环。截至 2026-10-07,它跑了 85 天,经手了 90 个真实问题。
这篇讲它长什么样。结论我先放前面:这类系统的难点从来不在"发现",也不在"动手改",而在"凭什么信它处置对了"。
二、这是什么系统?
不是演示项目。它是我自己的个人投资辅助系统——跑在我的一台笔记本上,由 cron 定时驱动,每天真实地读行情、算决策、发推送。它和我的工作无关,是业余时间搭的。
它做的事很窄:判断市场处在哪一档状态,按预算生成"这个月买什么、买多少"的建议,再每天跑一次风险扫描推到我手机上。
它不接券商、不自动交易。系统里有一处硬编码开关 brokerAutomationAuthorized = false,所有输出都只是建议——下单和资金划转,永远是我自己在券商 App 里点。
规模:55 个脚本、约 11,800 行代码、30 个测试文件,全在一个仓库里,我一个人写、一个人改。
因为代码是我一个人写的,而问题不会因为我没有时间就停止产生。数据源悄悄改了字段、某处逻辑改完忘了同步另一处、交易日历和时区这类外部假设某天突然不成立——它们有两个共同点:大多不报错,而发现它们需要精力和时间,恰恰是我最缺的两样。
三、两条主线:发现与处置
整套系统只有两条主线:
- 发现侧:扫描自己的代码与数据,把可疑之处变成问题池里的一条记录;
- 处置侧:把池子里"已被确认"的问题按风险分级解决掉,并留下能被独立复核的证据。
两条主线中间夹着一道人工闸门:新发现的问题默认只进池子、只做分析,处置权不在模型手里。整个设计的重心,其实都在这道闸门和它后面那套验证机制上。
本文后面会把系统里那类只读的机器校验统称为门禁:一段代码,不通过就禁止后续动作,跟"某人觉得可以"无关。
① 扫描发现 → ② 分诊 → ③ 排期 → ④ 执行 → ⑤ 验证 → ⑥ 归档 → ⑦ 写回扫描规则
      └──────────────────── 回到 ① 的规则库 ────────────────────┘
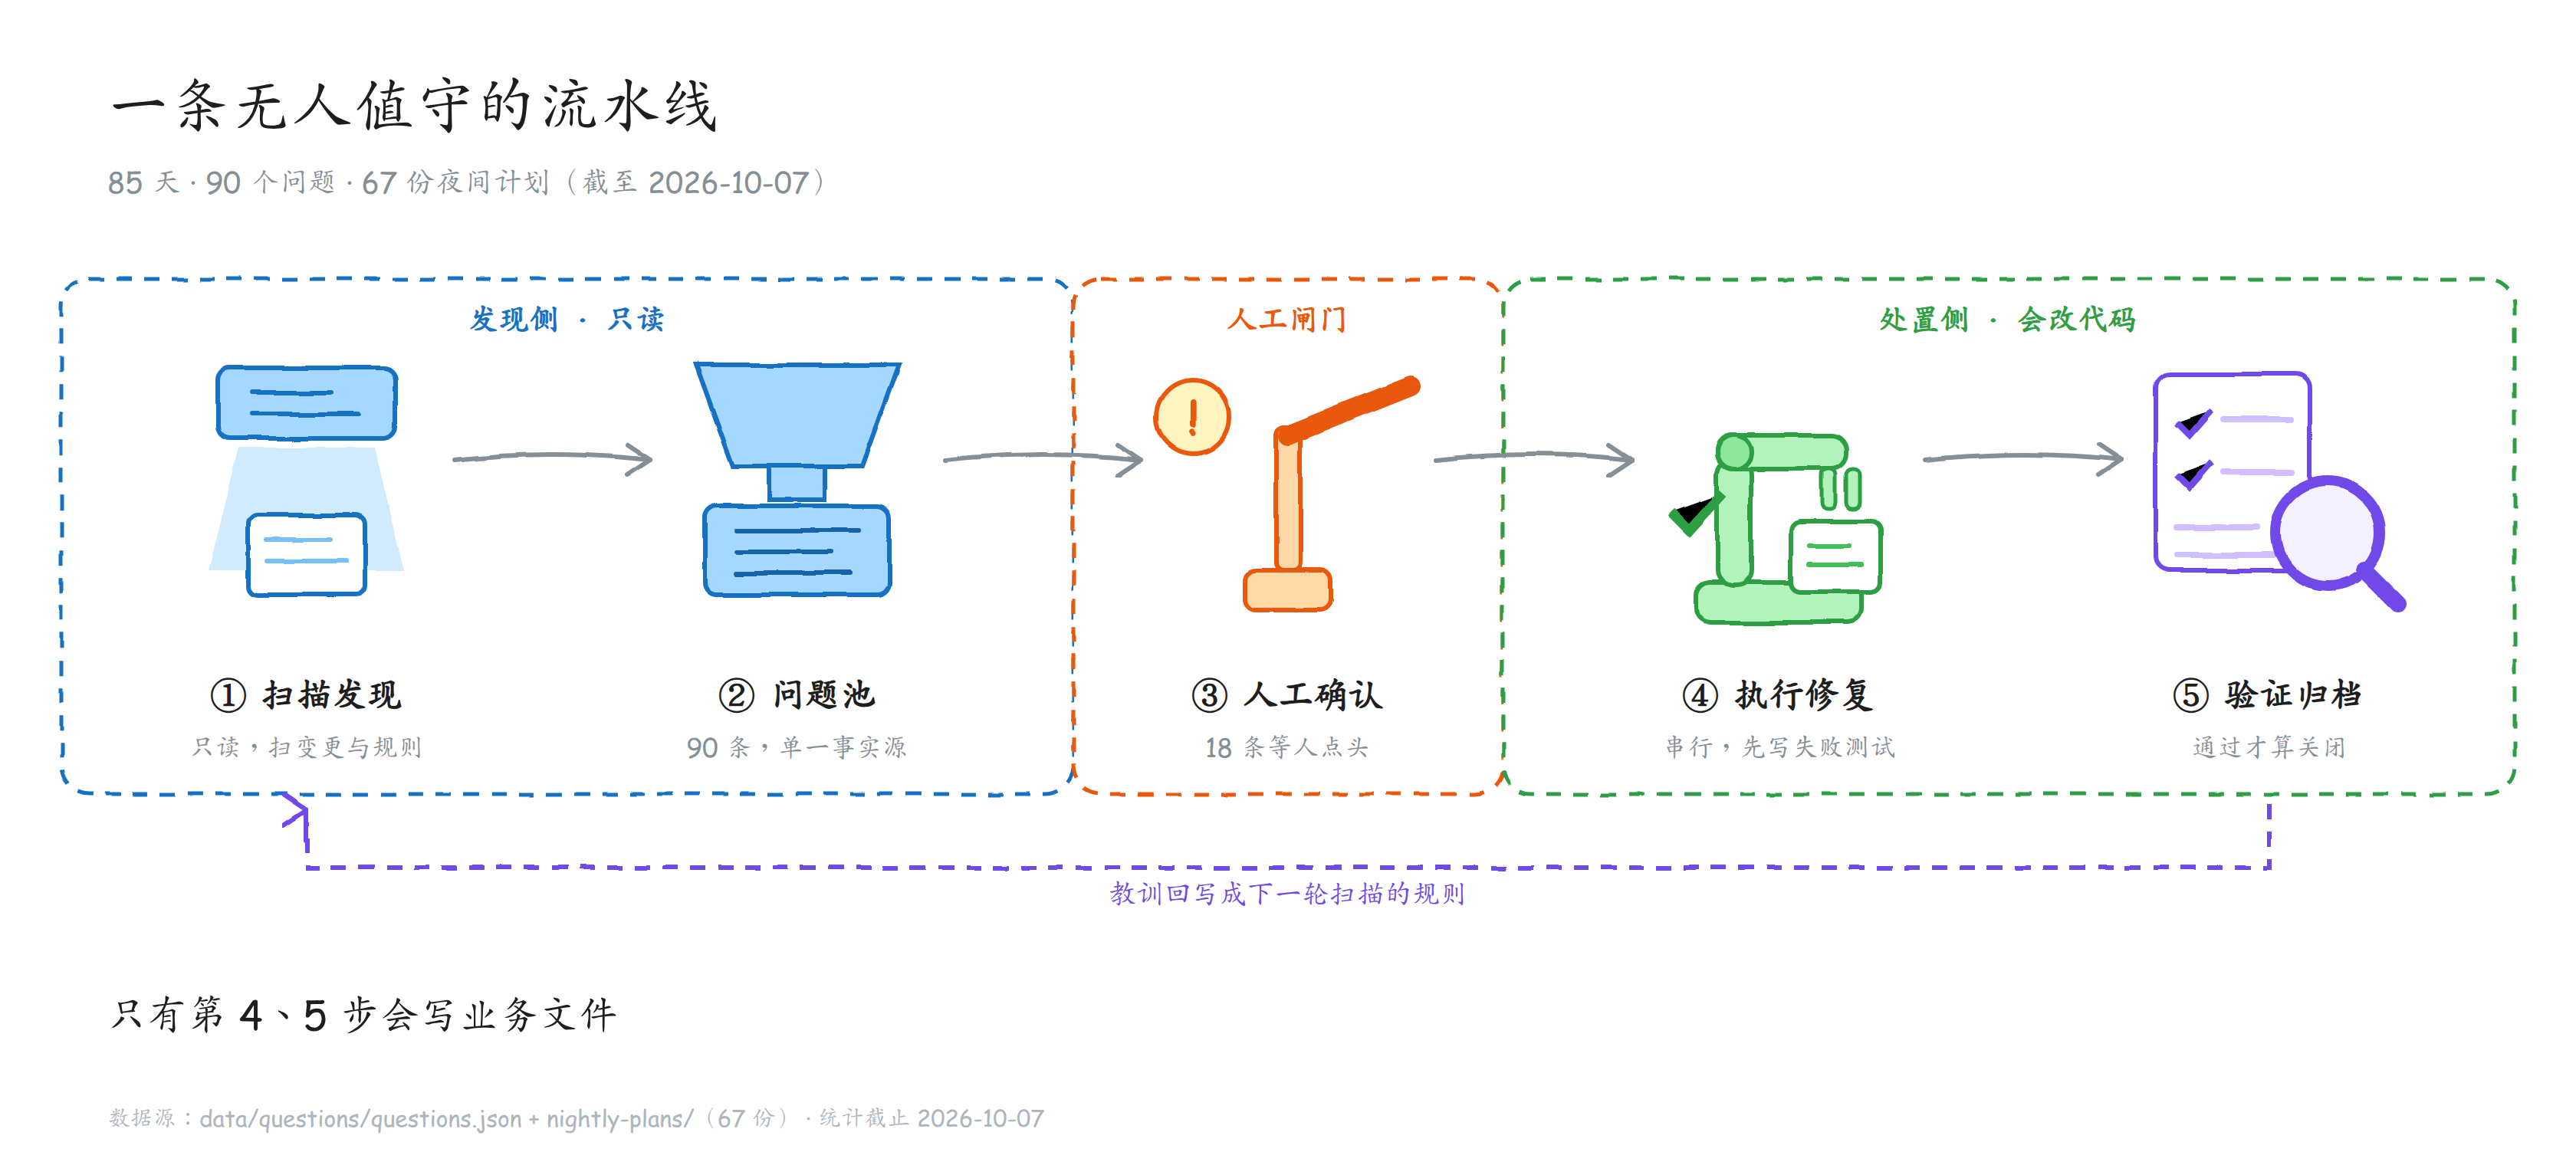
图 1:整条流水线。只有第 4、5 步会写业务文件,前面三步只读、或只往问题池里写证据。
四、发现侧:怎么让扫描既便宜又不漂移
如果每轮扫描都让模型从零思考"这段代码有没有问题",成本高,结论还会漂移。所以第一层不是思考,是规则。
扫描分三层,成本递增:
# 第一层:git diff 只深读最近变更过的文件
git diff --name-only HEAD~3..HEAD -- 'scripts/*.py' 'data/config/*.json'
# 第二层:未变更的文件只做反模式正则扫描,不读全文
# 第三层:配置与状态文件每轮必读
关键在第二层。我把踩过的坑一条条沉淀成正则规则,比如:
datetime\.now\(\)        → 调用没带时区参数,日期会算错
max\(.*old.*current\)    → 只增不减的累积窗口,永远不会过期
把"重新思考一遍"换成"跑一遍规则",成本降一个数量级,稳定性反而更高。代价是它只认得已经踩过的坑——这是它天生的边界。
效果是可见的:7 月首轮全量扫描一次挖出 51 个问题,之后逐月是 15 个、22 个,到 10 月只剩 2 个新问题。
五、处置侧:从问题池到关闭
所有问题收敛到一个 questions.json,状态是显式枚举:
open → in_progress → verified → closed
closed → reopened
这里有个刻意的设计:没有"观察中"这类中间态。我一开始加过,后来删了——"观察中"什么都说了、又什么都没说,它让我可以欺骗自己"这个问题在推进"。
处置一次要过这些环节:分诊(给每个问题一张持久化的卡,记录风险等级、估时、涉及文件)→ 排期(按分钟预算切,不按问题个数)→ 逐个串行执行 → 最后统一验证 → 归档。
排期这一环有个真实样本。这是系统 10 月 3 日晚上给自己排的计划(原文摘录,省略了部分字段;Q72、Q61、Q63 是问题池里的编号,认不出它们不影响这段要说明的事):
{
  "planDate": "2026-10-03",
  "budgetMinutes": 240,
  "triageMinutes": 20, "repairMinutes": 180, "finalVerificationMinutes": 40,
  "plannedRepairMinutes": 140, "status": "completed",
  "selectedIssues": [
    {"issueId": "Q72", "estimatedMinutes": 75, "executionOrder": 1, "reason": "首选:……它是当前唯一让全量基线变红的东西,而 Q61/Q63 的关闭门禁要求全量测试通过;改动自包含,与 Q61、Q63 零文件重叠。"},
    {"issueId": "Q61", "estimatedMinutes": 35, "executionOrder": 2, "reason": "……"},
    {"issueId": "Q63", "estimatedMinutes": 30, "executionOrder": 3, "reason": "……"}]
}
值得看的是它给自己排顺序时算了哪些账:谁在让全量测试从绿变红、谁的关闭条件依赖谁先完成、以及它们之间有没有文件重叠——同时改同一个文件的两个问题就必须一起验证,不能各测各的。
同一份计划里还记着 18 个待人工确认的问题,清一色 deferred:一个都不许生成可执行的分诊卡,一个都不许进当晚的名单。
六、真正的难点:凭什么信它处置对了
这一节是整套系统里我认为最值钱的部分。三条机制,一条都不依赖模型有多聪明。
第一,默认不信任。 新发现的问题默认是"待确认":可以进池子、可以被分析、可以被估时,但绝不能进入当晚的执行计划。系统的自主权是我一次一次点出来的,不是它自己伸手拿的。
第二,把纪律交给代码,不交给提示词。 我试过在提示词里写"请务必谨慎,不要修改计划外的文件"。结论是:没用,而且是有害的没用——它让我以为约束已经存在了。现在的做法是写一个校验器,在所有业务修改之前必须先跑通,校验不通过就一行代码都不许改。它校验的粒度很具体,包括"计划里的分钟数是否精确等于所选问题估时之和"这种账。
第三,把"改完了"和"能用了"分开判。 每个被处置的问题都要先交出一个"此刻必然失败"的测试,拿不出来就按没修处理;改完之后,写代码的模型不许给自己的改动签字,验证必须来自独立路径。最后还有一道只读的放行检查,它回答的问题和"问题是否修完"完全不同:
问题全部关闭 ≠ 系统具备恢复运行的条件
最反直觉的一刻发生在 9 月 21 日。那天的门禁 8 项检查全部通过、技术资格判定为真、阻断问题为空——按规则,恢复自动运行这件事已经合法了。但同一轮的业务语义核对翻出一件事:账上可用现金不足 800 元,而配置让它买入 5000 元,"现金底线"这个参数被写成了 0,这道本该拦住它的限流被悄悄削成了"现金 ≥ 0"。于是当晚的冻结记录里写下这么一句:
技术上你合法了,但账上不到 800 块,你却要买 5000 块。所以不许解冻。
一个纯门禁驱动的系统会在这一步放行。"合法"和"合理"是两件事,这是整套流程里最贵的一课。
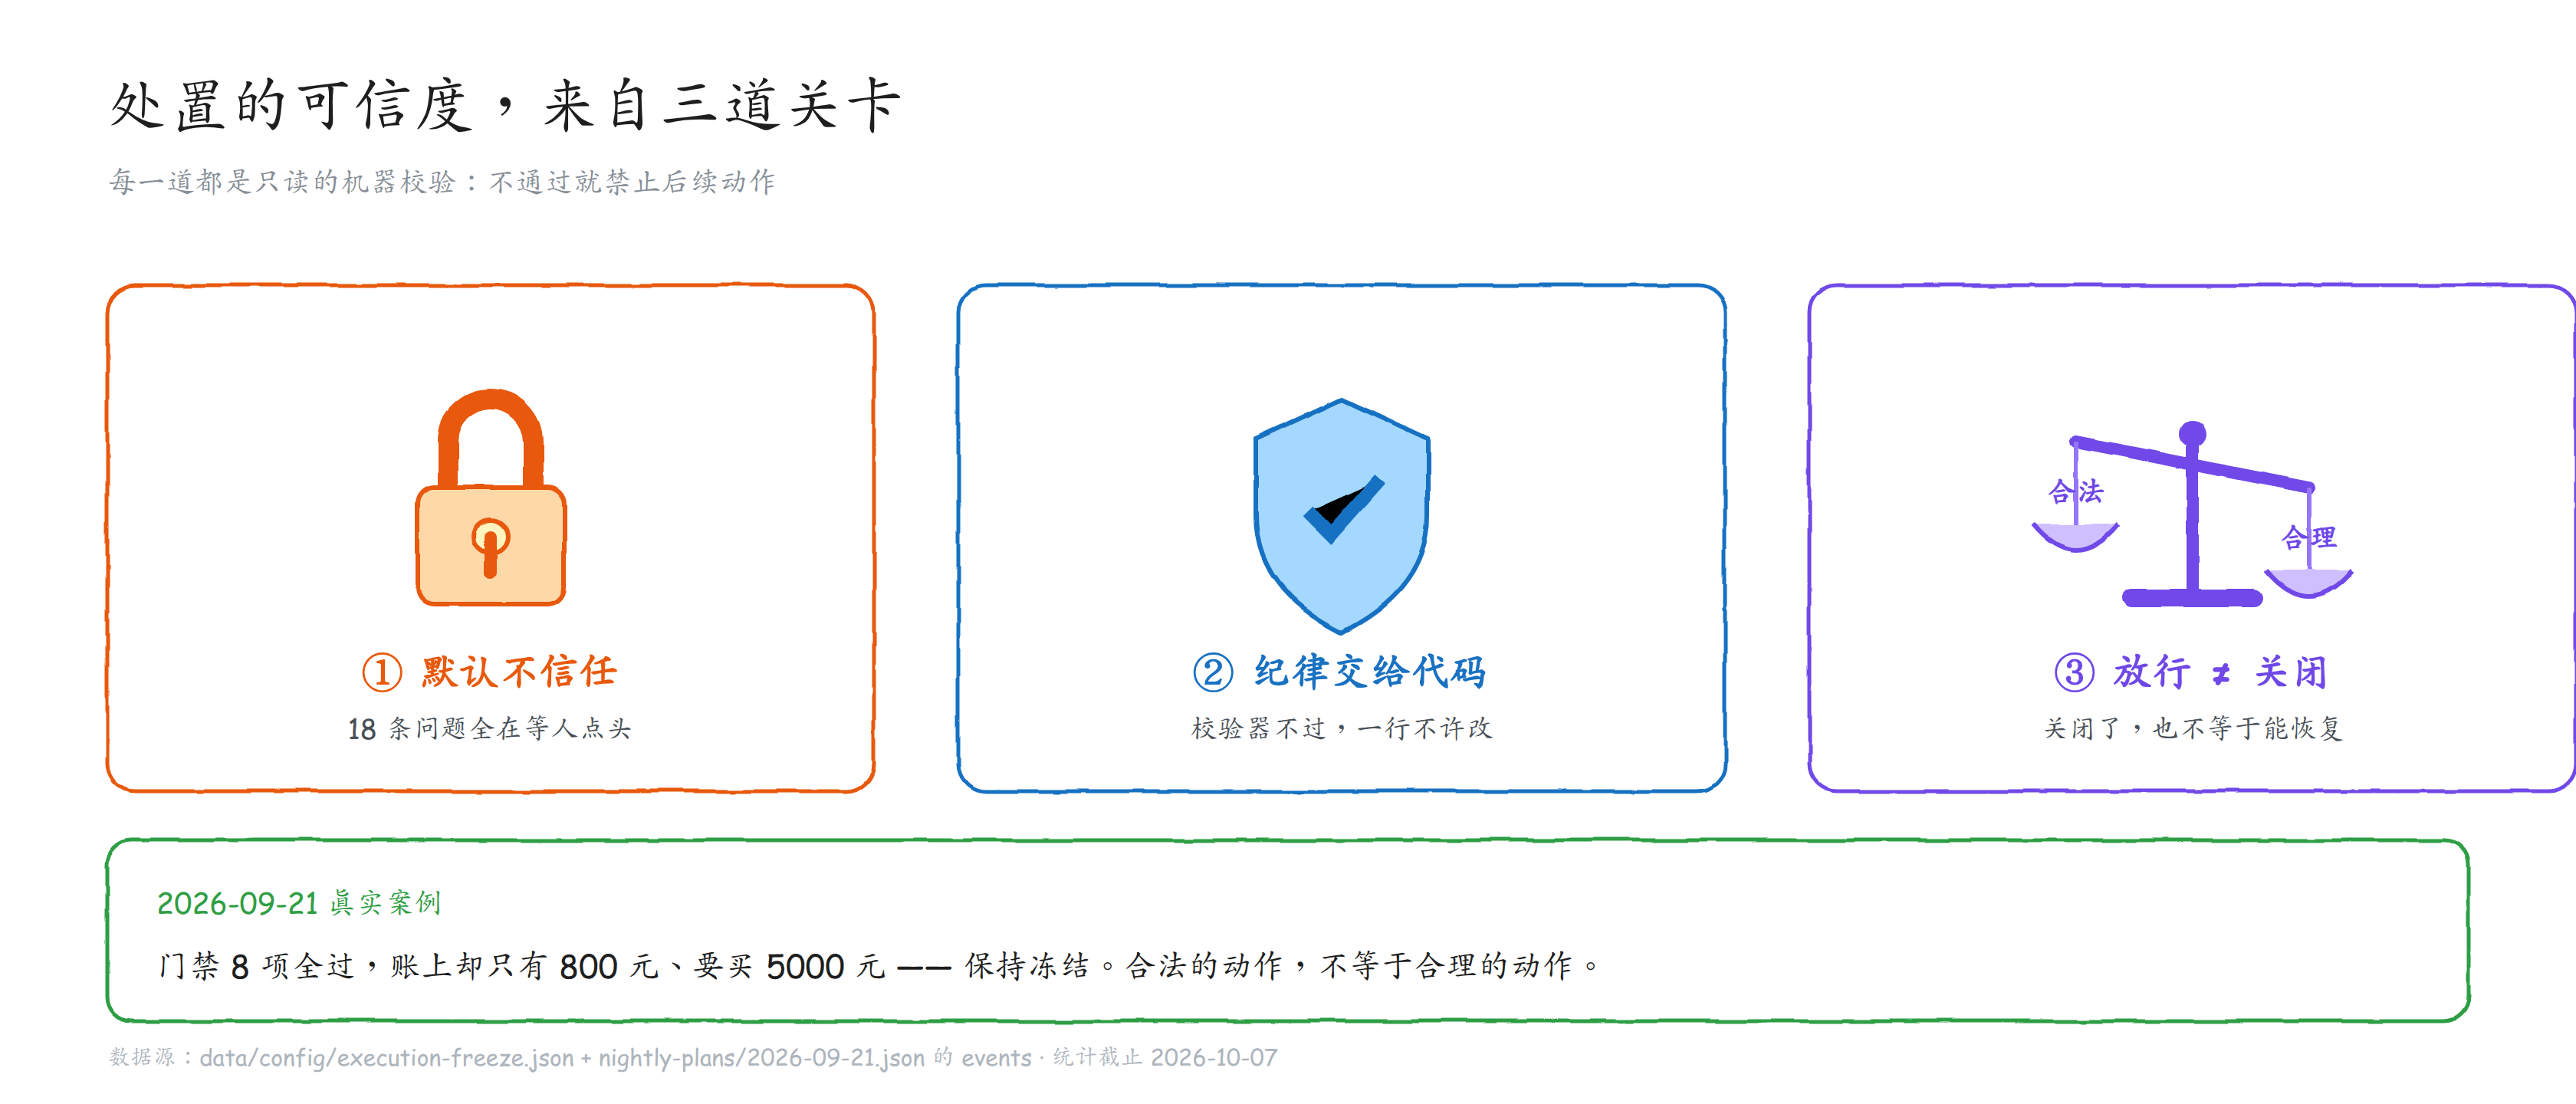
图 2:默认不信任(处置权在人手上)、纪律交给代码(改之前先过校验器)、放行与关闭分开判(门禁只看客观条件)。三条都不依赖模型有多聪明。
七、85 天的账:把失败数据也摆出来
好话讲完了,把账摆出来。数字截止 2026-10-07,这套闭环已运行 85 天。
| 指标 | 数值 |
|---|---|
| 累计发现 / 已关闭 / 未关闭 | 90 / 72 / 18 |
| 未关闭构成 | 17 open + 1 in_progress,全部待确认 |
| 关闭周期 | 中位 5 天,均值 12.4 天,最长 66 天 |
| 分析文档 / 分诊卡 | 92 篇 / 38 张 |
夜间执行:
| 指标 | 数值 |
|---|---|
| 夜间计划 | 67 份 |
| 完成 / 阻塞 / 零入选 / 失败 | 21 / 27 / 18 / 1 |
| 平均每晚推进问题数 | 1.45 个 |
| 估时 → 实际耗时 | 61.1 → 33.7 分钟(0.55 倍) |
三个数字我想单独说。
27 份计划以"阻塞"结束,占 40%。 多数夜晚它没能把计划跑完,原因有工作区不干净、外部依赖不可用、以及"这个问题需要判断业务语义,它做不了"。
18 份计划的入选问题是 0——它排完期,一个都不选。 最近的 10 月 4、5、6 日连续三天都是这样:没有已确认的问题,它就不开工,而不是自己去找点活干。
平均每晚只推进 1.45 个问题。 这个数字和"AI 效率高"的叙事完全相反。原因不复杂:瓶颈不在写代码,在验证。一个高风险问题要走全量测试、组合验证、真实路径检查,光验证就吃掉大半预算。
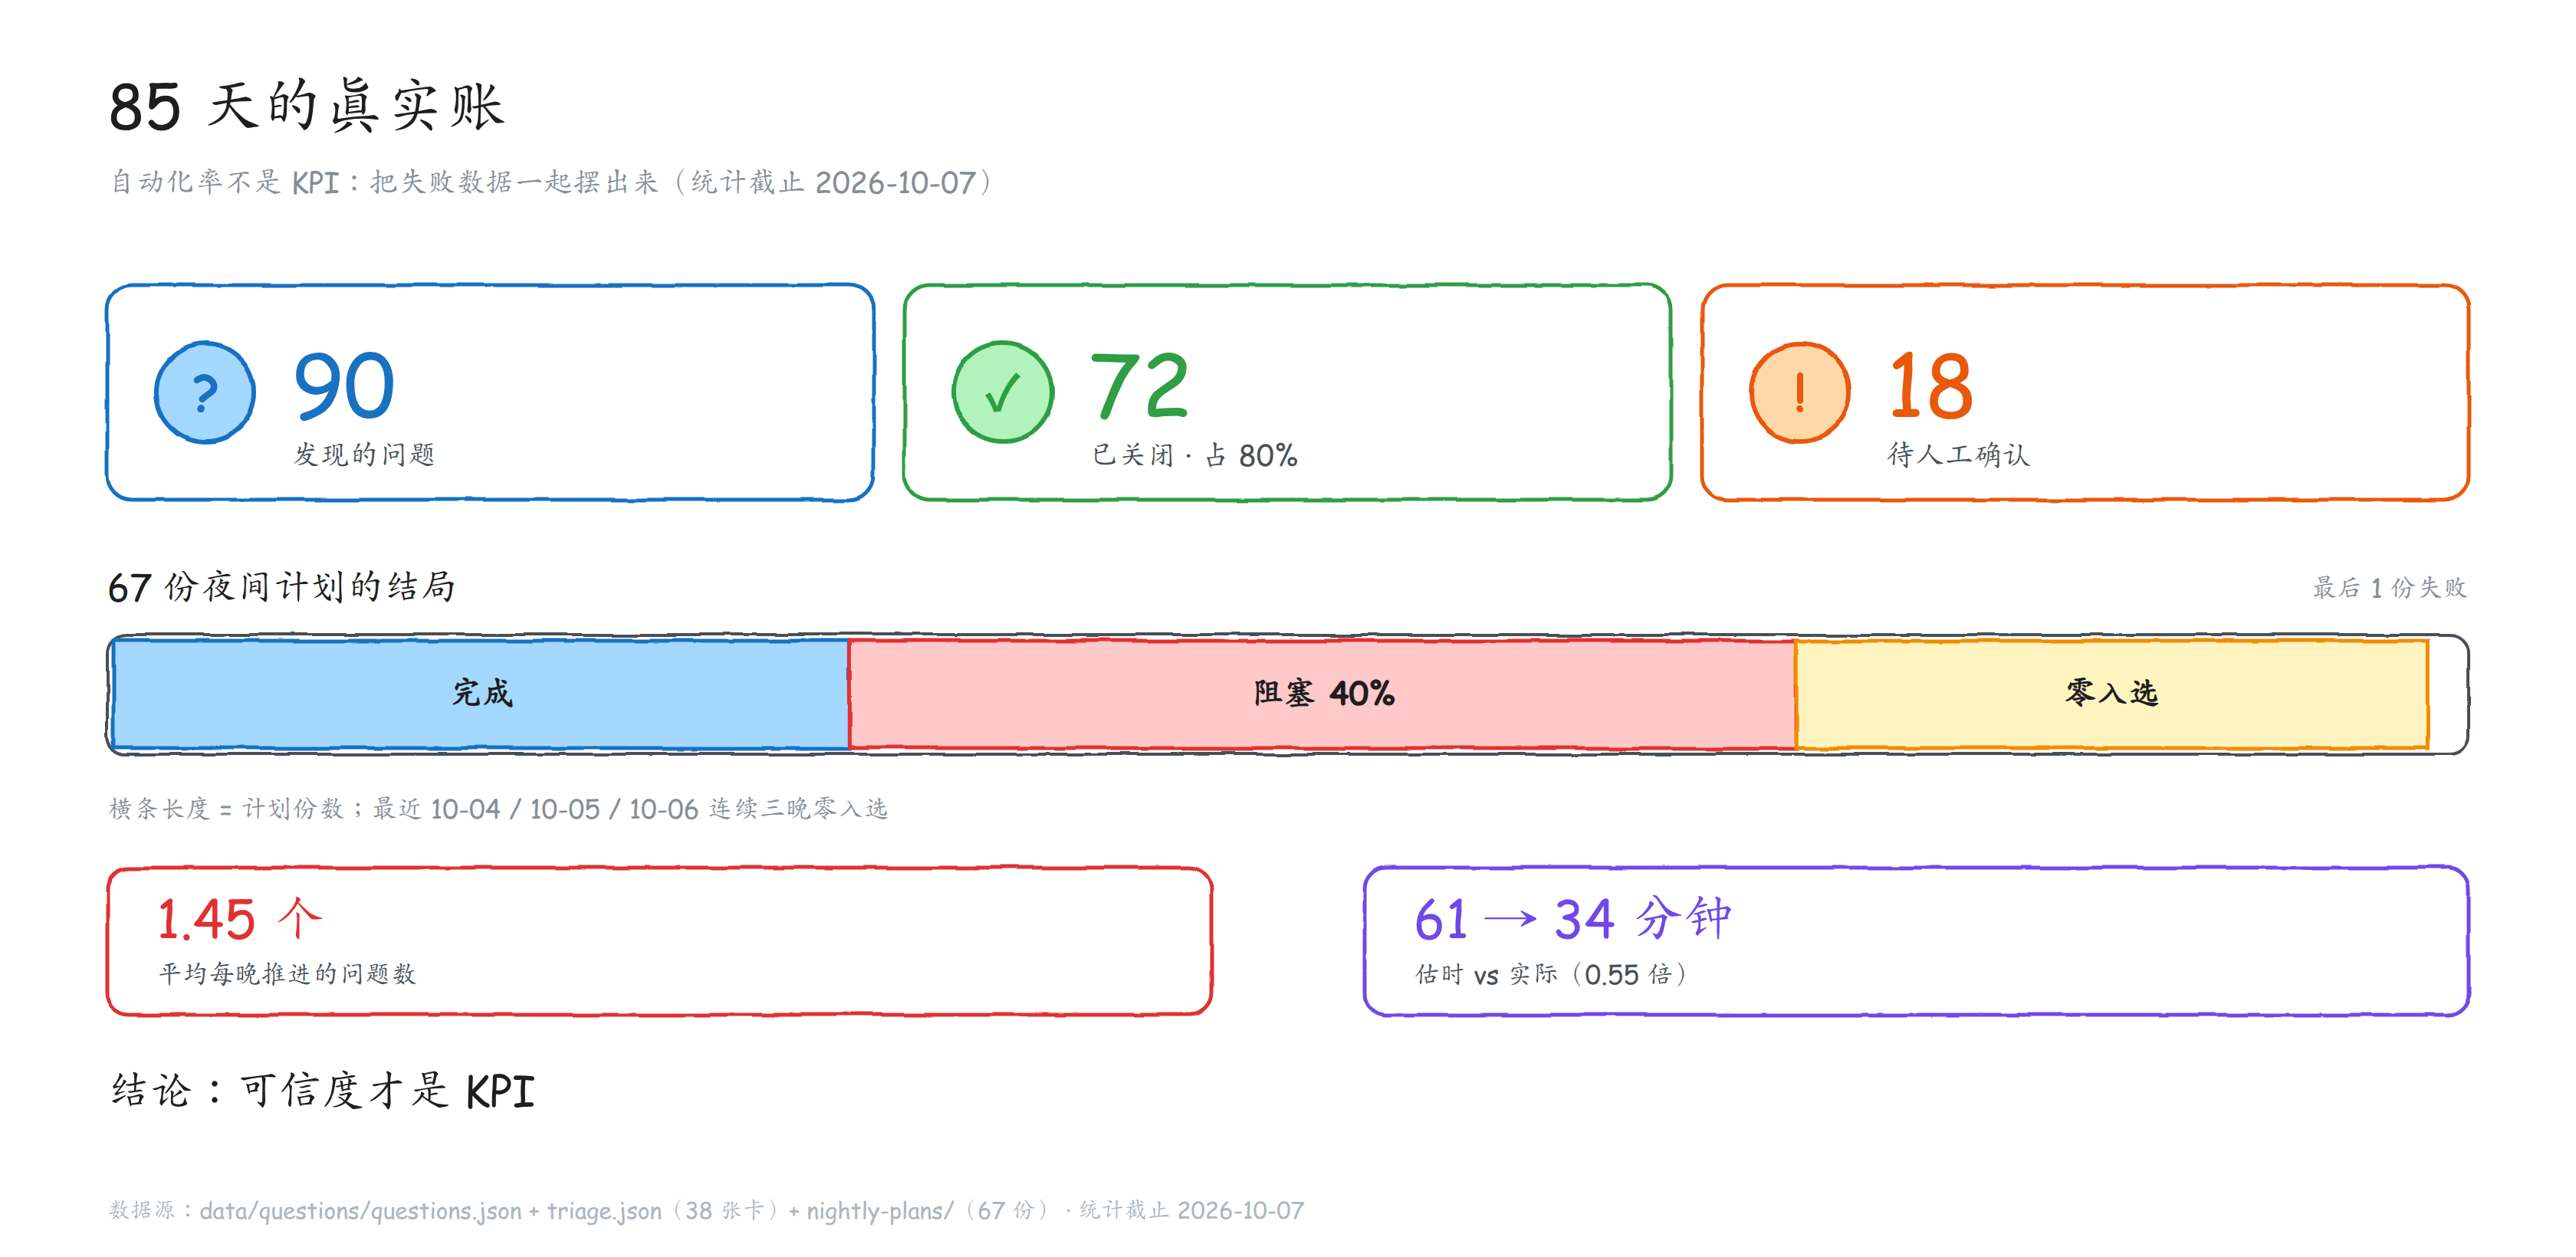
图 3:三个数我都希望它更好看,但它们是真的——27 份计划以阻塞收场,占了 40%。
结论就一句:自动化率不是 KPI,可信度才是。 一个每晚能修十个问题、但没人敢用的系统,价值是负的。
八、代价与边界
写到这,如果这套东西看起来挺美好,我得泼一盆冷水。
它不便宜。 每轮扫描要读源码,每晚要跑测试和验证,token 和时间开销明显高于"人工随手改一下"。这套流程只有在问题持续产生、且漏掉的代价高于修复成本时才划算。
AI 自评不算验证。 写代码的模型不能给自己的代码签字——它和自己有相同的盲区,判过等于没判。
什么场景不该用: 一次性项目、探索期的系统(还没稳定下来,谈回归门禁没有意义);连"修好了"都说不清的任务;以及变更本身风险极高的动作,比如付款、发版、删数据——这类应该留在人手上,AI 只做建议。
最后说清楚它现在的状态:截至统计日,这套系统仍在冻结中,18 个问题在等我逐条确认。它不是"跑通就一劳永逸"的东西,它是一个需要有人持续看着的结果。
如果你只带走一件事,我希望是这个:AI 工程化里真正稀缺的不是让 AI 更聪明,而是给它造一个犯不了大错的工位。
接下来的几篇会分别拆开讲:静默失败的三种真实形态;让一次修复可信的那道关;教训怎么变成机器能跑的规则;以及这 85 天里那些不好看的数字。
你现在的项目里,AI 改完代码之后是谁在签字? 是某个人扫一眼,还是有机器能反复算出来的判据?欢迎在评论区说说你卡在哪一环。