你见过同时派16个AI Agent去解同一道题的产品吗?
一、Muse Spark到底是谁——Meta憋了9个月的那张牌
1.1 从Avocado到Muse Spark:代号背后的战略意图
Muse Spark的原代号是Avocado,这是Meta内部项目常用的水果命名传统。2026年4月8日,Meta超级智慧实验室(MSL)正式发布这款模型,随后在7月9日推出Muse Spark 1.1版本。扎克伯格给它的定位是「有史以来最强大的模型」,但更准确地说,这是一次从底层重建AI栈后的首次亮相。
过去九个月,MSL团队推翻了Meta过往的诸多做法,重建了架构、数据管道和基础设施。根据Meta官方博客的描述,这是一个「刻意且科学的模型扩展路径」——每一代模型都要验证并建立在前一代的基础上,然后再做大。
这背后是一个清晰的战略信号:Meta不再满足于做Llama的开源跟随者,而是要在产品端直接对标OpenAI和Google。
1.2 Llama血脉的终结者?MSL团队的真实背景
Muse Spark并不是Llama系列的延续,而是Muse家族的第一款产品。这个切割是故意的。
MSL由前Scale AI首席执行官Alexandr Wang领导,他在Meta对Scale AI 143亿美元投资的同时加入,出任Meta首席AI官。根据公开信息,MSL整合了Meta原有的基础模型研究、产品开发与FAIR三大团队,并从OpenAI、Google DeepMind、Anthropic等实验室挖角超过11位核心科学家,部分签约金据传高达数千万至上亿美元。
这意味着Muse Spark承载的不是一个研究项目的成果,而是一个重兵投入的新部门的首个产品。它的架构、训练数据和推理模式都是从零设计的。
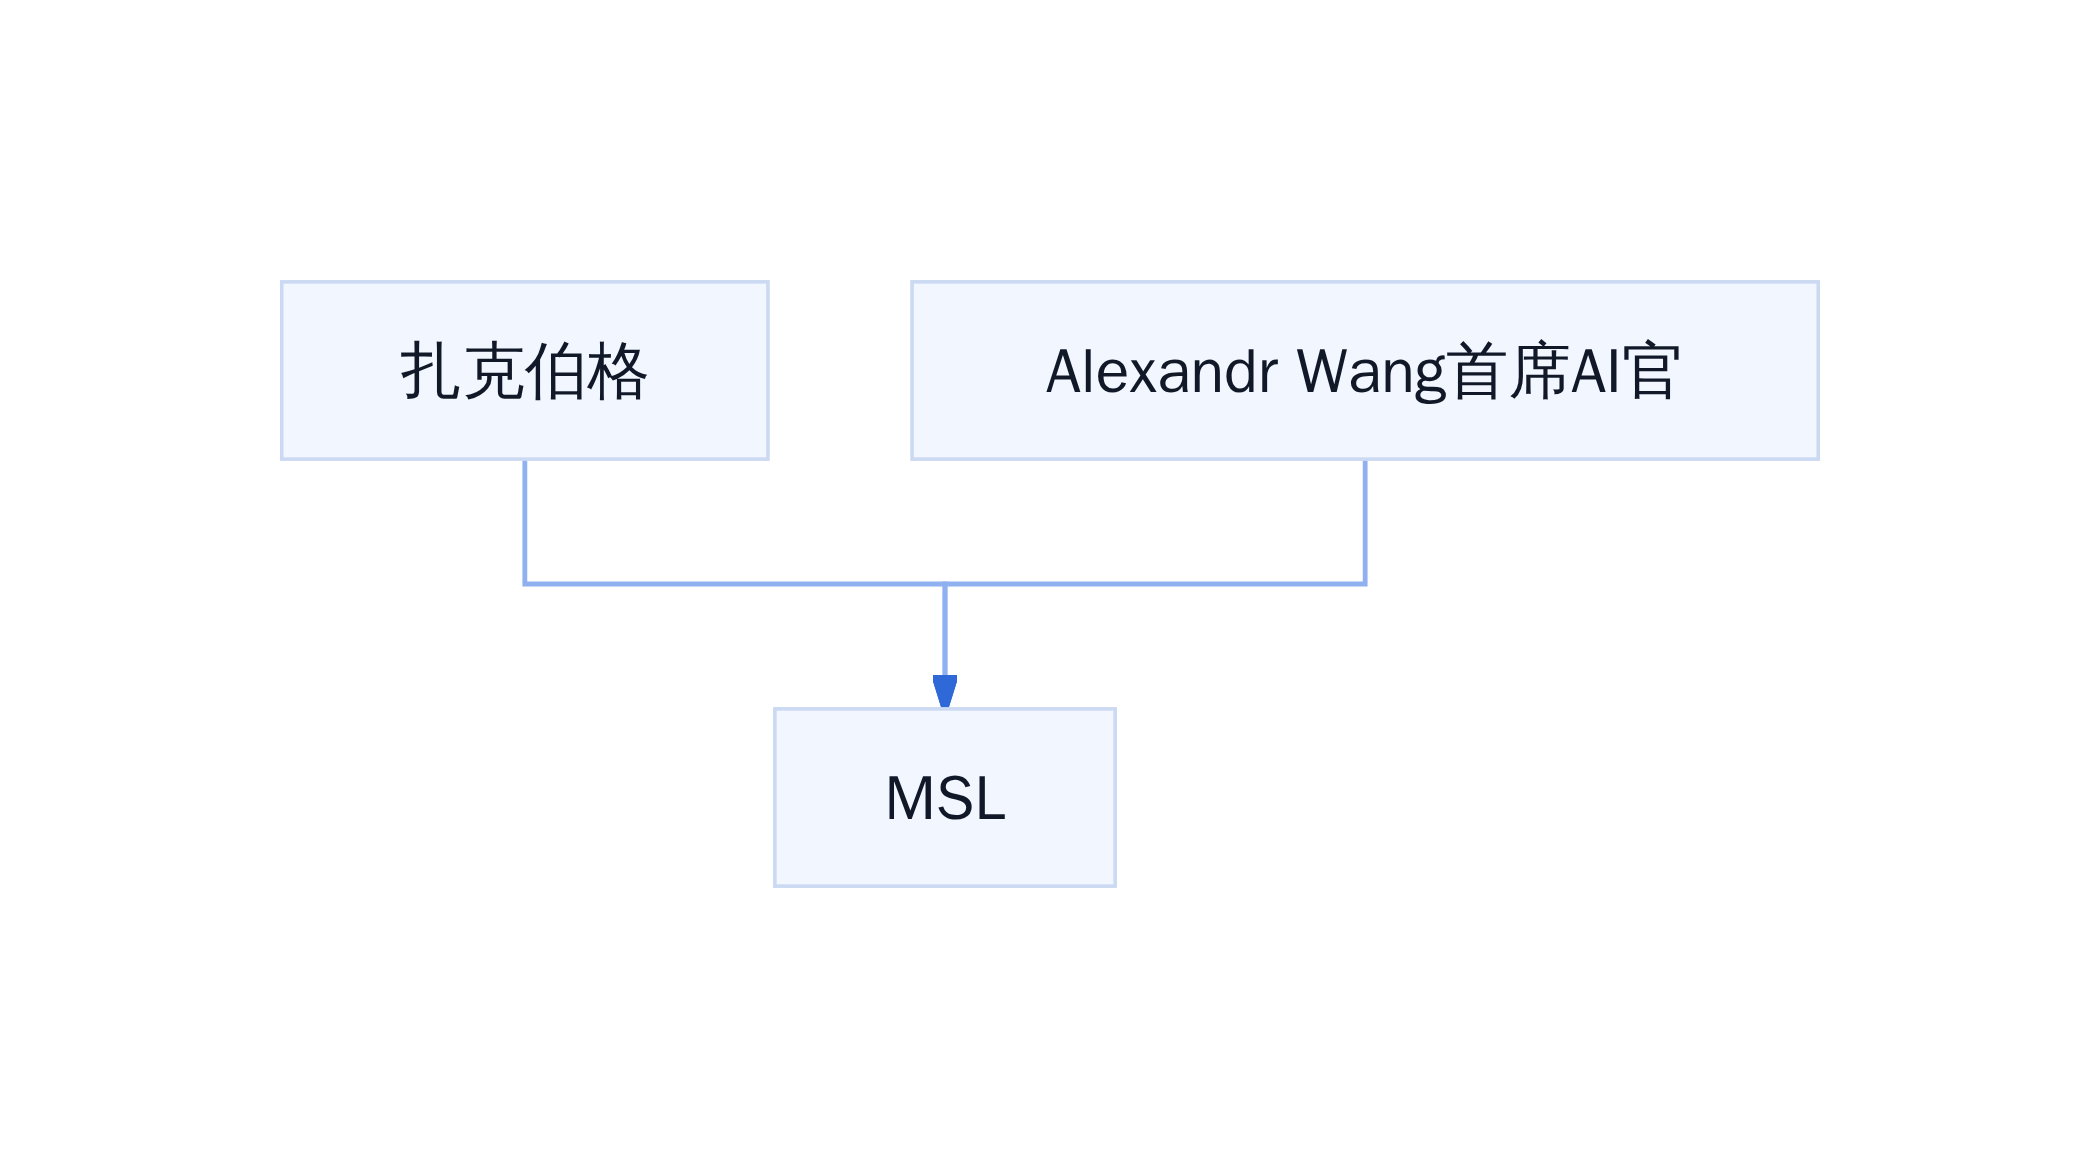
Meta超级智慧实验室(MSL)组织架构
同时在线16个Agent的运行时
2.1 Humanity's Last Exam与FrontierScience:测试设计意味着什么
先搞清楚这两个基准测的是什么。
Humanity's Last Exam(HLE)是一道综合推理测试,考察模型在跨学科问题上的整体推理能力。它分两个子场景:无工具模式(纯推理)和有工具模式(可以调用外部工具辅助解题)。前者测的是模型本身的逻辑引擎,后者测的是模型将推理拆解为工具调用的能力——这恰好是多代理架构最能发力的地方。
FrontierScience Research则是专门针对科学研究任务设计的基准,要求模型像真正的研究者一样,从假设出发,使用证据链逐步推进结论。这道题不关心你能不能给出正确答案,它关心的是你的论证过程是否经得起推敲。
论文评审式推理
2.2 38.3% vs 23.3%:科学推理差距的实质是什么
Muse Spark在FrontierScience上拿到38.3%,Gemini 3.1 Deep Think是23.3%,GPT 5.4 Pro是36.7%。
这个数字背后不是参数量的碾压,而是架构的选择。
Gemini走的是深度单线程推理路线——让一个Agent反复自我校验、延长思考时间。这在纯数学计算上有优势,但在科学问题面前会出现一个结构性瓶颈:当问题的论证链条超过一定长度,单线程的上下文管理成本呈指数上升,模型开始在自己的推理里绕圈子。
Muse Spark的做法是并行化。16个Agent同时出发,各自走不同的论证路径,最后由一个协调器整合结果。每个Agent只负责一小段推理链,上下文压力被分摊掉了。延迟并没有叠加16倍,因为大多数路径在早期就提前终止了——只有少数关键路径会继续深入。mermaid
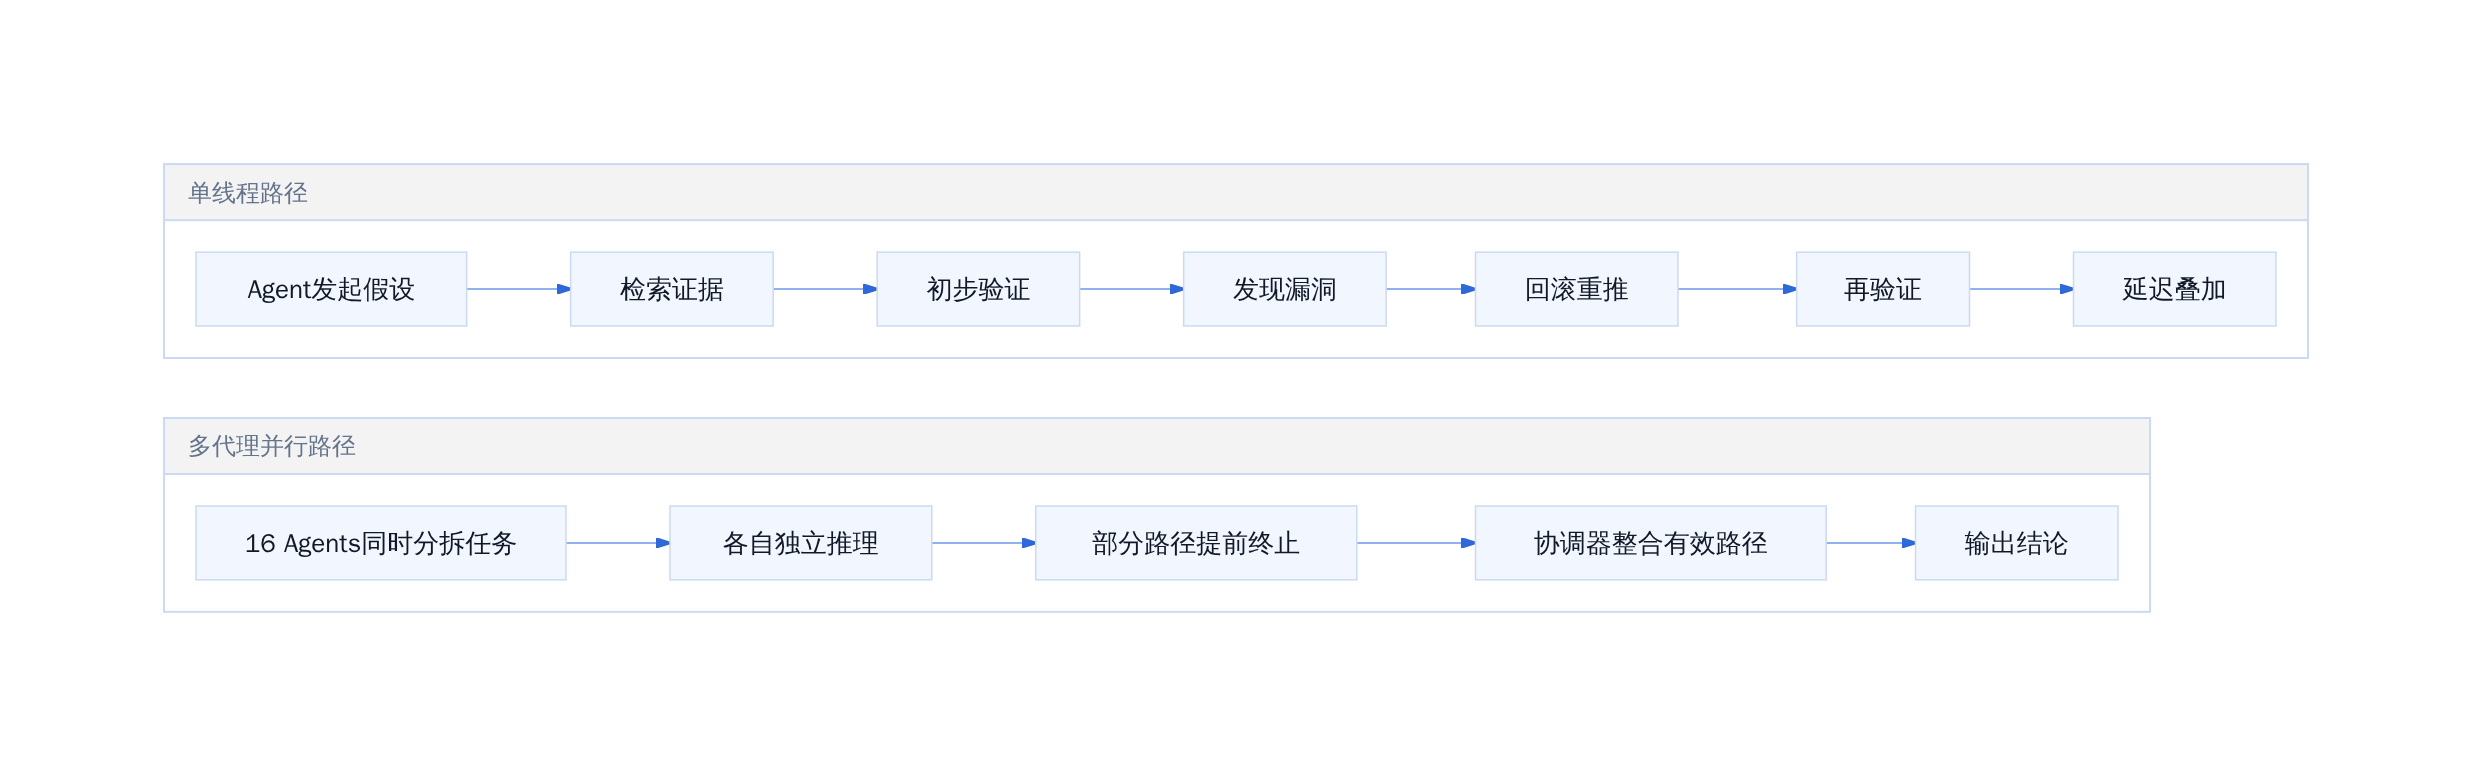
单线程推理 vs 多代理并行推理
2.3 工具场景58.4% vs 58.7%:GPT最后堡垒还能守多久
有工具场景下,Muse Spark达到58.4%,GPT 5.4 Pro是58.7%。三分之差的误差范围内,GPT的领先几乎可以忽略。
这意味着什么?在需要调用外部工具的场景里,多代理架构已经追平了GPT在单线程深度推理上的积累。GPT的优势曾经建立在「让它想更久」这条路上,但当并行替代了串行,这条路的优势就被结构性抵消了。
更准确地说,GPT的延迟会随着思考时间线性增长——你想更准,就得等更久。Muse Spark的延迟增长则接近对数曲线:从1个Agent到16个Agent,延迟只增加了不到一截,准确率却从50%稳步上升到58.5%。这个斜率,才是Meta真正卡住的位置。mermaid
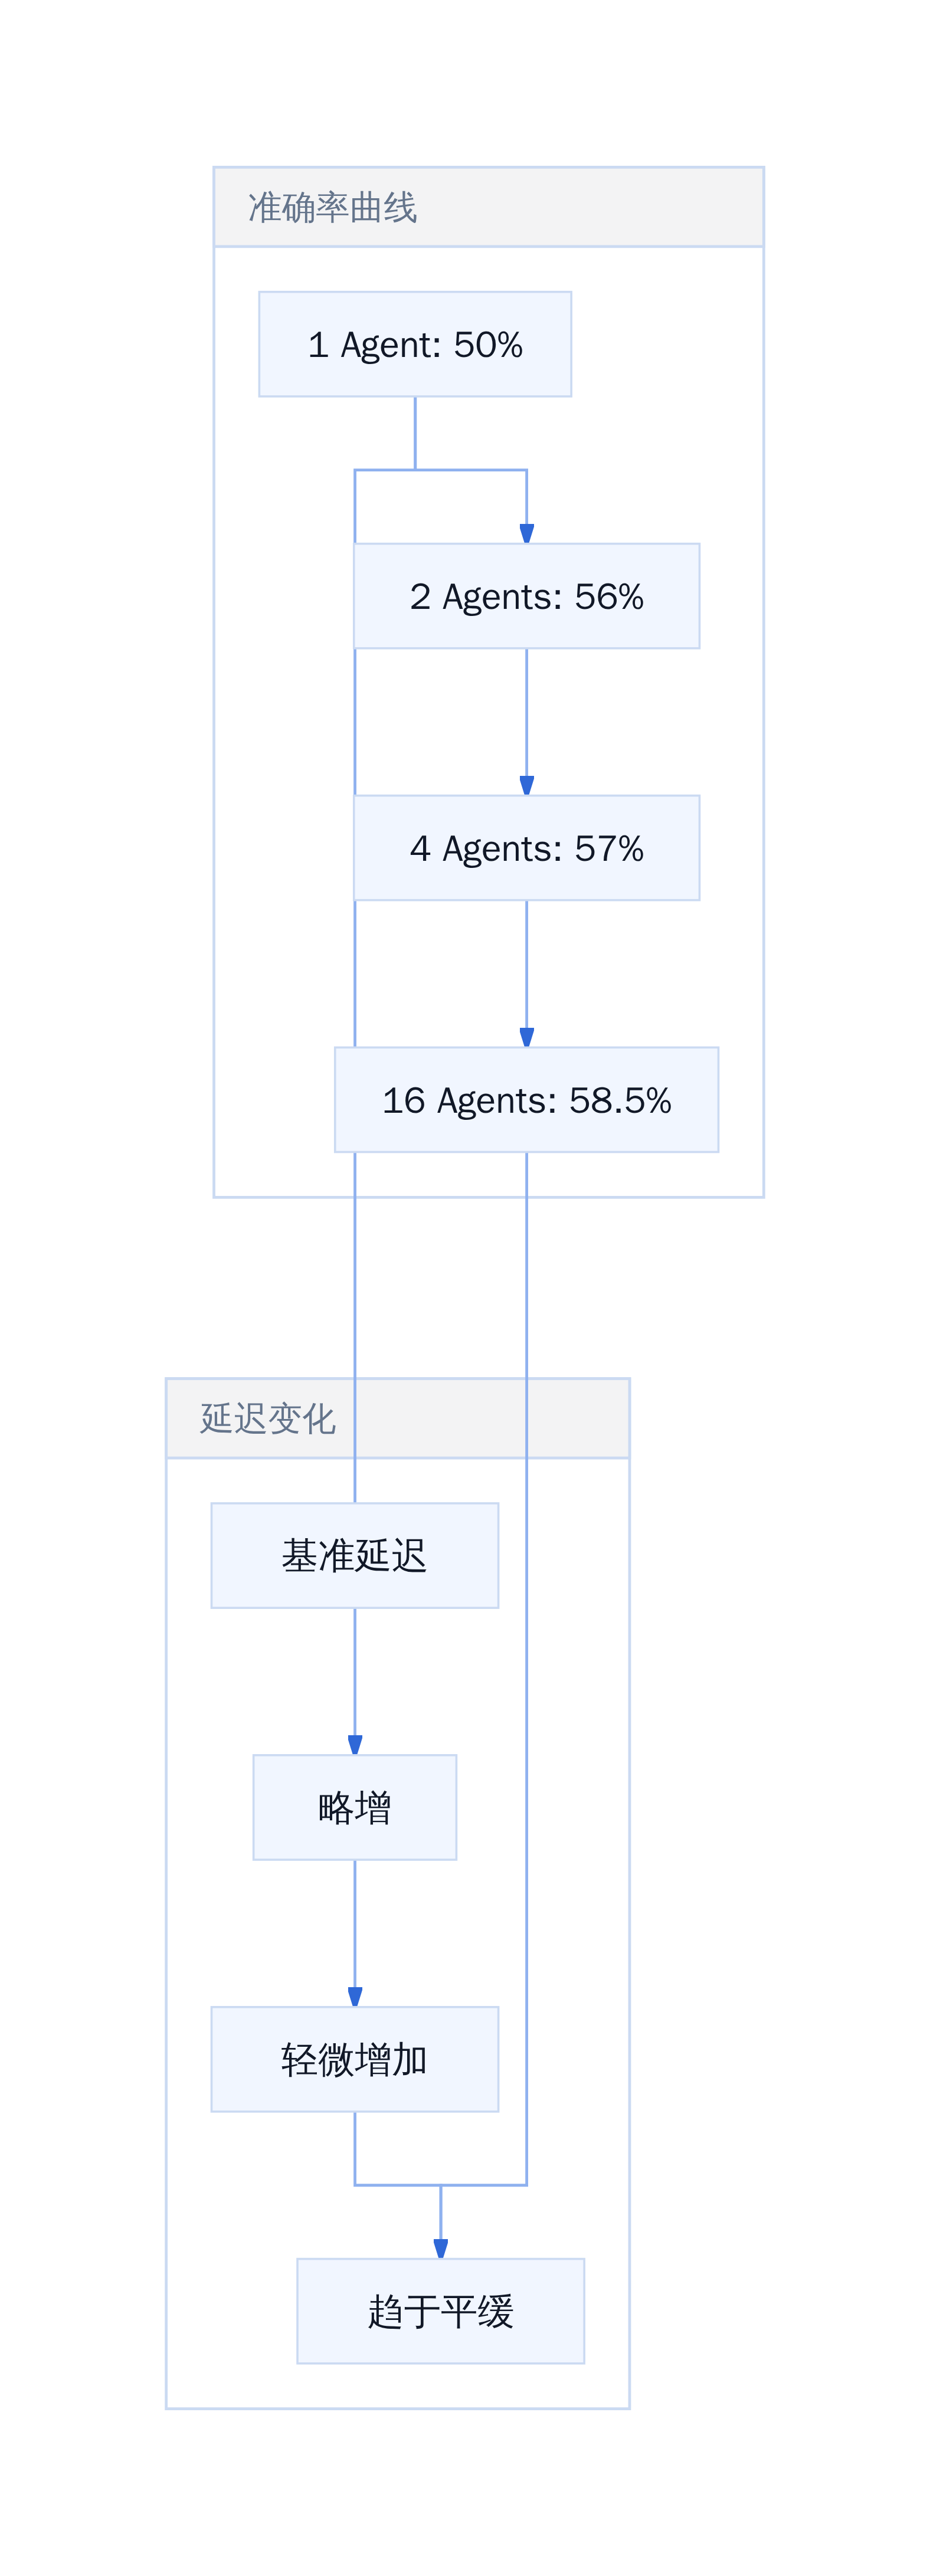
Agent数量与准确率/延迟的关系
架构红利兑现的时刻
数据本身是冷的,但它的指向很热。Meta这次赌的不是更大的参数,而是更聪明的架构——让AI同时想16件事,比让它想16次更高效。这个逻辑一旦被验证成立,后续所有跟进的模型都会在这条路线上加深投入。
Gemini的回应还在路上,但GPT这边,OpenAI过去两年最难复制的东西,恰恰就是这种结构性的推理效率优势。参数可以买,数据可以采,但架构红利需要时间验证。
16个代理同时开工,你的GPU看着有点慌
三、多代理并行的真正价值:不只是「想更多」
3.1 1个到16个代理:为什么曲线不衰减
单看Humanity's Last Exam(With Tools)的数据,你会得到一个反直觉的结论:代理数量从1扩展到16,准确率持续提升,但延迟几乎不变。
| 代理数 | 准确率 |
|---|---|
| 1 | ~50% |
| 2 | ~56% |
| 4 | ~57% |
| 16 | ~58.5% |
数据曲线长这样,但实现起来挺痛苦
关键在于,这不是「让一个Agent多想一会儿」,而是让16个Agent同时想不同的路径,然后在最后合并结果。每个Agent独立运行,互不干扰,共享的是同一个任务定义和输出格式。
这种架构的本质是空间换时间:你用更多的GPU算力换取更短的端到端延迟,同时获得更高的准确率。这和传统做法的逻辑完全相反——传统做法是让一个模型慢慢想、慢慢推理,延迟随思考深度线性增长。 ┌─────────────────────────────────────────────────┐ │ 任务输入(问题 + 工具集) │ └──────────────────────┬──────────────────────────┘ ▼ ┌────────────────┐ │ 任务分发器 │ ← 把问题拆解成16个子任务 └────────┬───────┘ │ ┌──────────────┼──────────────┐ ▼ ▼ ▼ ┌─────────┐ ┌─────────┐ ┌─────────┐ │ Agent 1 │ │ Agent 2 │ │ Agent 3 │ ... └────┬────┘ └────┬────┘ └────┬────┘ │ │ │ └──────────────┼──────────────┘ ▼
│ 结果合并器 │ ← 投票/加权/最优选择
▼
│ 最终输出 │ ← 单条响应,用户无感知 └────────────────┘
3.2 与延展推理(extended thinking)的本质区别
OpenAI的GPT-5.4和Anthropic的Claude都走了「延展推理」这条路——让模型花更多时间思考,产出更长的思维链。效果确实好,准确率能提升,但延迟也随之暴涨。
Muse Spark的选择完全不同。它的Contemplating模式不是让一个Agent想得更久,而是让16个Agent同时想、然后取最优结果。这是两条完全不同的技术路线。
| 维度 | 延展推理(OpenAI/Anthropic) | 多代理并行(Meta Muse Spark) |
|---|---|---|
| 扩展方式 | 增加单次推理时间 | 增加并行代理数量 |
| 延迟特征 | 线性增长 | 基本恒定 |
| 准确率上限 | 受限于单次推理深度 | 受限于探索空间宽度 |
| 算力利用 | 串行,GPU闲置率高 | 并行,GPU利用率高 |
| 工程复杂度 | 低(调参即可) | 高(需要任务分发与结果合并) |
从数学角度理解,延展推理解决的是「单个路径的探索深度」问题,多代理并行解决的是「路径数量的探索广度」问题。两者互补,但适用场景不同。
对于需要快速响应的产品场景,多代理并行更友好——用户感受不到延迟,但模型已经用算力换取了更高的准确率。这就是为什么Meta敢说「这恰好是OpenAI过去两年最难复制的东西」。
3.3 实时可用性与延迟惩罚的平衡术
延展推理的最大问题是延迟。当用户问一个问题,模型要花30秒甚至更久才能给出答案——这种体验在聊天场景里是灾难性的。
Muse Spark的方案是把这30秒拆成16份,每个Agent只花2秒左右,最后合并结果。对用户而言,延迟从30秒降到2秒,准确率反而从50%提升到58.5%。
这不是魔法,是工程取舍。代价是GPU利用率提升8倍,API成本相应增加。但Meta的策略很明确:先证明架构优势,再通过规模摊薄成本。 ┌─────────────────────────────────────────────────────┐ │ 延迟-准确率权衡对比 │ ├──────────────────┬──────────────────┬────────────────┤ │ 方案 │ 延迟(相对值) │ 准确率(相对值) │ ├──────────────────┼──────────────────┼────────────────┤ │ 单Agent标准模式 │ 1x │ 50% │ │ 单Agent延展推理 │ 15x │ 55% │ │ 16 Agent并行 │ 2x │ 58.5% │ └──────────────────┴──────────────────┴────────────────┘
从开发者的角度看,这意味着两件事:
第一,API调用时不需要再为「要不要开启深度思考」纠结——默认就是并行模式,延迟可控。
第二,成本模型会变化。单Agent延展推理的成本主要和时间成正比,多代理并行的成本主要和代理数量成正比。当GPU算力足够廉价时,后者更经济。
Meta的策略很直接:先用并行架构证明效果,再用规模效应降低单token成本。如果这个路径跑通,整个行业的推理架构都会跟着变。
OpenAI的难处在于,它们已经在延展推理上投入了大量工程资源,用户习惯也在养成。要切换到多代理并行,不仅要改架构,还要重新教育市场——这是为什么Meta敢说这是「过去两年最难复制的东西」。
四、从科研到产品:Muse Spark的落地路径
4.1 内部编码测试与开源计划(Muse Spark 1.2)
Benchmark分数只是起点,真正的考验落在工程团队每天面对的生产任务上。Meta内部编码评估——Muse Code Benchmark,是测试这套模型能否从研究玩具变成开发者的日常工具的关键关卡。
根据Meta官方博客披露的数据,Muse Spark 1.1在Muse Code Benchmark上相比初版Muse有显著提升,并达到与当前领先替代品相当的水平。更重要的是,研究人员已开始在日常工作流中利用Muse Spark 1.1自动化模型开发与评估任务,包括在OpenCode上的DeepSWE评估。
开源计划已经明确。Mark Zuckerberg表态,Muse Spark 1.2将以开放权重模型的形式发布。这意味着什么?意味着整个开源社区可以基于这个架构进行二次开发、微调,甚至构建自己的推理系统——而不像某些闭源竞品那样,把架构锁死在自家API后面。
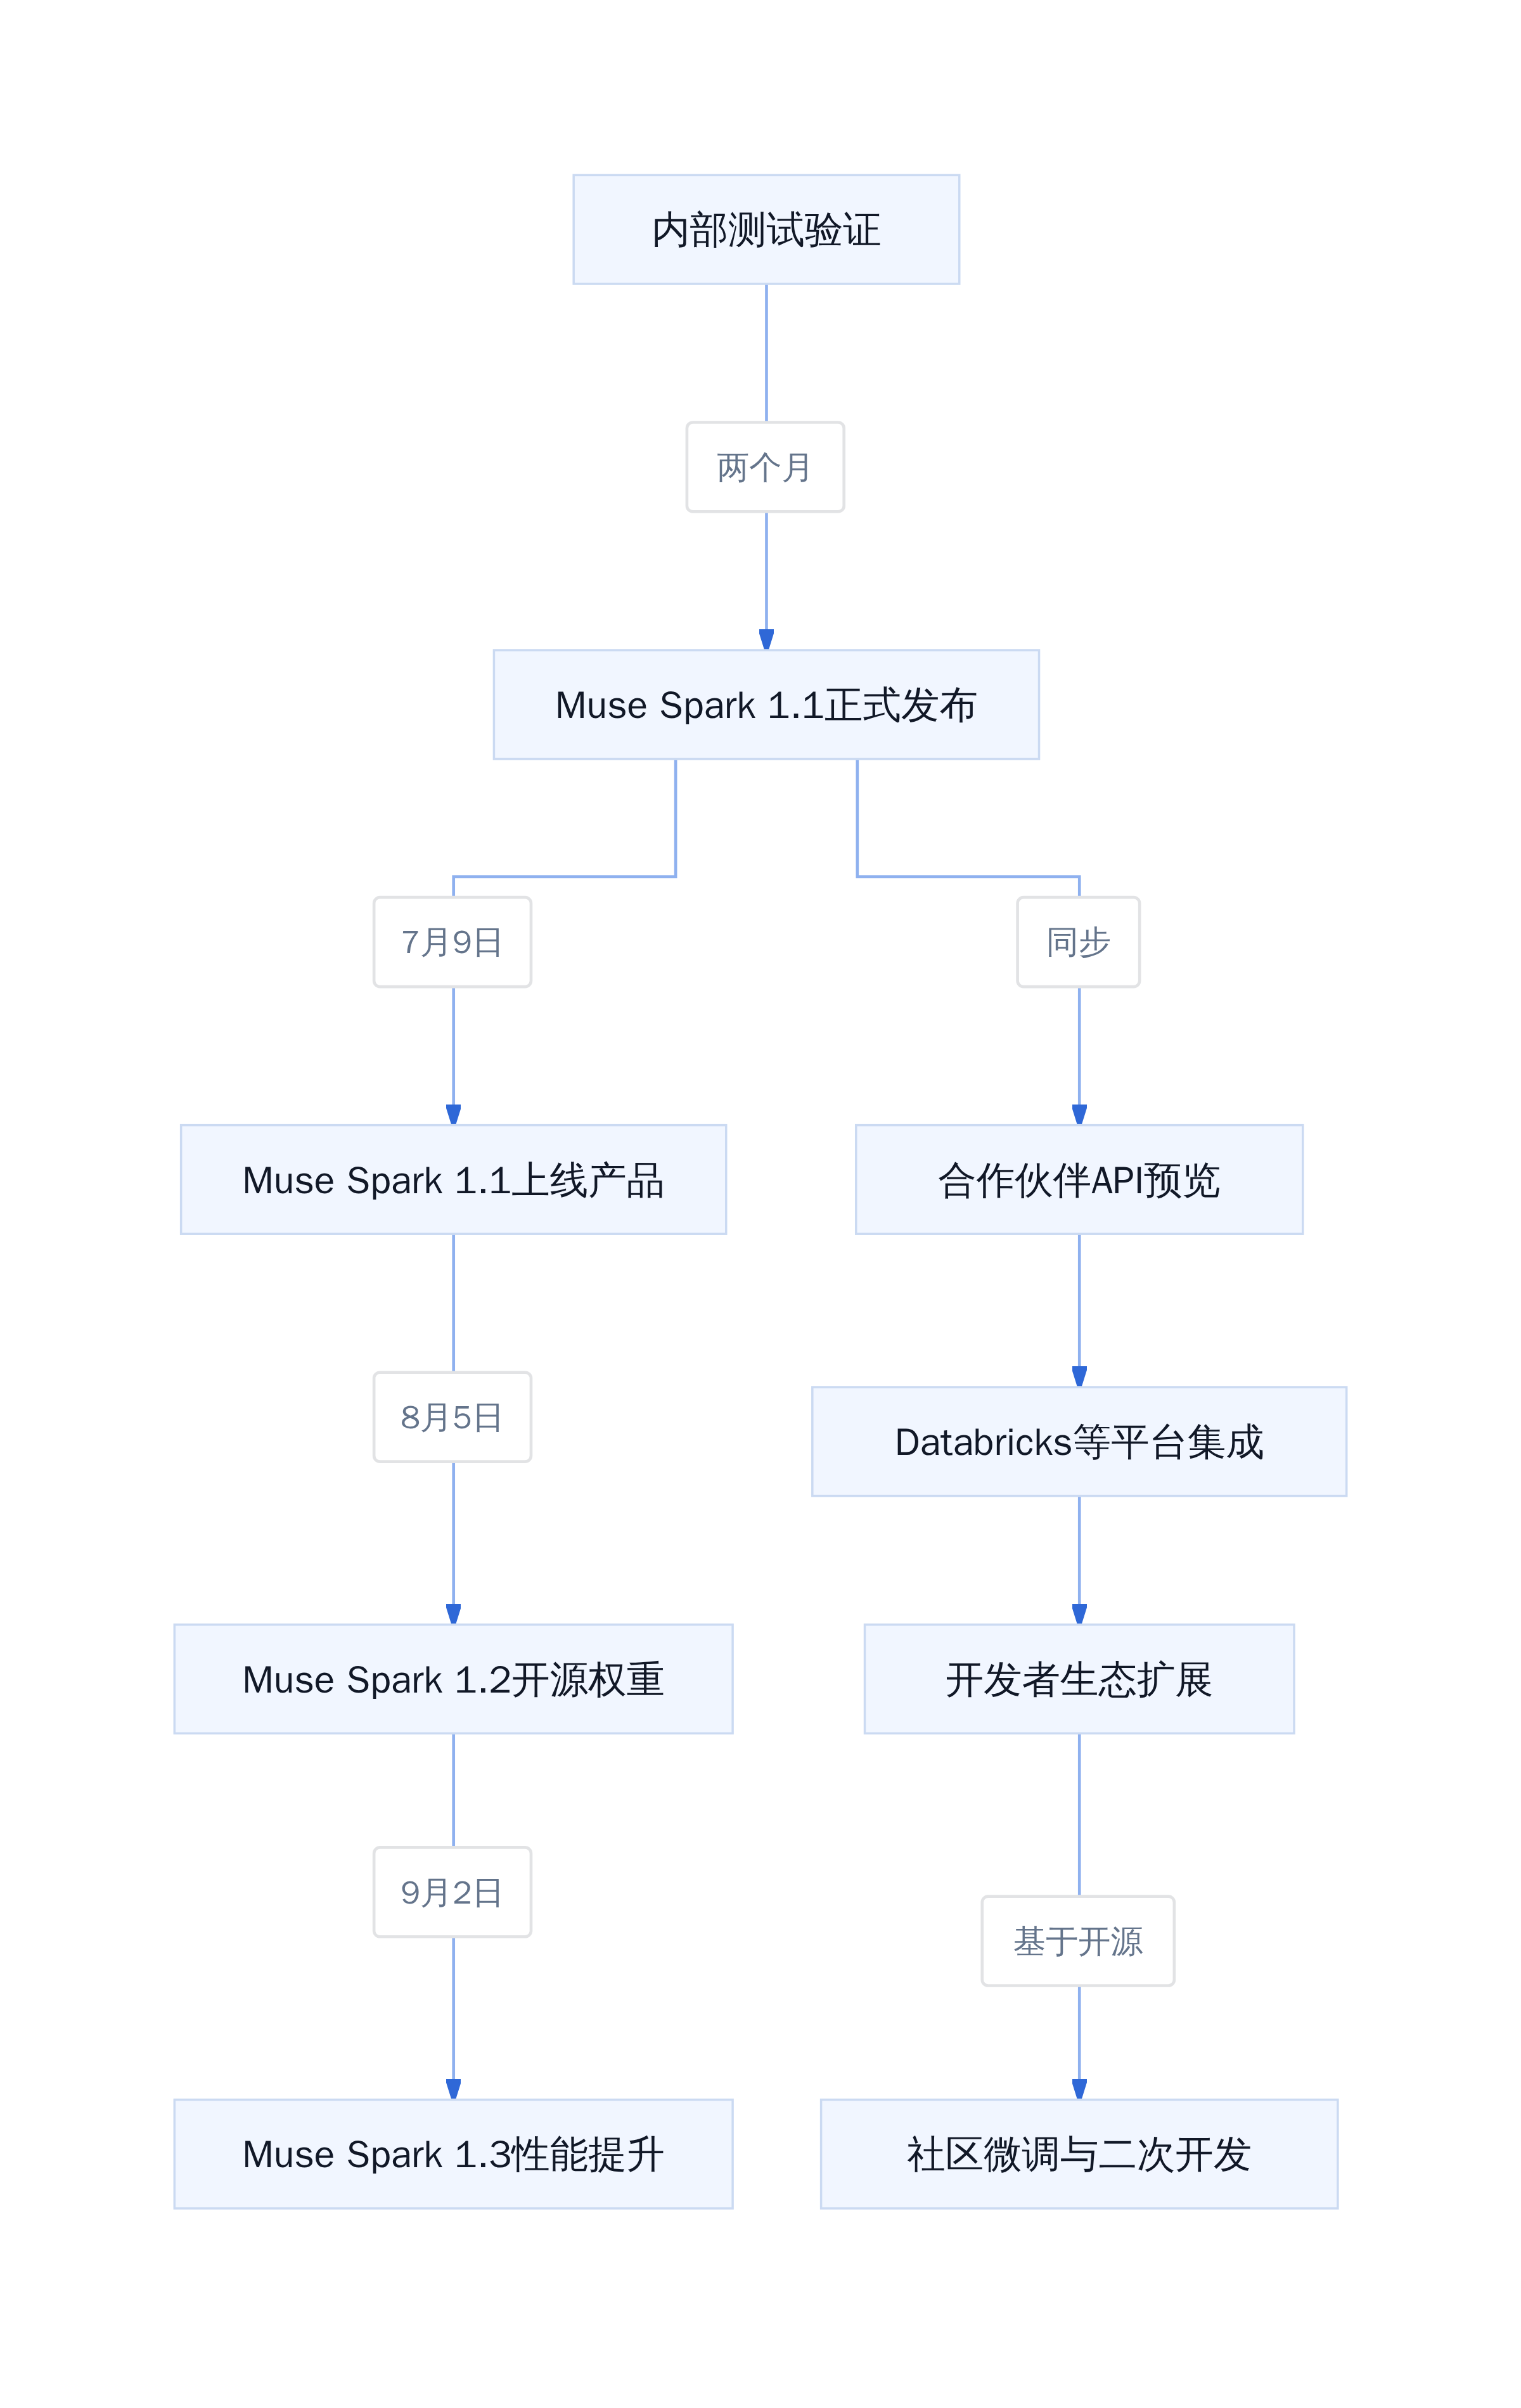
从时间线来看,Muse Spark 1.1于2026年4月8日发布,同年7月9日推出Muse Spark 1.1正式版,随后在8月5日推出Muse Code和Muse Spark 1.2,9月2日发布Muse Spark 1.3。迭代速度相当密集,Meta显然希望用快速发布来验证方向并收集社区反馈。
4.2 API预览与合作伙伴引入的节奏
API开放的节奏同样值得观察。Meta在发布Muse Spark时同步宣布,部分合作夥伴可通过私有API预览通道接入测试,逐步扩大应用范围。
Databricks是最早一批宣布支持Muse Spark的企业平台之一——其Unity AI Gateway提供了一站式模型治理,开发者只需在Unity Catalog中注册一次提供商,即可通过统一的权限、速率限制和安全护栏调用Muse Spark 1.1,同时避免API密钥散落的常见问题。mermaid
Muse Spark产品化路径
这种「内部先用→API预览→开放权重」的三步节奏,是Meta首次在旗舰模型上采取的策略。此前Meta的Llama系列直接开源权重,跳过预览阶段;而OpenAI和Google则完全封锁API接口。Meta选择了一条中间路线——先用内部产品(Meta AI及其旗下产品)打磨体验,再通过有限API验证企业需求,最后用开源权重换取社区护城河。
4.3 对开发者生态的潜在影响
从工程实践的角度看,Muse Spark的落地路径对开发者生态至少产生两个层面的影响。
第一层是成本模型的重构。Muse Spark的默认设计理念是「小型、高效」,而非堆参数。根据eigent.ai的深度分析,Muse Spark 1.3在工程团队协作场景中可以实现工具调用量减少约20%、token开销减少约25%。对于需要大量迭代式工具调用的复杂代码仓库维护任务来说,这两个数字叠加后的成本节省相当可观。
第二层是技术路线的分流。当Meta选择用多代理并行而非单代理延伸思考来扩展推理能力时,它在暗示一种不同的工程哲学:与其让一个模型想得很久(同时承受延迟惩罚),不如让多个代理同时干活(共享延迟、叠加准确率)。这个选择在API经济中会创造新的优化空间——开发者可以根据延迟容忍度和准确率需求,灵活调整并行代理数量,而不是被强制绑定在某一种推理模式中。
但现实约束也不容忽视。多代理并行的核心挑战在于结果的一致性验证与聚合。当16个代理各自给出答案时,如何判断哪些是高质量的、哪些产生了幻觉,需要一个可靠的仲裁机制——这恰是目前业界仍在探索的领域。Meta的Contemplating模式在这个方向上给出了初步答案,但距离生产级的可靠仲裁还有距离。
**可执行判断:**如果你的团队正在评估是否将Muse Spark纳入工程工作流,建议优先从代码审查和单元测试生成两个高ROI场景切入。Muse Spark 1.2的开源权重特性意味着你可以部署私有化版本来保护敏感代码库,配合Muse Code Benchmark上的表现来看,它在编程任务上的投入产出比目前处于较有利的位置。但对于需要极致低延迟的实时交互场景,仍需实测确认其多代理架构的延迟上限是否满足你的SLA要求。
参考文献
[1] Meta發表由超級智慧實驗室開發的首款模型Muse Spark,將直接應用在產品上 | iThome. www.ithome.com.tw/news/[REDAC…] [2] 全流程数学研究智能体发布自主攻克多项长期公开数学难题 - 新闻. news.sciencenet.cn/htmlnews/20… [3] Meta Muse Spark: Technical Deep Dive and Benchmark Analysis. www.eigent.ai/blog/meta-m… [4] Meta Muse Spark:技術深度解析與基準測試分析. www.eigent.ai/zh-TW/blog/… [5] Thomas Scialom, PhD's Post. www.linkedin.com/posts/tscia… [6] muse-spark-safety-and-preparedness-report. ai.meta.com/static-reso… [7] Muse Spark - Wikipedia. en.wikipedia.org/wiki/Muse_S… [8] Introducing Muse Spark 1.1. ai.meta.com/blog/introd…
延伸入口
- 原文归档:tobemagic.github.io/ai-magician…
- 公众号:计算机魔术师