一、做的是啥东西,有啥用
工作以来我一直在数据相关领域,给业务做过数据分析,也建过BI系统。上一代BI的典型特征是由IT做好指标、建好看板,然后业务用户在预定的范围内进行查询;后面有了ChatBI,但是用户自由度仍然有限,一个关键限制是传统BI都是独立应用,很难融入用户各种工作流程。
而在Agent时代,用户应该以Agent作为入口,应用和数据都是原子能力,由用户或者其Agent来决定如何分析数据、组织流程。基于这个想法,我做了一个轻量化的数据库语义网关 DatI (Data Intelligence): 只需接入数据库,配置语义元数据,发布为MCP服务,接下来就完全由用户决定如何使用它。
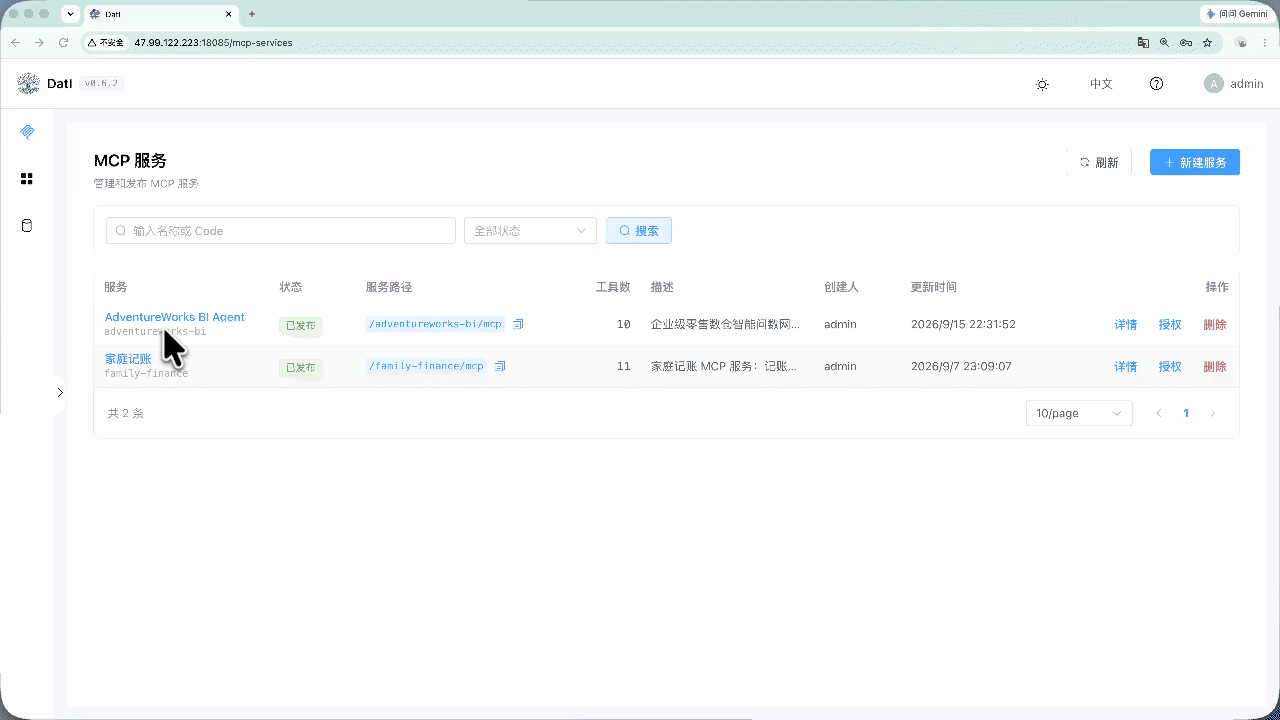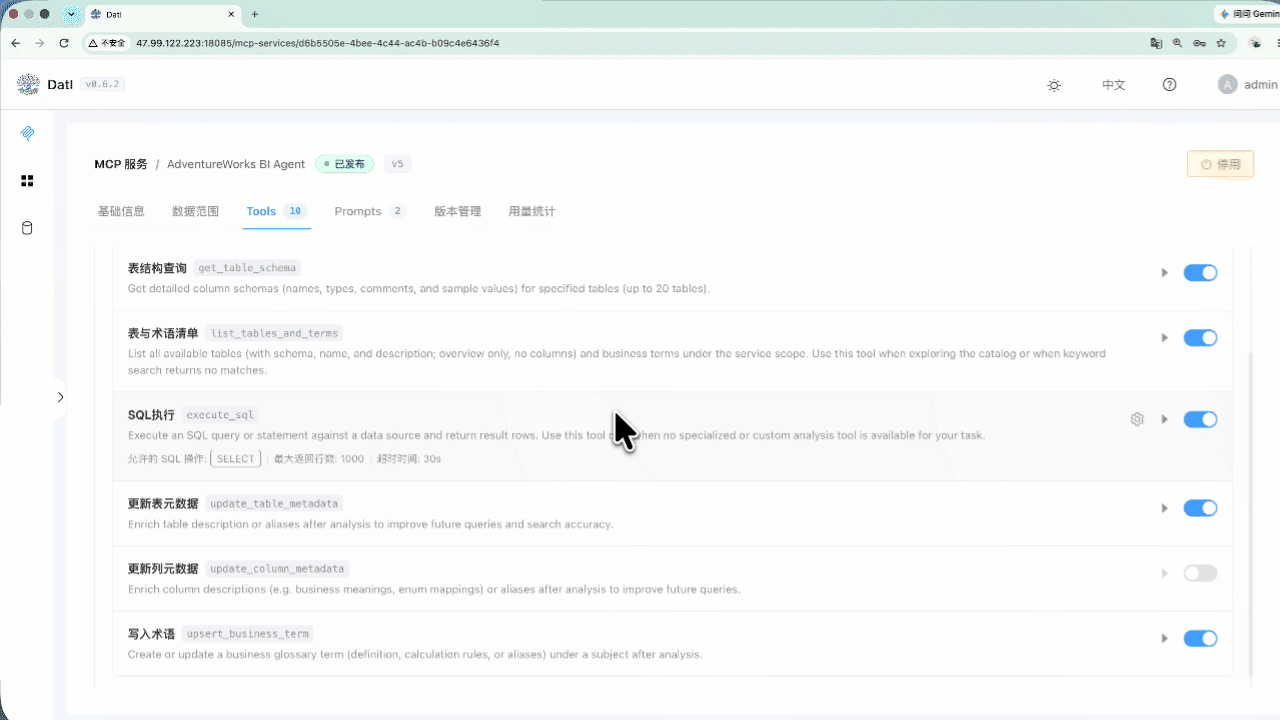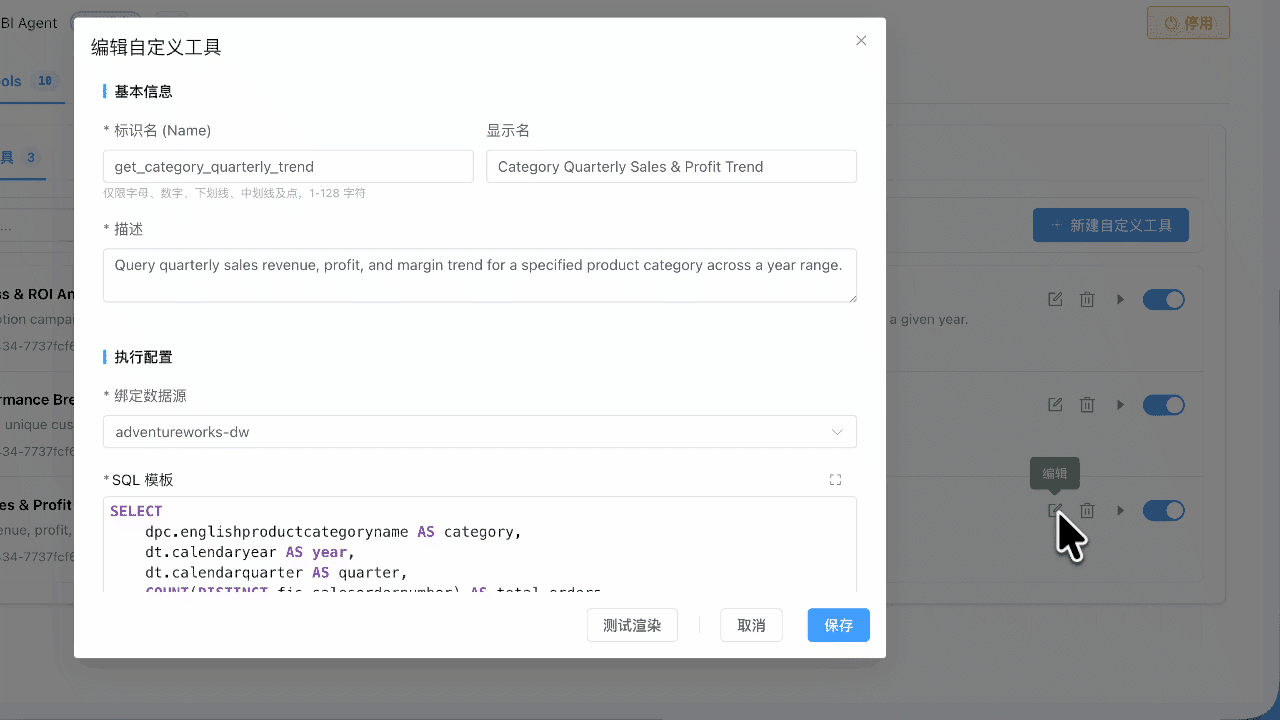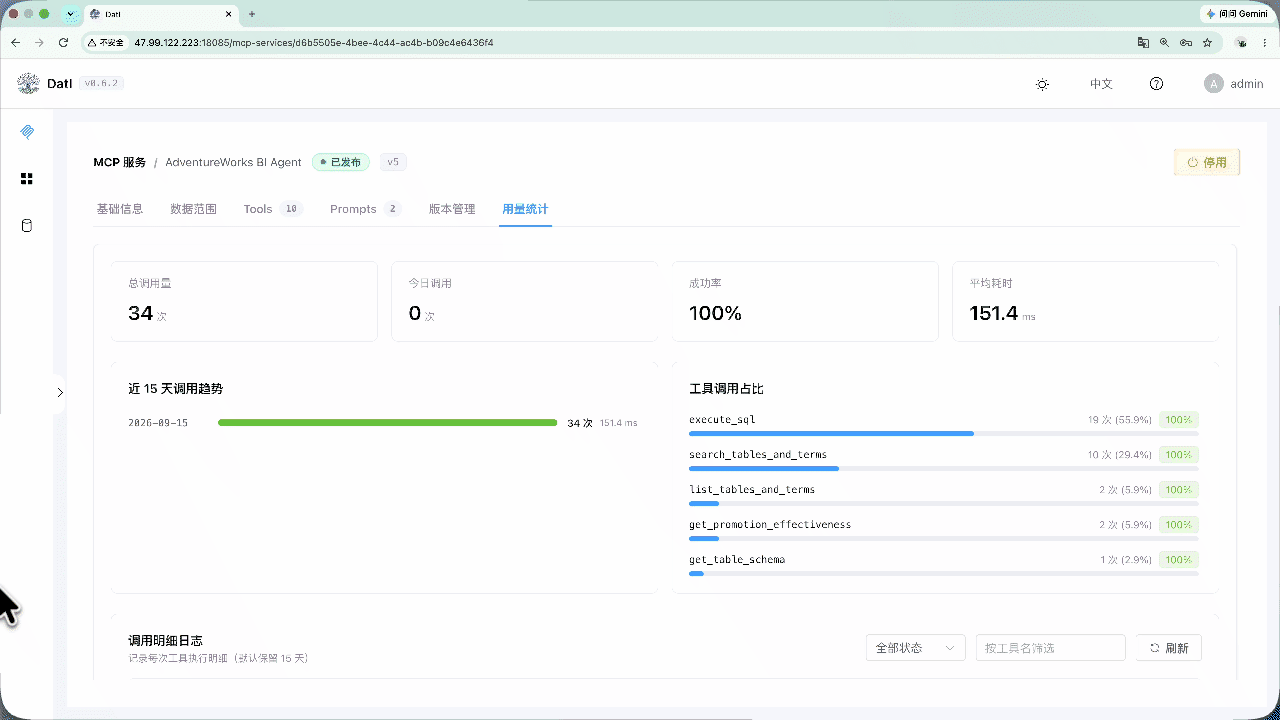
下面是一个数据分析的例子:
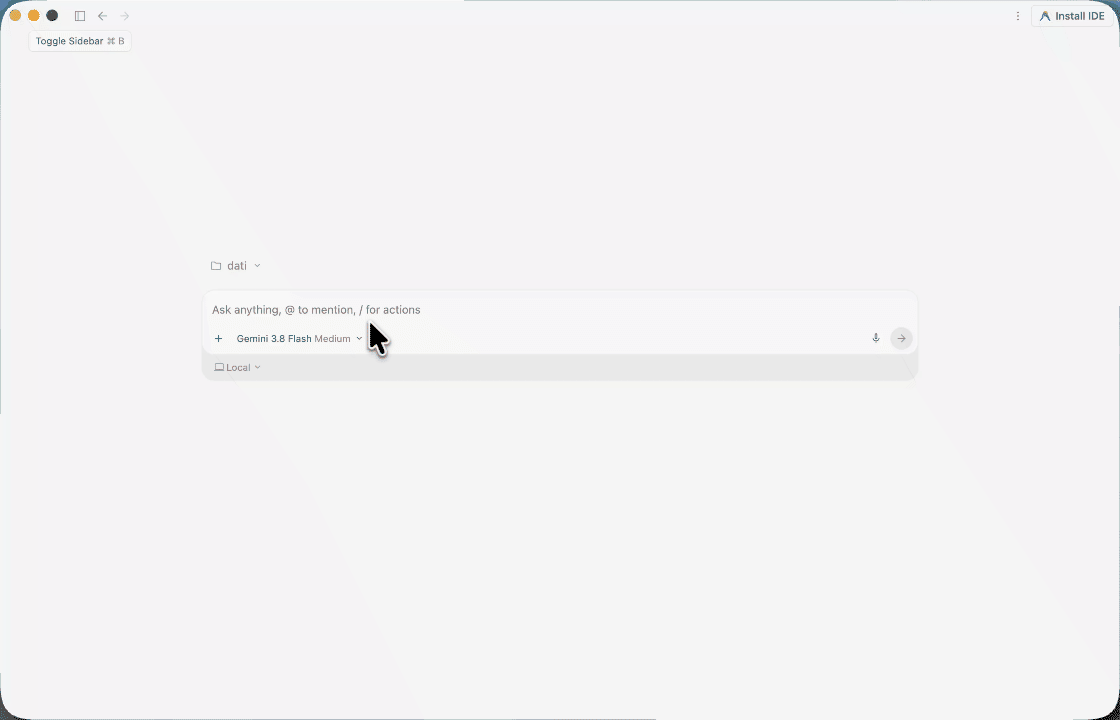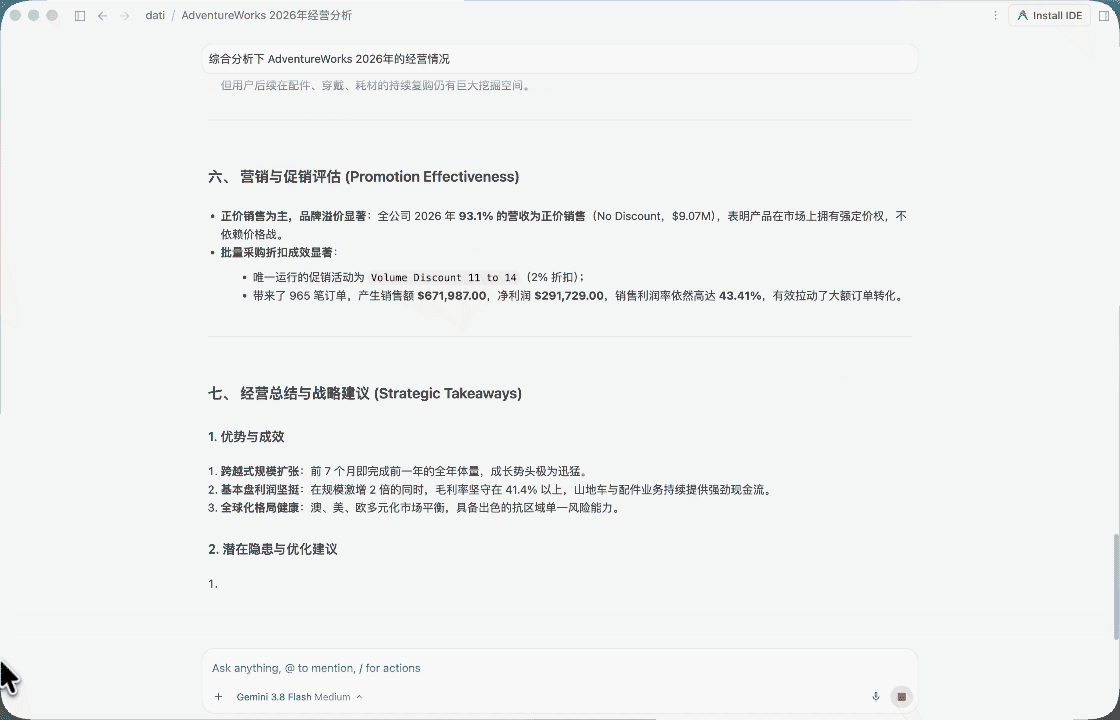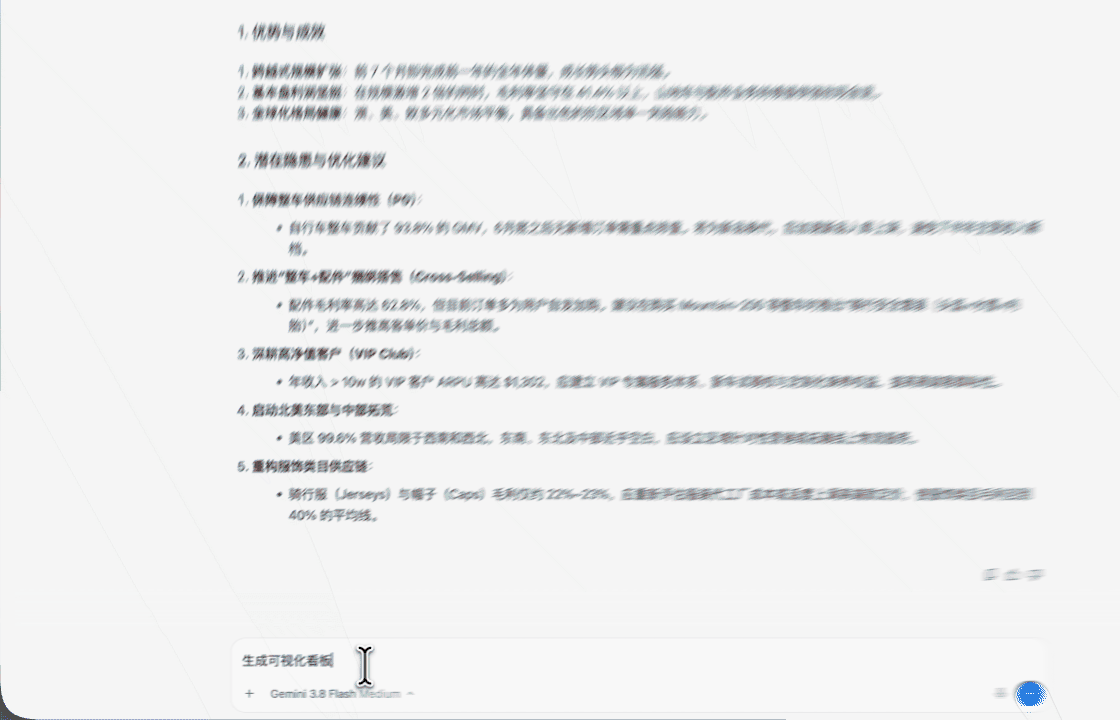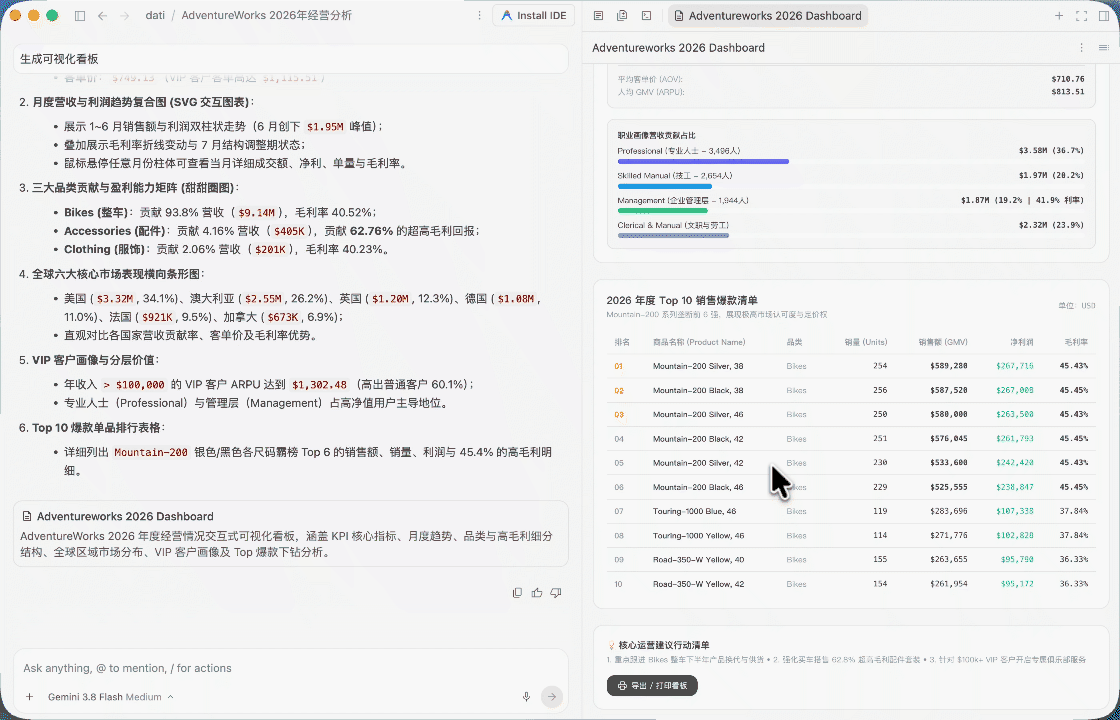
现有产品中定位类似的有 DBHub 和 MCP Toolbox,但是它们更多的是本地工具,在企业内使用,缺乏安全管控与语义信息。当前项目已开源 github.com/yimindev/da… ,感兴趣的话可以进一步了解,这里我们聊聊感受和折腾过程。
二、为啥要在业余时间折腾这个
核心动机就是 焦虑,一方面,近些时间AI编程的爆发式发展,作为开发者,会有非常大的不安感,主动拥抱它、并利用它来完成交付一个东西,能让自己可以稍微踏实点。
另一方面,日常工作中个人都是只负责一个小部分,很多时候缺乏挑战与成就感,会焦虑自身没有足够的成长,难以实现自身的价值。
而把它作为一个纯粹的业余个人项目,最大的好处是拥有100%的自主权,可以聚焦在真正对用户有价值的特性,而不用过多考虑商业价值、团队组织诉求等。
三、AI编程实录与踩坑总结
标题说花了大半年,实际项目从去年8月就启动了,算下来断断续续一年多了。去年靠古法编程,进展较慢,再加上拖延症,后来有一段时间就停滞了。直到今年采用Coding Agent,效率极大提升,才一鼓作气把东西做完整。
分享一下真实的模型花销与各工具体验:
- 模型上我的选型标准主要是便宜、不折腾:
- Minimax 2.5/2.7 (3-4月份,总花费 55元):体验尚可,相比古法编程效率还是大幅提升,但后来 review 发现不少暗坑
- Kimi 2.6 (5月份,总花费 99元):看中其多模态能力,想把前端做得精致点,实际体验中规中矩,并没有太惊艳
- Deepseek V4/V4.1 (6月至今,主力模型,总花费 201.2 元):按需计费对于业余项目比较划算,使用体验也不错;不过有时候感觉有点啰嗦
- Gemini 3.7/3.8 (8月至今间断使用,淘宝 52元 包年,最划算):最大特点就是快,肉眼可见跟其他模型不是一个速度;另外就是前端能力强,一些样式可以做得挺精致
- Coding Agent 体验:
- opencode:早期助力,成熟度最高、最稳定的开源选择
- pi:简单、干净、透明,上下文传递链路直观;使用/tree 可以省Token
- Antigravity:Gemini默认Agent,习惯TUI后,开始还不适应GUI,不过用多了后感觉GUI信息密度,操作友好上也有不少优势
- AI coding 策略:
- 坚持Review:虽然不少行业大佬有说 “不用看代码,把控架构即可”,但是我个人还是会审视代码,这样心里更有底,另外也确实一直能找到可改进的地方
- 自动端到端(E2E)测试:对开发效率和质量提升最多的一个经验就是让Agent自己执行端到端测试,相比UT,用例可读性高,而且能真正把流程串起来
四、欢迎探讨
相比开发,推广实际更难,对Data Agent有兴趣的可以关注下 DatI (Github: github.com/yimindev/da… )。对开源项目、AI Coding等方面有兴趣的也欢迎一起讨论!