Qwen-Image-2.1 是通义千问 9 月 20 日放出来的开源图像模型,权重能直接下载,生成组件 7B,官方默认出图 2048×2048。
我这边一直想把生图接到自己的 Agent 里,走云端接口按张计费,量一上来账就不好看,于是琢磨着把它放到本地那台 3060 上自己跑。
这次的目标不只是出图,还要让它常驻成一套能被程序调用的 HTTP 服务。今天把部署的过程和踩到的坑整理了一下,感兴趣的可以接着往下看。
一、部署环境
先看这台机器的家底。
| 项目 | 配置 |
|---|---|
| 操作系统 | Windows 64 位 |
| 处理器 | Intel Core i5-13490F |
| 内存 | 32GB |
| 显卡 | NVIDIA GeForce RTX 3060 |
| 显存 | 12GB |
| 推理后端 | CUDA 12 |
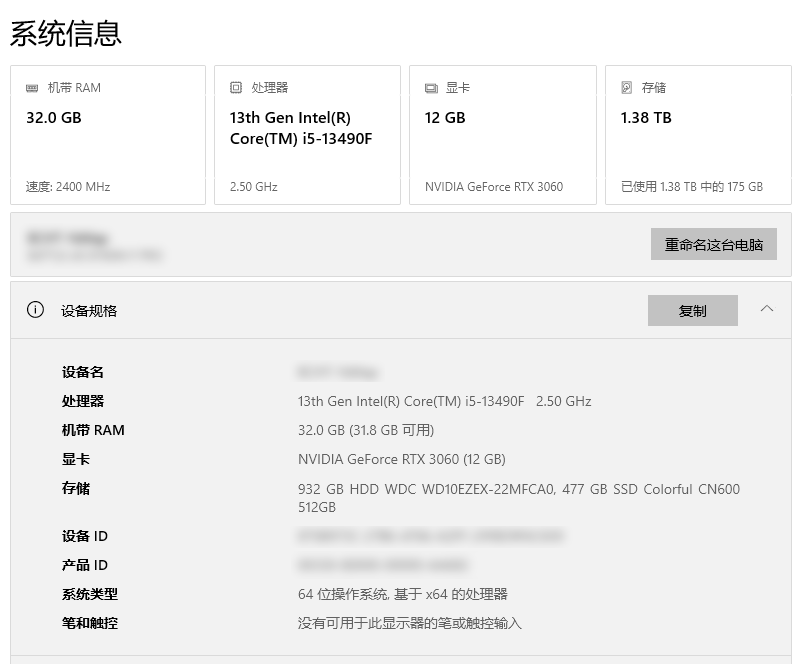
图:这台机器的实际配置
整台机器里最紧的就是那张 12GB 的卡。官方 BF16 权重全驻留要 33GB 显存起步,光文本编码器就比生成模型本身还大,这块卡连门都进不去。
**这次部署的目标是让 12GB 显存跑通并稳定出图,不是把权重全塞进显卡。**所以模型选型,我走的就是量化这条路。
二、工具选型
本地运行生图模型,我找了几个方案:
llama.cpp:运行的是 Qwen3.8、DeepSeek 这类语言模型,虽然用的都是 GGUF 是模型文件格式,但不代表所有 GGUF 都能通过 llama.cpp 运行。
ComfyUI:生态最全,界面点几下就能出图,代价是节点、插件和 Python 环境整套都得装齐,要求比较高。
stable-diffusion.cpp:一个压缩包解压就能用,自带命令行和一个网页界面,还能直接对外开 HTTP 服务。
我最后选的是 stable-diffusion.cpp,因为这次要的是能被程序调用的服务端口。
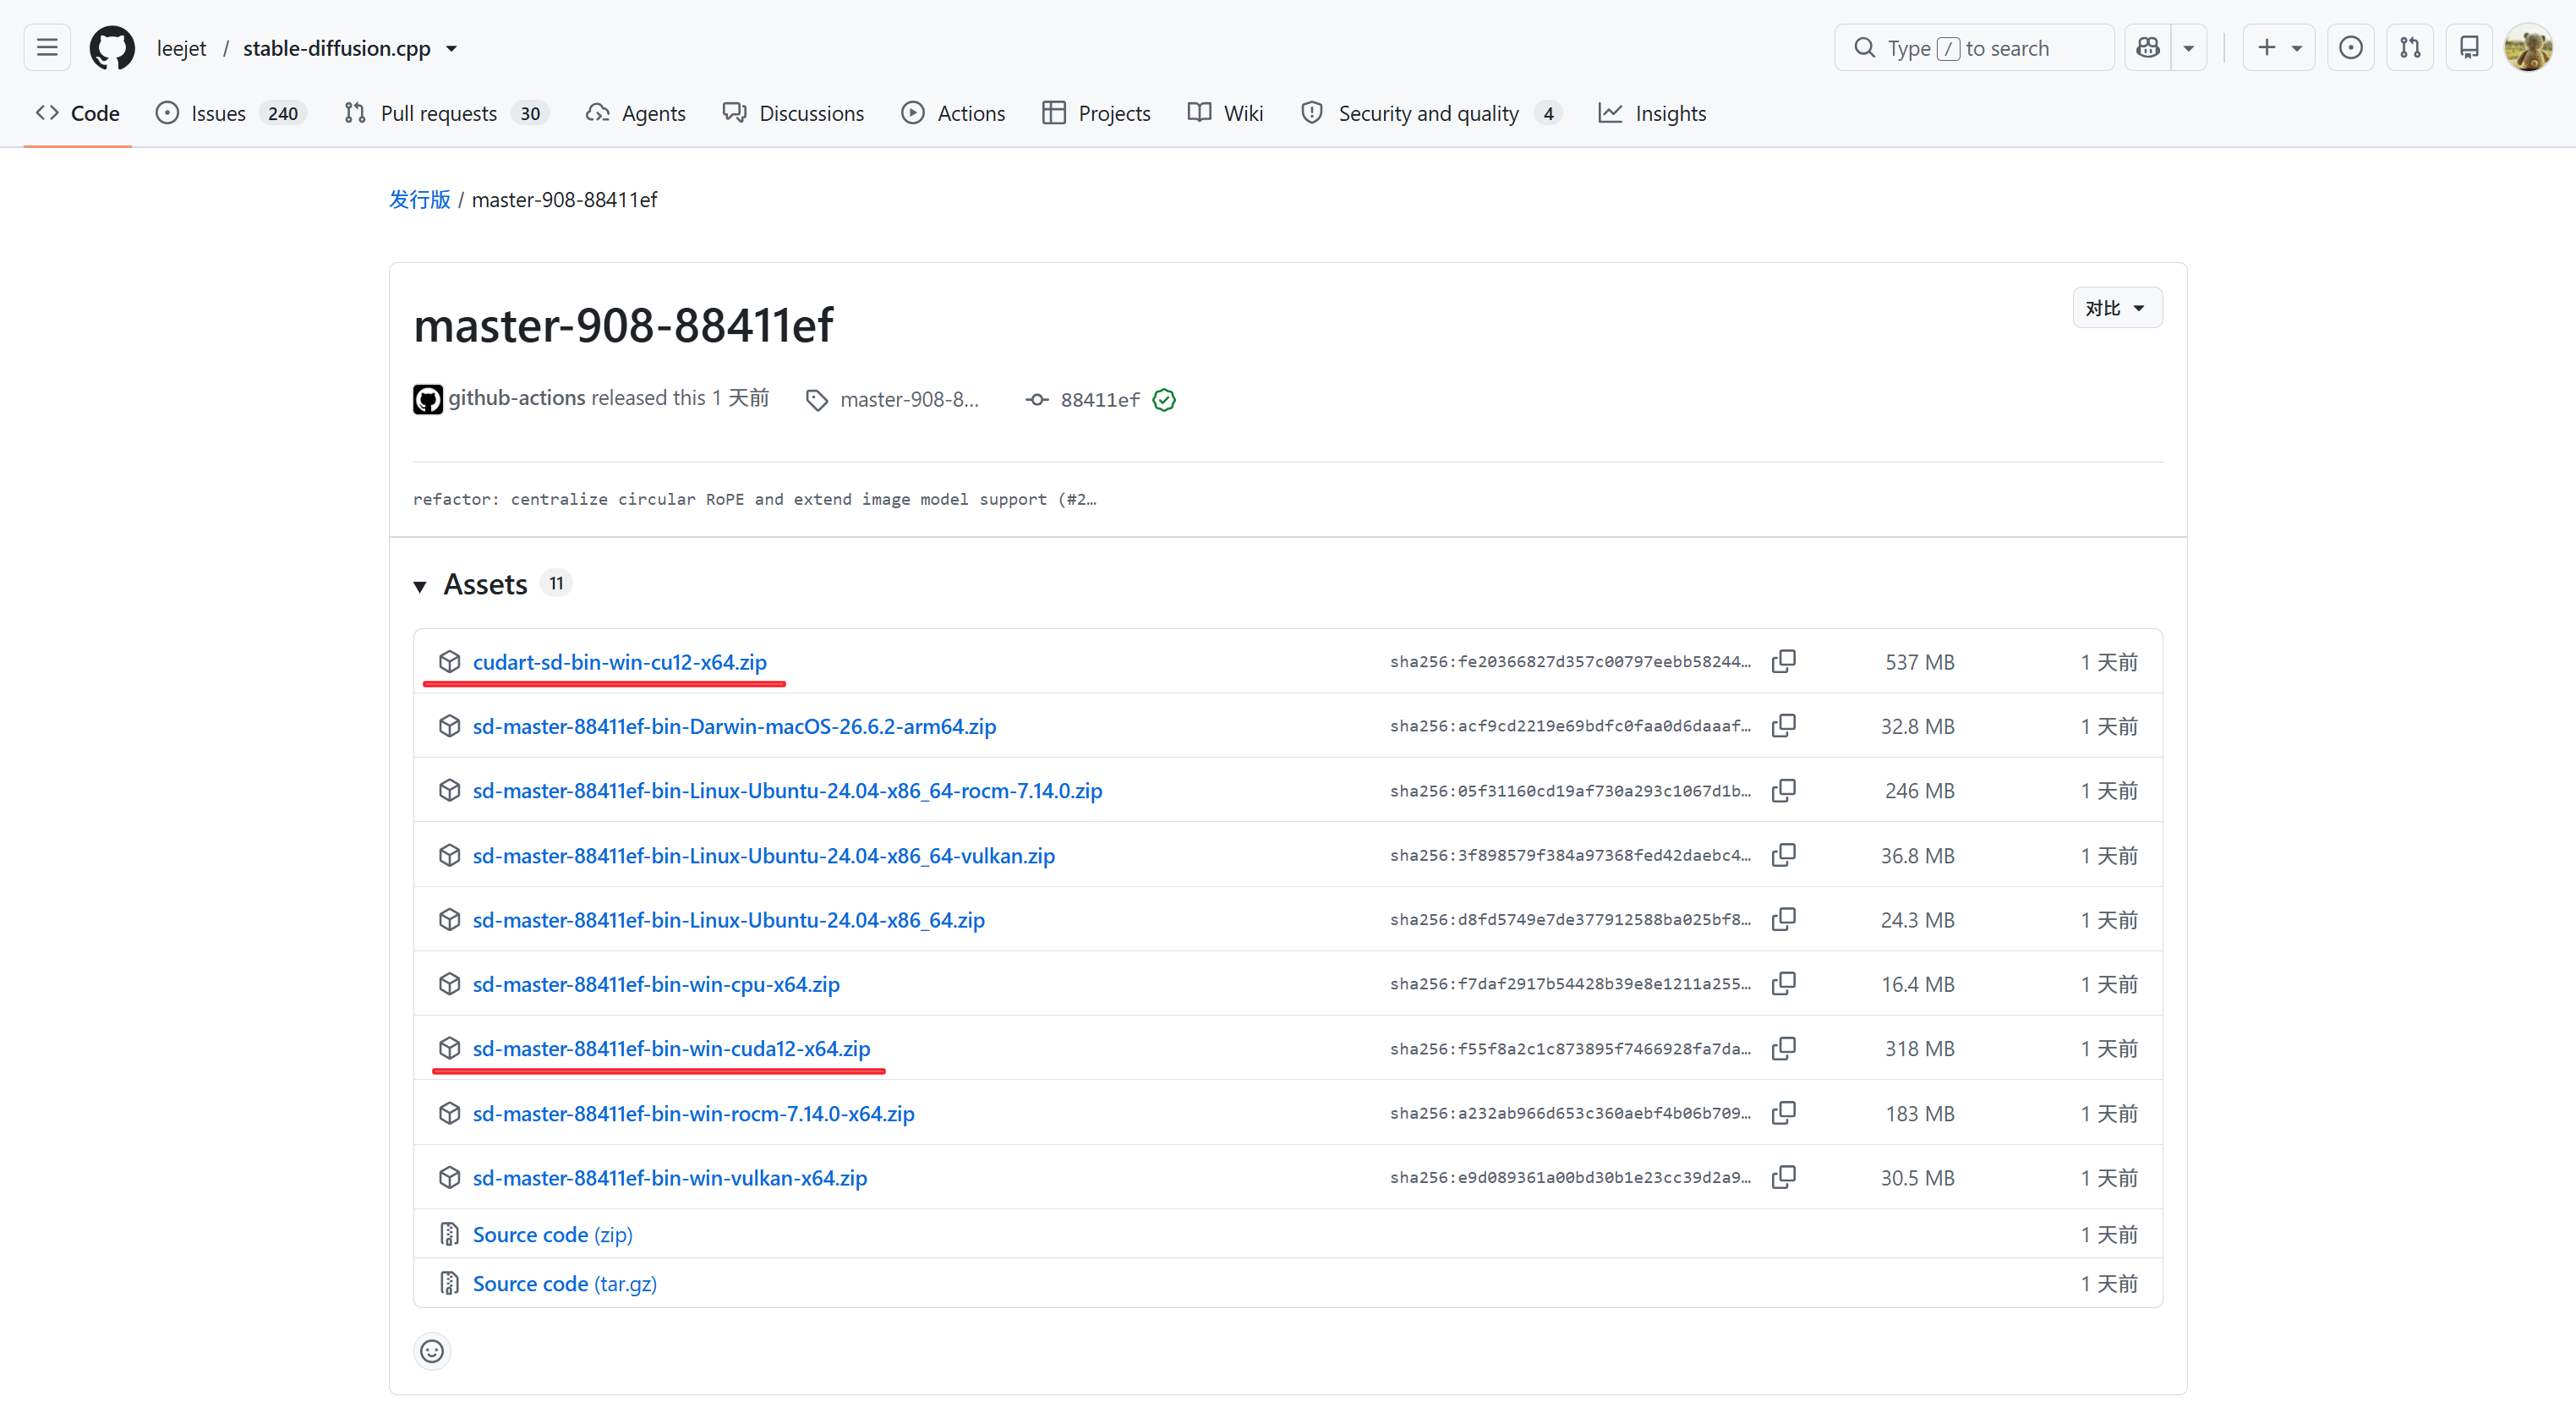
图:官方 release 里挑对应后端的包
我下的是 sd-master-88411ef-bin-win-cuda12-x64.zip,318MB,解压出来的文件夹是 sd-88411ef-bin-win-cuda12-x64。上面那个带 cudart 的是 CUDA 运行时依赖,机器上有没有装 CUDA,决定你要不要一起下。
三、模型选型
ModelScope 上的 Abiray 把 Qwen-Image-2.1 转成了 GGUF,模型很全,包含了 Q3 - Q8 的量化模型文件。
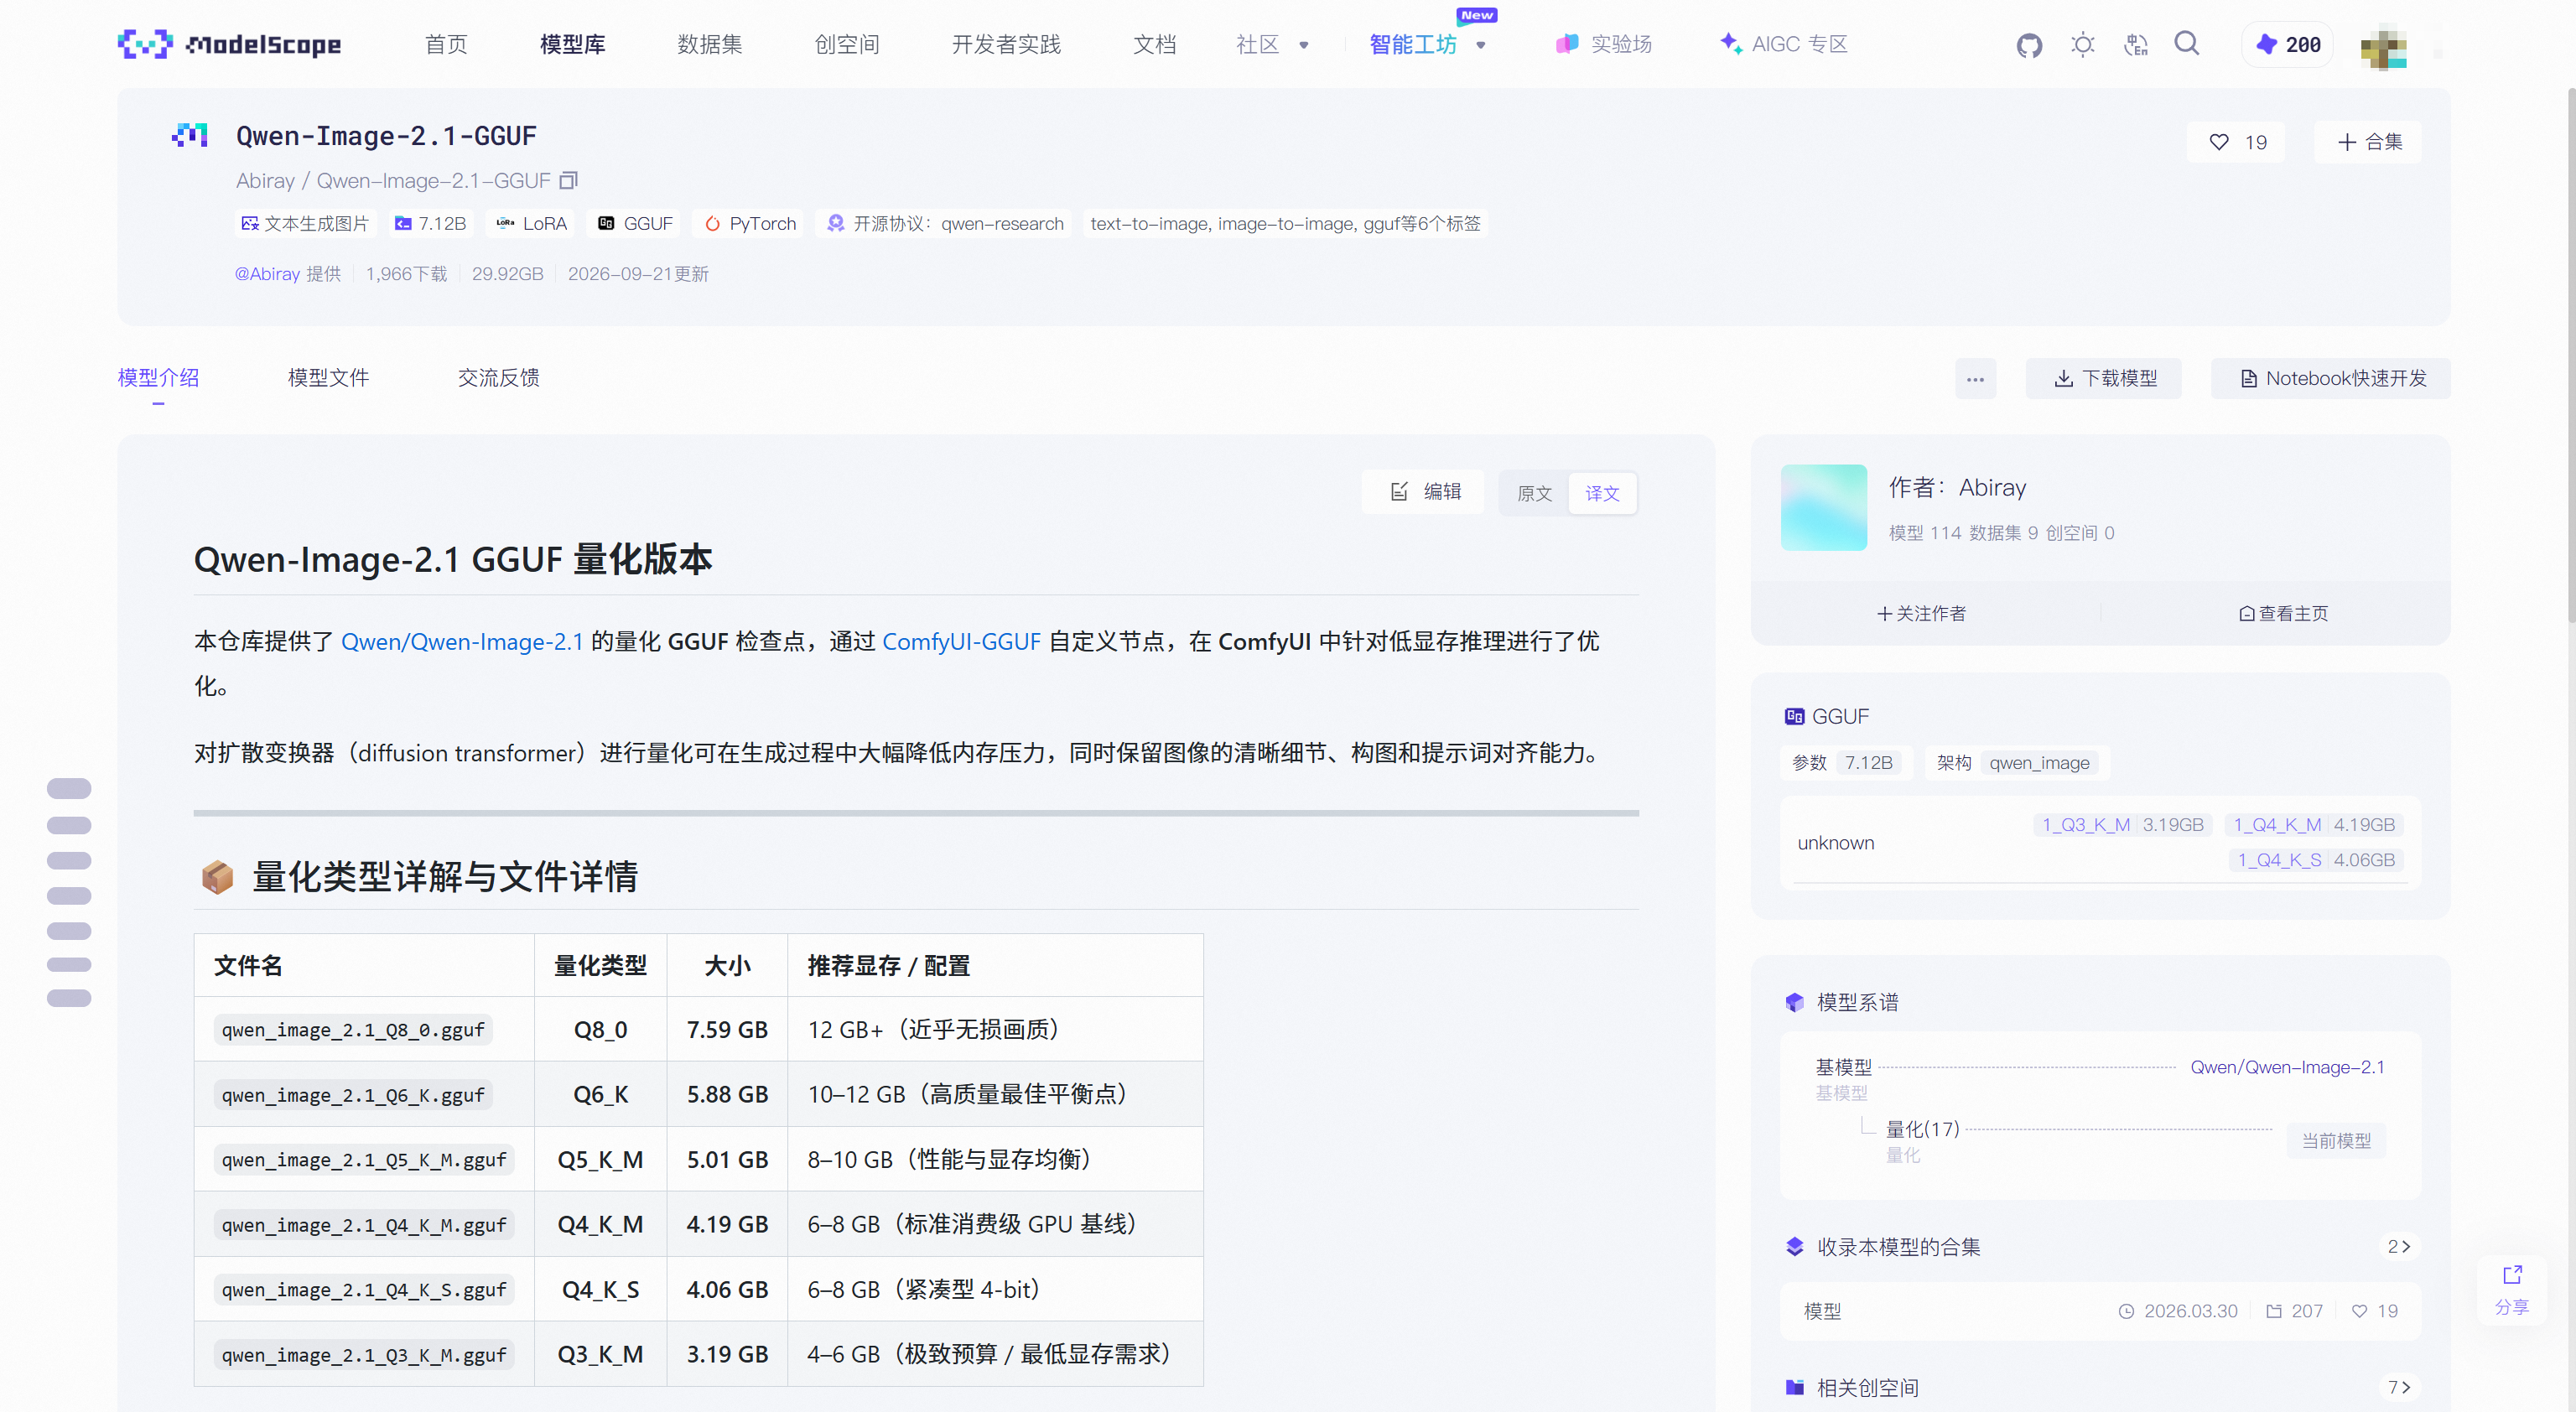
图:量化档位与建议显存对照
我一开始想上 Q6_K,5.88GB,建议显存 10-12GB,看着正好卡在这块卡的上限。
除了主模型之外,这台机器还要同时装下 8B 的文本编码器、mmproj 和 VAE,这几样才是容易漏算的部分,算了一下发现显存不够用。
最后选了 Q4_K_M,4.19GB,建议显存 6-8GB,给其他组件腾出了一截空间。这一档是拿画质余量换来的显存。
四、下载与目录
Qwen-Image-2.1 想跑起来要四个文件,少一个都起不来。
| 文件 | 作用 | 精度 |
|---|---|---|
| qwen_image_2.1_Q4_K_M.gguf | 图片生成主干 | Q4_K_M |
| Qwen3VL-8B-Instruct-Q4_K_M.gguf | 文本编码器,读懂提示词 | Q4_K_M |
| mmproj-Qwen3VL-8B-Instruct-Q8_0.gguf | 视觉投影,让编码器能读图 | Q8_0 |
| qwen_image_2.1_vae_bf16.safetensors | VAE,把潜变量还原成图 | BF16 |
下载我用的是 ModelScope 的命令行工具,进到 models 目录里直接拉:
modelscope download --model Abiray/Qwen-Image-2.1-GGUF qwen_image_2.1_Q4_K_M.gguf --local_dir ./Qwen-Image-2.1

modelscope download --model Qwen/Qwen3-VL-8B-Instruct-GGUF Qwen3VL-8B-Instruct-Q4_K_M.gguf --local_dir ./Qwen3-VL-8B-Instruct

modelscope download --model Qwen/Qwen3-VL-8B-Instruct-GGUF mmproj-Qwen3VL-8B-Instruct-Q8_0.gguf --local_dir ./Qwen3-VL-8B-Instruct
--local_dir 后面跟的是落盘目录,写相对路径会落到当前所在的文件夹,所以下之前先切到 models 里,别在根目录直接下。
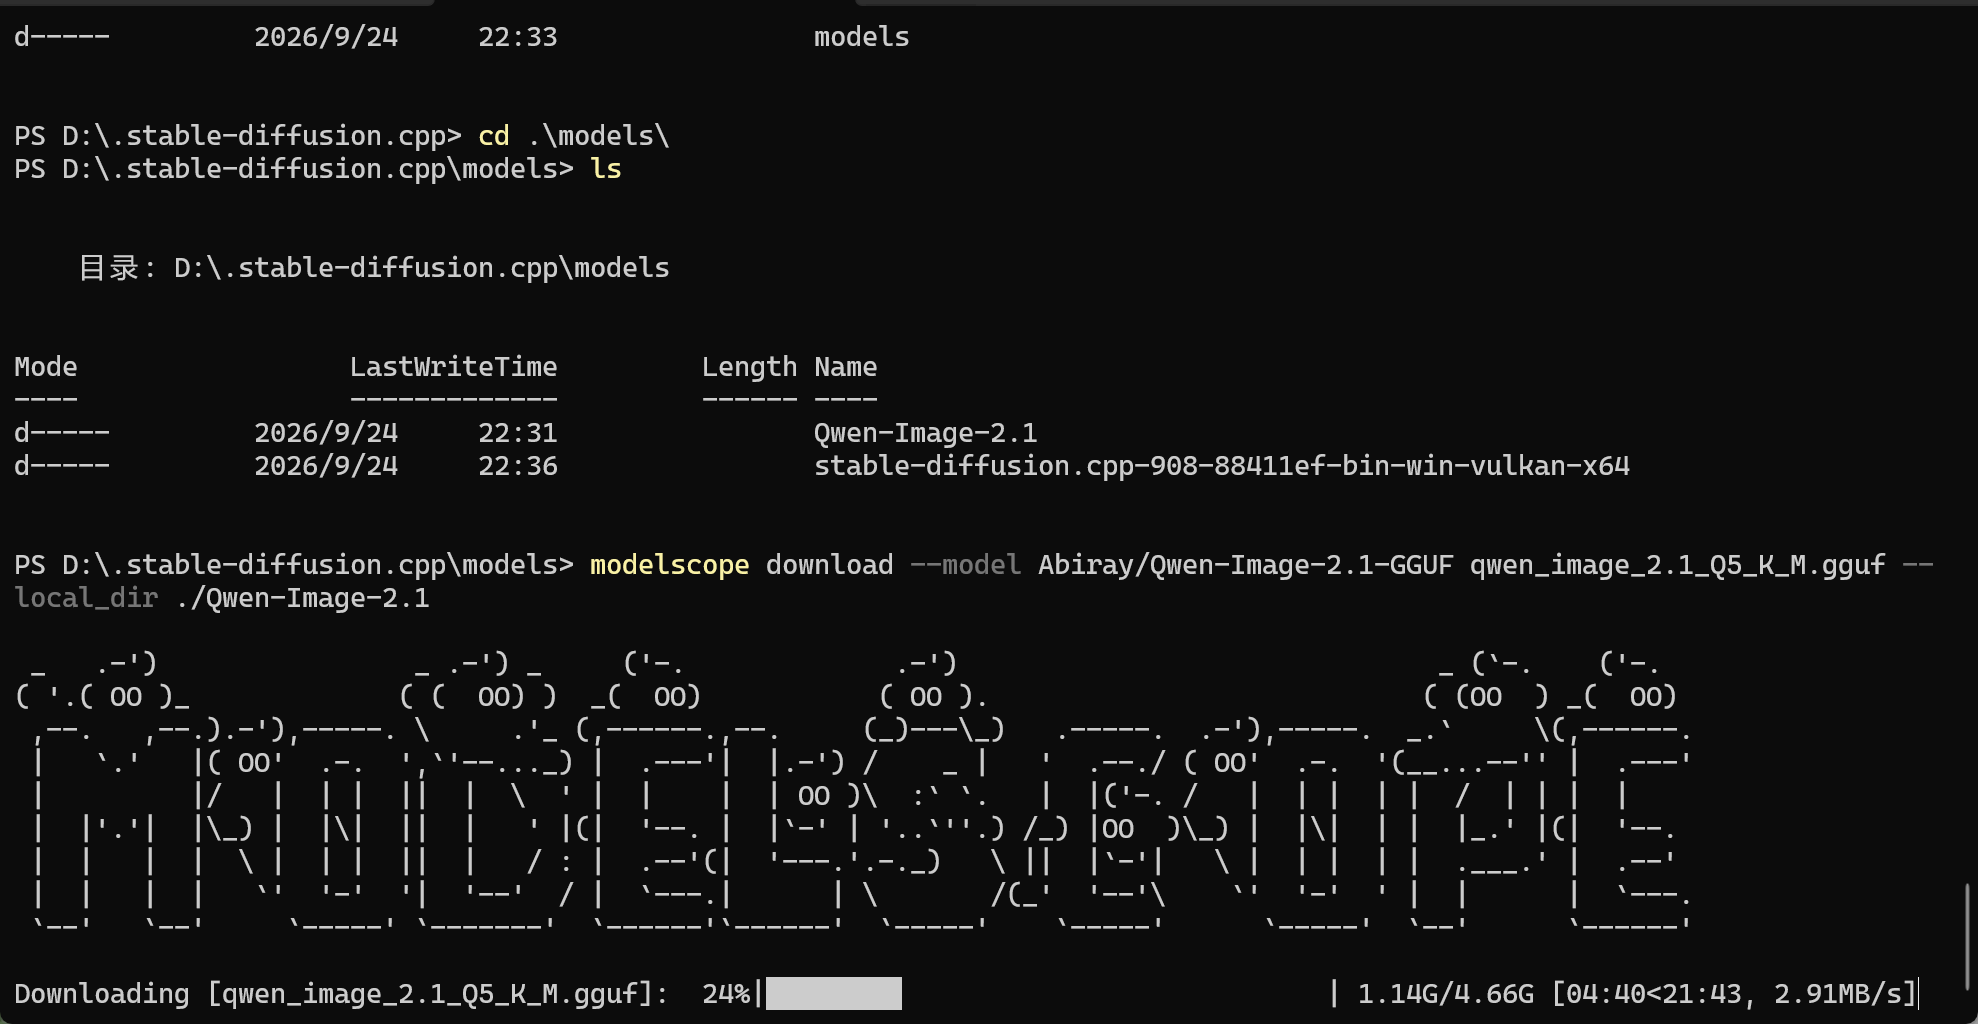
图:命令行下载主模型
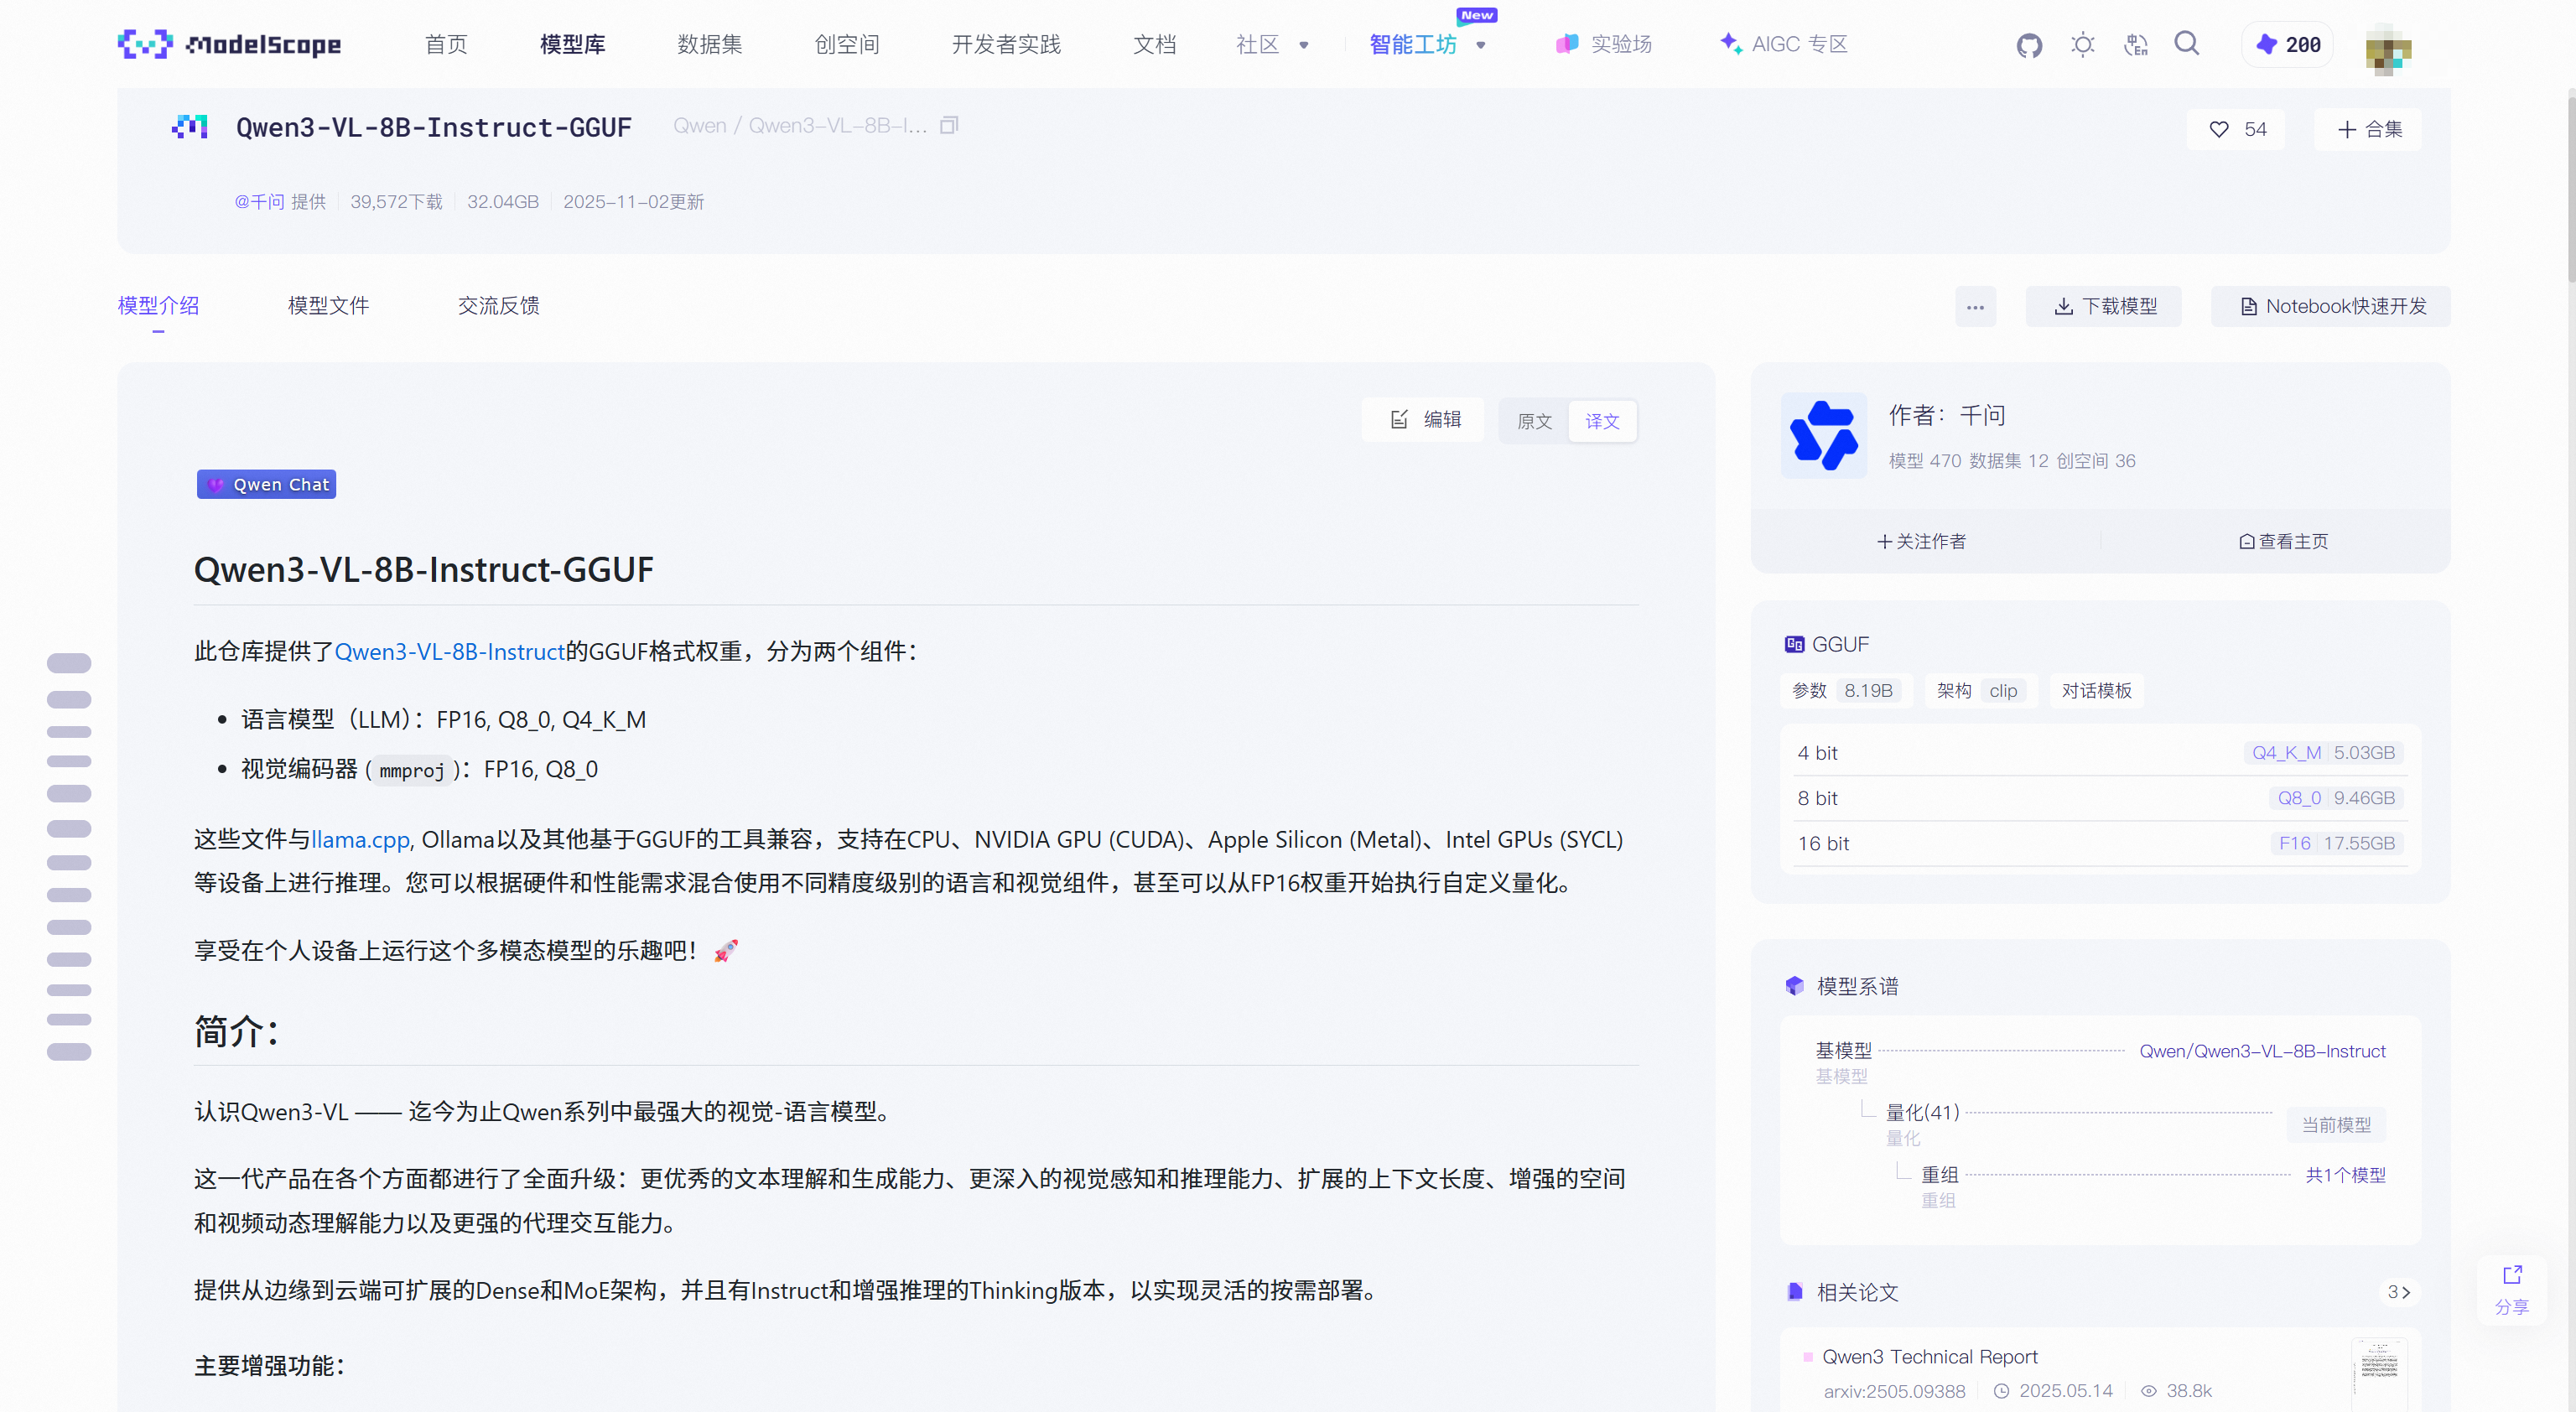
图:文本编码器来自 Qwen3-VL 的 GGUF 仓库
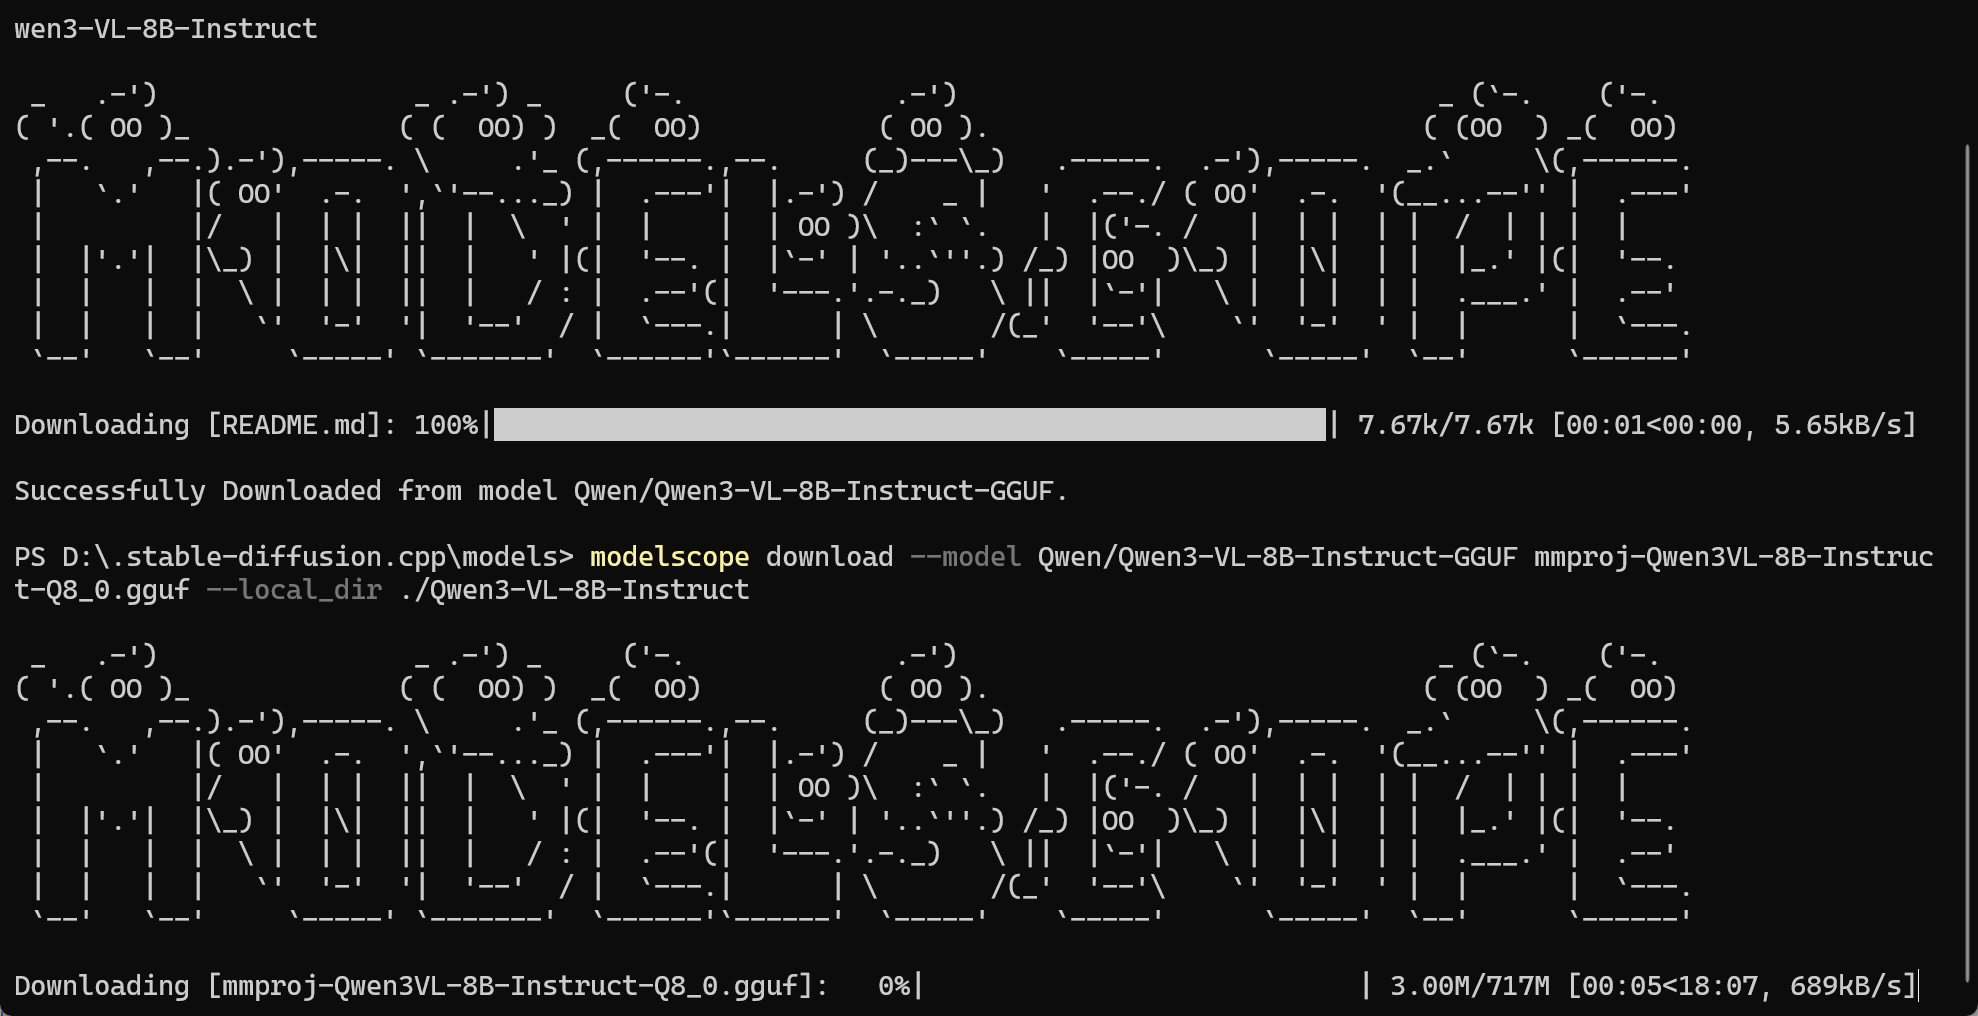
图:mmproj 下载中
VAE 在官方模型仓库里,文件名 qwen_image_2.1_vae_bf16.safetensors,单独放一个 vae 子目录,名字不改。
五、启动脚本
程序目录和模型目录我特意分开摆,稳定运行之后结构是这个样子。
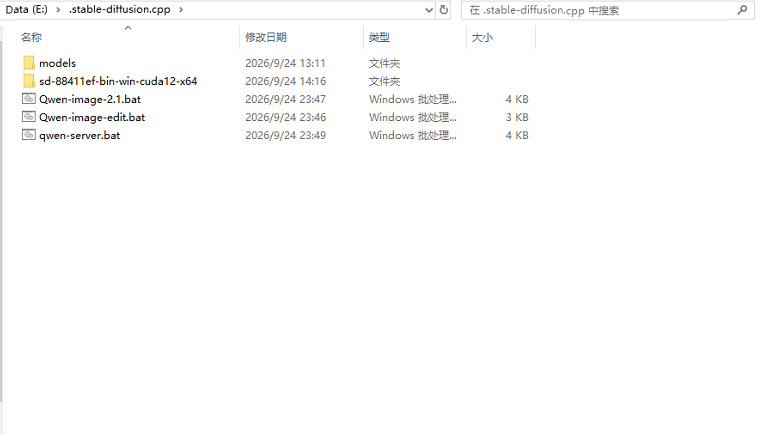
图:部署根目录的文件结构
Qwen-image-2.1.bat 是测试生图用的脚本,Qwen-image-edit.bat 是用来测试改图用的脚本,都是测试阶段用的,正在对外提供服务器的是 qwen-server.bat ,脚本命令如下:
E:\.stable-diffusion.cpp\
├── sd-88411ef-bin-win-cuda12-x64\   程序,含 sd-server.exe
└── models\
    ├── Qwen-Image-2.1\
    │   ├── qwen_image_2.1_Q4_K_M.gguf
    │   └── vae\qwen_image_2.1_vae_bf16.safetensors
    └── Qwen3-VL-8B-Instruct\
        ├── Qwen3VL-8B-Instruct-Q4_K_M.gguf
        └── mmproj-Qwen3VL-8B-Instruct-Q8_0.gguf
这么摆的好处是升级程序的时候不用挪几十 GB 的模型文件,换个程序文件夹就行。
真正启动服务的是脚本最后那一段:
@echo off
chcp 65001 >nul
title Qwen-Image-2.1 API Server

REM ============================================================
REM Qwen-Image-2.1 API Server
REM stable-diffusion.cpp commit: 88411ef
REM GPU: RTX 3060 12GB
REM ============================================================

REM ===== Root =====
set "ROOT=E:\.stable-diffusion.cpp"

REM ===== stable-diffusion.cpp =====
set "SD_DIR=%ROOT%\sd-88411ef-bin-win-cuda12-x64"

REM ===== Qwen-Image-2.1 =====
set "DIFFUSION_MODEL=%ROOT%\models\Qwen-Image-2.1\qwen_image_2.1_Q4_K_M.gguf"

REM ===== Qwen3-VL =====
set "LLM_MODEL=%ROOT%\models\Qwen3-VL-8B-Instruct\Qwen3VL-8B-Instruct-Q4_K_M.gguf"

set "LLM_VISION=%ROOT%\models\Qwen3-VL-8B-Instruct\mmproj-Qwen3VL-8B-Instruct-Q8_0.gguf"

REM ===== VAE =====
set "VAE_MODEL=%ROOT%\models\Qwen-Image-2.1\vae\qwen_image_2.1_vae_bf16.safetensors"

REM ============================================================
REM Server
REM 0.0.0.0 = Allow LAN access
REM ============================================================

set "LISTEN_IP=0.0.0.0"
set "LISTEN_PORT=1234"

REM ============================================================
REM Check files
REM ============================================================

echo.
echo ============================================================
echo   Checking files...
echo ============================================================
echo.

if not exist "%SD_DIR%\sd-server.exe" (
    echo [ERROR] sd-server.exe not found:
    echo %SD_DIR%\sd-server.exe
    pause
    exit /b 1
)

if not exist "%DIFFUSION_MODEL%" (
    echo [ERROR] Diffusion model not found:
    echo %DIFFUSION_MODEL%
    pause
    exit /b 1
)

if not exist "%LLM_MODEL%" (
    echo [ERROR] LLM model not found:
    echo %LLM_MODEL%
    pause
    exit /b 1
)

if not exist "%LLM_VISION%" (
    echo [ERROR] LLM Vision model not found:
    echo %LLM_VISION%
    pause
    exit /b 1
)

if not exist "%VAE_MODEL%" (
    echo [ERROR] VAE model not found:
    echo %VAE_MODEL%
    pause
    exit /b 1
)

echo [OK] sd-server.exe
echo [OK] Diffusion Model
echo [OK] LLM Model
echo [OK] LLM Vision
echo [OK] VAE
echo.

REM ============================================================
REM Start Server
REM ============================================================

cd /d "%SD_DIR%"

echo ============================================================
echo   Qwen-Image-2.1 API Server
echo ============================================================
echo.
echo Server:
echo   http://127.0.0.1:%LISTEN_PORT%
echo.
echo LAN:
echo   http://YOUR-LAN-IP:%LISTEN_PORT%
echo.
echo Diffusion:
echo   %DIFFUSION_MODEL%
echo.
echo LLM:
echo   %LLM_MODEL%
echo.
echo Vision:
echo   %LLM_VISION%
echo.
echo VAE:
echo   %VAE_MODEL%
echo.
echo ============================================================
echo   Starting server...
echo ============================================================
echo.

sd-server.exe ^
  --listen-ip %LISTEN_IP% ^
  --listen-port %LISTEN_PORT% ^
  --diffusion-model "%DIFFUSION_MODEL%" ^
  --llm "%LLM_MODEL%" ^
  --llm_vision "%LLM_VISION%" ^
  --vae "%VAE_MODEL%" ^
  --offload-to-cpu ^
  --diffusion-fa ^
  --vae-tiling

echo.
echo ============================================================
echo   Server stopped.
echo ============================================================
echo.

pause
前面那几行 set 全是给路径起变量,主要是为了以后改目录的时候不用满脚本翻找。真正决定跑不跑得动的,是最后三个参数。
| 参数 | 作用 |
|---|---|
| --offload-to-cpu | 把放不下、也不必一直占显存的部分交给内存 |
| --diffusion-fa | 打开 Diffusion 的 Flash Attention |
| --vae-tiling | VAE 分块处理,压低出图时的显存峰值 |
这三个参数解决的是同一件事,显存装不下的部分交给 32GB 内存接住,不去硬挤那张卡。
你可以理解成书桌和书柜的配合,常用的摊在桌上,不常用的先塞回柜子,要用的时候再拿,桌面才始终留得下干活的地方。
脚本前面还挂了一道文件检查,启动前先把要用的五个文件挨个看一遍,都在才继续。
============================================================
  Checking files...
============================================================

[OK] sd-server.exe
[OK] Diffusion Model
[OK] LLM Model
[OK] LLM Vision
[OK] VAE
有用的是它报错的位置。模型被误删的时候,它会把缺的那条完整路径打出来,比等程序跑到一半自己崩掉好找得多。
六、接口和局域网调用
服务起来之后监听在 0.0.0.0:1234。
这个写法表示监听这台机器所有的网络接口,不是让你去访问 http://0.0.0.0:1234 这个地址,实际访问IP是服务器地址,如:http://192.168.10.136:1234。
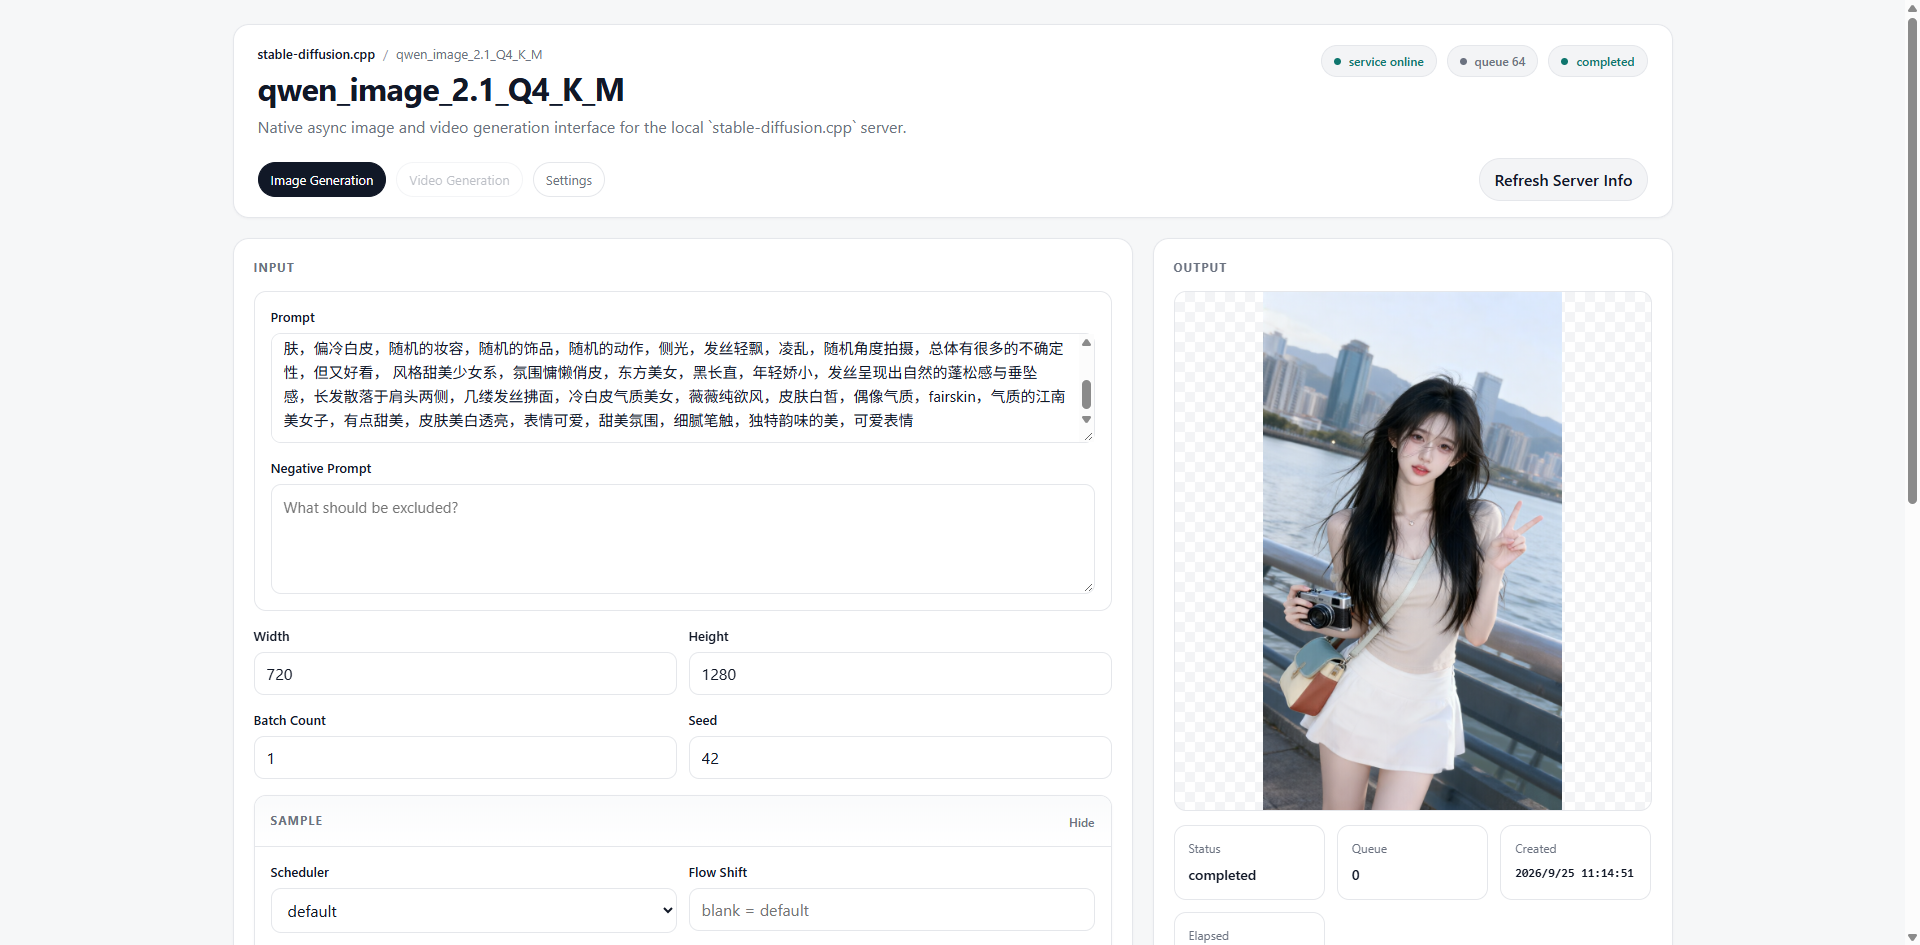
图:sd-server 自带的网页界面
这个网页界面是 sd-server 自带的,浏览器打开就能写提示词、调分辨率和种子,出图在右边直接看。我调参数基本都在这里完成。
要它正经干活还是走 HTTP 接口。模型跑在 3060 这台机器上,Agent 跑在另一台上,中间隔着局域网互调,一个端口就够,不用来回搬模型文件。这跟调用公司内网的接口是一个路子,服务在哪台机器上不重要,地址和端口通不通才要紧。
别在路由器上把 1234 端口映射到公网。脚本里没有 API Key,能连上这个端口的人都能直接占用你的显卡。
七、实战效果
下面这些图都是从这套服务里跑出来的,提示词写的是中文,模型对中文的理解没什么障碍。
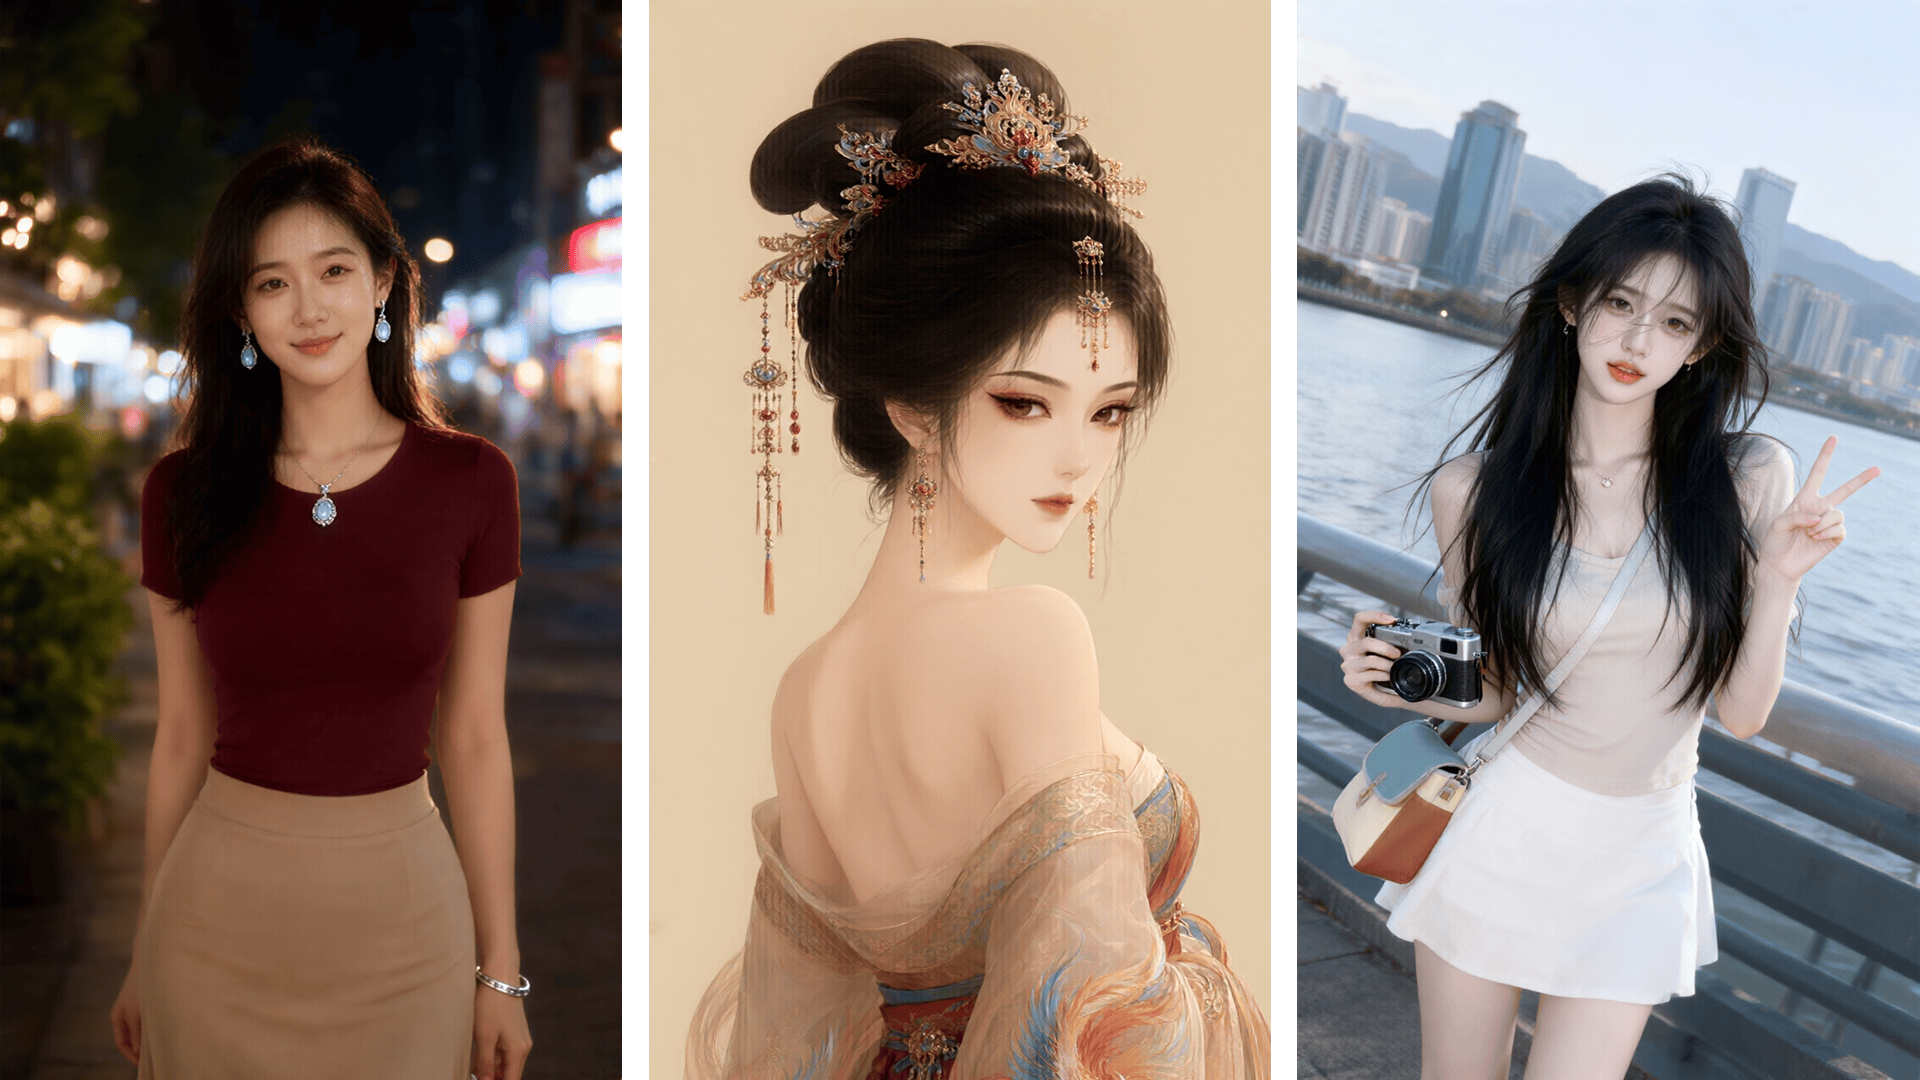
图:人物写真
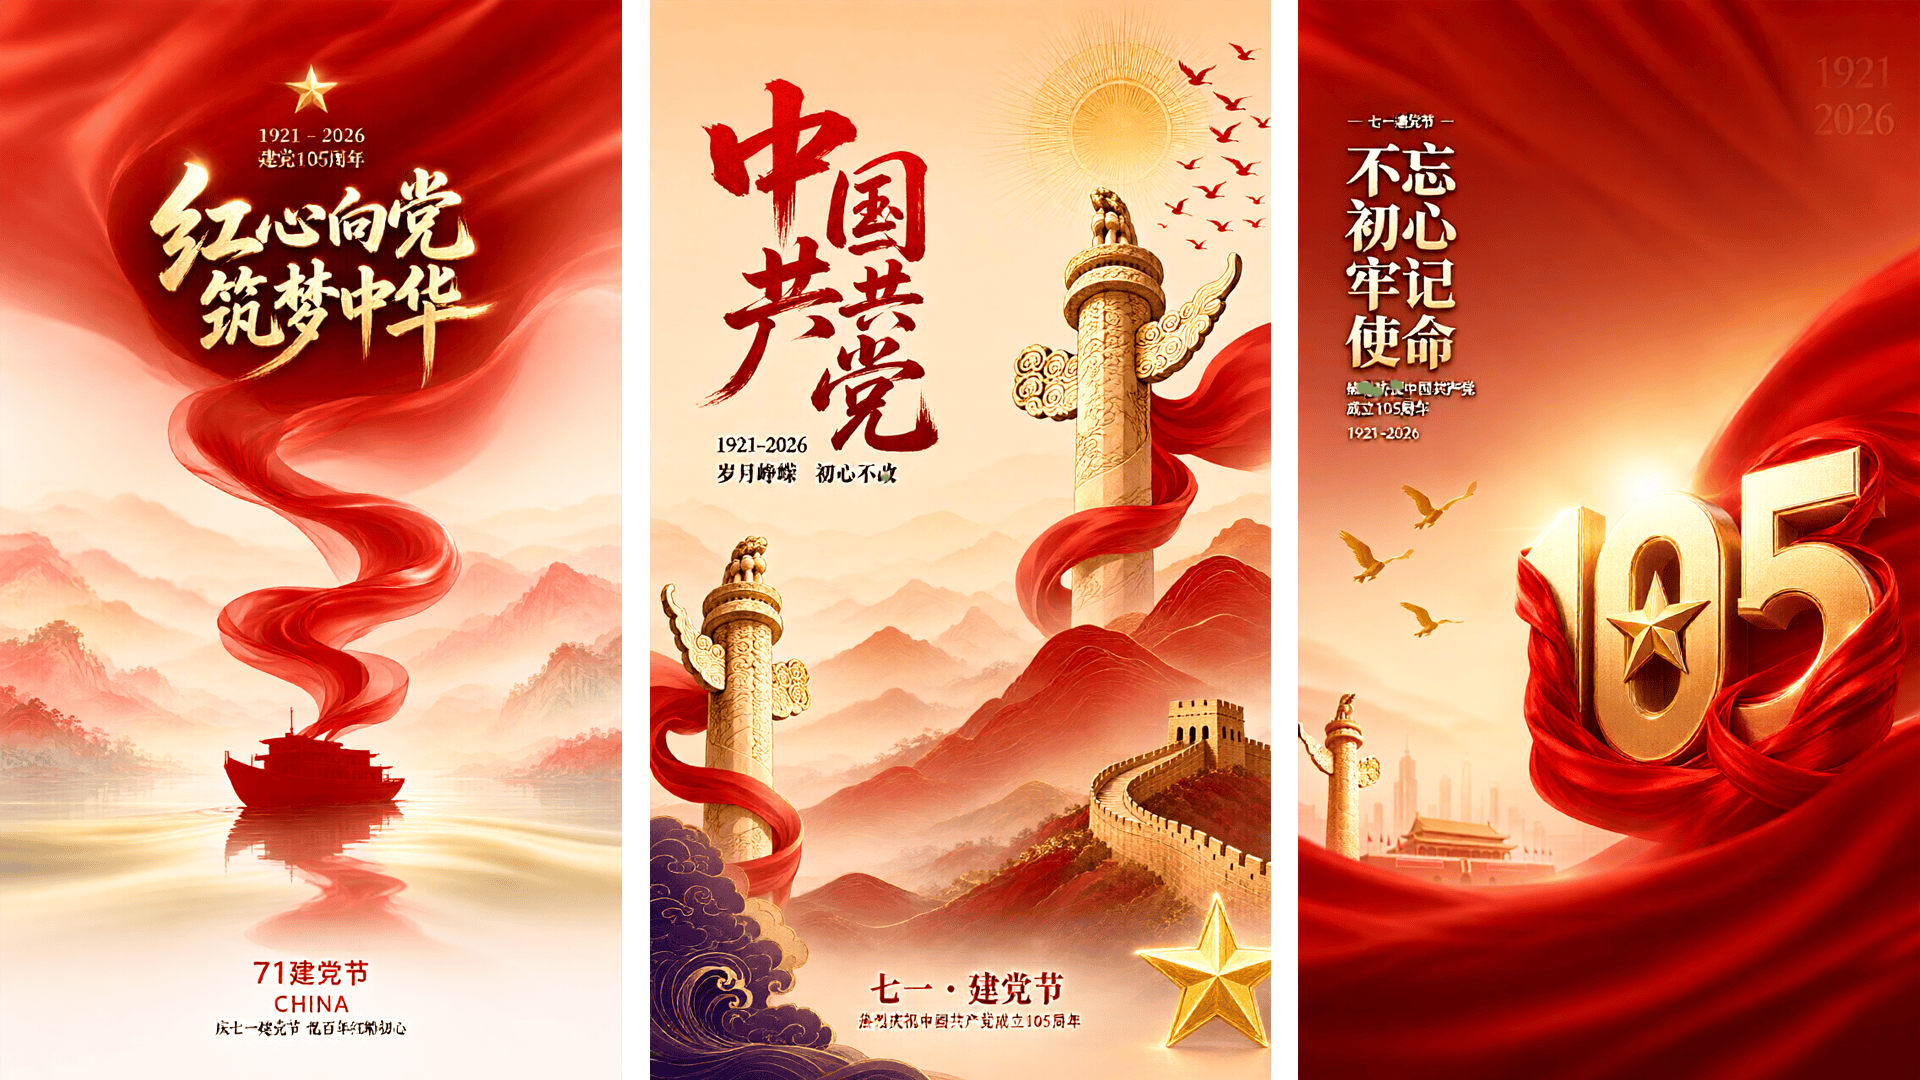
图:主题宣传画面
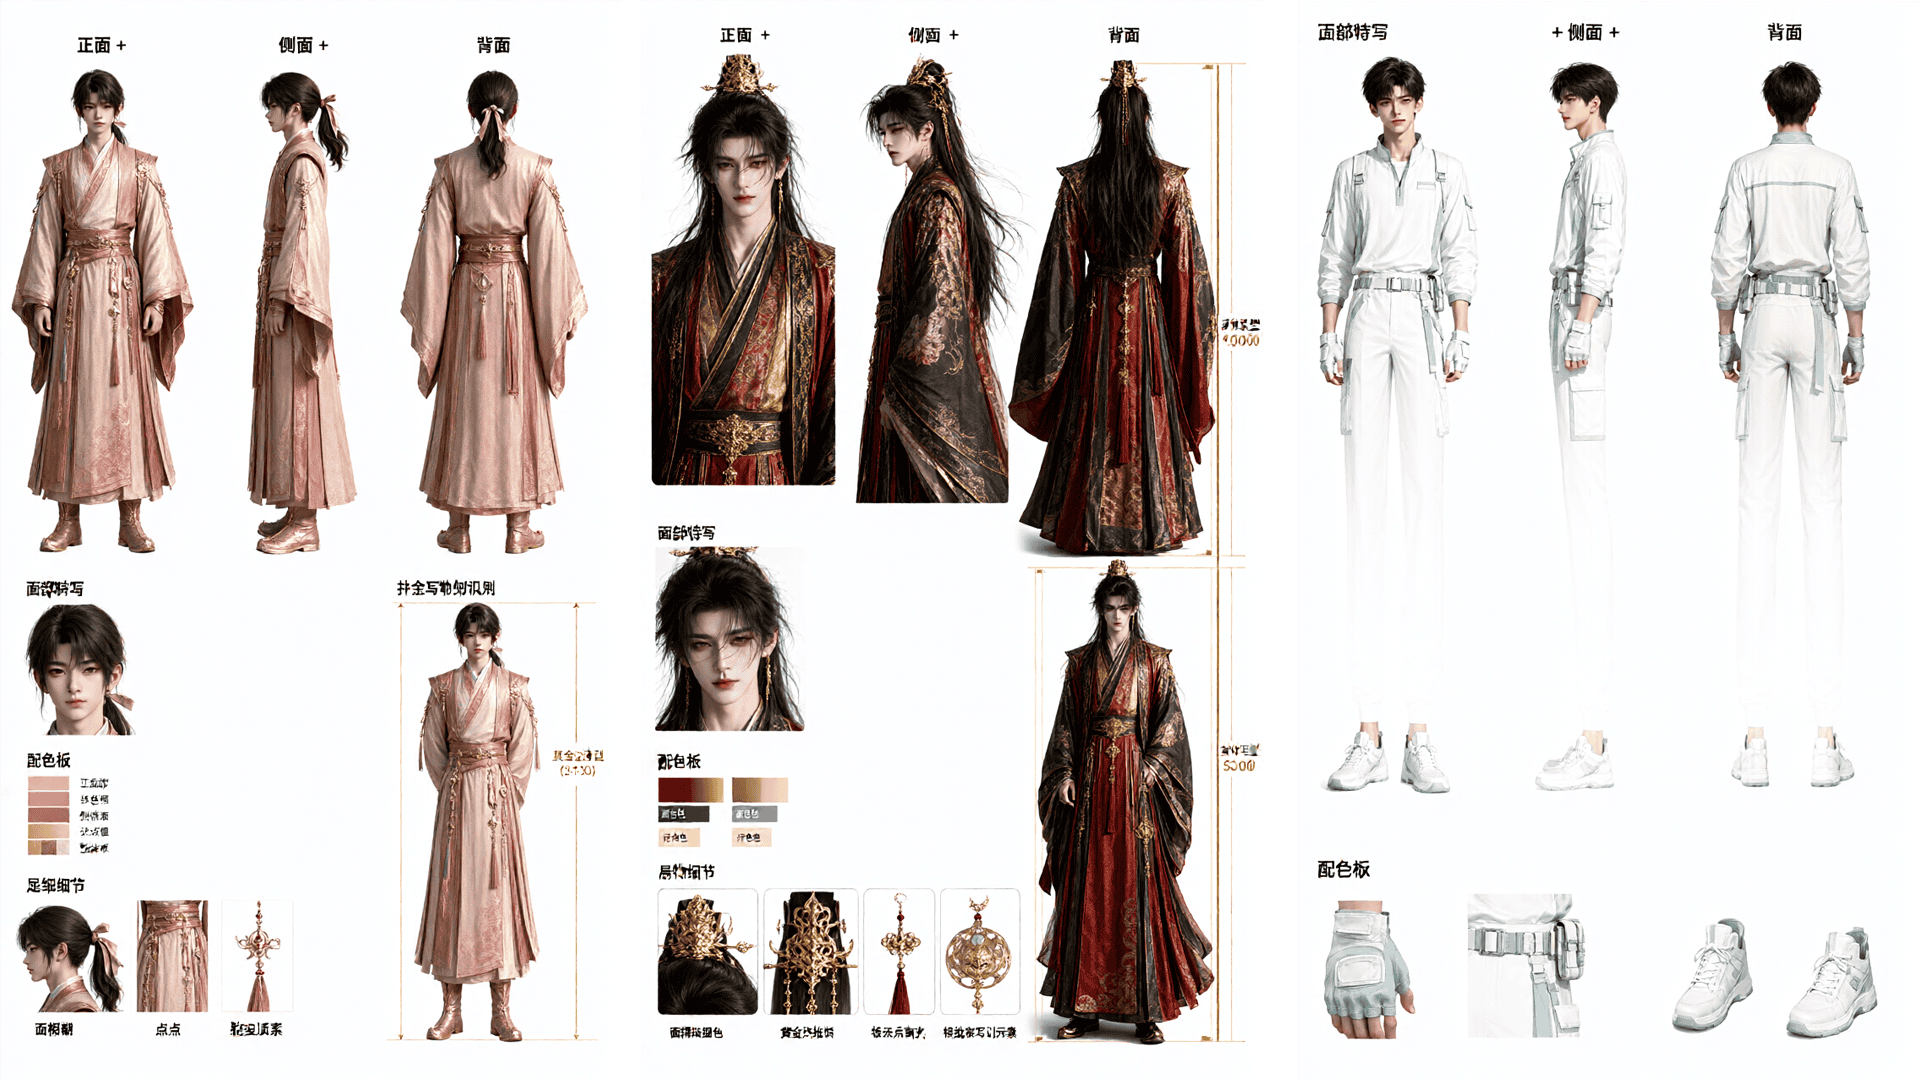
图:分镜图
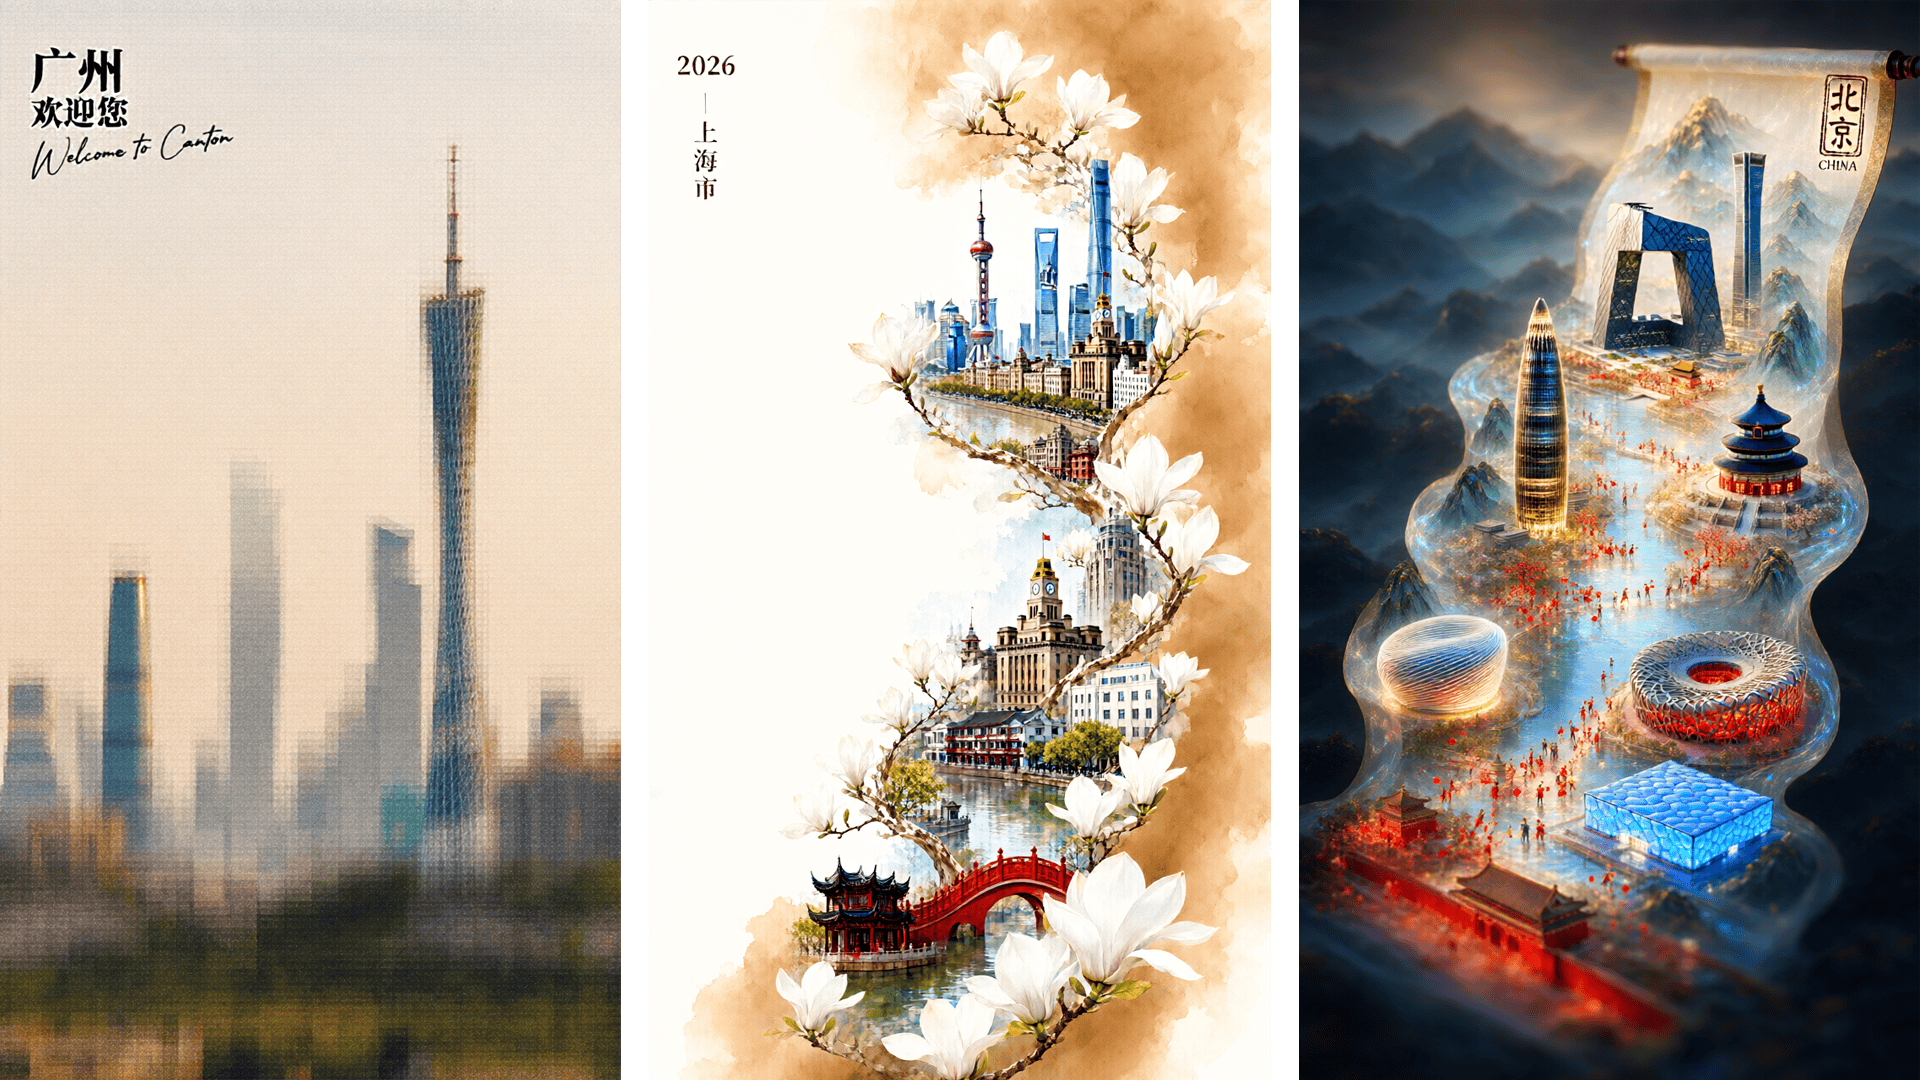
图:城市画像
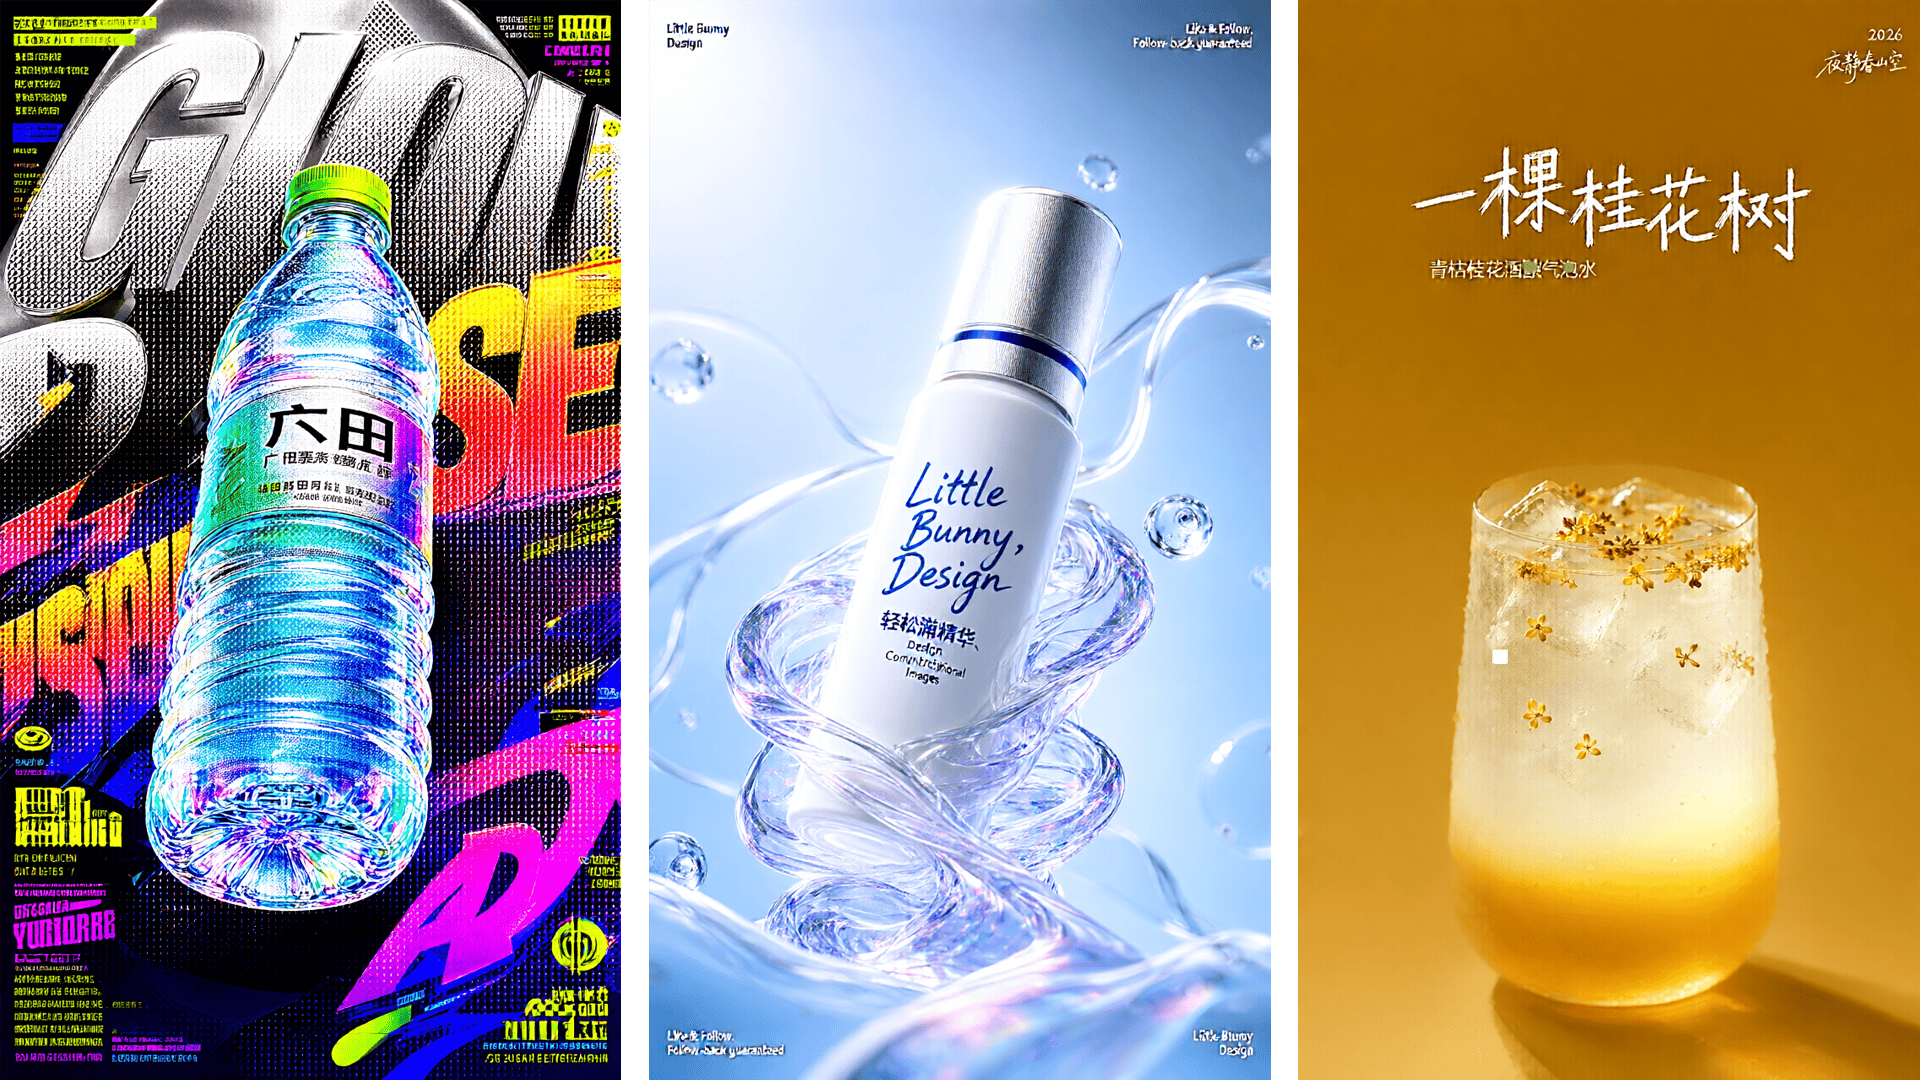
图:广告图
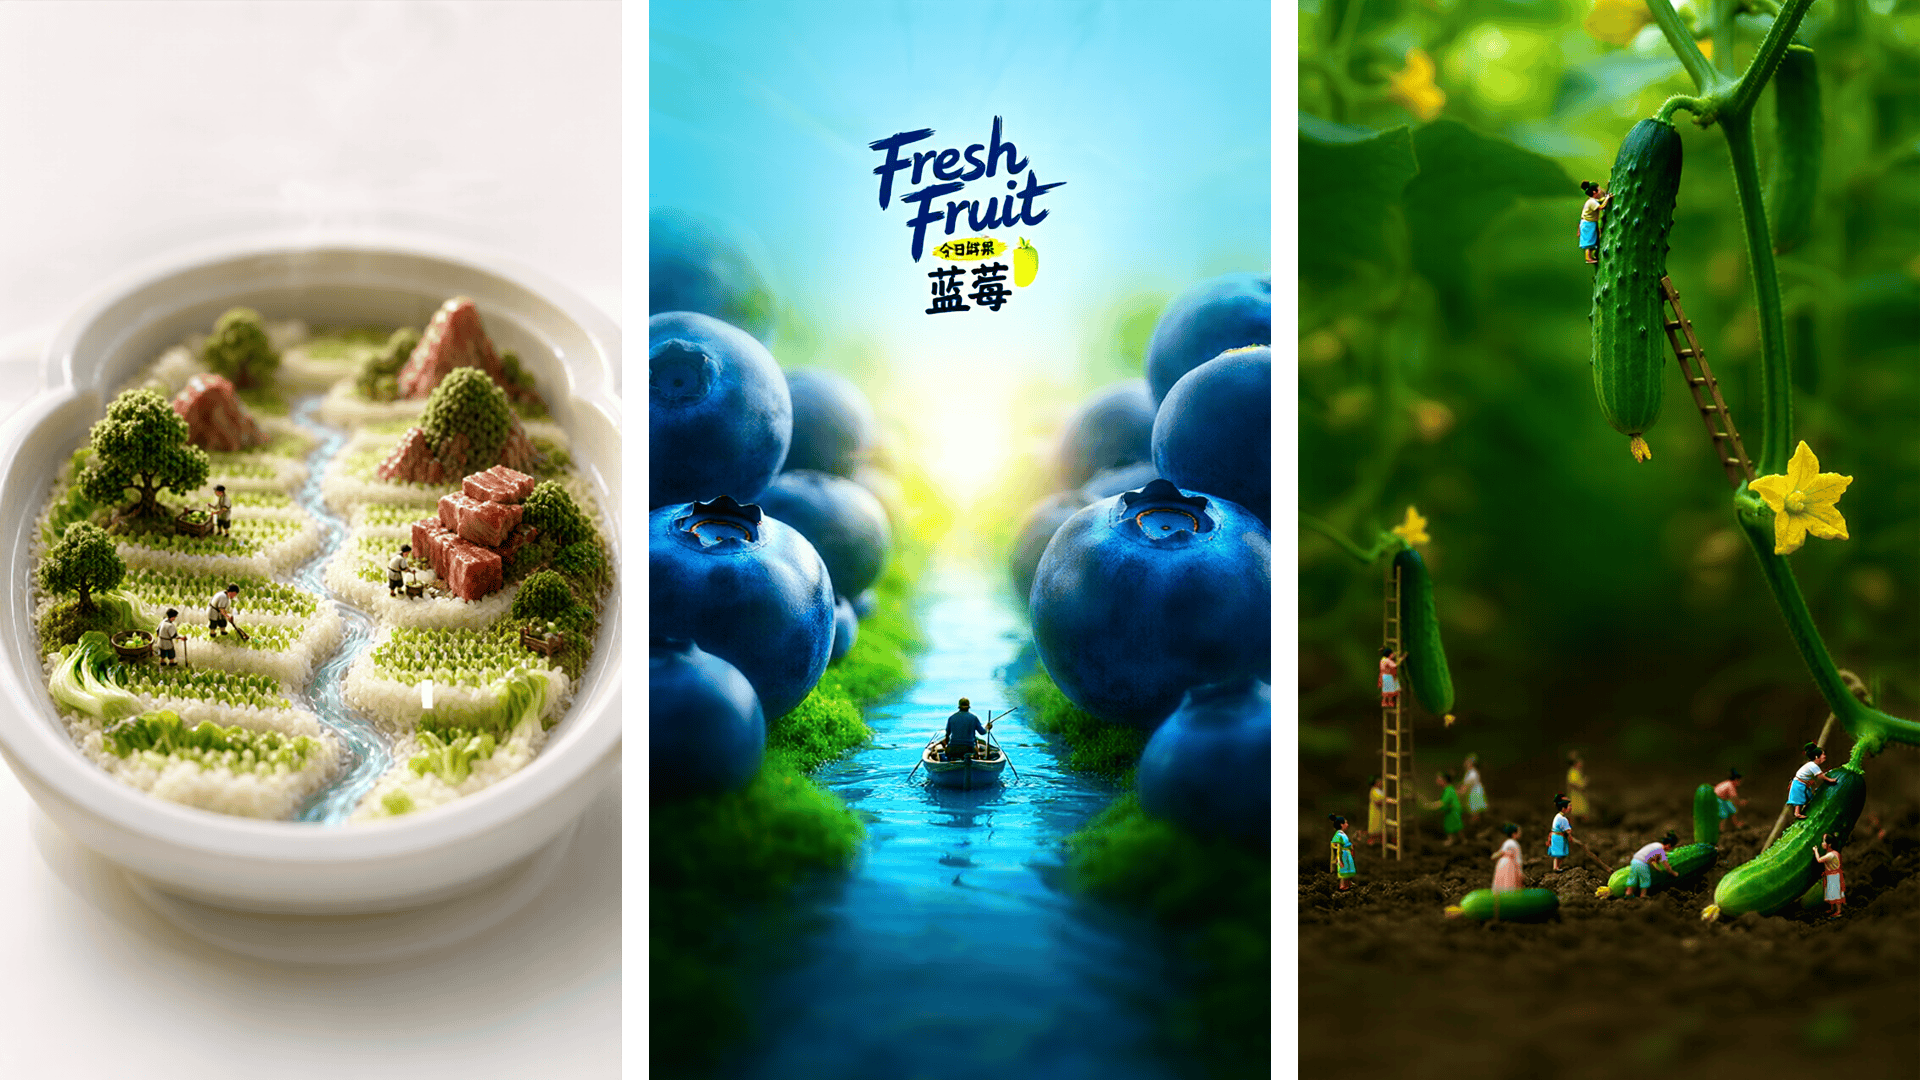
图:微观世界
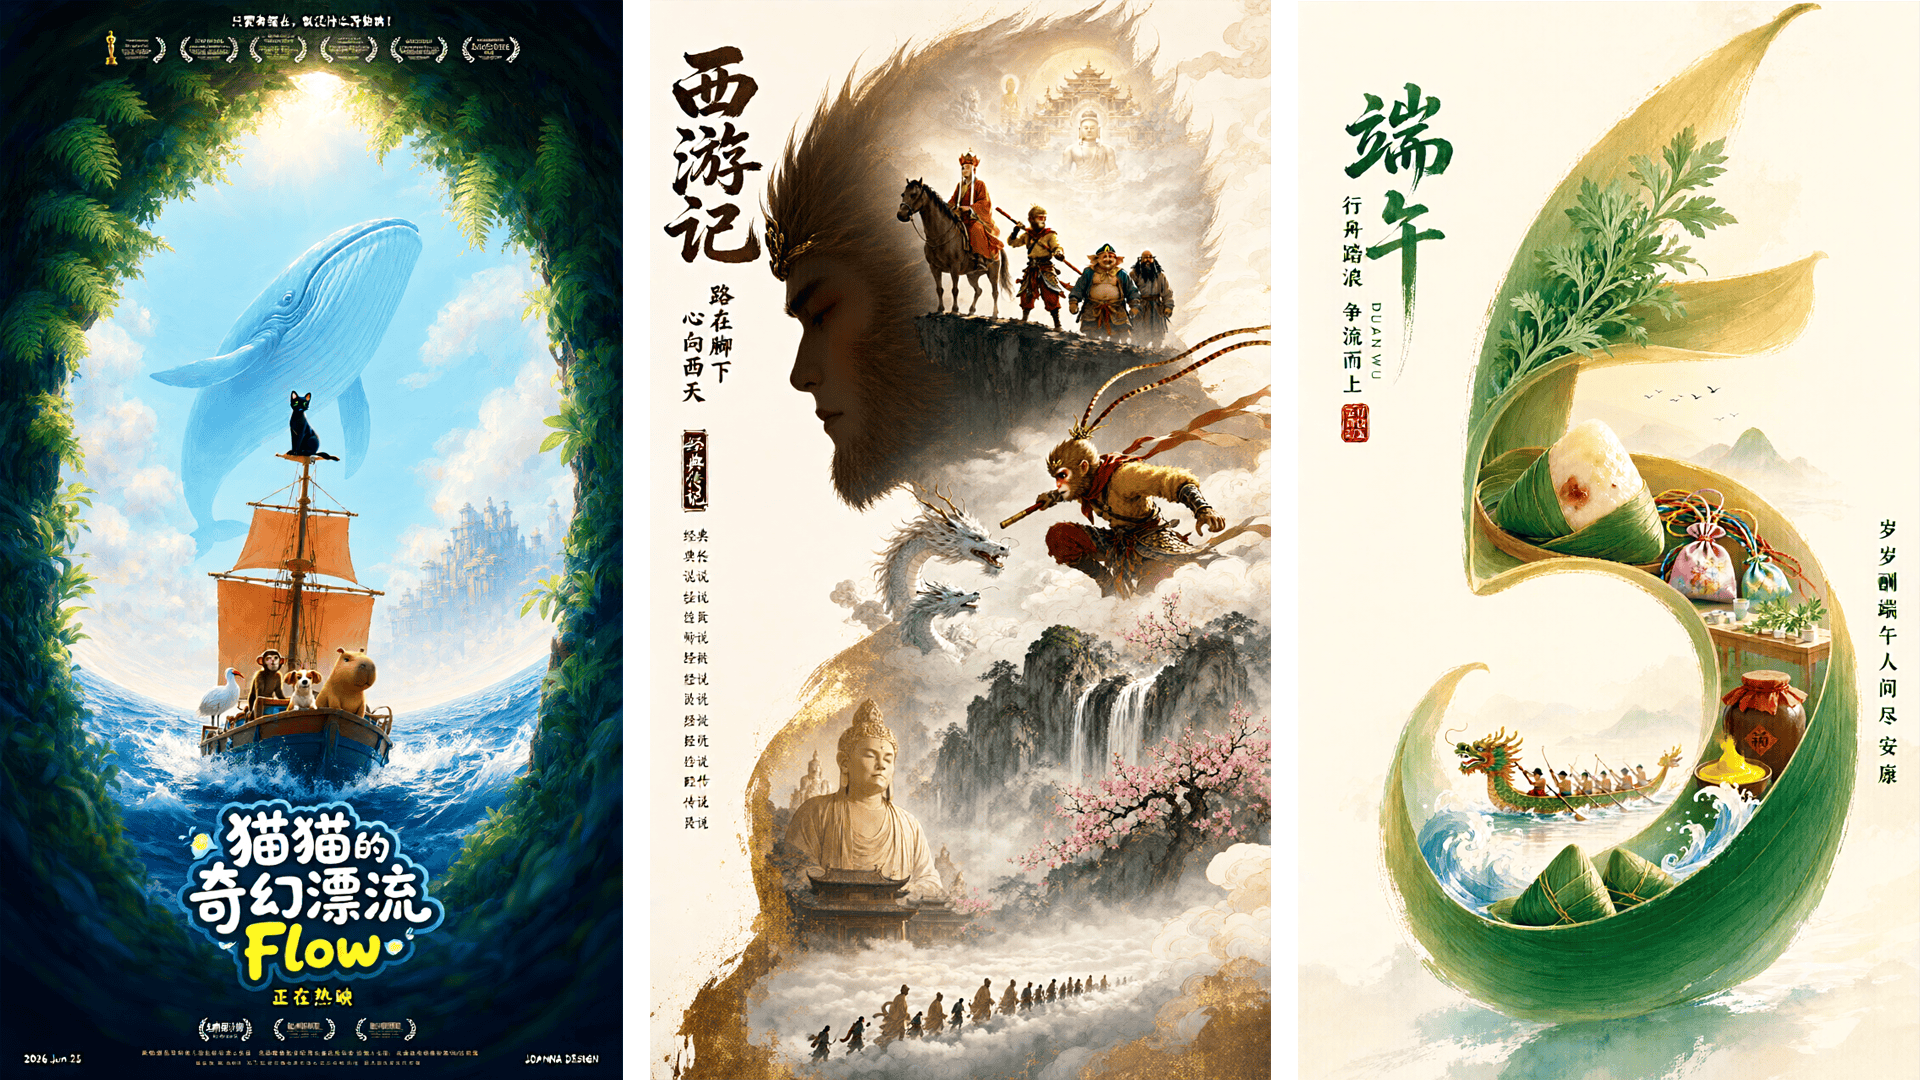
图:海报
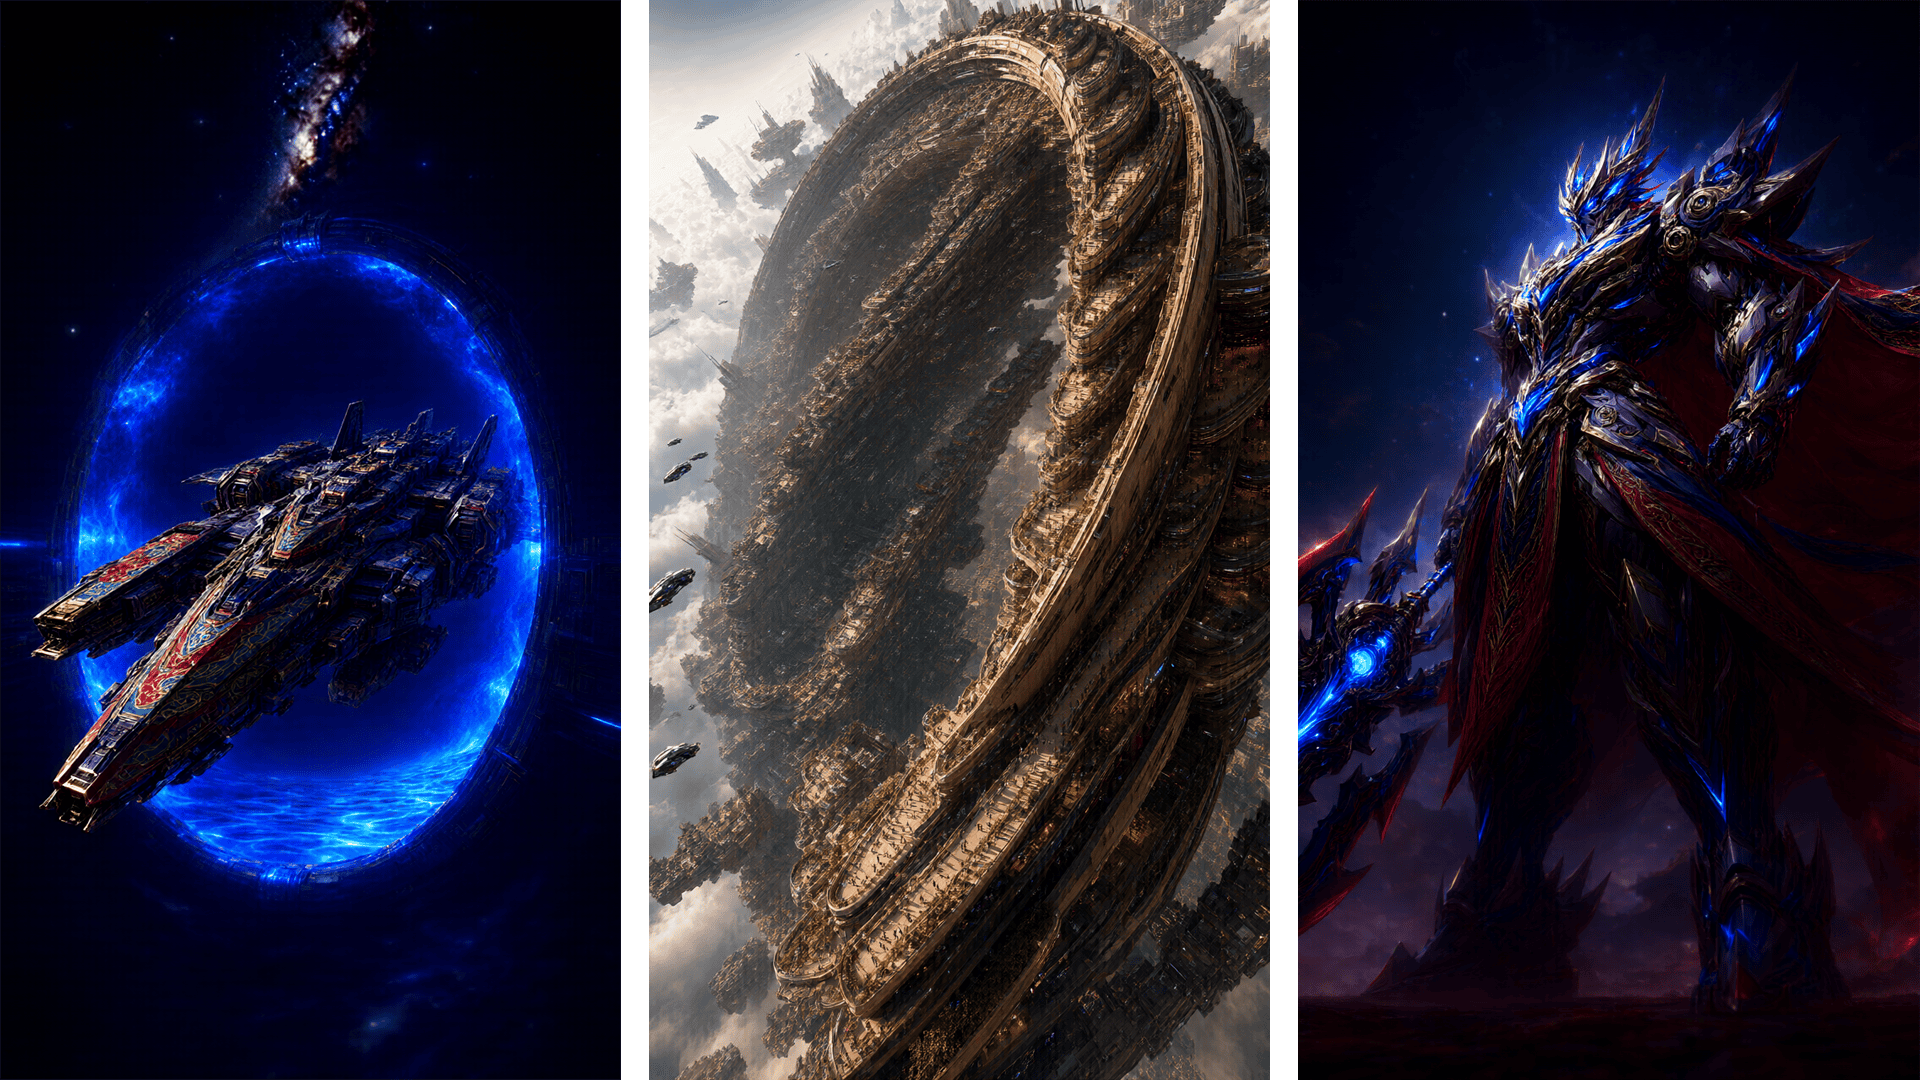
图:科幻场景
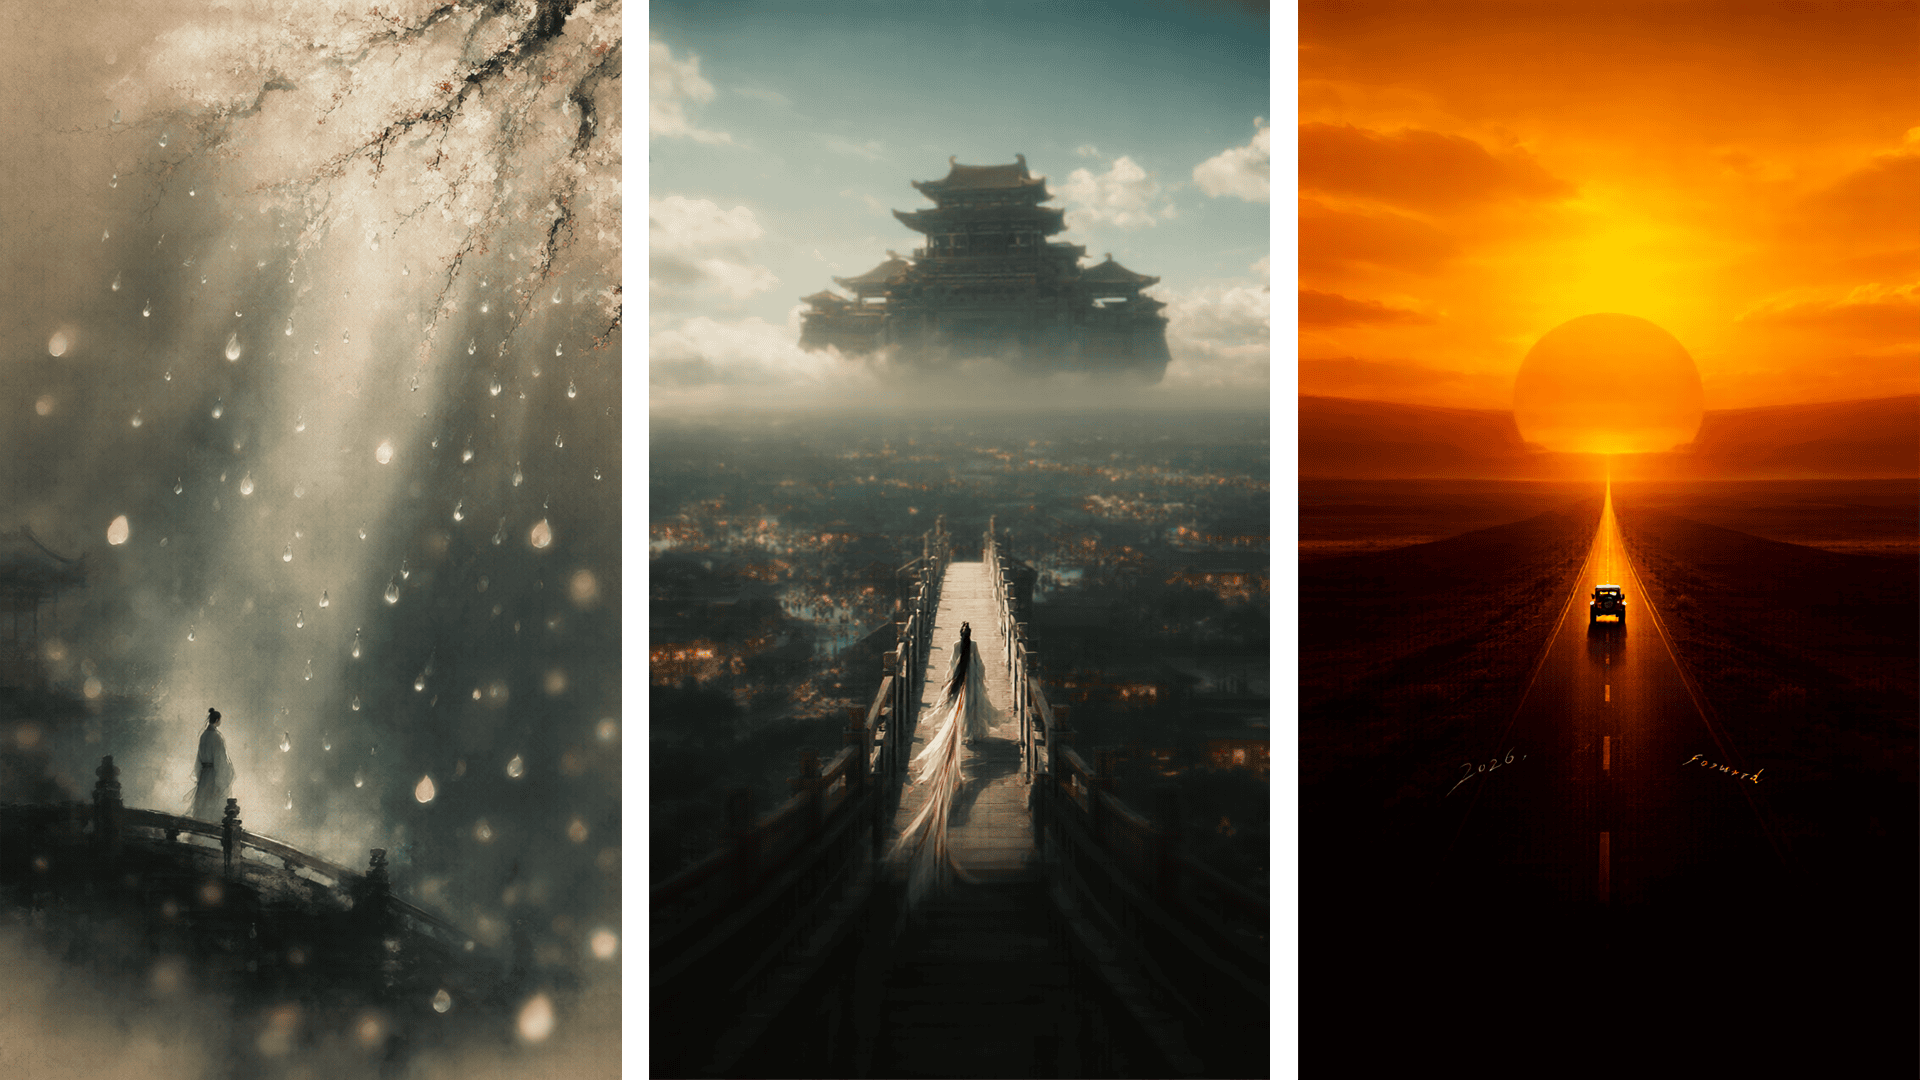
图:风景
八、几点提醒
1)许可证要看清。 Qwen-Image-2.1 用的是 Qwen Research License,公开许可覆盖的是研究和评估用途,商用得另外找 Qwen 拿授权,接商业项目之前先把这条确认了。
2)这套配置只做过出图验证,没做过速度基准。 不同分辨率、不同步数差别很大,我没有测出一组能拿来说事的时间,你自己跑的时候以实际为准。
3)主模型目录别改名。 脚本里的路径是写死的,把 Qwen-Image-2.1 这类目录名改掉,启动时会直接报 [ERROR] Diffusion model not found。
4)量化档位是显存和画质的交易。 Q4_K_M 只有 4.19GB,细节上是做了让步的,想要更好的质感就往 Q6_K、Q8_0 上走,代价是显存和速度一起往上涨。
5)升级程序不要覆盖旧目录。 新版本单独解压成一个新文件夹,两个版本并排放着,新版出问题就把脚本里的程序目录切回去。
有疑问的话可以在评论区留言交流。觉得有用的话,欢迎点赞关注。
参考资料:
Qwen-Image-2.1 官方发布说明 qwen.ai/blog?id=qwe…
Qwen-Image-2.1-GGUF 量化仓库 modelscope.cn/models/Abir…
Qwen3-VL-8B-Instruct-GGUF modelscope.cn/models/Qwen…
stable-diffusion.cpp github.com/leejet/stab…
本文部分内容包含 AI 辅助创作