背景:真实受限环境下的数据集成挑战
这家区域银行面临典型强合规场景:
-
数据库异构:信贷(Oracle)、CRM(SQL Server)、核心系统(DB2)三库并存;
-
接口缺失:各系统无标准API,禁止反向开发或源库改造;
-
部署刚性:必须全栈私有化部署,数据不出机房,账号需对接现有AD/LDAP;
-
人力瓶颈:IT仅3人,无专职数据工程师,ETL与SQL运维能力薄弱。
更关键的是——Excel并未被替代,而是承担着客户尽调标签、抵押物动态评估等关键补录职责。但手工台账带来版本混乱、更新不可控、审计难追溯等问题,导致业务分析普遍滞后于月度结账。
本质矛盾是:缺乏统一客户主键与行为时间轴,销售、风控、运营各自基于不同口径数据决策,形成‘盲区运行’。
技术选型逻辑:为什么JVS-BI能在该场景落地?
其可行性不在于功能堆砌,而在于对受限环境的精准适配设计:
-
私有化底座+统一认证:全栈本地部署,支持AD/LDAP无缝集成,权限体系零改造,满足‘数据不出域、权限不越界’硬性要求;
-
JDBC直连穿透异构层:无需定制驱动或方言适配层,通过标准化JDBC连接Oracle/SQL Server/DB2,自动处理类型映射与分页语法差异;
-
Excel作为一级数据源:上传即建模,系统自动注入
upload_time与batch_id字段,人工台账从‘黑箱’变为可版本化、可调度、可审计的数据资产; -
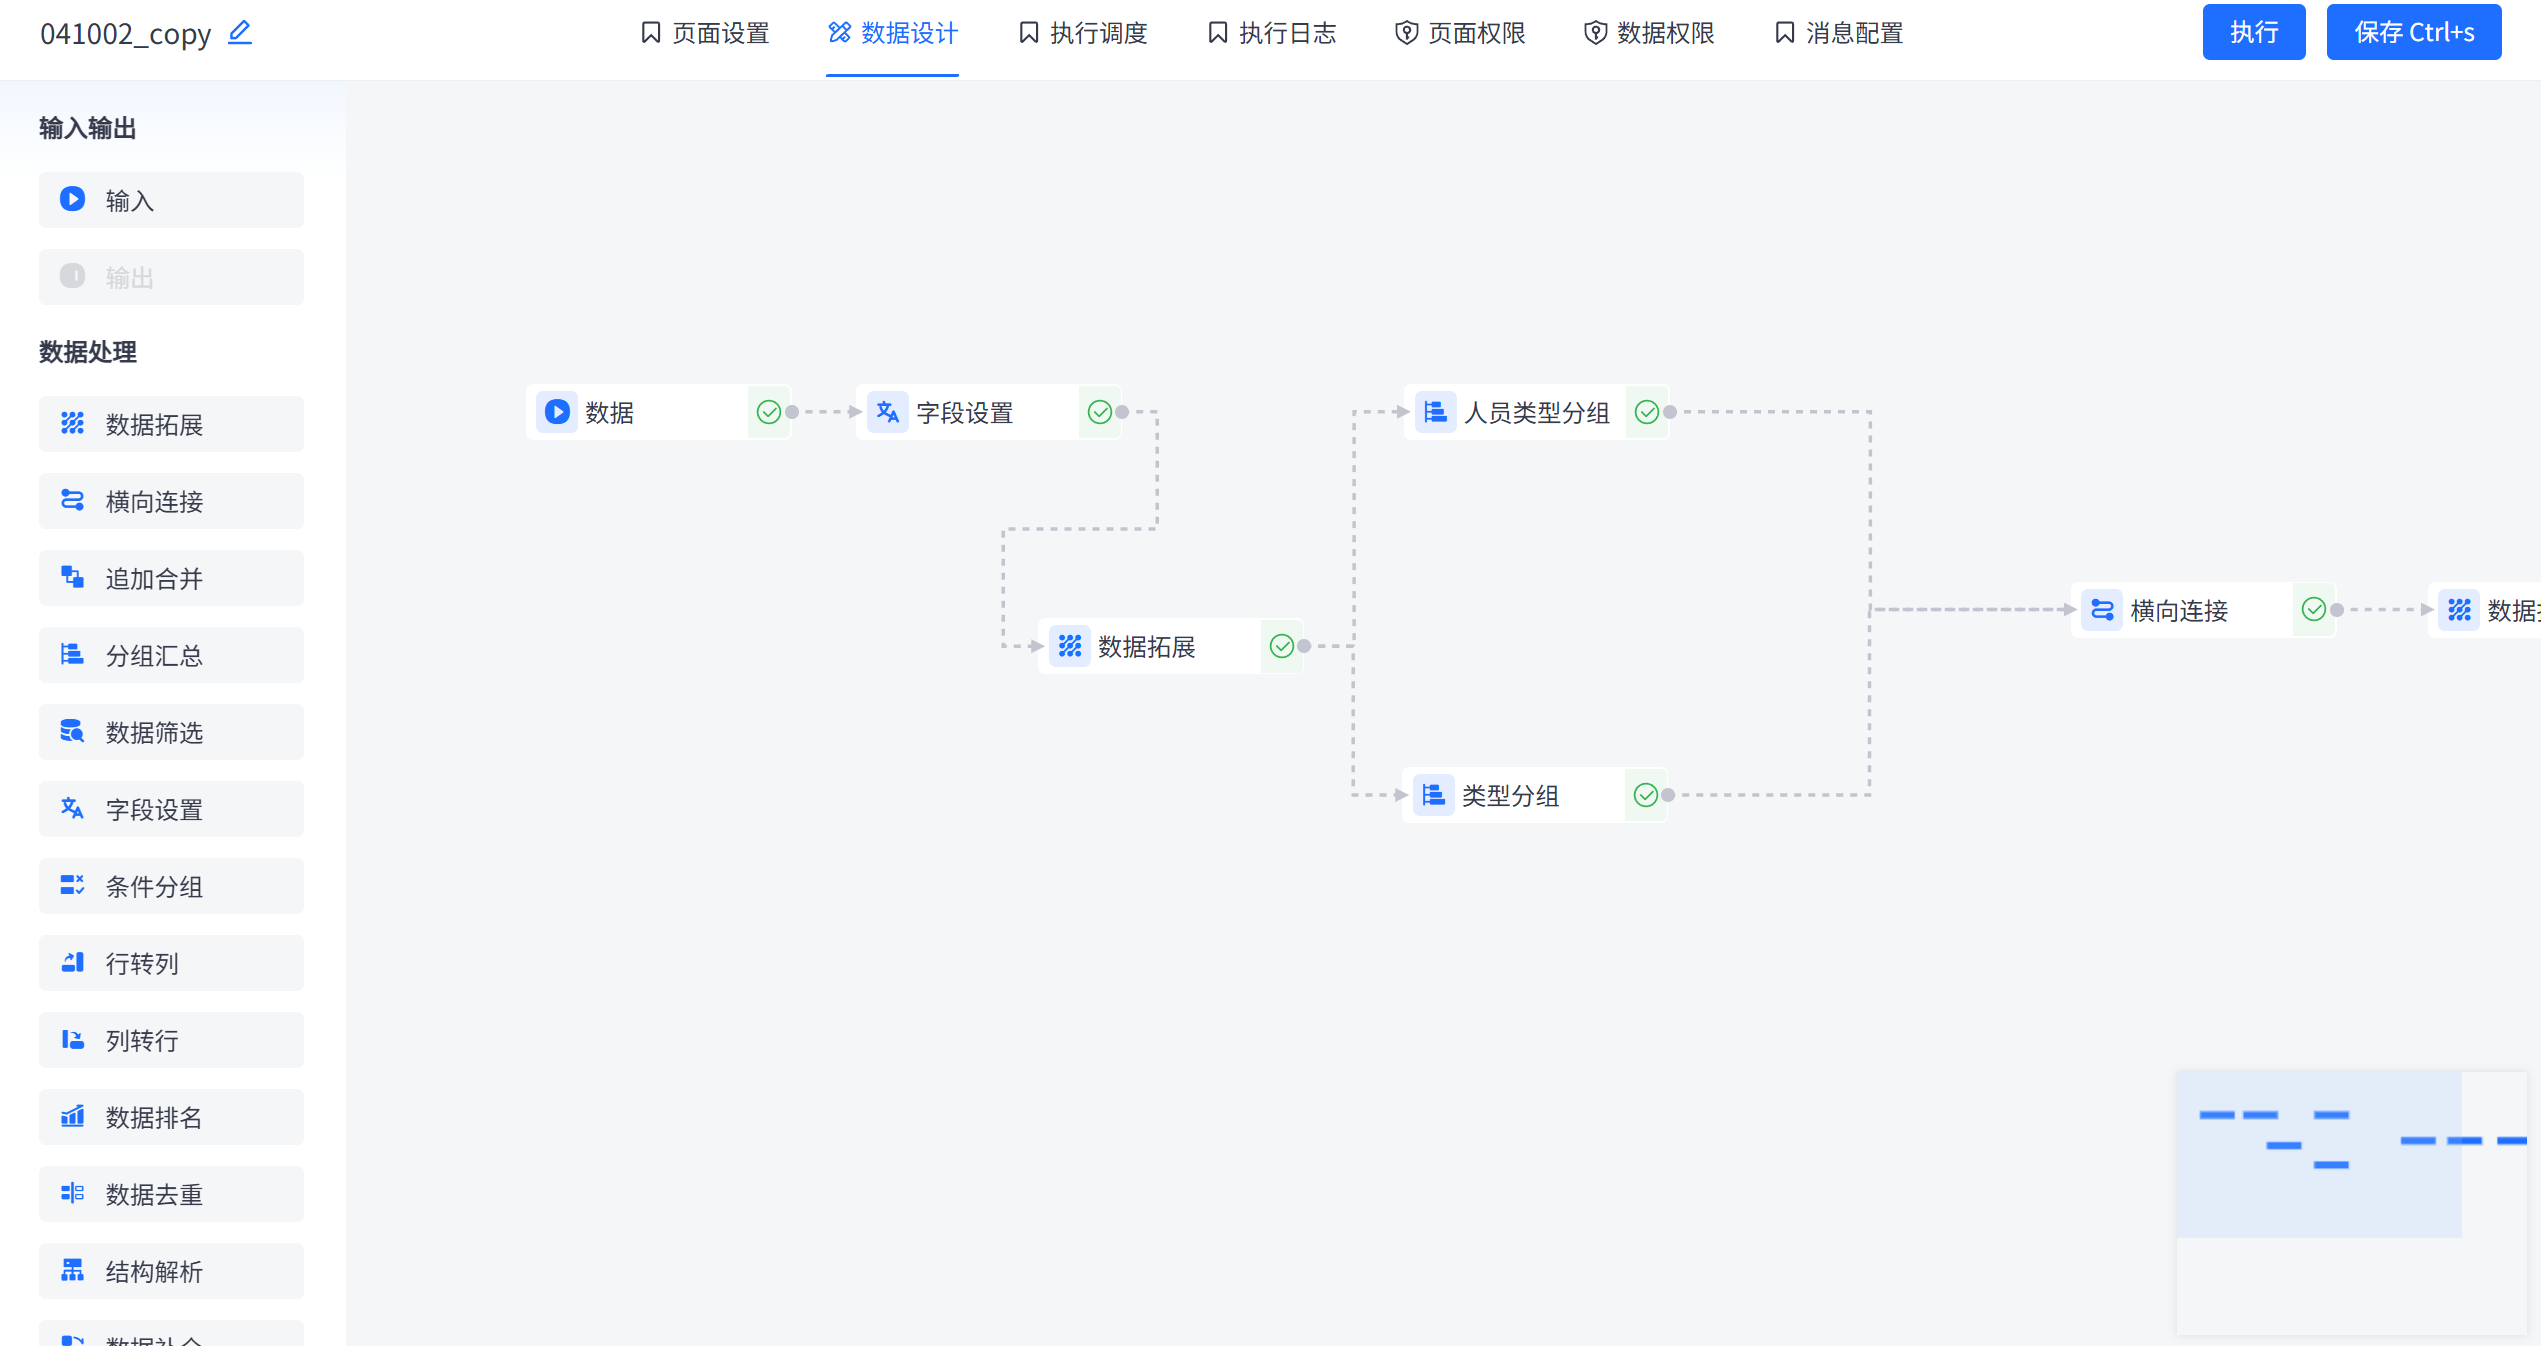
可视化ELT替代手写SQL:抽取→清洗→关联→聚合全流程拖拽配置,支持跨库ID映射、字段标准化(如证件号去空格/大小写归一)、指标计算,结果实时预览,绕过IT翻译环节。
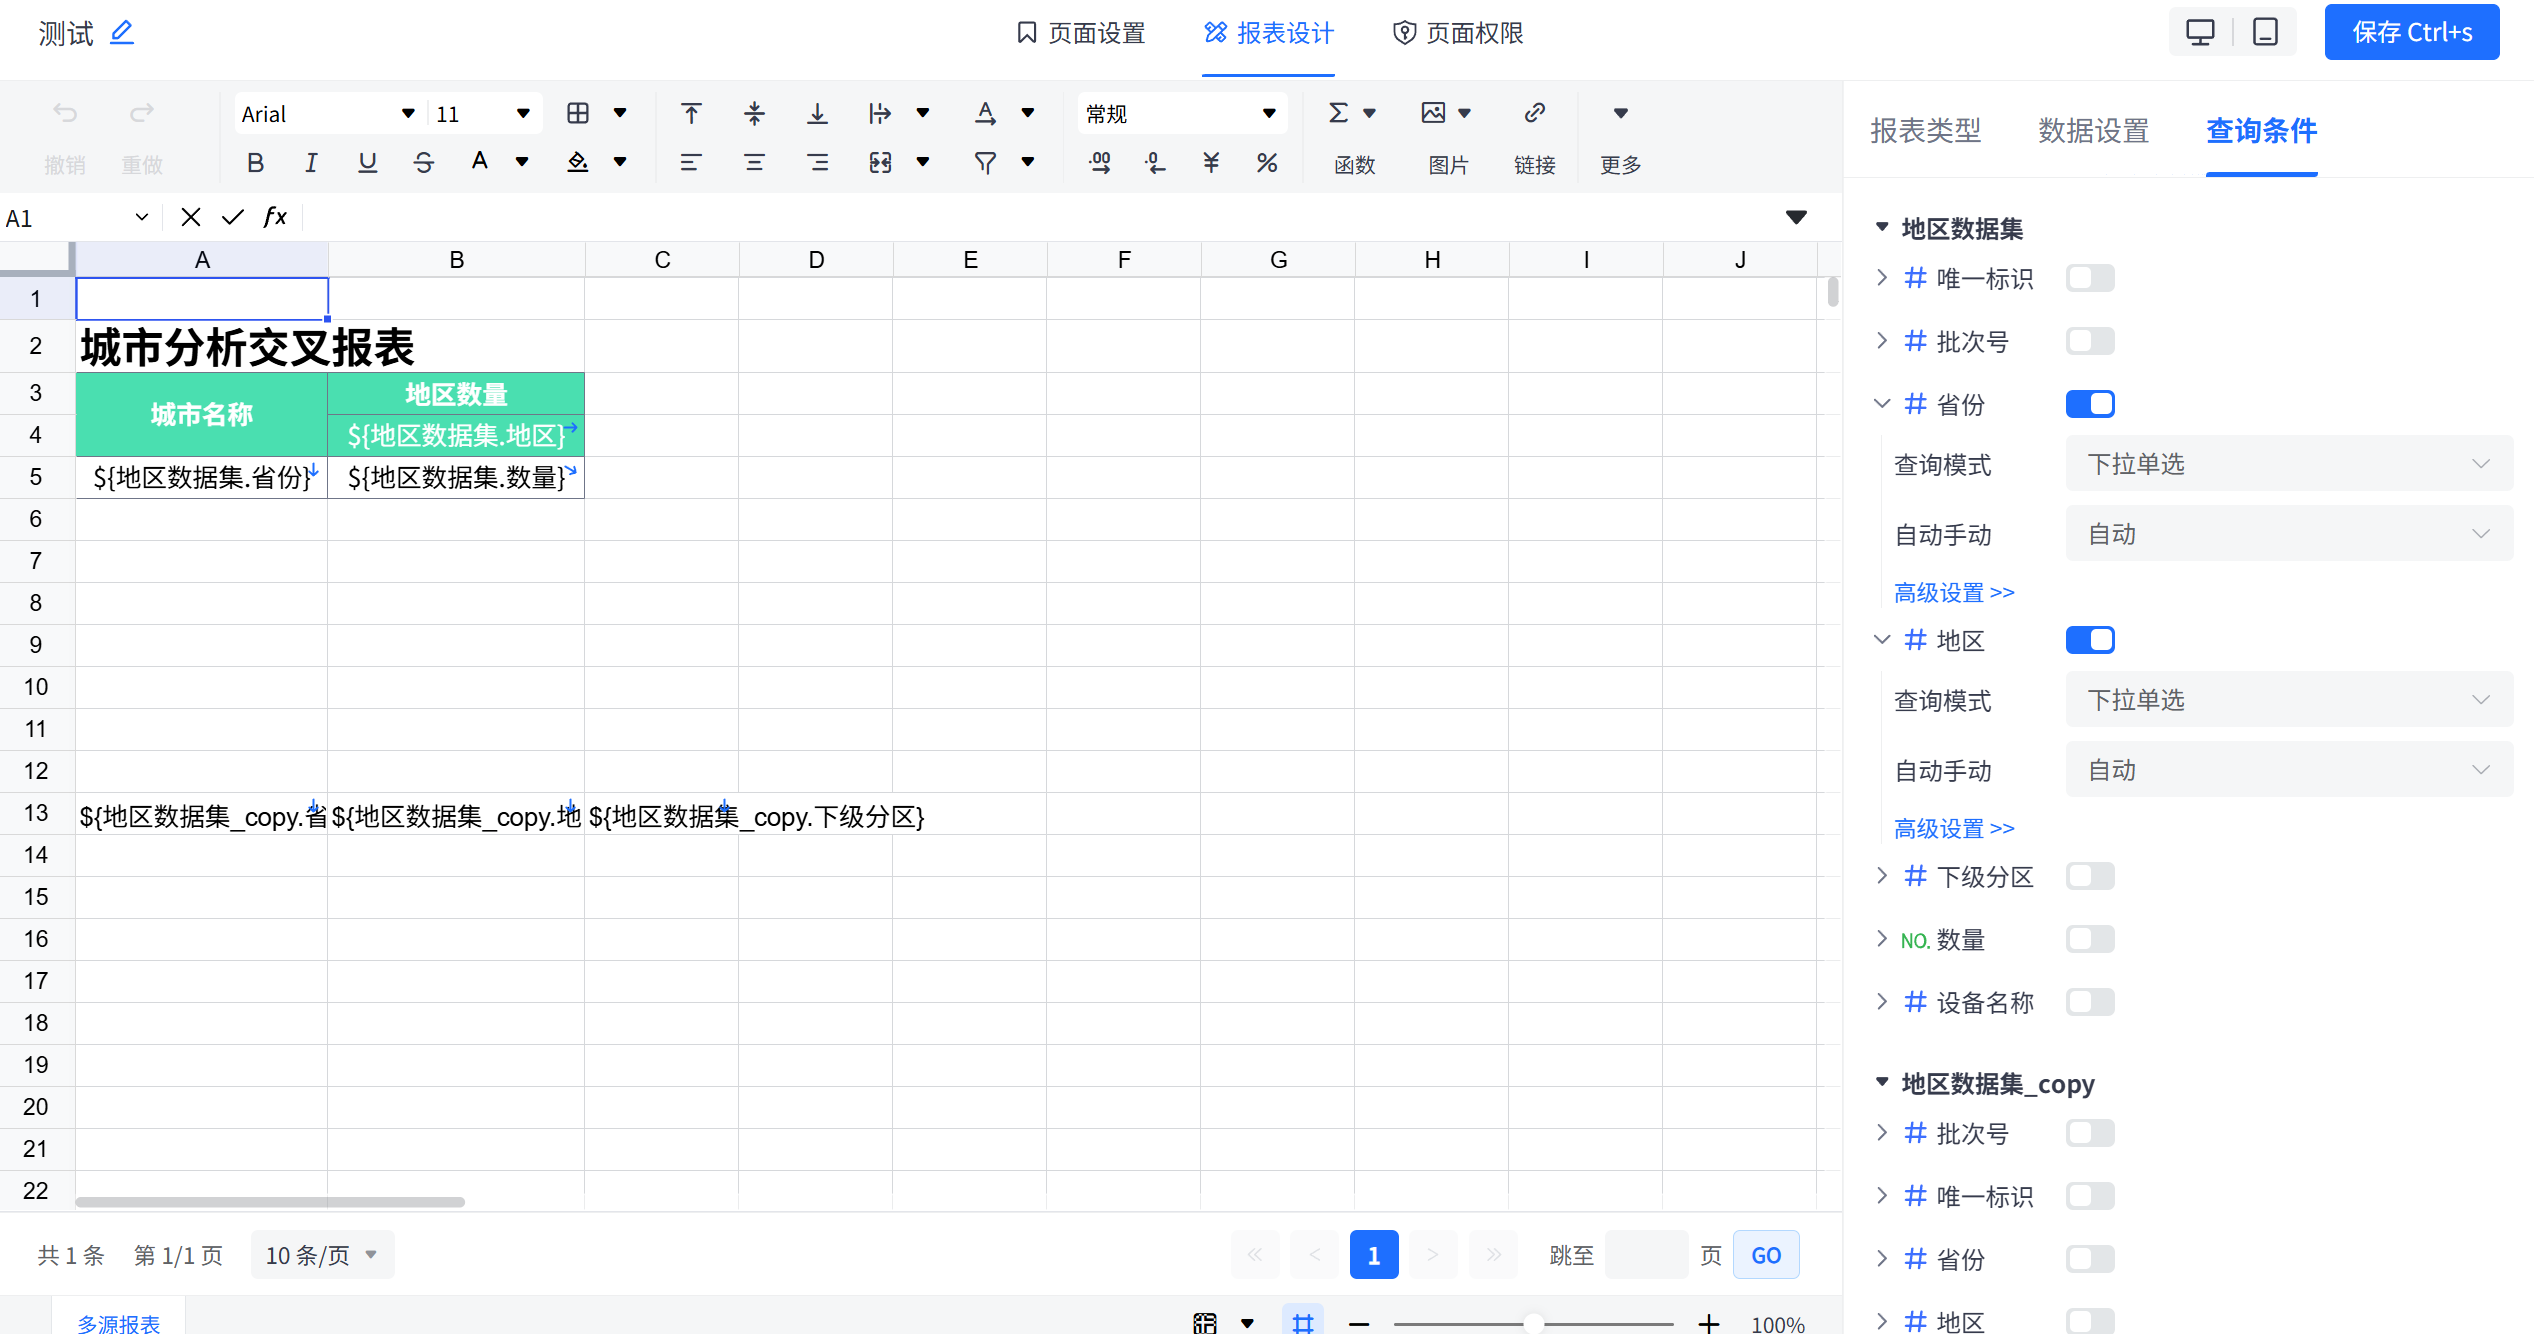
注:所有能力均基于配置实现,未修改任何源系统表结构或触发器,不依赖定时ETL服务或中间库。
关键实施路径:以贷后预警为MVP的2周闭环
项目聚焦最小可行场景,严格按四阶段推进,全程无定制开发:
-
Day 1:三库直连接入
-
分别配置Oracle信贷库、SQL Server CRM库、DB2核心库JDBC连接;
-
连接成功后自动同步元数据,识别
customer_master、loan_apply、contact_log等关键表;
-
-
Day 2–3:Excel补录建模
-
上传《线下尽调记录表》《抵押物动态台账》,系统自动标记批次号(如
B20240801); -
每次重传生成新批次,保留原始文件哈希与操作日志,支持按批次回溯;
-
-
Day 4–8:跨库关联建模
-
基于身份证号/客户号构建主键映射表;
-
使用跨库关联引擎,按
customer_id + event_time缝合四类数据源:-
信贷申请状态(Oracle)
-
CRM触点记录(SQL Server)
-
核心账户余额(DB2)
-
Excel尽调标签(本地文件)
-
-
输出宽表结构含
id,last_contact_time,current_balance,risk_tag,mortgage_status等字段;
-
-
Day 9–14:预警视图交付
-
加工标准数据集
post_loan_risk_list,含逾期率、30天触点频次、资产覆盖率等指标; -
配置下钻报表,支持按客户ID逐层展开至原始交易流水;
-
设置规则引擎条件:
last_contact_time < now() - INTERVAL '30 days' AND current_balance / prev_balance < 0.8,触发自动预警。
-
开发者关注点:能力复用与扩展边界
本方案并非一次性项目,其交付资产具备明确可复用性:
-
标准数据集开放REST API:
GET /api/v1/datasets/post_loan_risk_list返回JSON格式数据,已用于监管报送系统对接; -
客户主键映射表可导出为视图:支持下游数仓直接
SELECT * FROM jvs_customer_mapping引用; -
行为标签模型支持增量扩展:新增Excel补录字段(如
industry_risk_level)后,自动注入宽表,无需重跑全量流程; -
权限粒度控制到字段级:例如CRM人员仅可见
contact_log相关字段,不可见信贷金额列。
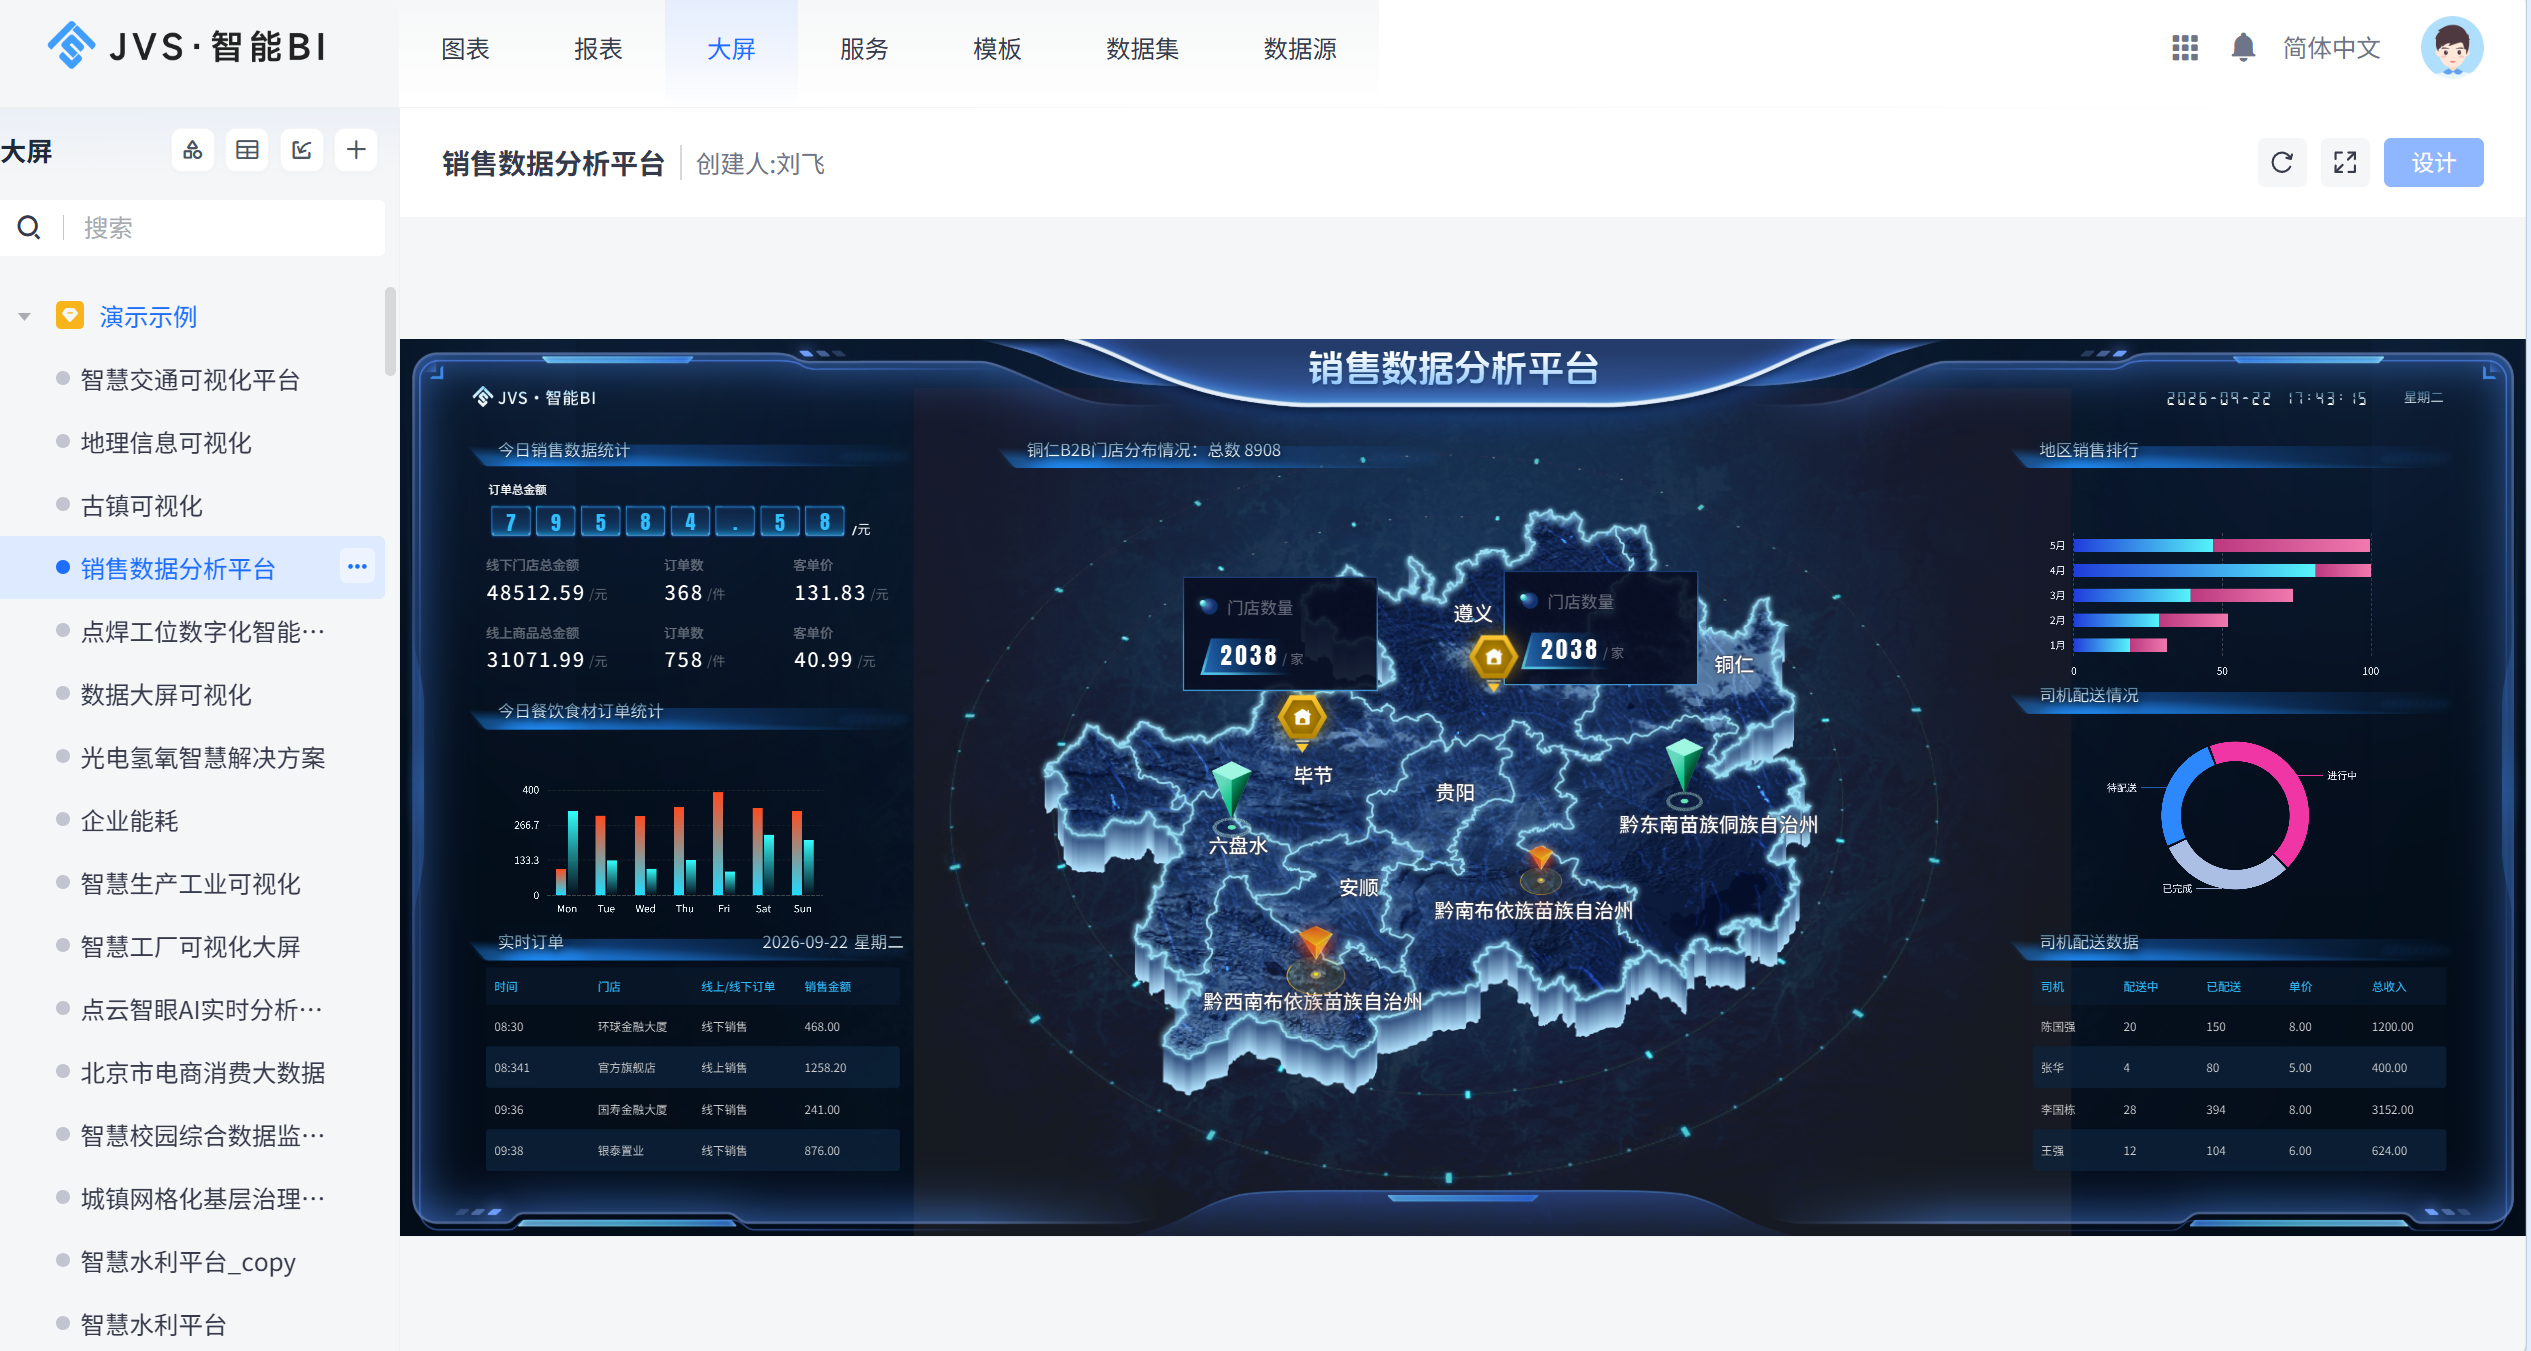
最终视图未作为独立BI页面交付,而是通过iframe挂载嵌入信贷员作业系统首页——打开即见本人管户风险概览,点击下钻即查原始数据源,完全不侵入原有工作流。
经验总结:什么条件下适合采用此类方案?
-
✅ 适用:源系统稳定但封闭、无ETL能力、急需业务闭环验证、允许Excel作为可信补充数据源;
-
❌ 不适用:需毫秒级实时同步、存在大量非结构化数据(如OCR票据)、要求完整数据血缘追踪到字节级;
-
⚠️ 注意:跨库关联性能依赖JDBC连接池配置与目标库索引合理性,建议对
customer_id和event_time字段建立复合索引。