每次记录限5分钟,
写个开头就放下就是最好的写作技巧.
超过5分钟 说明自觉没想清楚,
请把这5分钟用在思考上。
Q1:开发流程设计--开发--自测--review--反复修改
- 考虑太多,设计时候考虑开发,开发时候考虑测试,测试时候考虑设计,最后能上库,一个人考虑全部。最后00
- 不是在党的领导下 一步一步执行,该执行什么。就执行什么。哪怕错了 不好也不管。设计只有就行不高级设计不复杂场景,开发只有实现就行 ,测试case通过将完成,最后完成功能,世界就是板子,最后能bug 修复,都是这个方式,
其实可能都相同知识,相同实现,不同
因此 你学习这个方式,学习这个方式。
Q2 开发流程 开发期间不测试,有10个功能,一一次全部实现完毕,最后在测试,如果担心语法问题 可以去编译,这个开发1个功能,测试1个功能,是最慢 最慢的?
现象:
开发一个功能,测试一个功能,感觉效率很高,其实最慢的,
大部分实践都在重复同样测试上,
开发功能一部分 ,相同测试
开发功能一部分 ,相同测试
开发功能一部分 ,相同测试
原因:
测试的不是最终的代码,if else 分支代码都没有开发完成你
一个测试问题 影响10天 20天 没解决,耽误看写代码速度。
因此
这个不是敏捷开发,小瀑布式开发方式必须遵守
设计完毕,然后开发,开发完毕然后测试,
不能设计一半,然后去开发,开发一半去测试,
忍住 忍住做容易事情的冲动
忍住做容易事情的冲动
住做容易事情的冲动
住做容易事情的冲动
因为你不清楚
设计,开发 测试 需要不同的思维方式
考虑事情角度不一样,
甚至设计师只设计部开发。
测试人员只测试部开发。
因此 你目前采取这方式 结果低效的 低效的 ,低效的。
Q3 :再次强调 必须开发完毕在测试,在设计,开发时候 考虑各自分支,不一定测试完毕?
原因: 一个问题 可能调试很长很长时间,验证耽误开发进度,验证耽误测试进度
再次提醒,再次提醒,只开发部测试。
我发现之前领导这样的,先分析清楚,然后实现清楚。
错误处理方式:
通过测试 发现开发 涉及不足,这个说明根本没有设计,根本开发。
设计 开发 解决90%问题,测试发现剩余10% 异常的问题。
不是通过测试解决100%问题,这个时间上来不及。
这个时间来不及。
Q3 c 和c++ 设置默认一个参数为null如何实现?
C 语言不支持真正的默认参数(不像 C++ 可以 <font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">void f(int x, int y = 0)</font>)。
Q4 请练习gdb调试,非修改一行代码 重编打印日志
- 大型项目 编译一次需要45分钟,运行一次45分钟,如果完整的至少1天时间。
- 必须设计清楚,分析清楚,了解完整过程,不要修改一样代码,gdb一次。
- 不要像demo项目一样来解决。
明确 为什么不用gdb调试,不要说gdb无法调试你复杂业务,任何情况都可以的。
分析不清楚:不要删除core文件 然后重来
请不要删除core文件,gdb可以打印任何信息。继续分析你core文件
反复 n次 这个浪费时间,
请时间浪费在分析core文件上,不是增加debug日志上
21:32 我清楚这个规则,下次一定不删除
Q4 【git】 git add -u 和 git add -A区别?
| 命令 | 新增文件 | 修改文件 | 删除文件 | 误加编译产物风险 |
|---|---|---|---|---|
<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">git add -A</font> | ✅ | ✅ | ✅ | 高(未跟踪的编译产物会被加入) |
<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">git add -u</font> | ❌ | ✅ | ✅ | 低(只处理已跟踪文件) |
<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">git add .</font> | ✅ | ✅ | ✅ | 中(取决于当前目录) |
新增文件 这个这个 包括代码编译临时结果 不安全
Q6 gdb跟踪core,只要分析清楚愿意,自然100%解决问题
验收标准 ,写不出来,说不出来 说明流程不清楚,继续分析 感觉不行,无法盘
3个小时分析 不是浪费 节省至少8个小时。
步骤:
1、 投入更多时间分析愿意上
- 【5why1 为什么core】 一个数组总长度4,索引变成5,5 怎么来的
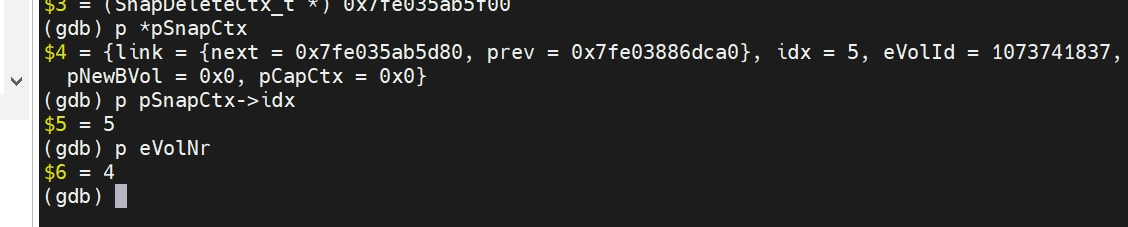
- 【5why2 5是分组前下标】流程图表示
- 【5why 3 缺失返回值设置逻辑】
【1 2 3 4 56】-->[12] [34] [56] 长度是2 但是下标大于2
通过绘图 你了解到 你遗留一个功能。
- 写都都是最终代码,不是临时代码,如果临时代码就不要写。
- 池分组后 ,每个分组后的返回值 如何设置
- 全部写完毕,在编译,不要写一行编译一样,你有能力解决编译问题,不怕编译错误,因为避免90%时间都在重复编译。
- 4总结 全部写完毕后 ,然后在编译。不需要写一次,编译一次。
- 开始产生core,到core文件产生完整 需要过程
Q7 开发安排
- 批量删除10个删除成功 【在返回post失败报错来哦】
- 批量删除10个有故障情况删除成功(包含池故障)
- 批量删除512*200个删除成功
- 代码内存泄漏和bus调整
【验收标准 上面不符合设计-开发--测试流程】【结果测试耗时比开发还长,测试步骤最终代码 ,反复测试】!!!
Q9:core问题如何解决?[没有解决 需要复盘bug号xxx] 【没有解决】
- 这里不考虑解决复杂问题,不内核 从基本的问题处理步骤开始
- 通过commit id确保 获取二进制正确版本 git checkout commid_id
<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">git checkout a1b2c3d</font> | 检出 <font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">a1b2c3d</font>这个提交 | 分离头指针状态(HEAD 直接指向 commit,不指向任何分支) |
|---|
平时你提交代码时,<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">HEAD</font> 是指向某个分支(比如 <font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">master</font>)的,分支再指向最新的提交。
当你执行 <font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">git checkout <commit_id></font> 时,<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">HEAD</font> 会越过分支,直接指向那个历史的提交节点
如果你在 <font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">Detached HEAD</font> 状态下修改了代码并 <font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">git commit</font>,这些新的提交不属于任何分支
对 只查看 不提交
Q10: 文件系统 性能慢 90%原因 读盘慢有关系?【没有解决,没有寻找清楚】
IO 流程是什么,不同存储系统实现方式不的,liunx默认文件系统,数据库,存储,采用存储引擎 和处理方式不一样的。这个基础 如果不了解,无法定位
LVM池(逻辑卷管理池)抽象了什么?
LVM池是对底层物理存储资源的抽象。
- 抽象了物理硬件的差异:底层可能是不同品牌、不同容量、不同介质(HDD、SSD、NVMe、PMEM)的磁盘。LVM池把它们揉成一个统一的“大资源池”(由
<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">DSM</font>磁盘段管理负责分配<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">dSeg</font>)。 - 抽象了空间分配与回收:上层业务不需要关心数据具体落在哪块盘的哪个扇区。LVM池提供了逻辑卷(Logical Volume)的概念,支持在线扩容、瘦分配(Thin Provisioning)、快照等高级功能(由图1中的
<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">LCS</font>逻辑控制服务负责)。
<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">small卷</font>、<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">big卷</font>、<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">persist卷</font> 等,既不是直接存储用户数据的空间,也不是普通意义上的内存,它们本质上是“元数据(Metadata)的逻辑管理单元”。
。所以这里的 <font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">small/big/persist卷</font>,是用来存放“用户数据在哪里”的映射记录的。
表(Table)。这是一个很自然的抽象:
| 你的概念 | 抽象为数据库概念 | 在Ceph/RocksDB中的实现 |
|---|---|---|
| Small卷 | 小数据对象元数据表 | 可能是一个独立的列族,存储小IO的映射关系 |
| Big卷 | 大数据对象元数据表 | 另一个独立的列族,存储大IO的映射关系 |
| Persist卷 | 持久化元数据表 | 可能是一个专门的列族,用于存放需要绝对持久化的关键元数据 |
以Ceph为例,它的底层存储引擎 BlueStore 就是这种设计的典型代表。BlueStore 在 RocksDB(一个基于LSM-Tree的KV存储引擎)中维护了多个 Namespace(命名空间) 来隔离不同类型的元数据。
**<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">O</font>******(Object) 命名空间:存储对象本身的元数据,比如对象名、大小、创建时间等。**<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">B</font>******(Block) 命名空间:存储块分配信息,即数据块在磁盘上的物理位置,这类似你图中的“映射记录”。**<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">C</font>******(Collection) 命名空间:存储集合(类似Pool或PG)的元数据,用于管理对象的归属和分布。
这种设计的核心优势在于隔离:将不同类型、不同访问模式的元数据分开管理,可以避免相互干扰,提升整体性能。例如,频繁更新的小对象元数据(<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">O</font>)和相对稳定的块分配信息(<font style="color:rgb(15, 17, 21);background-color:rgb(235, 238, 242);">B</font>)分开存储,能让缓存和压缩策略更高效。
Q11 不需要20台,raft等协议,传统的4台 分布式/集中式 存储系统 如何保证升主降备的?围绕这个每个业务模块都自己业务控制?
- 场景:服务重启
- 业务:逻辑单元 主 从
哪怕是2台控制器,这里2台设备,是很强的扩展能力
然后里面划分多个逻辑单元,必须明确 谁是主,输是从。
这个没有算法
- 故障检测逻辑:业务模块不负责,只注册回调,等通知 然后做各自状态切换