String 类中的 byte[] value
在String 类中 byte 是存储单位,char 是字符单位,两者不是一回事——所以不能通过遍历 byte 来遍历 String 中的每一个元素。
char 和 byte 的根本区别
char | byte | |
|---|---|---|
| 位宽 | 16 位无符号 | 8 位有符号 |
| 范围 | 0 ~ 65535 | -128 ~ 127 |
| 语义 | 一个 UTF-16 码元(半个或整个字符) | 一个原始字节,没有字符含义 |
| C 类比 | unsigned short / wchar_t | signed char / int8_t |
| 默认值 | '\u0000' | 0 |
关键点:char 是 Java 里唯一的无符号类型,它是为 Unicode 设计的;而 byte 只是 8 个 bit,跟 "字符" 没有任何绑定关系,只有当全是 ASCII 字符时,String 才使用一个 byte 存储一个字符,但是 byte[] 是 private ,实际上也不能直接遍历,我们可以通过 getbytes() 方法返回一个新分配的 byte[],它是通过指定编码格式重新编码后的副本,不是 value 的引用,因此这个 byte[] 是可以修改的。
String 从 char[] 改成 byte[] 是怎么回事
JDK 9 之前 String 内部是 private final char[] value,每个字符雷打不动占 2 字节。但统计发现,实际应用中 绝大多数字符串只含 ASCII 字符,高 8 位永远是 0,纯属浪费。于是 JDK 9 引入 Compact Strings:
private final byte[] value;   // 存储
private final byte coder;     // 编码标记:0 = LATIN1,1 = UTF16
构造 String 时先试着用 LATIN1 编码,只要所有字符都 ≤ 0xFF 就存成 1 字节/字符;一旦出现中文、emoji,整串自动切换成 UTF16,退回 2 字节/字符。
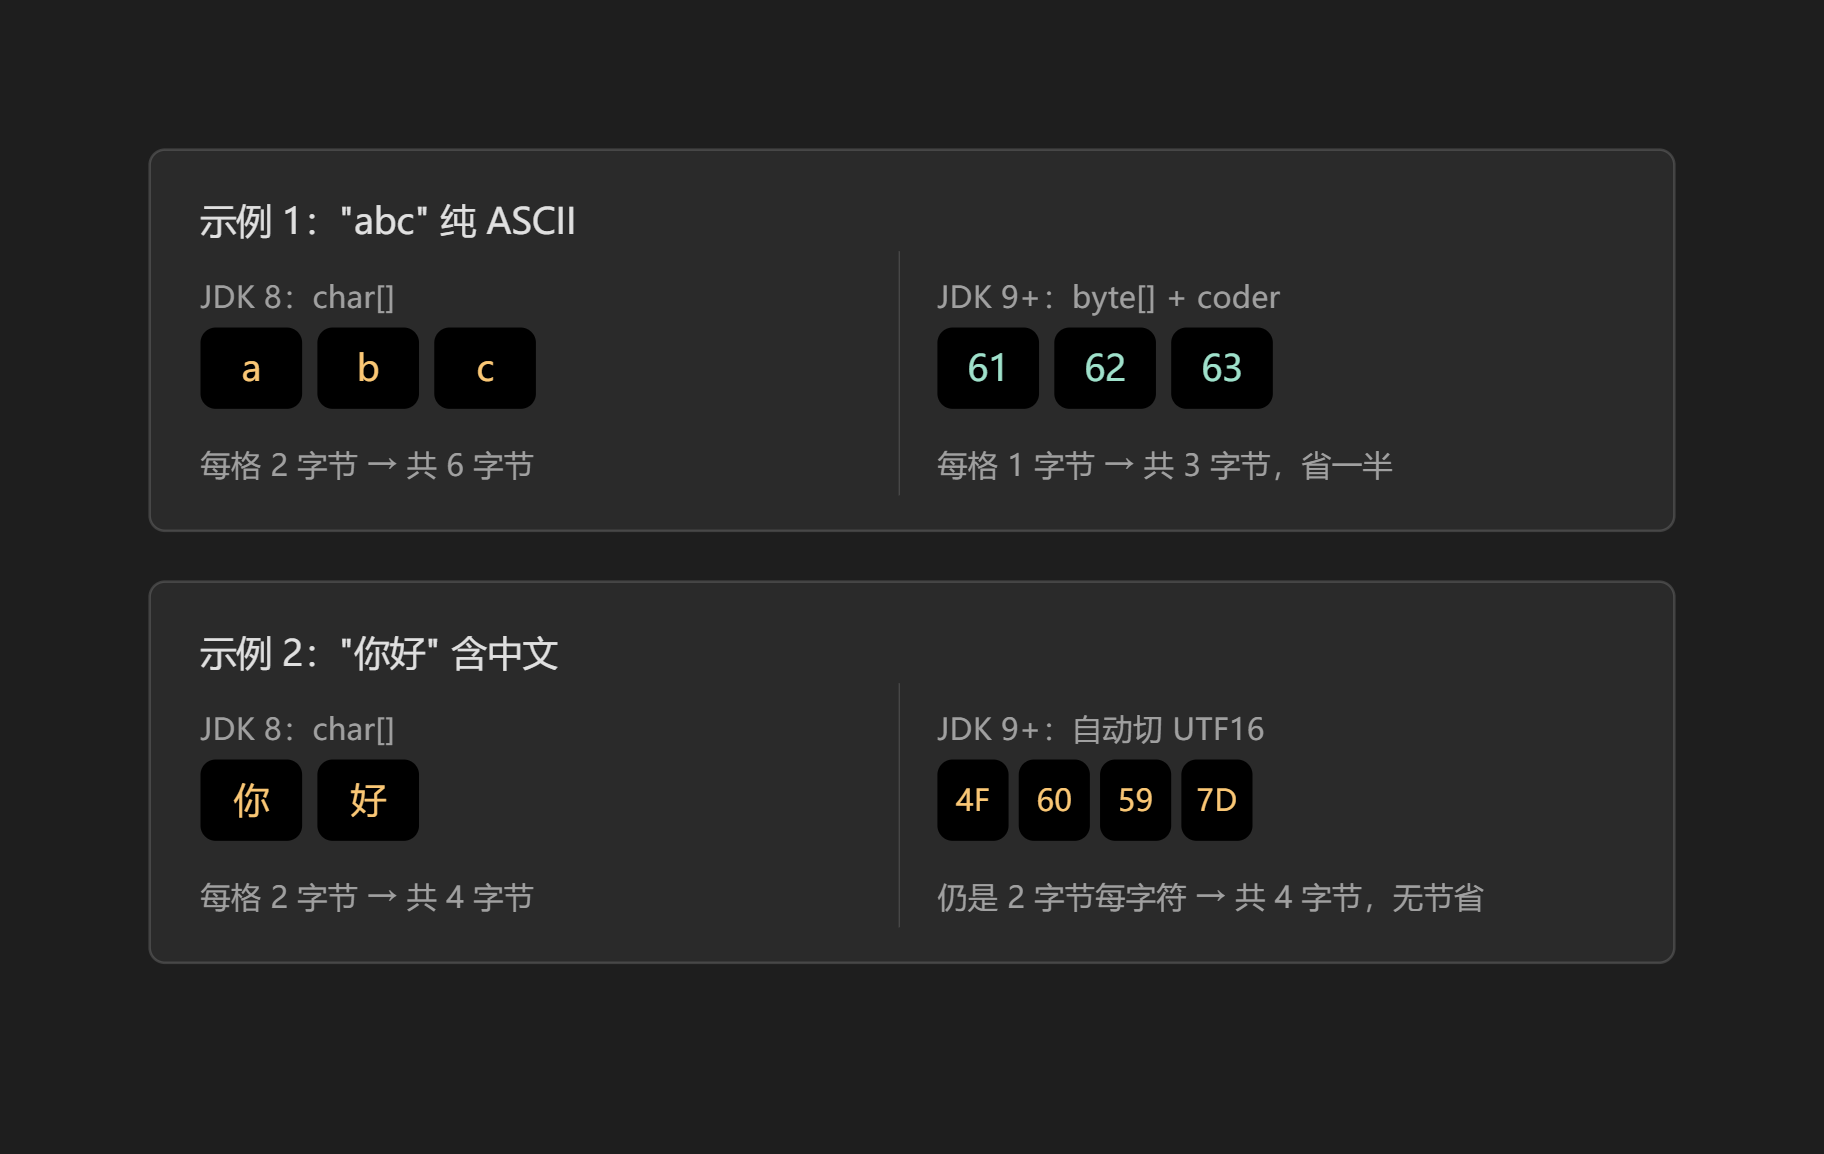
图上第二个例子是重点:Compact Strings 只对纯 ASCII 有效,混进一个中文就整串退化。使用 AI 实测了 200 万个 100 字符的字符串(字符数完全相同):
LATIN1 (100个ASCII字符 × 200 万个): 约 290 MB
UTF16  (100个中文字符 × 200 万个): 约 488 MB
byte[] 本身从 120 字节涨到 216 字节,正好翻倍;加上对象头的固定开销,整体差了约 40%~68%。
能不能直接遍历 byte?以及所有字符都只占两个或两个字节一下吗?
1. 你根本拿不到。 value 是 private final,想拿得靠反射,而且 JDK 17+ 之后模块封装还会直接抛 InaccessibleObjectException,必须加 --add-opens java.base/java.lang=ALL-UNNAMED。
2. 拿到了也读不懂。 光有 byte[] 不知道 coder 是 0 还是 1,同一个字节序列在两种编码下含义完全不同。
3. 更根本的问题:byte 是编码产物,不是字符。 实测输出:
原串: a你😀   length()=4   码点数=3   UTF-8字节数=8
  getBytes()  : 61 E4 BD A0 F0 9F 98 80   <- 这是字节,不是字符
同一个字符串里,a 占 1 字节、你 占 3 字节、😀 占 4 字节。UTF-8 是变长编码,字节边界和字符边界完全对不上。而 getBytes() 返回的是一份新拷贝,跟 String 内部的 byte[] 毫无关系。
最常用的遍历函数 charAt() 和 toCharArray()
for (int i = 0; i < s.length(); i++) {
    char c = s.charAt(i);
}
特点
- 不创建新数组
- 每次调用都从 String 里取第 i 个 UTF-16 code unit。
- Java 9+ 中 String 内部是 byte[] + coder,charAt() 每次可能要判断编码并解码。
- emoji、部分生僻字会被拆成两个 char。
char[] arr = s.toCharArray();
for (char c : arr) {
}
特点
- 会创建一个新的 char[],把字符串内容复制进去,有额外的内存开销
- 之后遍历的是普通数组,访问很快。
- 数组可以修改,但修改不会影响原 String。
正确的遍历方式
| 场景 | 推荐写法 |
|---|---|
| 确定只有 ASCII / 中文(99% 业务代码) | charAt() 或 toCharArray() |
| 可能含 emoji、生僻字(U+FFFF 以上) | codePoints() ← 推荐 |
| 要按"用户看到的一个字"处理(排版、截断、光标) | BreakIterator |
| 网络传输 / 文件 IO | getBytes(StandardCharsets.UTF_8) |
为什么 charAt 会出事
charAt : a(U+0061) 你(U+4F60) ?(U+D83D) ?(U+DE00)
😀 是 U+1F600,超出 65535,UTF-16 只能用两个 char 拼(代理对 D83D + DE00)。你按 char 遍历,一个 emoji 会被掰成两半,中间那半单独拿出来是个非法字符,打印出来就是问号。
换成 codePoints() 就正常了:
codePoints(): a(U+0061) 你(U+4F60) 😀(U+1F600)
// 推荐写法:按码点遍历,能正确处理 emoji 和生僻字
s.codePoints().forEach(cp -> {
    System.out.printf("%s (U+%04X)%n", new String(Character.toChars(cp)), cp);
});

// 需要带索引统计字符数(注意 count 要用码点数,不是 length())
int count = s.codePointCount(0, s.length());   // a你😀 -> 3,而 s.length() 是 4
总结
byte是存储层的字节(变长、无语义),char是字符层的 UTF-16 码元(定长、emoji 会占两个),码点才是你心里的"一个字符"。遍历 String 请忘掉 byte,无脑用codePoints()。
- char(16 位无符号)是字符单位,byte(8 位有符号)是存储单位,两者不在同一层。
- Compact Strings 只对纯 ASCII 省空间,串里混进一个中文就整串退化为 UTF16
- 遍历 String,无脑用
codePoints()
另外:s.length() 返回的是 char 个数不是字符个数,a你😀 长度是 4 而实际只有 3 个字符。以后做"限制输入 10 个字"这类需求,用 length() 会出现用户输 5 个 emoji 就被截断的 bug。