一、一个听起来很美的承诺
需求是这样描述的:设计师在 AE(或者 Unity)里做好一个片头,导出成一个素材包,上传到后台,用户下次打开 App 就能用。不发版,不过审,不改代码。
第一次听到这个承诺的人通常会觉得:不就是定个 JSON 吗?
然后你真的定了一个 JSON,跑通了第一个素材包,上线。接下来的三个月里你会依次遇到这些事:
- 设计师换了个人,新导出的包在端上动画时间对不上——第一帧是对的,播到一半开始漂。
- 同一个包在 16:9 上完美,切到 9:16 整个特效跑到画面外。端上不崩,就是难看。
- 后台上架了一个用了新字段的包,老版本 App 的用户下载下来渲染出一片空白——不崩溃,没有日志,客服那边只收到"这个模板是坏的"。
- 你想给协议加一个字段,结果发现端上有半打页面各自解析了一遍同一份 config,每处对"字段不存在"的兜底还不一样。
这些问题没有一个是渲染问题。它们全是协议问题。
这篇讲的是:一套"让设计师零发版上线特效"的素材协议,真正难的地方在哪。我会用一套真实在跑的模板素材格式做解剖对象——为了保密,字段名按通用叫法重写过,但结构、机制和数量级都是真实的。结论那一节可以搬到任何"用数据驱动 UI/渲染"的场景:Lottie 之外的自研动画格式、游戏的关卡配置、低代码页面的 schema,形状是一样的。
二、先看清这份数据长什么样
一个模板素材包解压出来大致是这样:
theme_xxx/
├── config.json          # 包清单:这个模板由哪些片段组成、音乐是谁、支持哪些画幅
├── icon.png             # 封面
├── music/
│   └── Dynamic Beats.m4a
├── 00/  data.xml        # 片段 0(片头)
├── 01/  data.xml        # 片段 1(转场)
├── 02/  data.xml
└── ...
两层协议,职责完全不同,这一点很重要:
第一层,包清单(config.json):描述"这个模板是什么",端上的业务代码读它——决定列表里怎么展示、支持不支持竖屏、片头片尾能不能改文字、用哪首背景音乐。
{
  "effectList": [
    { "type": 2, "path": "01/", "duration": 1000, "start_time": 0, "end_time": 0 },
    { "type": 3, "path": "00/", "duration": 1000,
      "text_color": "#FFFFFF", "text_bg_color": "#00000000", "text_wh_ratio": 0.1 },
    { "type": 4, "path": "05/", "is_water": 1, "text_wh_ratio": 0.1 }
  ],
  "supportSizes": [1, 2, 3, 4, 5],
  "musicConfig": "{\"zh\":\"Dynamic Beats\",\"en\":\"Dynamic Beats\",\"path\":\"music/Dynamic Beats.m4a\"}",
  "filterId": 16,
  "isTransRand": 0
}
第二层,场景描述(每段一份 data.xml):描述"这一段画面怎么动",渲染引擎读它,业务代码一个字都不该碰。
<root version="0.3">
  <textures>
    <texture id="0" wrap="0" file="0.png" />
  </textures>
  <materials>
    <material id="0" shader="texture" texture_id="-100" mask_id="-1"
              offset="0,-0.5" scale="1,1" color="1,1,1,1" />
  </materials>
  <scene duration="1" frame_rate="30" play_mode="0">
    <screens>
      <screen name="" aspect="1.78">
        <projection_matrix>0.112,0,0,0, 0,0.2,0,0, 0,0,-0.002,-1.0, 0,0,0,1</projection_matrix>
        <view_matrix>1,0,0,0, 0,1,0,0, 0,0,-1,-10, 0,0,0,1</view_matrix>
        <object name="Quad" type="mesh" mesh_id="0" id="0" material_id="2">
          <transform position="0,-0.32,-1" scale="10,-1,1" rotation="0,0,0,1" />
          <animations>
            <curve name="position.y">-0.32,-0.32,-0.32, ... </curve>
            <curve name="color.a">0.0094,0.0094,0.036,0.078,0.13,0.198, ... </curve>
          </animations>
        </object>
      </screen>
    </screens>
  </scene>
</root>
看清楚 <curve> 里是什么:不是关键帧,是一串逐帧采样值。 这是整个设计里第一个、也是最重要的决定。
三、坑一:烘焙——设计工具的语义不能进协议
AE 里一条属性曲线可以携带:贝塞尔缓动手柄、表达式、父子层级约束、时间重映射、运动模糊。Unity 里还可以挂粒子系统、物理、脚本。
如果协议直接把这些搬过来,端上就得实现一个 AE。这不是工作量问题,是不可能对齐的问题:你实现的贝塞尔求值和 AE 的差 0.001,设计师就会说"和我做的不一样",而且他说得对。
所以这套协议的选择是:在导出期把所有曲线求值成逐帧数组,端上只做"取值 + 线性插值"这一件事。
代价是体积。看几个真实数字(都来自同一套素材):
| 片段 | 时长 | 曲线条数 | 单文件大小 |
|---|---|---|---|
| 片头 | 1s | 210 | 54.9 KB |
| 转场 | 1s | 1680 | 383.6 KB |
| 主特效 | 10s | 4438 | 9.3 MB |
| 主特效 | 20s | 2588 | 7.9 MB |
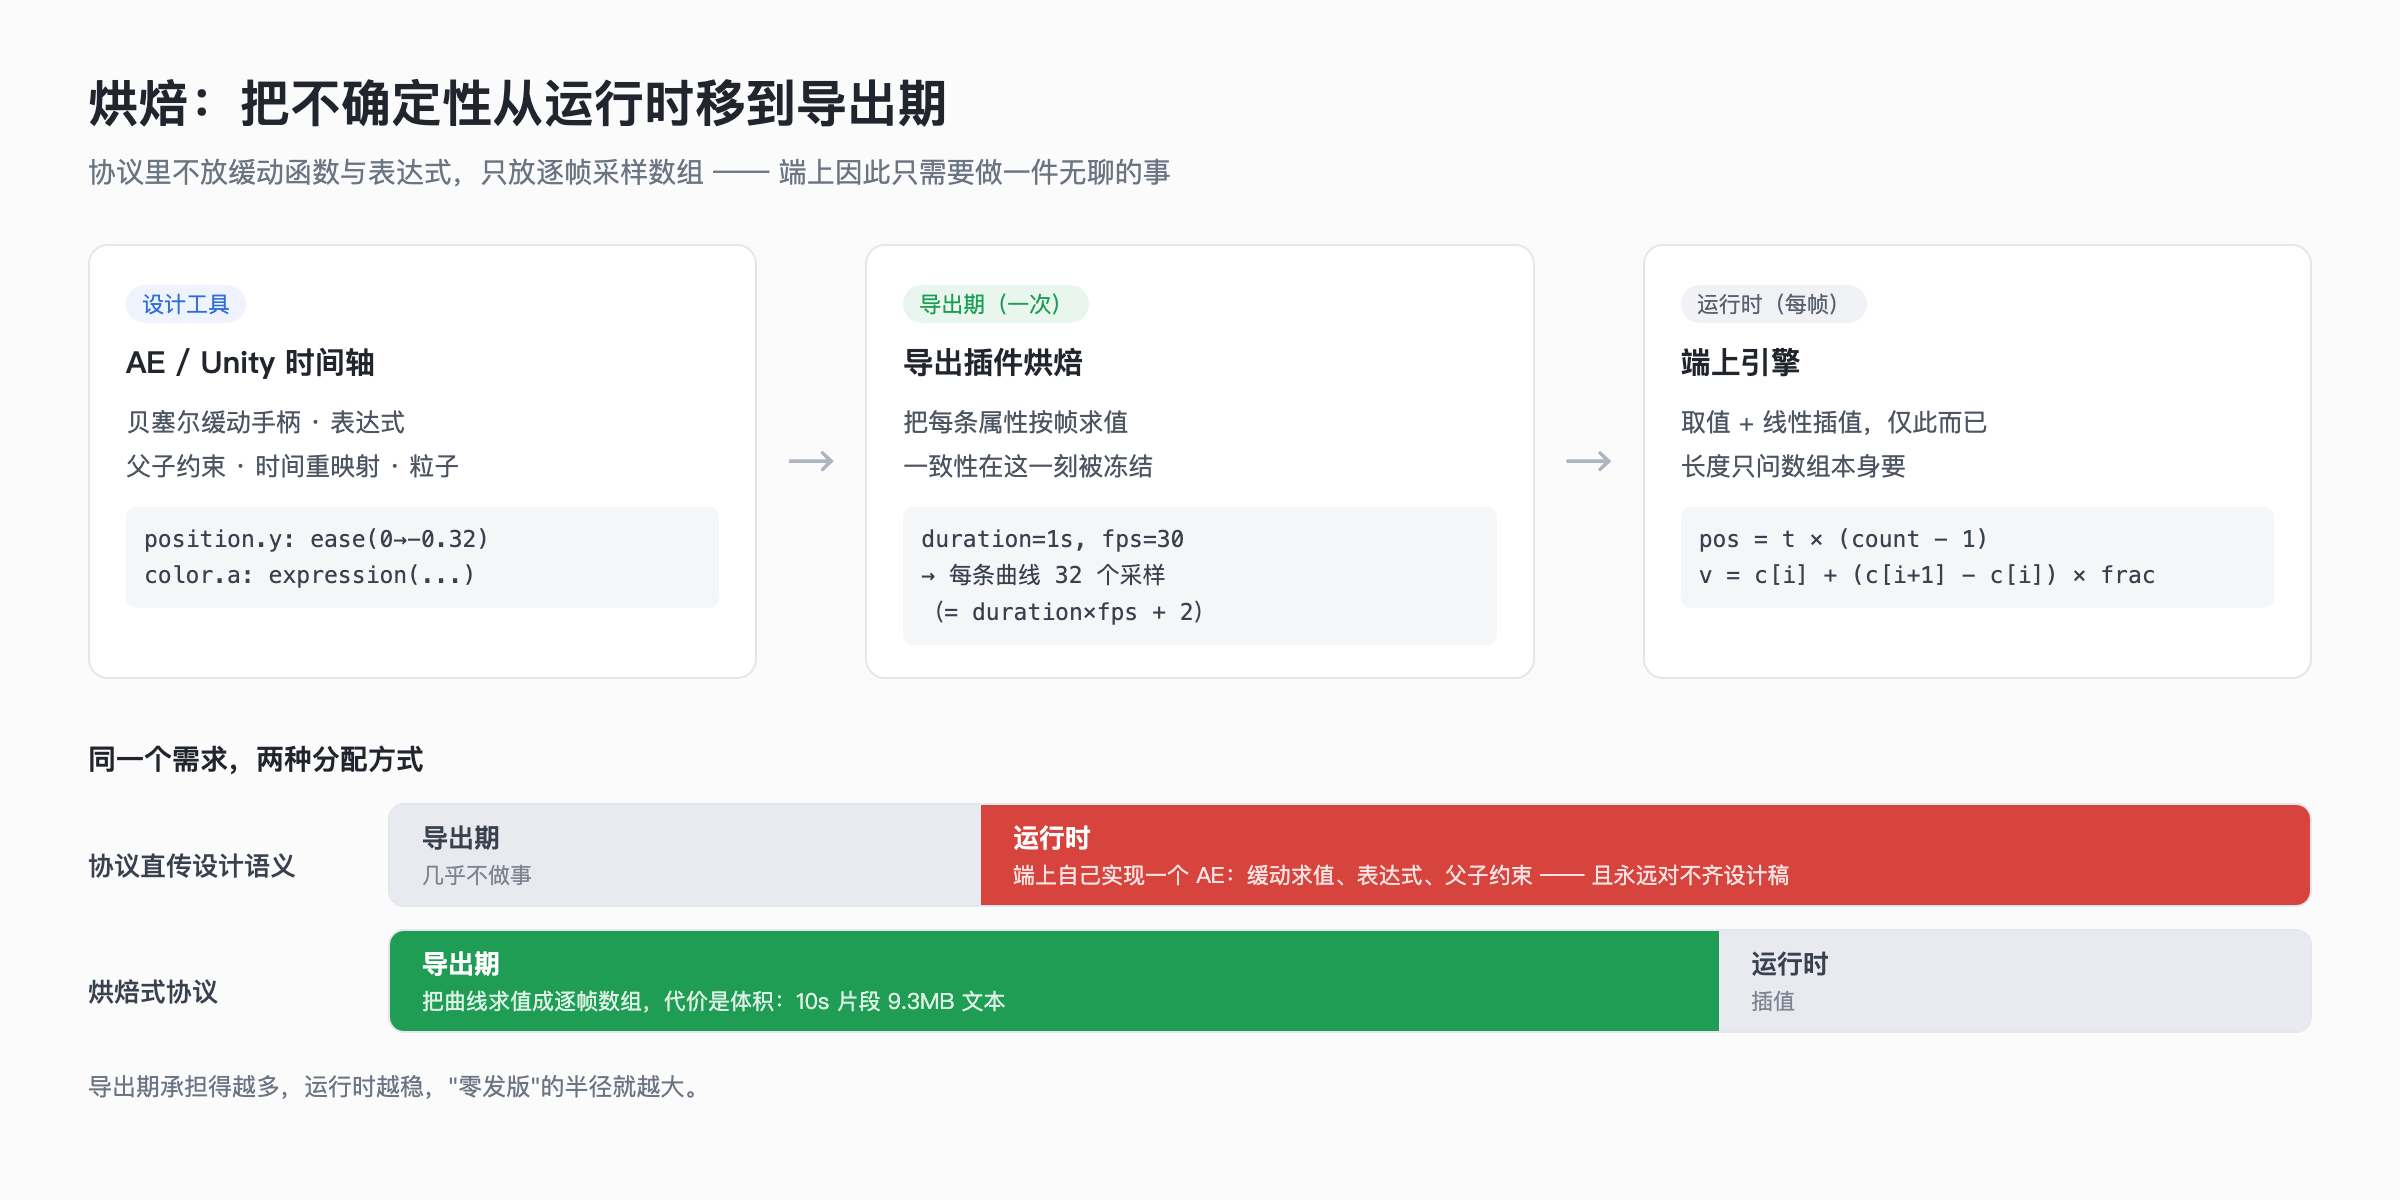
一个 10 秒的片段,光是描述动画的文本就 9.3MB。这是把不确定性从运行时搬到构建期要付的钱。
收益是:端上的求值逻辑可以写进一屏,而且它永远不会和设计稿不一致——因为一致性在导出的那一刻就被冻结了。
然后是第一个真正的坑。数一下采样点个数:
duration=1、frame_rate=30的片段,每条曲线 32 个值duration=2的,62 个duration=3的,92 个
不是 30、60、90,也不是 31、61、91。是 duration × fps + 2。
多出来的两个是端点/收尾采样——具体是首尾哨兵还是别的约定,要看导出器。重点不在于 2 是怎么来的,而在于:
任何"我按
duration × fps算出长度然后索引"的端上代码,从第一帧起就是错的。
正确的求值只依赖数组自己的长度:
/// 按归一化时间在烘焙曲线上取值。curve 是导出期烘焙好的逐帧采样。
/// 注意:长度只能问数组本身要,不能用 duration × fps 推。
func sample(_ curve: [Float], atNormalized t: Float) -> Float {
    guard let first = curve.first else { return 0 }
    guard curve.count > 1 else { return first }

    let clamped = min(max(t, 0), 1)
    let pos = clamped * Float(curve.count - 1)   // 用 count-1 做跨度,不是 count
    let i = Int(pos)
    if i >= curve.count - 1 { return curve[curve.count - 1] }

    let frac = pos - Float(i)
    return curve[i] + (curve[i + 1] - curve[i]) * frac
}
这段代码很平庸,这正是它该有的样子。协议设计得好不好,看的就是端上这段代码有多无聊。
四、坑二:同一个文件里,曲线不等长——而曲线不带时间
上面那张表里有两个"主特效"片段,它们和别的片段有一个结构性差异,是我数采样点的时候才发现的。
早期片段里,所有曲线的采样数完全一致(1s 的全是 32)。但在后来导出的那两个大文件里,同一个 XML 内部,曲线长度从 24 到 602 不等:
- 10s@30fps 的那个包:满长度应该是 302,而 317 个对象里只有 273 个是 302,其余是 61、182、203、227、230、284……
- 每个对象内部的所有曲线长度一致,对象之间不一致。
原因不难猜:导出器升级了,对生命周期短的对象(比如只存在两秒的粒子)不再烘焙整个时间轴,只烘焙它活着的那几帧。省体积,合理。
问题在于——
<object name="Particle System_33" type="mesh" mesh_id="0" id="33" material_id="0">
  <transform position="2.12,0,-5" scale="1,1,1" rotation="-0.707,0,0,0.707" />
  <animations>
    <curve name="position.x">...61 个值...</curve>
  </animations>
</object>
<object> 的属性只有 name / type / mesh_id / id / material_id。<curve> 的属性只有 name。
这 61 个采样对应整个 10 秒里的哪 61 帧,文件里没有写。
你可以猜:从 0 开始?在场景中间?按 (i / (n-1)) 归一化拉伸到全场景?三种猜法会给出三个完全不同的画面,而它们对同一份文件都"解析成功"。
这就是我在这套协议上学到的最值钱的一条:
破坏兼容性的往往不是字段的增减,而是某条从没写进协议的隐含不变量被悄悄改掉了。
"所有曲线等长、索引即帧号"这条不变量,在第一版里是成立的,所以没人觉得需要写下来。它活在导出器作者和引擎作者的共同默契里。等到导出器做了个完全合理的优化,默契就断了——而断掉的地方没有任何报错,只有"动画有点怪"。
字段增减至少还能被 schema 检查出来。不变量不会。
实务上的应对有三条,按性价比排:
- 把不变量写进协议文档,并且写成可执行的校验。哪怕只是一个 50 行的 Python 校验脚本挂在素材上架流程里:曲线长度必须要么等于
duration × fps + 2,要么对象上带显式的frame_start/frame_count。校验脚本比文档可靠,因为它会 fail。 - 能显式就别隐式。短曲线这个优化本身没错,错在优化引入了新语义却复用了旧结构。正确做法是加
frame_start字段,老端上读不到它就当 0——降级明确。 - 端上遇到不满足不变量的数据,要么按声明的兜底走,要么整包拒绝,不要"尽力而为地猜"。猜出来的画面比空白更难排查。
五、坑三:插槽——用户内容从哪里进去
模板不是动画播放器。它的价值在于用户的照片、视频和文字能长进特效里。
看回那个 <material>:
<material id="0" shader="texture" texture_id="-100" ... />
<material id="1" shader="texture" texture_id="-101" ... />
<material id="7" shader="texture" texture_id="0"    ... />
texture_id 正数指向 <textures> 里包内自带的图;负数是占位符——约定好的几个负值分别代表"用户当前片段的画面"和"用户输入的文字渲染出来的贴图"。设计师在 AE 里摆一个占位图层,导出插件把它写成负 id,端上在渲染前把真实纹理绑上去。
为什么是负数,而不是老老实实加一个 "slot": "user_media" 字段?
这不是偷懒,是一个有理由的权衡:
- 类型不变。
texture_id永远是 int,老解析器不用改类型、不用加分支就能读完整个文件。 - 失败形态可控。一个不认识插槽机制的旧引擎拿到
-100,在纹理表里找不到,绑一张默认白图或者干脆不画——画面缺一块,但不崩。相比之下,多一个它不认识的字符串字段,很多手写解析器会直接抛异常。
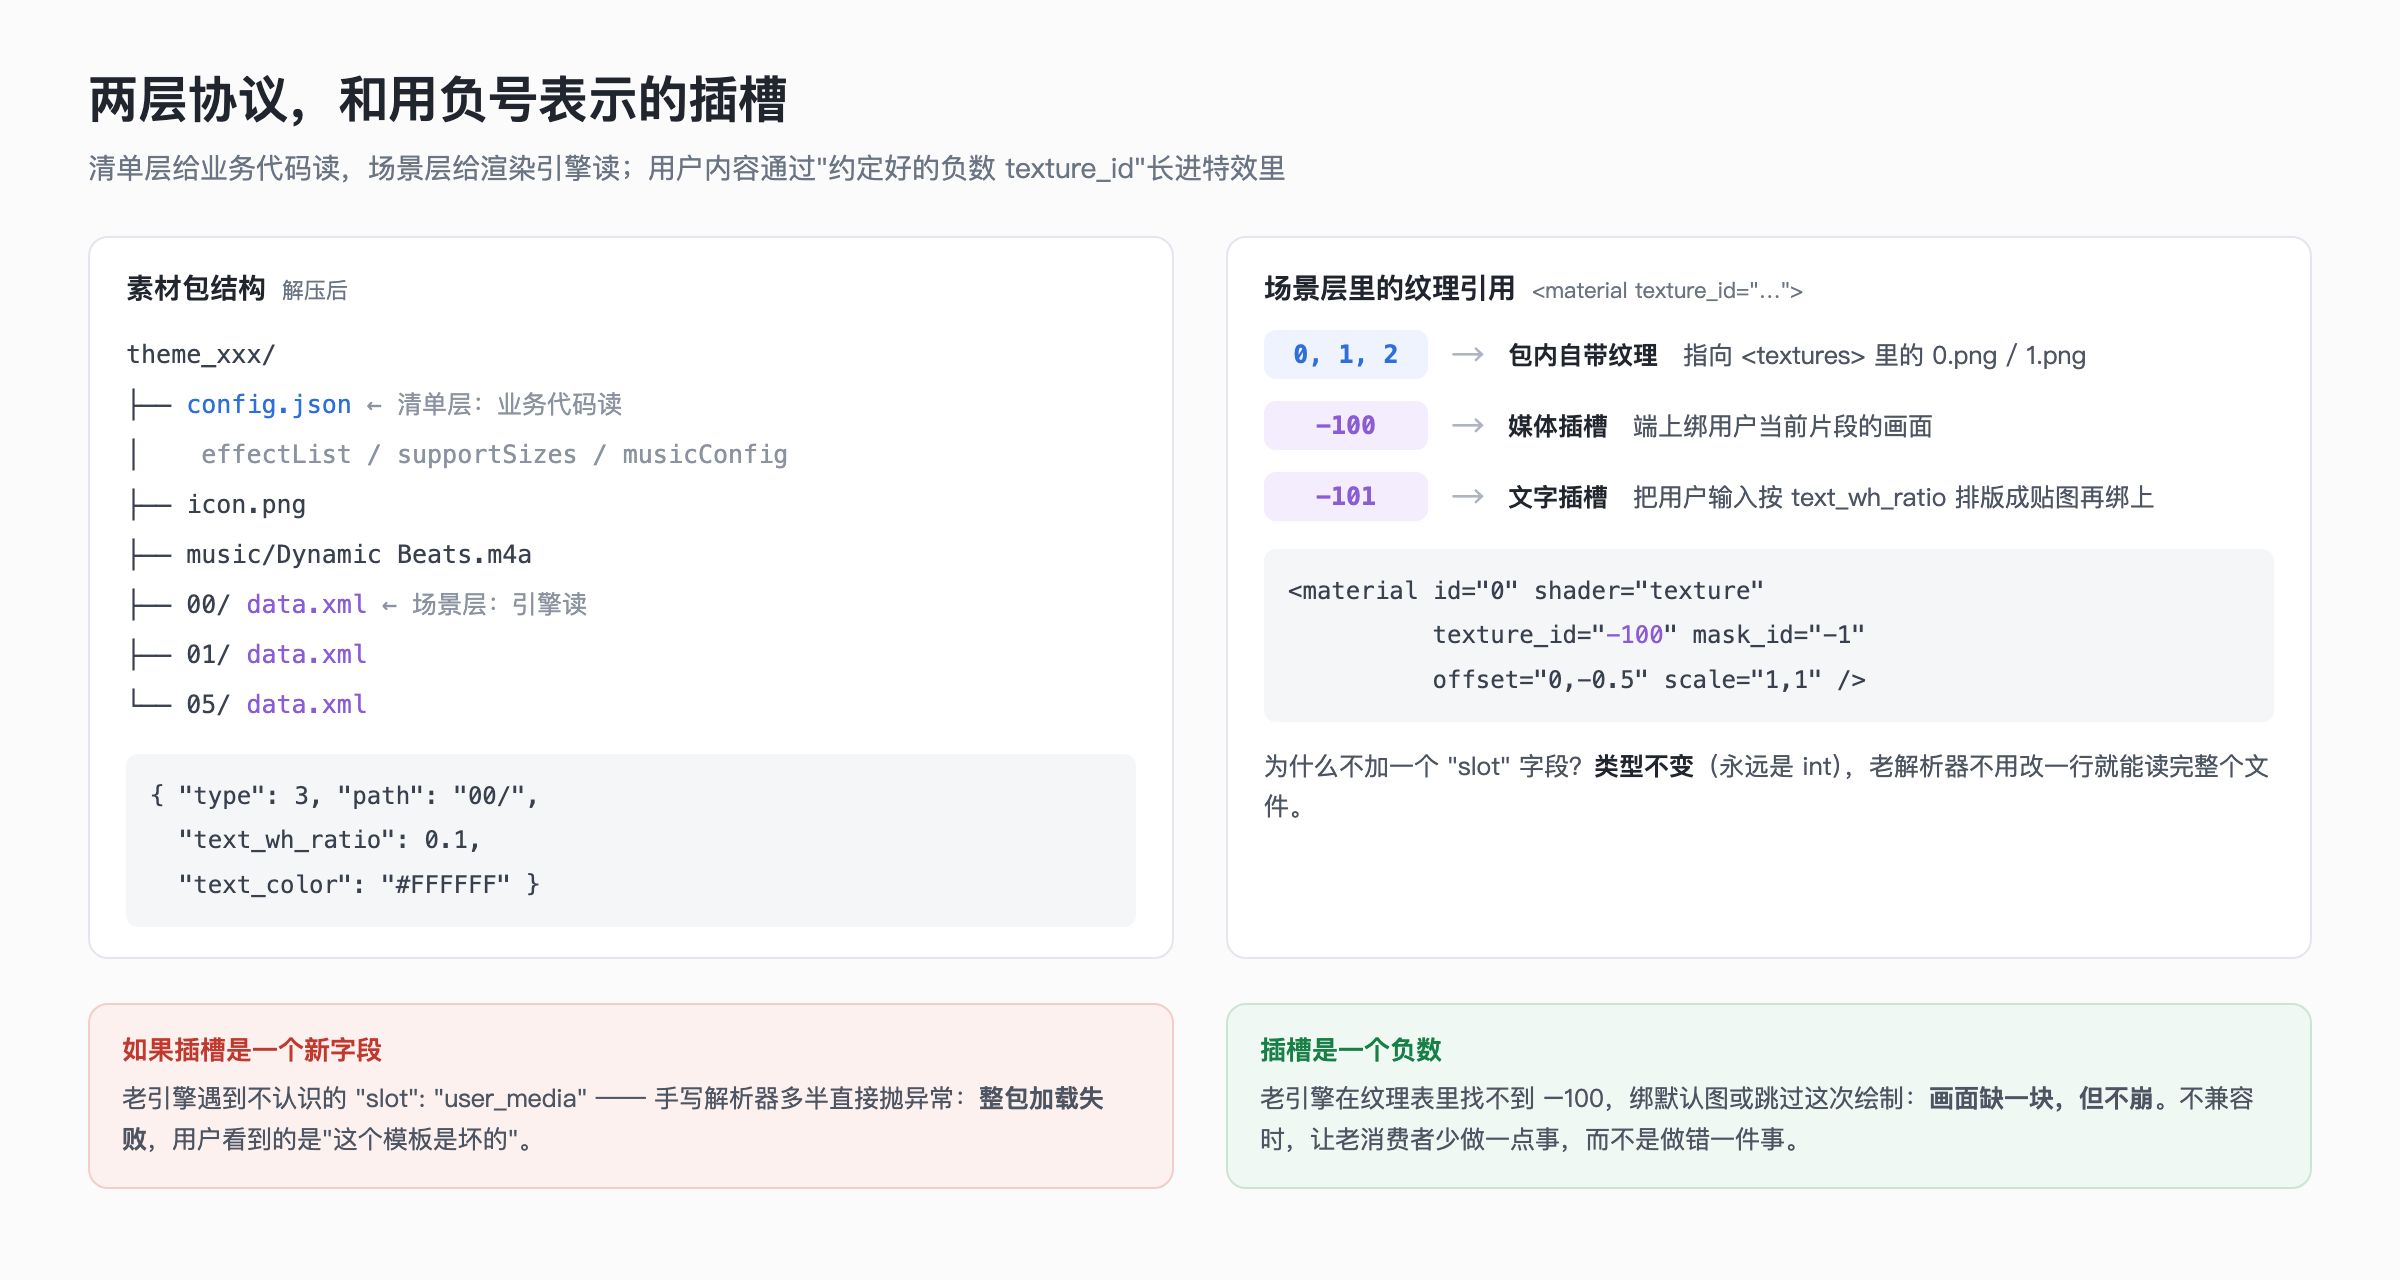
这是协议设计里一条经常被低估的原则:不兼容的时候,数据应该让老消费者"少做一点事",而不是"做错一件事"或者"直接死"。 负数占位符是这个原则的一个很朴素的实现。
文字插槽要复杂一点,因为文字不只是纹理——它有字号、颜色、底色、对齐、字体:
{ "type": 3, "path": "00/",
  "text_color": "#FFFFFF", "text_bg_color": "#00000000", "text_wh_ratio": 0.1 }
text_wh_ratio 是文字区域的宽高比:端上按它把用户输入排版成一张贴图,再送进 -101 那个槽。字符串长了怎么办、换行不换行、CJK 和拉丁字母混排怎么算宽度——这些全在端上,协议只给一个比例。
这个设计的后果,就是下一个坑。
六、坑四:能力协商——"零发版"的真正边界在哪
端上要回答一个问题:这个模板,要不要给用户展示"修改片头文字"的入口?
真实代码里的答案是这样的(重写成等价示意):
// 片头/片尾是不是独立片段:看 duration 有没有大于 0
BOOL hasHeadOrTail = (headEffect.duration > 0 || tailEffect.duration > 0);

// 有没有文字位:看 text_wh_ratio 这个可选字段存不存在、是不是大于 0
if (headEffect.text_wh_ratio.floatValue > 0) {
    model.isShowModifyTitle = YES;
}
看出问题了吗?"这个模板支不支持改文字"这件事,协议里从来没有显式声明过。 端上是靠"某个可选字段存不存在且大于零"反推出来的。
同样的事还发生在画幅上:
NSArray *sizes = config[@"supportSizes"];   // 比如 [1,2,3,4,5]
model.isSupportVertical = [sizes containsObject:@(4)] || [sizes containsObject:@(5)];
4 和 5 是什么意思?只有端上代码知道。协议里是五个裸整数。
再加一条:素材在后台有 version_code,但那是用来判断"这个包有没有更新"的,不是"这个包需要多新的引擎"。也就是说——
后台可以上架一个用了新字段的素材,而老版本的 App 完全不知道自己不该碰它。
这三件事合起来,就是"零发版上线"这个承诺的真实边界:
能零发版上线的,从来不是"特效",而是"其能力已经在协议里被显式声明过"的那部分特效。
任何靠端上启发式推断出来的语义(字段存不存在、数值大不大于零、整数是不是 4 或 5),都锁死在了当前这个版本的端上代码里。设计师做出协议没描述过的东西,就一定要发版。
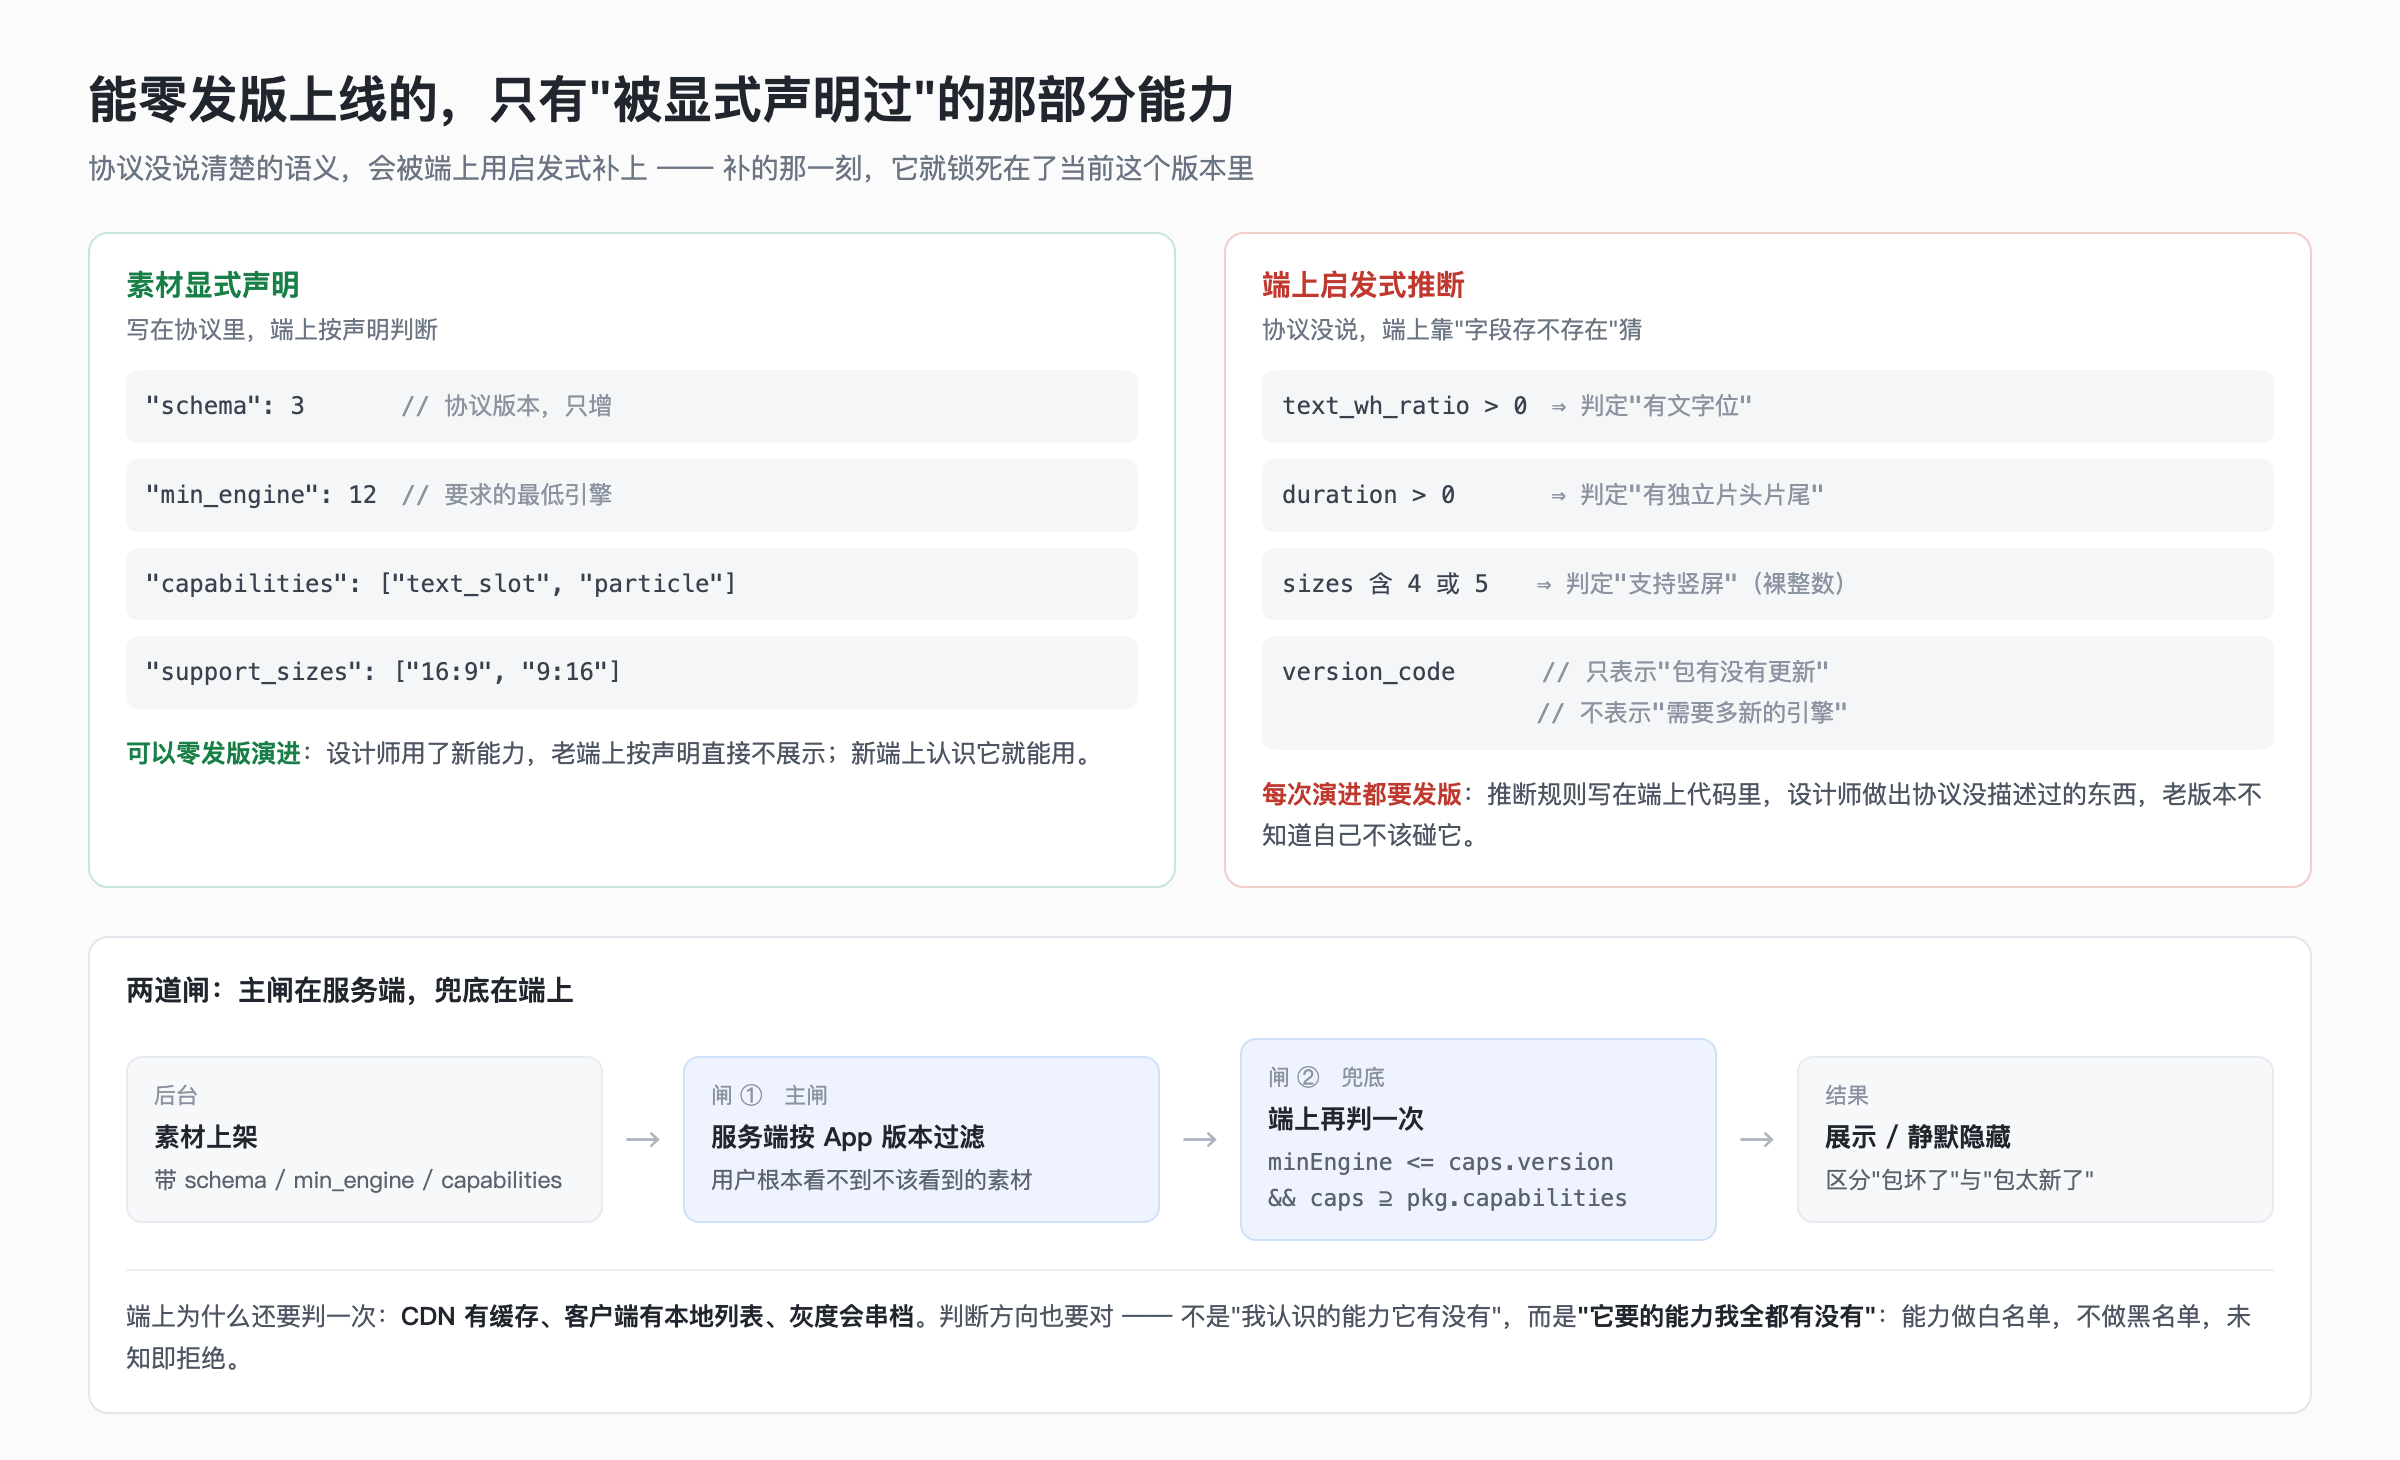
所以能力协商应该是协议的一等公民,而不是事后补丁。最小可用的形状:
{
  "schema": 3,                       // 协议版本,整数,只增
  "min_engine": 12,                  // 需要的最低引擎能力号
  "capabilities": ["text_slot", "media_slot", "particle", "mask"],
  "support_sizes": ["16:9", "9:16", "1:1", "4:3", "3:4"]
}
配套的两道闸:
- 服务端按 App 版本过滤列表——这是主闸,用户根本看不到不该看到的素材。
- 端上再判一次:
material.min_engine > engineVersion或capabilities里有自己不认识的项 → 不展示、不下载。这是兜底,因为 CDN 有缓存、客户端有本地列表、灰度会串档。
struct EngineCaps {
    static let version = 12
    static let supported: Set<String> = ["text_slot", "media_slot", "particle", "mask"]
}

func canUse(_ pkg: MaterialManifest) -> Bool {
    guard pkg.minEngine <= EngineCaps.version else { return false }
    return pkg.capabilities.allSatisfy { EngineCaps.supported.contains($0) }
}
注意第二个判断的方向:不是"我认识的能力它有没有",而是"它要的能力我全都有没有"。 前者会让未知能力静默通过,后者才是"未知即拒绝"。八个字:能力做白名单,不做黑名单。
七、坑五:协议能不能演进,取决于端上有几个解析入口
这条和格式本身无关,但它决定了前面所有设计能不能兑现。
在那套真实工程里,supportSizes 这一个字段的解析,散落在半打以上不同的页面文件里——素材列表页、运营活动详情页、相册选片页、时间轴模板面板、剪同款页……每一处都是从头 JSONObjectWithData 解析一遍 config,然后各自判断 containsObject:@(4)。
后果不是"代码丑",是:
- 加一个字段要改半打文件,而且总会漏掉一处——漏掉的那一处不会编译报错,它只会在某个入口表现得和别的入口不一样。
- 每处对"字段缺失"的兜底不同:有的默认 YES,有的默认 NO,有的直接
break。同一个包,从不同入口进去行为不一致。 - 想加一层"能力协商"的拦截,得在半打地方都加。
于是有了这条:
协议的可演进性 = min(格式设计的前瞻性, 端上解析层的收敛度)。
格式设计得再好,端上有六个解析入口,它的演进速度就是那六个入口里最保守的那个。
解决方案不高级,但必须有人做:
/// 素材包的唯一入口。业务代码只拿 MaterialPackage,永远不碰原始 JSON。
struct MaterialPackage {
    let id: String
    let schema: Int
    let minEngine: Int
    let capabilities: Set<String>
    let supportSizes: Set<AspectRatio>
    let hasTextSlot: Bool        // 显式字段解析而来;缺失时按 false,而不是靠猜
    let segments: [Segment]
    let unknownKeys: [String: Any]   // 保留未知字段,透传给引擎,不丢弃

    static func load(at url: URL) throws -> MaterialPackage { /* 唯一一处解析 */ }
}
三个细节值得强调:
- 默认值写在一处,而且写成常量表,谁都能查。
- 保留未知字段。新素材带了老端上不认识的键,解析器不该丢掉它们——透传给引擎,将来引擎升级了就能用。"解析器丢弃未知字段"是很多协议无法平滑升级的隐形元凶。
- 解析失败要区分"包坏了"和"包太新了"。前者报错删除重下,后者静默隐藏。混成一个"加载失败",线上就没法定位。
八、坑六:JSON 套 JSON,和裸整数枚举
两个小坑,但它们出现的频率高得惊人。
第一个:被转义的 JSON 字符串。
"musicConfig": "{\"zh\":\"Dynamic Beats\",\"en\":\"Dynamic Beats\",\"path\":\"music/xxx.m4a\"}"
音乐配置是一个字符串,内容是 JSON。为什么会这样?几乎总是同一个原因:某一层(服务端表结构、导出工具、老版本兼容)只接受字符串,于是有人把结构塞进去了。
代价是实打实的:
- schema 校验穿不透这层字符串,里面写错了没人拦。
- 转义嵌套容易坏,尤其是素材名里带引号、带反斜杠、带 emoji 的时候。
- 多语言塞在里面,从 2 种语言扩到 20 种语言时你会发现它根本没法扩。
如果历史包袱已经存在,至少做一件事:在唯一解析层里把它展开成强类型结构,别让这个字符串流到业务代码里。
第二个:裸整数枚举。
"type": 2 / 3 / 4 / 5,含义只在端上代码里。老素材包里的 type 序列是 [5,2,5,2,5,2,5,2,3,4],新素材包是 [5,2,1]——多出来一个 1。协议文档不更新的话,这个 1 对任何人都是谜。
用字符串枚举("transition" / "opening" / "ending")的好处不是"可读",而是:未知值可以安全跳过。type: "kenburns" 这种老端上不认识的值,跳过它顶多少一个效果;而一个不认识的整数 1,落进 switch 的 default 分支很可能被当成某个默认类型渲染出来——错得无声无息。
顺带说一个同源的观察:字段是逐次增补的(新包比老包多了 totalDuration / clipNum / restricted_trans,音乐配置多了 musicType),全部是可选的增量字段,没有一次是改语义或删字段。这就是典型的 expand-then-contract:先扩展,让新老消费者共存,等老消费者退场再收缩。 已发布的协议就是契约——这一点在任何跨系统边界上都成立,素材包只是它最容易被忽视的一种形态(它跨的是"设计工具 → 服务端 → N 个客户端版本"三道边界)。
九、第二代:为什么从 XML 走到二进制
前面那个 9.3MB 的 XML 是个信号。文本格式的代价在素材量级上来之后会集中爆发:解析慢、内存峰值高(整份 DOM 展开)、包体大、CDN 流量贵。
所以新一代引擎的场景文件换成了二进制帧流,形状大致是:
struct SceneHeader {
    char  flag[4];            // 魔数,第一时间拒绝不是自家的文件
    uint  version;            // 版本号在文件头,不在文件内部某个角落
    uint  resourceCount;
    uint  userDataCount;
    float duration;
    uint  frameRate;
    uint  frames;             // 帧数显式写死,不靠 duration × fps 推
    uint  dataStartPosition;  // 数据区起始偏移
};

struct ResourceHeader {       // 资源表:每项带偏移和长度
    uint id; uint type; uint position; uint size;
};

struct UserData {             // 定长记录:名字 32 字节,数据 256 字节
    uint id; byte name[32]; uint type; byte data[256];
};
几个设计动作值得拿走:
- 魔数 + 版本号放在文件最前面。读四个字节就能拒绝一个不该由你处理的文件。这一条在文本格式里也该做,但文本格式总让人觉得"反正能打开看",于是就省了。
- 资源表带
position+size。意味着可以按需加载单个资源、可以 mmap、可以跳过整块不解析。文本格式做不到这件事——XML 你必须从头扫到尾。 frames显式存储,正好消掉第三节那个"duration × fps推不出真实长度"的坑。设计二进制格式时把推导出来的量显式写下来,成本是 4 个字节。- 定长记录的代价要提前认:名字 32 字节、数据 256 字节,超了就截断或塞不下。所以长文本、长路径必须走资源区而不是 UserData。定长换来的是随机寻址和零分配解析——这笔交易在"读多写少、结构稳定"的素材数据上是划算的,在别处未必。
值得注意的是:从文本换成二进制,第三节到第八节那六个坑一个都没解决。不变量还是不变量,能力协商还是没有,枚举还是整数。格式是表达方式,协议是约定本身。换表达方式不会自动带来约定。
十、什么时候别自研这套东西
这一节比上面九节都重要,因为大部分团队的正确答案是"别做"。
特效数量少于二十个、且没有"设计师自助上线"这个硬需求 → 直接写代码。 协议的真实成本不是那份 JSON,是一整条链路:AE/Unity 导出插件(要有人长期维护,工具升级了它就坏)、素材校验工具、后台上架与灰度、CDN、多端一致性测试、以及端上永远要兼容所有历史版本的素材。这条链路的人力投入按年算。二十个特效硬编码,一个人两周。
只是贴纸、序列帧、简单的矢量动画 → 用 Lottie / APNG / WebP 序列。 Lottie 就是"AE 导出协议"这道题的工业级答案,它的 schema、导出插件、多端运行时都是现成的。自研的唯一理由是 Lottie 表达不了你要的东西(自定义 shader、粒子、用户媒体插槽、与视频轨道混合),而不是"我们想要个自己的"。
要自研,先问三个问题:
- 设计师用的工具链固定吗?(导出插件是长期负债,工具链一变就得重写)
- 特效里需要嵌入用户内容吗?(这是 Lottie 最弱的地方,也是自研最常见的正当理由)
- 需要 iOS / Android / Web 表现一致吗?(一致性是烘焙式协议的最大卖点:所有求值都在导出期完成,端上只做插值,天然一致)
三个都是"是",自研才划算。只有第三个是"是",多半还是该选现成方案。
十一、收尾:协议是一张"不确定性由谁承担"的分配表
如果只带走一句话,我希望是这句:
协议不是数据格式,是一张分配表——它规定了不确定性由谁、在什么时候承担。
烘焙曲线,是把"缓动怎么算"的不确定性从运行时移到了导出期,端上因此可以只做插值,也因此可以做到跨端一致。 插槽用负数占位,是把"老版本遇到新特性"的不确定性,从"崩溃或错误渲染"移到了"少画一块"。 能力协商,是把"这个包能不能用"的不确定性,从"用户点了才知道"移到了"列表里根本不出现"。
导出期承担得越多,运行时越稳,"零发版"的半径就越大。 反过来,任何被留到运行时才解决的不确定性——靠字段是否存在推断能力、靠裸整数推断角色、靠默契维持不变量——都会变成一次发版。
另外两条可以带走的:
第一,把隐含不变量变成可执行的校验。 协议文档会过期,人的默契会断。一个挂在素材上架流程里的校验脚本不会:它要么过,要么红。你每写下一条"这个值一定会……"的假设,就顺手把它写成一行断言。这一条对所有"上游产出、下游消费"的数据边界都成立——配置文件、埋点 schema、接口返回、模型的输入输出。
第二,先收敛消费端,再谈协议演进。 格式设计的前瞻性会被端上最保守的那个解析入口抵消掉。把解析收成一个入口、默认值收成一张表、未知字段一律保留透传——做完这三件事,协议才真的"可以改"。在此之前,你设计的不是协议,是一份永远只能加、不能动的历史包袱。
回到开头那个"不发版、不过审、不改代码"的承诺:它能不能兑现,从来不取决于你的渲染引擎有多强,只取决于你的协议把多少东西说清楚了。说清楚的部分可以零发版演进,没说清楚的部分,每一次都要发版——而且是在线上出问题之后。
如果你的模板特效"在某些素材上动画时间不对",先别查插值代码——先数一下那份素材里每条曲线有几个采样点,以及它们是不是都一样长。
关于本文的代码与数据
文中的 Swift / Objective-C / C 片段用于说明协议设计与解析思路,未逐行编译验证。素材包的字段名、目录名按通用叫法重写过,不对应任何产品的线上格式;引用的数量级(曲线条数、采样点个数、单文件体积、对象数量)来自对一组真实素材文件的静态统计,是格式机制层面的事实,不包含任何产品指标或业务数据。二进制头部结构为示意性重构,用于说明"魔数 + 版本 + 资源表 + 定长记录"这一类设计的权衡,不是任何具体实现的逐字还原。AE / Unity 的能力描述基于公开文档与通用认知。