Grok 4.7 进入 API 之后,很多开发者的第一反应是:如果项目已经使用 OpenAI 兼容 SDK,是不是只要替换一个 model 字段,就能把它接入现有应用?
从“能发出请求”的角度看,答案大致是肯定的;从“能够长期维护”的角度看,答案还差了不少步骤。模型名称、API Base、密钥权限、参数兼容、错误处理、时间敏感信息和日志追踪,任何一项没有确认,都可能让一个看似简单的 Demo 在进入业务后变得难以排查。
这篇文章以 RelayRouter 模型广场当前可见的 grok-4.7 为例,完整走一遍从最小请求到模型切换、日志记录和故障定位的流程。重点不是证明某个模型一定比其他模型更好,而是展示怎样把一次接入做得可复现、可比较、可替换。文中的代码可以直接复制后改成自己的配置,示例提示词也可以替换成客服、代码分析或文档整理任务。
先说明一个容易被忽略的边界:模型广场显示一个模型,不等于它自动拥有所有原厂产品能力。grok-4.7 可以作为标准聊天、视觉和工具调用的候选模型,但是否支持某个具体参数、某种搜索方式、特定上下文长度或某个预览能力,仍然要以当前接口文档和实际响应为准。不要因为模型名字里有“4.7”,就自行推断它包含某个产品版本的全部特性。
一、先确认这次接入到底要解决什么问题
在安装 SDK 之前,先把任务写清楚。模型接入并不是目的,能够稳定完成任务才是目的。比如“做一个客服 Agent”太宽泛,无法判断模型是否合适;如果改成“根据订单资料回答状态问题,必要时调用查询工具,资料缺失时转人工,并保留每一步日志”,就可以拆成多个可测试环节。
我通常会先把任务分成四层:输入层、推理层、工具层和反馈层。
输入层负责接收用户文本、图片、文件或经过转写的语音,并做格式、长度和隐私检查;推理层负责识别意图、提取参数、判断是否需要知识库或工具;工具层负责执行真实业务动作,例如查询订单、检索文档或计算价格;反馈层负责把结果转换成用户能够理解的回答,并明确说明不确定性和下一步操作。
这样拆分有两个好处。第一,模型输出不再被误当成最终事实,工具层的结果可以单独校验;第二,出现问题时可以定位是输入错误、模型判断错误、工具失败还是表达不清,而不是笼统地说“模型不行”。
如果只是测试长文档整理,可以先不接工具;如果要做代码排错,可以先不接图片;如果要做时间敏感的新闻分析,应先设计资料获取流程,再让模型分析。把任务范围缩小,反而更容易判断一次调用是否真的有价值。
二、准备三项配置:API Base、Key 和 Model Name
标准 OpenAI 兼容调用通常需要三项配置:API Base、API Key 和 Model Name。它们必须来自同一套账户和调用环境。
API Base 决定请求发往哪个兼容入口;API Key 决定身份、权限和计费归属;Model Name 决定具体路由到哪个模型。三项信息如果混用,例如 Base 来自测试环境、Key 来自另一个账户、模型名称又是从新闻标题手动拼出来的,结果很可能是认证失败或模型不存在。
建议把配置写成环境变量:
RELAYROUTER_API_BASE=从当前文档或控制台复制的API Base
RELAYROUTER_API_KEY=你的API密钥
RELAYROUTER_MODEL=grok-4.7
macOS 或 Linux 可以在终端中设置:
export RELAYROUTER_API_BASE="从控制台复制的 API Base"
export RELAYROUTER_API_KEY="你的 API 密钥"
export RELAYROUTER_MODEL="grok-4.7"
Windows PowerShell 可以这样设置当前会话变量:
$env:RELAYROUTER_API_BASE = "从控制台复制的 API Base"
$env:RELAYROUTER_API_KEY = "你的 API 密钥"
$env:RELAYROUTER_MODEL = "grok-4.7"
环境变量只是降低误提交概率,并不能替代密钥管理。不要把完整 Key 写进文章、截图、前端代码或公开仓库;不要把真实 .env 文件提交到 Git;开发、测试和生产环境应使用不同密钥。密钥一旦出现在日志或截图里,最稳妥的处理是立即撤销并重新创建,而不是只修改本地代码。
模型名称也不要手动添加后缀。当前模型广场可检索到 grok-4.7,并标注了 Chat、Tools、Vision 和 Thinking 等能力。这里的标签适合做初步筛选,但不等于每个参数都已在你的账户分组中开放。实际请求时,应从模型广场复制完整 Model Name,并保留一次最小调用作为基准。
三、安装兼容 SDK,先跑一个能判断对错的 Demo
安装 OpenAI Python SDK:
pip install -U openai
最小 Demo 不要一开始就写成复杂 Agent。它只需要完成四件事:读取环境变量、发送请求、打印返回模型、输出结果和用量。
import os
import time
from openai import OpenAI

api_base = os.environ["RELAYROUTER_API_BASE"]
api_key = os.environ["RELAYROUTER_API_KEY"]
model_name = os.getenv("RELAYROUTER_MODEL", "grok-4.7")

client = OpenAI(
    api_key=api_key,
    base_url=api_base,
    timeout=60.0,
    max_retries=2,
)

messages = [
    {
        "role": "system",
        "content": (
            "你是一名资深软件架构师。"
            "回答时区分已确认事实、合理推断和待验证信息。"
        ),
    },
    {
        "role": "user",
        "content": (
            "请设计一个多模型客服 Agent,"
            "要求包含意图识别、知识库检索、工具调用、"
            "失败重试和日志追踪。"
        ),
    },
]

started = time.perf_counter()

response = client.chat.completions.create(
    model=model_name,
    messages=messages,
    temperature=0.2,
    max_tokens=1200,
)

elapsed_ms = int((time.perf_counter() - started) * 1000)

print("请求模型:", model_name)
print("返回模型:", response.model)
print("耗时:", elapsed_ms, "ms")
print(response.choices[0].message.content)

if response.usage:
    print("用量:", response.usage.model_dump())
这里有三个值得保留的细节。
第一,base_url 通过环境变量读取。不同环境切换时,不需要修改业务代码;如果文档要求基础路径包含 /v1,也不会因为复制时漏掉路径而悄悄发往错误地址。
第二,同时记录请求模型和返回模型。平台可能存在别名、路由或分组映射,返回字段未必能证明底层全部版本信息,但它至少能够帮助发现明显的不一致。如果请求的是 grok-4.7,响应却出现另一个意外标识,应该先核对模型配置和平台文档。
第三,保留耗时和用量。一次回答看起来不错,并不能说明它适合生产。首字延迟、总耗时、输入输出 Token 和失败重试次数,都会影响用户体验与真实成本。
运行最小 Demo 时,建议使用公开资料或虚构数据。先确认网络、认证、模型权限和响应结构,之后再接入真实业务。不要用客户订单、内部源代码或包含个人信息的文本来验证“能不能调用”。
四、把模型名放进配置,才能真正实现切换
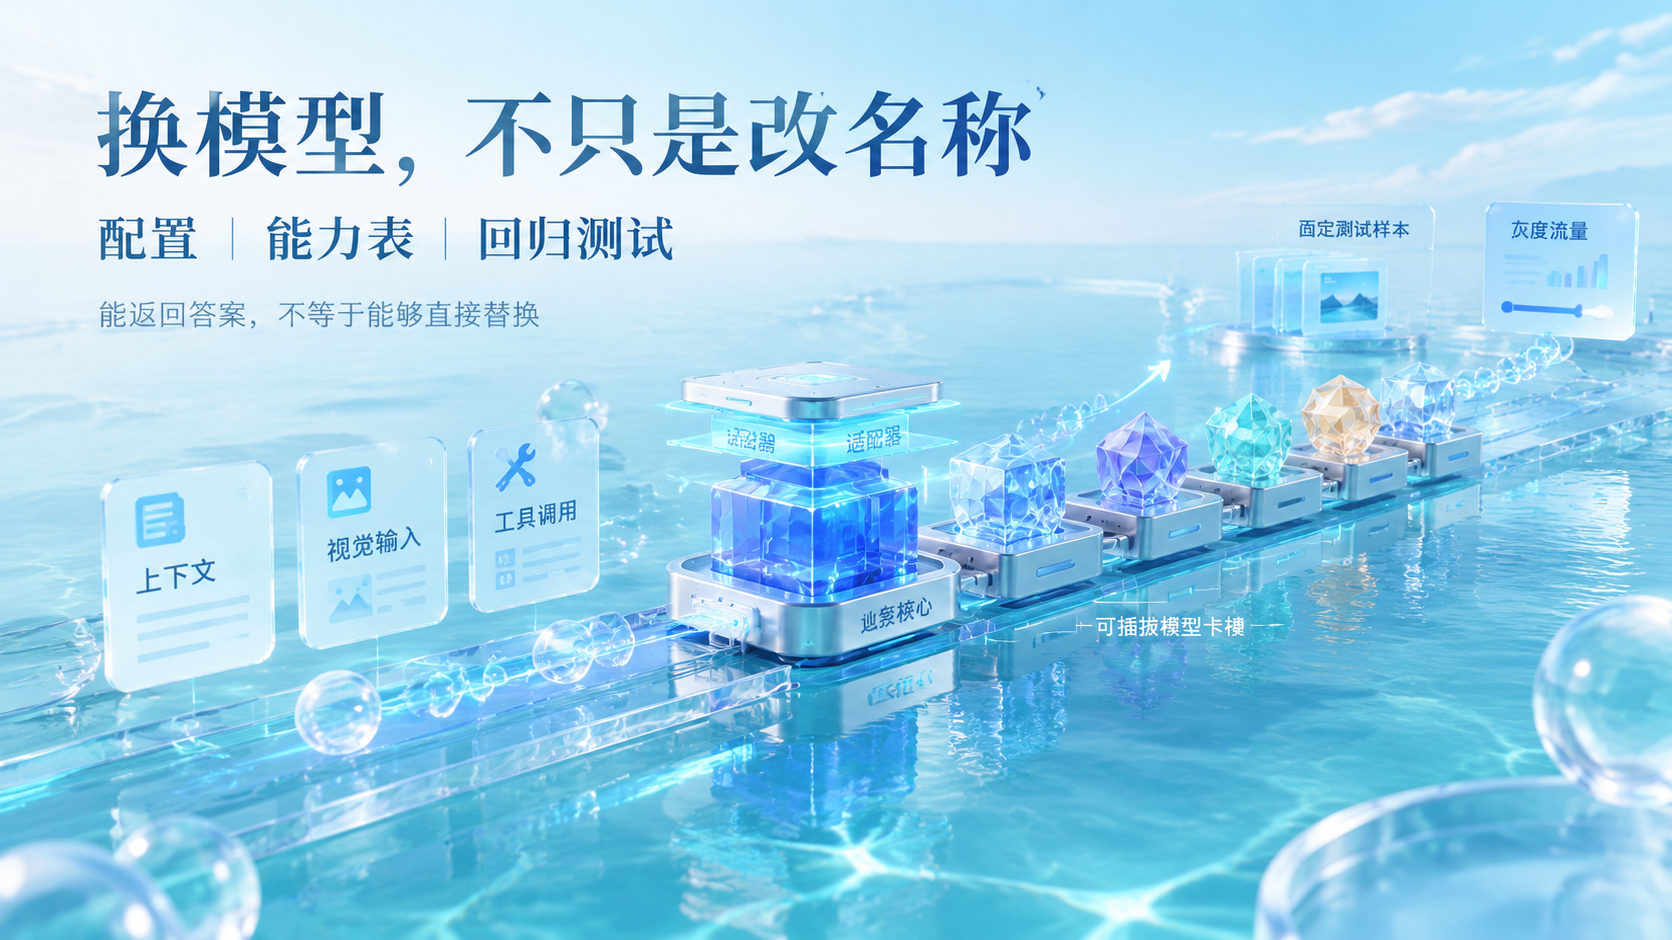
如果模型名称写死在每个调用函数中,切换一次模型就要搜索和修改多个文件。更稳妥的方式是把模型名视为配置,把业务逻辑视为稳定层。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["RELAYROUTER_API_KEY"],
    base_url=os.environ["RELAYROUTER_API_BASE"],
    timeout=60.0,
)

model_name = os.getenv("RELAYROUTER_MODEL", "grok-4.7")

def ask_model(prompt: str, model: str | None = None) -> str:
    selected_model = model or model_name
    response = client.chat.completions.create(
        model=selected_model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0.2,
        max_tokens=1200,
    )
    return response.choices[0].message.content or ""

if __name__ == "__main__":
    print(ask_model("把这份客服需求拆成开发任务、测试任务和上线检查项。"))
切换时只需要改变:
export RELAYROUTER_MODEL="另一个已在当前账户开放的模型标识"
不过,代码层面的可切换,不等于能力层面的可替换。不同模型可能在上下文长度、工具调用、视觉输入、结构化输出和推理参数上存在差异。切换前最好维护一张能力表,至少记录:支持哪些输入、是否支持工具、是否支持 JSON Schema、最大上下文、最大输出、平均延迟,以及是否通过项目回归测试。
比较模型时要固定测试数据和 System Prompt。可以准备三组样本:长文档整理、代码排错和 Agent 规划。每组再加入资料缺失、错误前提、工具超时和需要转人工的案例。不要只用一条“请介绍自己”判断模型好坏,那只能测出语言风格,无法反映业务能力。
如果需要灰度切换,可以让一小部分非关键请求使用新模型,同时保留请求模型、返回模型、延迟、用量和人工评分。只有当新模型在准确率、格式合规率、失败率和成本上达到预设标准,才扩大范围。模型能正常返回答案,并不代表它可以无条件替换旧模型。
五、Grok 4.7 的“最新信息”问题,不能靠模型名称解决
很多人看到 Grok 这类模型,容易默认它天然掌握请求当天的新闻、行情或政策变化。实际情况取决于当前接口是否接入搜索、知识库或其他外部数据源。一个标准聊天请求本身,并不会自动获得所有实时信息。
如果任务涉及“今天发生了什么”“当前价格是多少”“刚刚发布的政策如何规定”,推荐采用四段式流程:先获取资料,再整理来源和时间,随后提交给模型分析,最后输出结论与引用依据。
搜索、数据库或知识库获取原始资料
                ↓
记录来源、发布时间和抓取时间
                ↓
把资料与问题一起提交给模型分析
                ↓
输出结论、证据片段和不确定性说明
模型负责归纳、比较和解释,资料系统负责提供证据。不要把一句“请告诉我最新消息”当成搜索工具,也不要因为回答语气确定,就把没有来源的内容当作实时事实。
一个简单的资料注入格式可以这样写:
source_text = """
来源:某机构公告
发布时间:2026-09-21 10:00
内容:……
"""

prompt = f"""
请只根据下面的资料回答问题。
如果资料不足,请明确说明,不要补写具体事实。

资料:
{source_text}

问题:这项变化对现有客服流程有什么影响?
请分别输出:结论、依据、仍需确认的信息。
"""
如果资料来自搜索结果,应该保留原始链接、发布时间和抓取时间;如果来自内部知识库,应记录文档版本。多份资料互相矛盾时,不要让模型自行投票,应该把冲突显式交给模型,并要求它指出差异。
这套方法同样适用于代码库和企业文档。模型可以帮助总结、定位和提出方案,但事实依据仍应来自版本化的资料。对时间敏感任务而言,模型名称不是数据源,搜索或检索链路才是数据源。
六、日志不是“打印一下回答”,而是保留一次请求的证据
请求失败后,如果日志里只有一句“调用失败”,开发者几乎无法判断是 Key、模型、网络还是业务输入出了问题。一个最小的请求日志至少要包含:请求 ID、请求模型、返回模型、开始时间、总耗时、HTTP 状态或异常类型、重试次数、输入输出用量、业务任务 ID 和最终状态。
不要默认把完整提示词、客户文本、图片或工具返回结果写入日志。生产日志应尽量脱敏,必要时只保存内容摘要、哈希或字段统计。涉及语音、订单、身份证明和内部代码时,还要明确日志保留周期与访问权限。
可以定义一个简单的结构化事件:
import json
import time
import uuid

def log_event(event: str, **fields):
    record = {
        "event": event,
        "request_id": str(uuid.uuid4()),
        "timestamp": time.time(),
        **fields,
    }
    print(json.dumps(record, ensure_ascii=False))

log_event(
    "model_request_finished",
    requested_model="grok-4.7",
    returned_model="grok-4.7",
    latency_ms=842,
    transport_ok=True,
    task_ok=True,
)
实际项目中,request_id 应贯穿模型请求、知识库检索、工具调用和最终响应。这样用户反馈“刚才的答案不对”时,客服或开发者可以沿着同一个 ID 查看完整链路,而不是凭时间猜测是哪一次请求。
建议把技术成功和业务成功分开记录:
transport_ok=true
schema_ok=true
task_ok=false
failure_reason=缺少订单状态字段
HTTP 200 只能说明服务返回了内容,不等于回答满足业务要求。结构化输出失败、引用缺失、工具参数错误和事实不完整,都应作为业务失败记录。模型切换时,这些字段也能帮助比较不同模型,而不是只比较“有没有报错”。
七、常见错误应该怎样逐层排查
出现 401 或 403 时,先检查 API Key 是否完整、是否在当前进程环境中生效,再确认 API Base 和 Key 是否属于同一账户。之后检查当前模型是否对该 Key 开放,以及是否使用了错误的环境变量名称。不要一看到 403 就直接判断为余额问题,权限、分组和策略限制也可能产生相同状态码。
出现 model_not_found 或类似提示时,回到模型广场重新复制完整 Model Name。不要手动添加 -fast、-preview 或其他版本后缀,也不要把新闻标题中的产品名直接当 API 名。模型名称可能因为版本、分组和供应商映射发生变化。
出现 429 时,要区分请求频率、并发数、余额、额度和服务端限流。可以对没有外部副作用的请求采用指数退避,但应设置最大重试次数和随机抖动;如果是余额或权限问题,重试不会解决。高并发任务应在应用层增加队列,而不是让所有线程同时重发。
出现 5xx 或网络超时,可以检查网络连通性、客户端超时、服务状态和请求体大小。纯文本请求通常可以有限重试,但已经触发工具的请求必须先确认是否执行成功。否则第二次重试可能造成重复扣款、重复发货或重复通知。
请求成功但输出中断时,优先检查 max_tokens、客户端超时、代理连接和流式读取逻辑。若使用流式返回,客户端要处理连接中断、空事件和结束标记;不要因为收到第一个文本片段,就假设整段回答已经完整。
结果与预期不符时,固定 System Prompt、Temperature、输入数据和模型名称,再对比日志。不要同时更改提示词、模型、资料和参数,否则即使下一次结果变好,也无法知道是哪项变化起作用。对时间敏感任务,还要检查输入资料的发布时间和来源,而不是只看模型文字是否流畅。
一个实用的排查顺序是:配置 → 鉴权 → 模型标识 → 请求参数 → 网络与超时 → 响应结构 → 业务规则。按这个顺序检查,通常比反复修改提示词更快找到问题。
八、把图片、长上下文和工具调用逐步加进来
最小文本请求稳定后,可以按“一个变量一次增加”的方式扩展能力。
第一步是长文档整理。先把文档切分成明确片段,记录文档版本和来源,再要求模型输出摘要、待办、风险和引用片段。不要把超长文档一次性塞进请求,除非已经确认上下文限制、成本和响应时间都满足要求。
第二步是图片或视觉输入。图片要先做格式、尺寸和隐私检查;提示词要说明模型需要观察什么,例如识别表格结构、比较两张产品图,或找出截图中的错误信息。视觉输入的结果仍应经过业务校验,不能把模型对票据、证件或设备故障的判断当作最终结论。
第三步是工具调用。工具 Schema 要小而明确,服务端必须再次校验权限和参数。模型只能提出“查询订单”,不能直接访问数据库;它只能提供候选商品编号,不能绕过库存服务创建订单。工具失败时,应用要把真实错误返回给模型或直接转人工,不能允许模型编造成功消息。
第四步才是多模型路由。简单摘要可以走成本和延迟更低的模型,复杂代码分析使用能力更强的模型,涉及敏感数据的任务走通过审查的通道。路由规则应该写在配置或策略层,并记录每次选择原因。否则模型越多,系统越难解释。
RelayRouter 的统一 API 在这个阶段的价值,主要体现在减少一部分基础接入重复工作。开发者可以用相近的 SDK 结构测试不同模型,并把请求日志、评分表和回归集放到同一套程序中。但统一格式不代表所有高级能力完全一致,扩展到视觉、工具或结构化输出时,仍需逐项查文档和实际验证。
九、三个适合先做的练习,以及一条更稳的上线路线
第一个练习是长文档整理。准备一份公开需求文档,让模型输出开发任务、验收标准、风险点和仍需确认的问题。评分重点放在是否遗漏条件、是否把推断写成事实、是否能够引用原文依据。
第二个练习是代码排错。准备一段带有明确错误的代码和日志,让模型输出可能模块、检查顺序、最小复现方式和修复风险。不要只看它有没有给出正确修复,还要看它能否承认信息不足,避免把猜测写成确定原因。
第三个练习是 Agent 规划。要求模型把一个复杂目标拆成检索、判断、工具调用、复核和反馈步骤,再用虚拟工具返回成功、失败和超时三种结果。这个练习能较早暴露模型在工具参数、异常处理和状态表达上的问题。
如果要上线,建议分四阶段推进。第一阶段只做最小文本请求,建立固定测试集和结构化日志;第二阶段加入知识库和工具,但继续使用文本交互;第三阶段加入视觉输入、长上下文和流式输出;第四阶段再做按任务路由、灰度切换和备用通道。
每个阶段都要保留退出条件。例如:请求成功率达到目标,关键字段格式合规,工具失败不被伪装成成功,敏感数据不进入普通日志,单次任务成本在预算内。没有退出条件的迭代,很容易变成不断增加模型和参数,却没有真正提高系统质量。
结语:接入新模型,真正要复用的是方法
RelayRouter 接入 Grok 4.7 的基础动作并不复杂:准备 API Base、Key 和 Model Name,安装兼容 SDK,完成一个最小请求,再把模型名称和日志放进可维护的配置层。但真正值得复用的,不是某一段固定代码,而是一套排错方法。
先确认任务,再确认模型;先记录请求模型和返回模型,再讨论效果;先建立时间敏感资料链路,再分析“最新信息”;先把工具权限和重试边界写清楚,再让模型参与自动化;先用固定测试集做比较,再决定是否切换。
Grok 4.7 可以作为长文档整理、代码排错、视觉理解和 Agent 规划的候选模型,但模型名称本身不会自动带来实时事实,也不会替你解决权限、数据和业务责任。统一 API 能减少一部分接入摩擦,却不能取消模型差异和生产治理。
如果你准备开始验证,最小闭环可以只有四步:用脱敏数据完成一次文本请求,记录真实返回模型和耗时;用固定样本跑三类任务;模拟 401、429、超时和工具失败;最后再决定是否增加视觉、长上下文或多模型路由。这样即使最后不采用某个模型,测试过程也会留下可迁移的工程经验。
需要核对当前模型名称、账户配置和公开接口信息时,可查看一次:RelayRouter 模型与控制台入口
说明:本文依据撰写时可见的公开模型广场和接口资料整理,不构成对模型效果、价格、持续可用性或特定功能的承诺。模型目录、参数和计费方式可能调整,实际调用前请以最新控制台、接口文档和服务条款为准。