Dify 路由实测:判断模型的 400 倍怎么算出来
在 Dify 这类编排平台里,一个分类或路由节点通常就是一个 LLM 节点。你让它读用户输入,吐回一个标签。
要拿一个标签,付的是整段推理的输出成本。这笔账一直不太对,只是过去没人认真算。
市面上出现了「不生成自然语言、只输出结构化判断与概率」的判断模型,官方宣称在特定工作流里便宜 400 多倍。这篇文章不复述这个数字,而是把它拆开算一遍:**400 倍需要什么前提。**顺带交付一个可跑的审计脚本,含成本模型、schema 护栏和校准抽检。
一、为什么分类和路由不该用生成式模型
先看任务形态。
分类、路由、评分、信息提取、护栏检测,这五类任务的共同点是:**输出空间极小,而且已知。**标签是 4 个也好、20 个也好,都是枚举值。判断结果不是一段话,是一个选择加一个置信度。
用生成式模型做这类任务,多付的成本有三块。
第一块是输出长度。为了维护对话风格,模型会先解释再给结论,输出几十到几百个 token 里的绝大部分与标签无关。
第二块是解析逻辑。你得从自然语言里把标签抠出来,而这个解析器本身就是一个新的失败点。比如模型写成「这更像退款而非账单问题」,你的关键词匹配先命中「账单」,标签就错了。这种情况在规则式解析里非常常见。
第三块是多轮开销。有些编排里为了稳定输出,会加一步「自我检查」,等于同一笔成本付两遍。
**不是模型不够强,是工具选错了规模。**拿一个通用推理模型去返回一个枚举值,就像用全文检索引擎回答一个是非题。
二、判断模型在强调什么,以及它的边界
据官方发布信息,前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 发布了首款模型 Jev,定位是「智能 if 语句」:不生成自然语言,直接输出结构化判断与概率(来源:TypeSafe AI 官方发布 2026-09)。训练方法为并行采样器加 RLCD 校准,目标场景正是分类、路由、评分、信息提取与护栏检测。同期公司完成 4000 万美元种子轮。
官方给出的量级是:在特定工作流中最高快近 200 倍、便宜 400 多倍。
这里有三条边界必须写在前面,否则后面的数字会误导人。
第一,评测为自建。「快 200 倍」这类数字来自厂商自己的工作流,不是第三方基准。
第二,宣称的「0% 错误率」来自 schema 机制保证,意思是结构不合法的输出会被直接拒绝,不代表判断本身正确。这两件事经常被混为一谈。
**第三,校准效果仍待第三方验证。**概率输出准不准,直接决定了它能不能进自动化链路。
带着这三条边界,再去看 400 倍这个数字,问题就变成一个可算的题了。
三、把「便宜 400 倍」拆成可测的因子
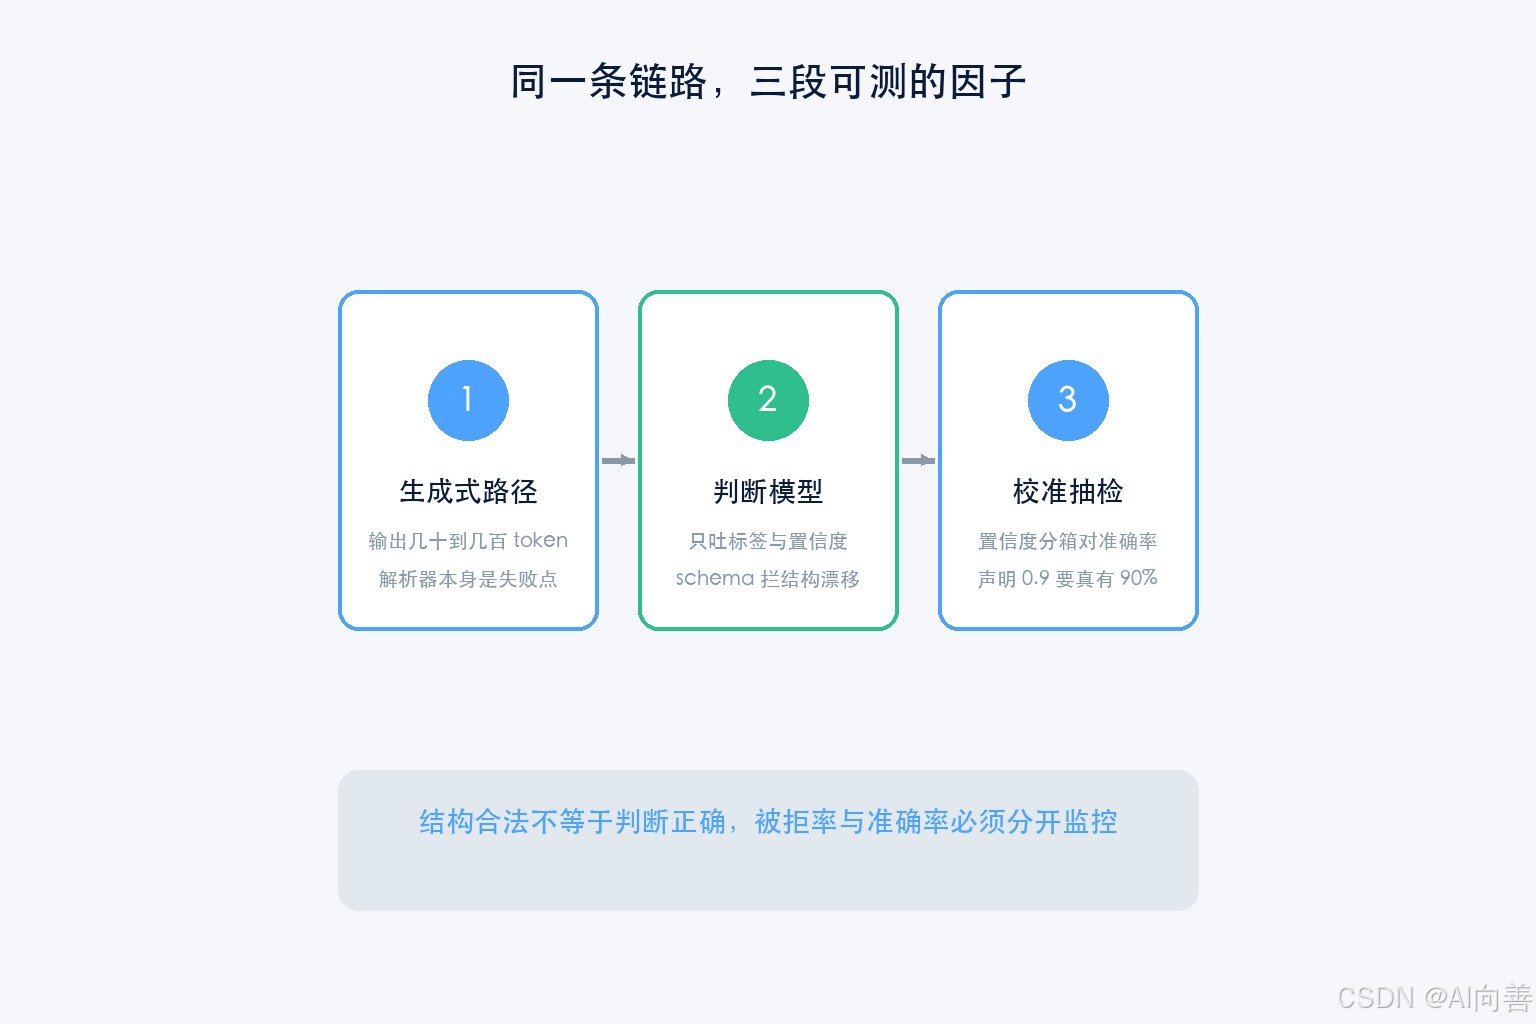
单次调用成本可以写成一行公式:
单次成本 = (输入 token × 输入单价 + 输出 token × 输出单价) / 1e6
于是一条路径比另一条便宜多少,只由三个因子决定:输入 token 数、输出 token 数、两侧单价。
关键观察在这里:输入 token 数在两条路径上通常是一样的,因为读的是同一段用户输入。如果输入单价也相同,那么输入成本成为两条路径的共同底噪,它会压住倍数上限。
这一条我是在写脚本时被自检打脸才意识到的。最初的敏感度表只扫输出长度,算完发现倍数怎么都上不去。于是把脚本改成扫描「生成式路径轮数 × 单轮输出 token」,实测结果如下(python route_cost_audit.py --report):
  轮数=1  gen_out=  96  生成式 $0.00270  =>    2.1x
  轮数=1  gen_out= 384  生成式 $0.00702  =>    5.5x
  轮数=1  gen_out= 768  生成式 $0.01278  =>   10.0x
  轮数=2  gen_out= 384  生成式 $0.01404  =>   11.0x
  轮数=4  gen_out= 384  生成式 $0.02808  =>   21.9x
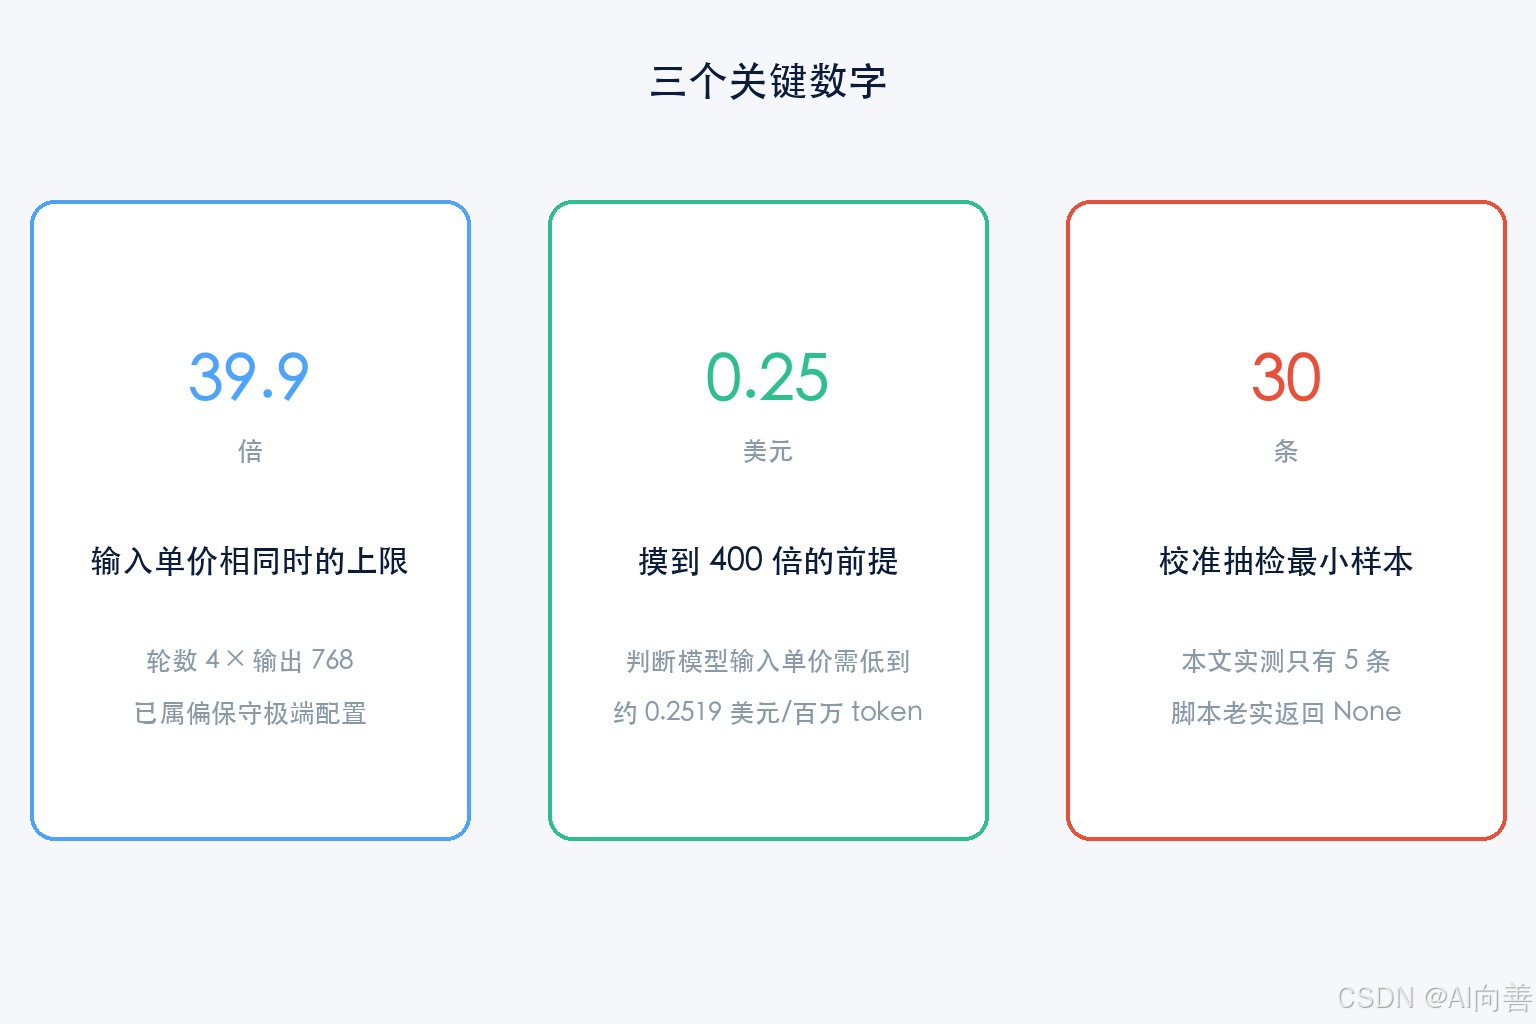
  轮数=4  gen_out= 768  生成式 $0.05112  =>   39.9x

  ⚠️ 输入单价相同时的倍数上限:39.9x
  要达到 100x,判断模型的输入单价需低到约 1.1648 美元/百万 token
  要达到 400x,判断模型的输入单价需低到约 0.2519 美元/百万 token
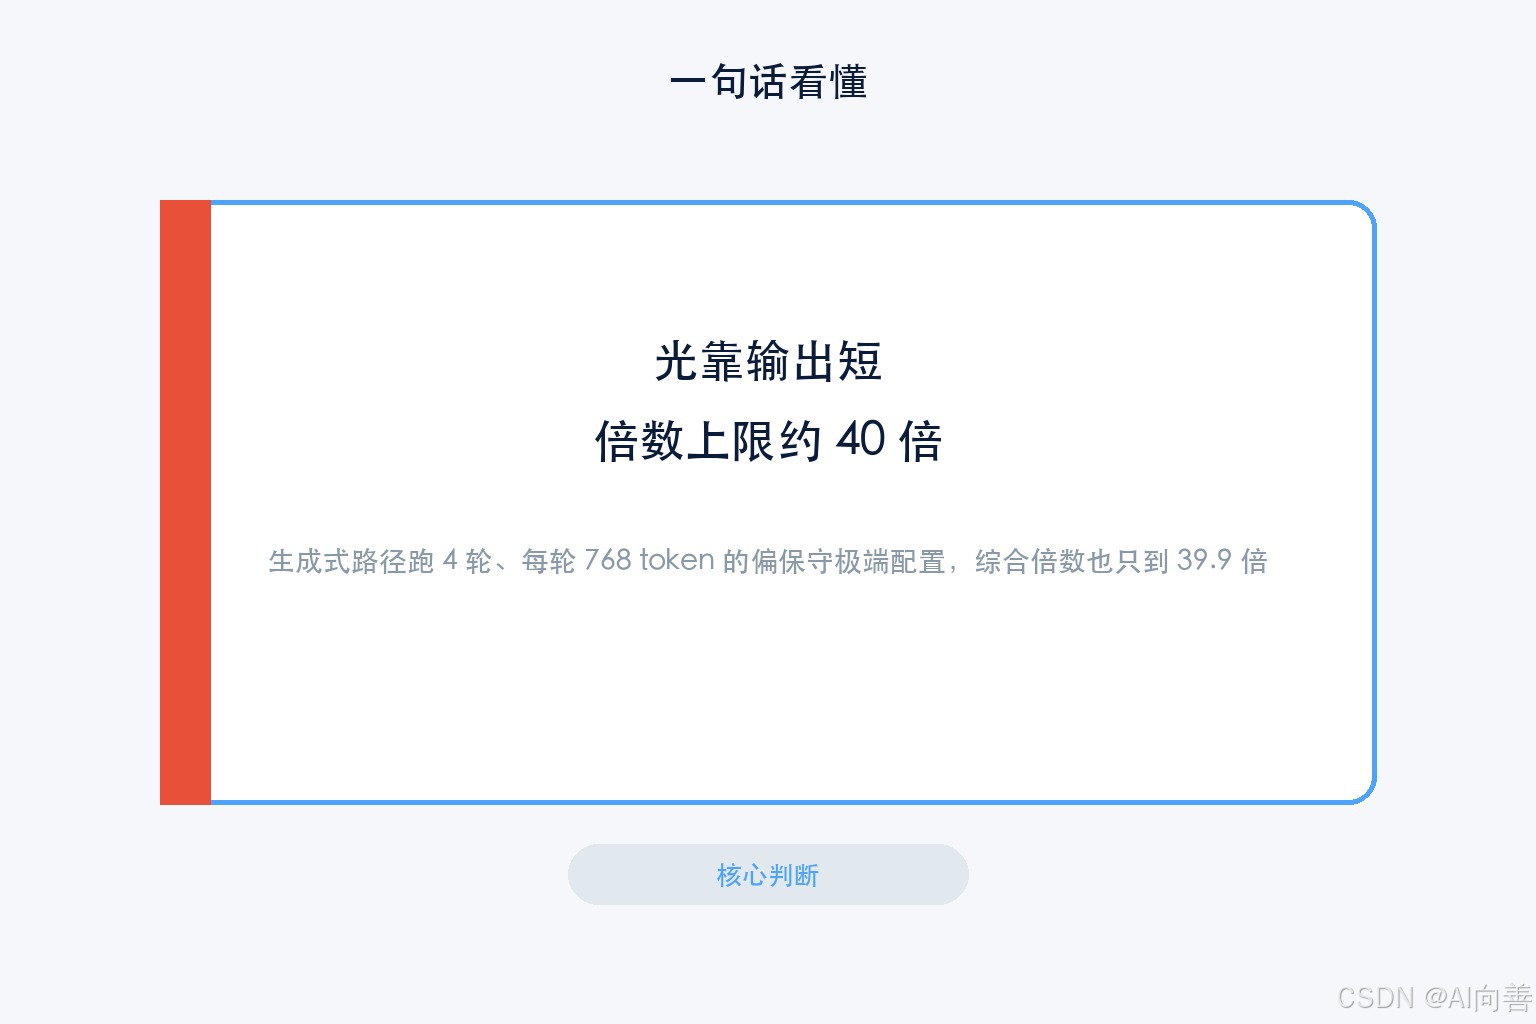
结论很直接:光靠「输出短」,倍数上限约 40 倍。
即使假设生成式路径跑 4 轮、每轮输出 768 个 token(这已经是偏保守的极端配置),综合倍数也只到 39.9 倍。要摸到 400 倍,判断模型的输入单价得低到约 0.25 美元每百万 token。
所以 400 倍这个宣称,**隐含了一个没被说出来的前提:判断模型不只是输出短,它的输入处理也便宜一个量级。**如果你的编排里输入很长(比如把 50 条候选标签和一大段上下文都塞进去),这个倍数会立刻缩水。比如输入从 420 token 涨到 4000 token,倍数上限会掉到十分之一左右。
这不是说宣称不成立,而是说它有适用边界,而这个边界可以用上面的公式先自己算一遍。
四、实测:同一批任务的两条路径
脚本的第二部分是护栏,第三部分是校准。先跑护栏。
  结构化产出 5 条,通过 5 条,被拒 0 条
  正控(4 条非法样本):通过 0 条,被拒 4 条  => 护栏有效
护栏的实现就是一份 JSON Schema,关键字段是枚举与必填:
{
  "type": "object",
  "required": ["label", "confidence"],
  "properties": {
    "label": {"type": "string", "enum": ["billing", "refund", "technical", "compliance"]},
    "confidence": {"type": "number"}
  },
  "additionalProperties": false
}
additionalProperties: false 这一条最容易被省,但它很值钱:它能让「模型自作主张加了一个 reason 字段」这类结构漂移在入口就被拦下,而不是流到下游把反序列化搞崩。
脚本里的自检同时装了正控与负控,本地跑的结果是 7 项全绿:
  [PASS] 负控1 合法样本护栏必须静默
  [PASS] 正控1 非法结构必须全部被拒
  [PASS] 正控2 概率越界能被单独定位
  [PASS] 负控2 小样本校准必须拒绝下结论
  [PASS] 正控3 足量样本给出 ECE
  [PASS] 正控4 敏感度表能区分量级并解出 400x 前提
  [PASS] 正控5 无标签文本解析为 None
这里有两项值得单独说。
负控1 验证的是「合法样本不许被误拒」。只会拦、不认好数据的护栏会让人把护栏关掉,那它等于没装。比如概率字段写成 0.93 合法,写成 1.7 必须被拒,写成 "high" 也必须被拒。这三条如果不分开测,你就不知道护栏到底在拦什么。
负控2 验证的是「小样本必须拒绝下结论」。5 条样本算出来的 ECE 没有意义,脚本直接返回 None。把「没测到」写成「没问题」,是这类审计脚本最容易退化的地方。
五、校准抽检:别把结构合法当判断正确
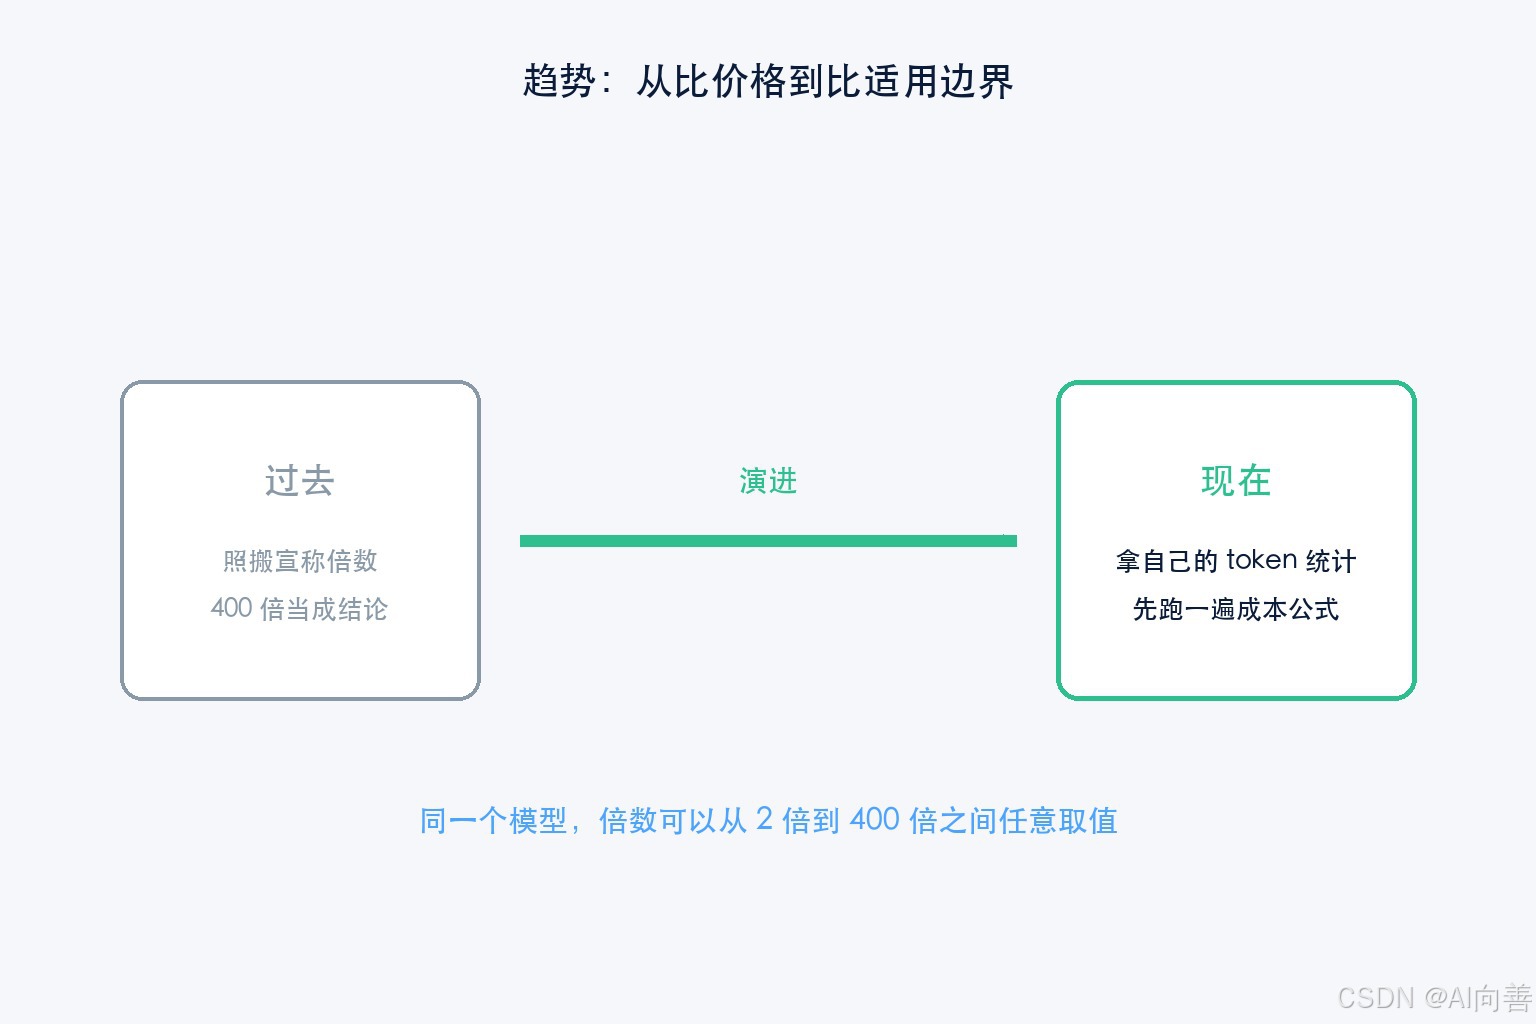
护栏只能保证结构可消费。它挡不住「结构完美但判断错了」。
判据要换成校准:把置信度分箱,看每一箱的实际准确率是否贴近声明的置信度。
def calibration(pairs, bins=3):
    if len(pairs) < 30:
        return None          # 小样本拒绝下结论
    buckets = [[] for _ in range(bins)]
    for conf, ok in pairs:
        buckets[min(int(conf * bins), bins - 1)].append((conf, ok))
    rows, ece, total = [], 0.0, len(pairs)
    for i, b in enumerate(buckets):
        if not b:
            continue
        avg_conf = sum(c for c, _ in b) / len(b)
        acc = sum(1 for _, o in b if o) / len(b)
        ece += (len(b) / total) * abs(avg_conf - acc)
        rows.append({"bin": f"{i / bins:.2f}-{(i + 1) / bins:.2f}",
                     "n": len(b), "avg_conf": round(avg_conf, 3), "acc": round(acc, 3)})
    return {"bins": rows, "ece": round(ece, 3), "n": total}
ece 是期望校准误差,越接近 0 越好。它的工程含义是:**声明 0.9 置信度的那批样本,真的要有约 90% 判对。**差得远,就不能让这个概率去驱动自动动作。
我自己跑下来只有 5 条样本,脚本老老实实返回 None。这正说明上线前第一件事不是接模型,是攒够带标注的抽检集,规模至少 30 条、最好 200 条以上。
六、落地取舍与踩坑
**取舍一,判断模型放在哪一层。**它适合放在确定性流程的入口做分诊,不适合直接执行有副作用的动作。资金、状态变更这类操作,仍然要有确定性代码路径兜底。
**取舍二,概率怎么用。**把概率当开关,就要给每一档置信度配不同动作:高置信直接走、中置信进人工队列、低置信退回澄清。把概率当展示用的装饰,等于白拿。
**取舍三,A/B 怎么设计。**两条路径要用同一批任务、同一份金标、同一套指标跑,只换执行层。样本少于 30 条不要比准确率。
踩坑有五条。
**坑一,只比价格不比解析成本。**生成式路径每一条输出都要写解析规则,规则维护本身就是人力成本。比如标签名和解释文本里出现同义词,解析逻辑就会反复改。
**坑二,把 additionalProperties 省掉。**省掉之后模型加字段不会被拦,下游反序列化直接报错,而且报错点在很远的调用栈里。
**坑三,用「被拒率」当质量指标。**被拒率高只说明结构不稳,不代表判断准。两个指标必须分开监控。
**坑四,忽略输入长度。**上面算过,输入从 420 token 涨到 4000 token,倍数上限掉到约十分之一。业务上下文越长,判断模型的成本优势越小。
**坑五,不做灰度直接全量切。**建议先切一条低风险链路,跑两周看人工抽检准确率,再决定扩面。
七、这套方案换不来什么
有三件事必须说清楚。
**第一,它换不来通用能力。**判断模型只做窄任务,任何超出枚举范围的问题都不该交给它。用户问了一个开放问题时,正确的处理是回到生成式路径,而不是让它硬选一个标签。
**第二,它把风险从「说错话」换成了「判断错」。**生成式模型说错了话,用户能看出来;判断模型判错了,输出依然是一段合法 JSON,页面一切正常。这类静默错误比显性错误更难发现。
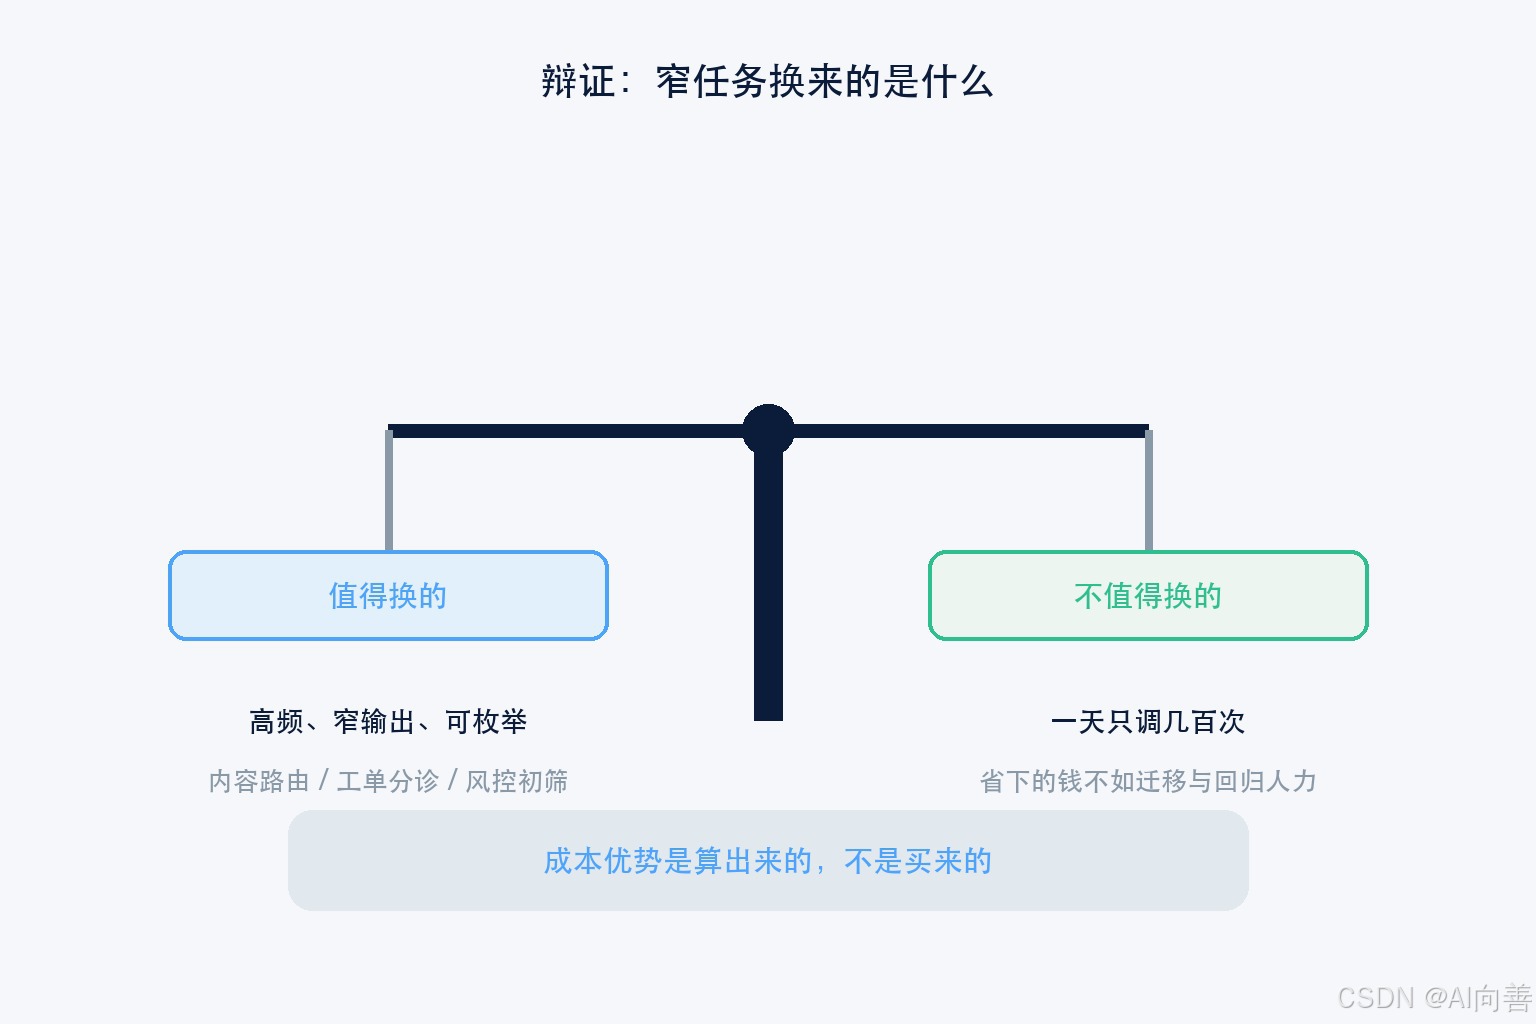
**第三,也是最容易被忽略的,成本优势是算出来的,不是买来的。**同一个模型,输入长度不同、轮数不同、单价不同,倍数可以从 2 倍到 400 倍之间任意取值。所以落地前应该做的第一件事,是拿你们自己的 token 统计跑一遍上面的公式,而不是照搬任何宣称。
另一个角度也要说清楚:**不是所有场景都值得换。**如果一条链路一天只调用几百次,省下来的钱还不如迁移和回归测试的人力成本。真正值得换的是高频、窄输出、可枚举的场景,比如内容路由、工单分诊、风控初筛这几类。
你怎么看
- 你们的路由节点是自己写的解析规则,还是已经换成结构化判断?
- 如果判断模型给出 0.7 的置信度,你们的系统会怎么处理?
- 按你们自己的输入长度算,判断模型的成本优势大概是多少倍?
欢迎在评论区说说你们的做法。
数据与事件来源
- Jev 的发布、定位「智能 if 语句」、训练方法(并行采样器 + RLCD 校准)与目标场景:TypeSafe AI 官方发布信息(来源:官方发布 2026-09)
- 快近 200 倍、便宜 400 多倍:厂商自建工作流的官方宣称,非第三方基准(来源:官方发布口径)
- 4000 万美元种子轮:公开融资报道
- 分类与路由占用的输出 token 量级、输入 420 token 的取值:本文为审计而设定的示例参数,替换为你们自己的 token 统计后结论会变
- 单次成本公式中的单价:脚本内为参数化默认值,非任何厂商报价
- 本文全部自检与报告输出:本机实测,脚本
route_cost_audit.py,运行python route_cost_audit.py --selftest与--report可复现,正控与负控共 7 项已交叉核实过 - 「400 倍需要判断模型输入单价低到约 0.2519 美元每百万 token」:由本文成本模型反解得出,属于条件结论,不是实测报价
本文首发于 CSDN,原文链接:blog.csdn.net/superdangbo…