录屏的音频比视频难:App 音 + 麦克风的双路混音与对齐
一、视频跑通了,然后你以为音频是顺手的事
做录屏的人几乎都是同一个顺序:先啃视频。
RPBroadcastSampleHandler 起来,processSampleBuffer 里拿到 .video 的 CMSampleBuffer,接 VideoToolbox 编码,写进 muxer,出文件,能播。这一段确实难——内存红线、编码器配置、IOSurface 池、旋转、后台被杀。你花了两周把它打磨到线上能用。
然后你回头看那两行:
case .audioApp:
case .audioMic:
心里想的是:音频而已,PCM 而已,两路加起来除以二,比视频简单一个数量级。
接下来两周,你会依次遇到这些:
- 录出来只有麦克风的声音,App 的声音完全没有。检查代码,
.audioApp那个 case 一次都没进过。 - 加了 App 音之后,文件里的声音变快了——1 分钟的录屏,音频只有 47 秒,后面全是静音。
- 每隔一小段就有一个"咔哒"声,规律得像节拍器。
- 前 10 秒音画同步,第 3 分钟人声比口型早了半秒多。
- 用户反馈:"我听见我自己说话有回音。"
- 用户还反馈:"背景音乐太吵了,听不清我说话。"你把 App 音降到 0.3,另一个用户说:"音乐怎么没声了。"
这些不是六个 bug,是三个结构性问题在不同位置的显形。这篇把它们拆开。
我的立场先摆在这里:录屏里,音频比视频难。 不是因为音频的信号处理更复杂——恰恰相反,这里几乎不需要什么信号处理。难在音频是唯一一路"不能丢帧"的数据。视频丢一帧,用户看不出来;音频丢 10 毫秒,用户听得见"啪"的一下。视频可以变帧率,音频的采样率是一条不能弯的线。你在视频那边学到的所有"扛不住就降级"的直觉,到音频这边全部失效。
二、ReplayKit 到底给了你什么
先把输入面讲清楚,因为后面所有的坑都长在这上面。
Broadcast Extension 的入口只有一个:
override func processSampleBuffer(_ sampleBuffer: CMSampleBuffer,
                                  with sampleBufferType: RPSampleBufferType) {
    switch sampleBufferType {
    case .video:     handleVideo(sampleBuffer)
    case .audioApp:  handleAudio(sampleBuffer, isMic: false)
    case .audioMic:  handleAudio(sampleBuffer, isMic: true)
    @unknown default: break
    }
}
三种类型,同一个方法,同一个线程(ReplayKit 会在它自己的串行队列上回调你,不要假设是主线程,也不要假设三种类型来自同一个队列——按"可能并发"来写你的状态机)。
两路音频的真实形态
.audioMic(麦克风)
- 只有用户在系统的录屏面板上打开了麦克风开关,这一路才会有数据。关掉就一个 buffer 都没有。
- 打开的情况下,它是连续的。设备在采,就一直往外送,说话和不说话都送,静音时送的是接近 0 的采样点。
- 每个 buffer 的采样点数不保证恒定。你可能连续收到 1024、1024、1024、然后一个 512。
.audioApp(App 音)
- 这是被录制 App(以及系统混音出来的其他声音)的输出。
- 关键点:它是稀疏的。 App 没在出声的时候,这一路一个 buffer 都不来。不是来一堆零,是根本不来。
- 它的间隔完全不可预测。用户录一个静态页面,可能十几秒没有任何
.audioApp;点一下按钮出个音效,来 3 个 buffer,又没了。
这条"App 音是稀疏的",是整篇文章里最重要的一句话。后面第五节会展开它的全部后果。
格式:不要写死,而且它会中途变
两路的 AudioStreamBasicDescription 不一样,而且不是常量。
正确的写法永远是从 buffer 自己身上读:
typealias ASBD = AudioStreamBasicDescription   // 下文统一用这个缩写

guard let fmt = CMSampleBufferGetFormatDescription(sampleBuffer),
      let asbdPtr = CMAudioFormatDescriptionGetStreamBasicDescription(fmt) else { return }
let asbd = asbdPtr.pointee
// asbd.mSampleRate, mChannelsPerFrame, mBitsPerChannel, mFormatFlags, mBytesPerFrame ...
我见过的组合里,.audioApp 常见是 44100 Hz / 2 声道 / Float32 / 非交错(mFormatFlags 带 kAudioFormatFlagIsNonInterleaved),.audioMic 常见是 44100 Hz / 1 声道。但这些数字在不同 iOS 版本、不同设备、不同被录 App 上都可能不同,把它们写成常量是这类代码里最常见的定时炸弹。
更麻烦的是第二件事:.audioApp 的格式会在一次录制中途改变。
这一路本质上是系统混音的输出。当声源从"一个 48kHz 的视频"切换到"一个 44.1kHz 的音效",或者从立体声内容切到单声道内容,你收到的 ASBD 就可能变。它不会通知你,你只能靠每个 buffer 自己去比对。
写死格式的代码在这里的表现是:不崩,不报错,只是声音开始变调或者变成噪声。因为你按 44100 解释了一段 48000 的数据。
非交错,是个容易被漏掉的细节
kAudioFormatFlagIsNonInterleaved 意味着 AudioBufferList 里有 N 个 AudioBuffer,每个 mNumberChannels = 1;交错的话是 1 个 AudioBuffer,mNumberChannels = N。
// 非交错立体声:mNumberBuffers = 2
//   abl.mBuffers[0] -> [L L L L ...]
//   abl.mBuffers[1] -> [R R R R ...]
//
// 交错立体声:    mNumberBuffers = 1
//   abl.mBuffers[0] -> [L R L R L R ...]
如果你按交错的方式去读非交错的 buffer,拿到的是"左声道的前半段"被当成了"左右交替"——听起来是声音变成两倍速、音调高八度、而且只有一半时长。上一节列的"1 分钟录屏音频只有 47 秒"就是这个家族的症状。
顺便,算一下内存
Broadcast Extension 有大约 50MB 的内存上限(这个红线怎么定义整个架构,我在另一篇里写过)。音频虽然比视频小得多,但也不是免费的:
48000 Hz × 4 字节(Float32) × 2 声道 = 384 KB / 秒 / 路
两路各缓 2 秒                      ≈ 1.5 MB
1.5MB 在 50MB 里不算什么。但它是常驻的,而且如果你为了"安全"把环形缓冲开到 10 秒,就是 7.5MB——在一个视频编码器随时可能因为 IOSurface 池扩张而多吃十几 MB 的进程里,这 7.5MB 可能就是压垮它的那一根。
结论:音频缓冲要按毫秒级去设计,不要按秒级。 后面会说为什么 200~500ms 就够。
三、坑一:AudioBufferList 的指针是借来的
在讲混音之前,先把一个必踩的崩溃说了,因为它会在你还没搞懂业务逻辑之前就把你卡住。
从 CMSampleBuffer 里取 PCM 数据的标准姿势:
var abl = AudioBufferList()
var blockBuffer: CMBlockBuffer?

let status = CMSampleBufferGetAudioBufferListWithRetainedBlockBuffer(
    sampleBuffer,
    bufferListSizeNeededOut: nil,
    bufferListOut: &abl,
    bufferListSize: MemoryLayout<AudioBufferList>.size,
    blockBufferAllocator: nil,
    blockBufferMemoryAllocator: nil,
    flags: kCMSampleBufferFlag_AudioBufferList_Assure16ByteAlignment,
    blockBufferOut: &blockBuffer
)
这个函数名里的 WithRetainedBlockBuffer 是全部的重点:abl 里的 mData 指针指向的是 blockBuffer 持有的内存,abl 本身不拥有任何东西。
于是有两个必踩的错误:
错误 A:把 abl 存起来,稍后再用。
// 错的
func handleAudio(_ sb: CMSampleBuffer) {
    var abl = AudioBufferList(); var bb: CMBlockBuffer?
    CMSampleBufferGetAudioBufferListWithRetainedBlockBuffer(...)
    self.pendingList.append(abl)   // ← bb 出作用域被释放,abl.mBuffers[0].mData 悬空
}
函数返回,bb 这个局部强引用没了,CMBlockBuffer 被销毁,mData 变成野指针。后面读的时候,运气好是 EXC_BAD_ACCESS,运气不好是读到别人的内存——变成一段随机噪声混进你的音轨里,而且只在某些设备上偶发。
错误 B:非交错时只声明了一个 AudioBuffer。
AudioBufferList 是个变长结构体(尾部柔性数组)。Swift 里 AudioBufferList() 只给你 1 个 mBuffers 的空间。立体声非交错需要 2 个。系统会往你只有 1 个槽的结构体里写 2 个 AudioBuffer —— 栈溢出,写坏相邻变量。
正确写法是先问需要多大,再用 AudioBufferList.allocate 开:
var sizeNeeded = 0
CMSampleBufferGetAudioBufferListWithRetainedBlockBuffer(
    sampleBuffer,
    bufferListSizeNeededOut: &sizeNeeded,
    bufferListOut: nil, bufferListSize: 0,
    blockBufferAllocator: nil, blockBufferMemoryAllocator: nil,
    flags: 0, blockBufferOut: nil
)

let count = (sizeNeeded - MemoryLayout<AudioBufferList>.size)
          / MemoryLayout<AudioBuffer>.size + 1
let ablPtr = AudioBufferList.allocate(maximumBuffers: count)
defer { free(ablPtr.unsafeMutablePointer) }

var blockBuffer: CMBlockBuffer?
guard CMSampleBufferGetAudioBufferListWithRetainedBlockBuffer(
        sampleBuffer,
        bufferListSizeNeededOut: nil,
        bufferListOut: ablPtr.unsafeMutablePointer,
        bufferListSize: sizeNeeded,
        blockBufferAllocator: nil, blockBufferMemoryAllocator: nil,
        flags: kCMSampleBufferFlag_AudioBufferList_Assure16ByteAlignment,
        blockBufferOut: &blockBuffer) == noErr,
      blockBuffer != nil else { return }

// 只在 blockBuffer 还活着的这个作用域里,把数据 **拷贝** 走
for buf in ablPtr {
    guard let src = buf.mData else { continue }
    ringBuffer.write(src, byteCount: Int(buf.mDataByteSize), channel: ...)
}
// 出了这个函数,blockBuffer 释放,ablPtr 里的指针全部作废 —— 这是正确的
一条规则记住就行:CMSampleBuffer 里的音频数据,只在回调栈帧内有效。要么当场用完,要么当场拷走。 不存在第三种选择。
(视频那边可以靠 CVPixelBufferRetain 做零拷贝,音频这边没有对应的便宜做法——好在音频数据量小,拷贝是可以接受的成本。384KB/秒,拷贝一次的开销可以忽略。)
四、坑二:AudioConverter 是有状态的,所以"每次新建"是错的
两路格式不同,你必须做转换。目标格式自己定,我的建议是统一到 48000 Hz / 双声道 / Float32 / 非交错作为内部工作格式,最后编码前再转成 AAC 需要的形态。选 Float32 是因为混音时要做加法和增益,定点会反复溢出和舍入;选非交错是因为混音代码按声道循环写起来最干净。
于是你需要两个 AudioConverter:mic 的格式 → 工作格式,app 的格式 → 工作格式。
写法大概是这样:
final class PCMConverter {
    private var converter: AudioConverterRef?
    private(set) var srcFormat: ASBD
    private let dstFormat: ASBD

    init?(src: ASBD, dst: ASBD) {
        self.srcFormat = src
        self.dstFormat = dst
        var s = src, d = dst
        guard AudioConverterNew(&s, &d, &converter) == noErr else { return nil }
    }

    deinit { if let c = converter { AudioConverterDispose(c) } }
}
然后是喂数据。AudioConverterFillComplexBuffer 是拉模型:你告诉它要多少输出,它通过回调向你要输入。
private struct InputContext {
    var abl: UnsafeMutableAudioBufferListPointer
    var consumed: Bool
    var asbd: ASBD
}

private let inputProc: AudioConverterComplexInputDataProc = {
    _, ioNumberDataPackets, ioData, outPacketDesc, userData in

    let ctx = userData!.assumingMemoryBound(to: InputContext.self)
    if ctx.pointee.consumed {
        ioNumberDataPackets.pointee = 0
        return noErr            // 输入用完了,告诉转换器"没有更多了"
    }

    let src = ctx.pointee.abl
    let bytesPerFrame = ctx.pointee.asbd.mBytesPerFrame
    let frames = src[0].mDataByteSize / max(bytesPerFrame, 1)

    ioData.pointee.mNumberBuffers = UInt32(src.count)
    let dst = UnsafeMutableAudioBufferListPointer(ioData)
    for i in 0..<src.count { dst[i] = src[i] }

    ioNumberDataPackets.pointee = frames
    ctx.pointee.consumed = true
    return noErr
}
注意那个 ioNumberDataPackets.pointee = 0; return noErr ——这是"输入暂时用完"的正确表达,不要返回错误码。 返回非零错误码会让 FillComplexBuffer 直接失败并丢掉转换器内部已经攒着的数据。这是第一个容易写错的地方。
真正的坑:状态
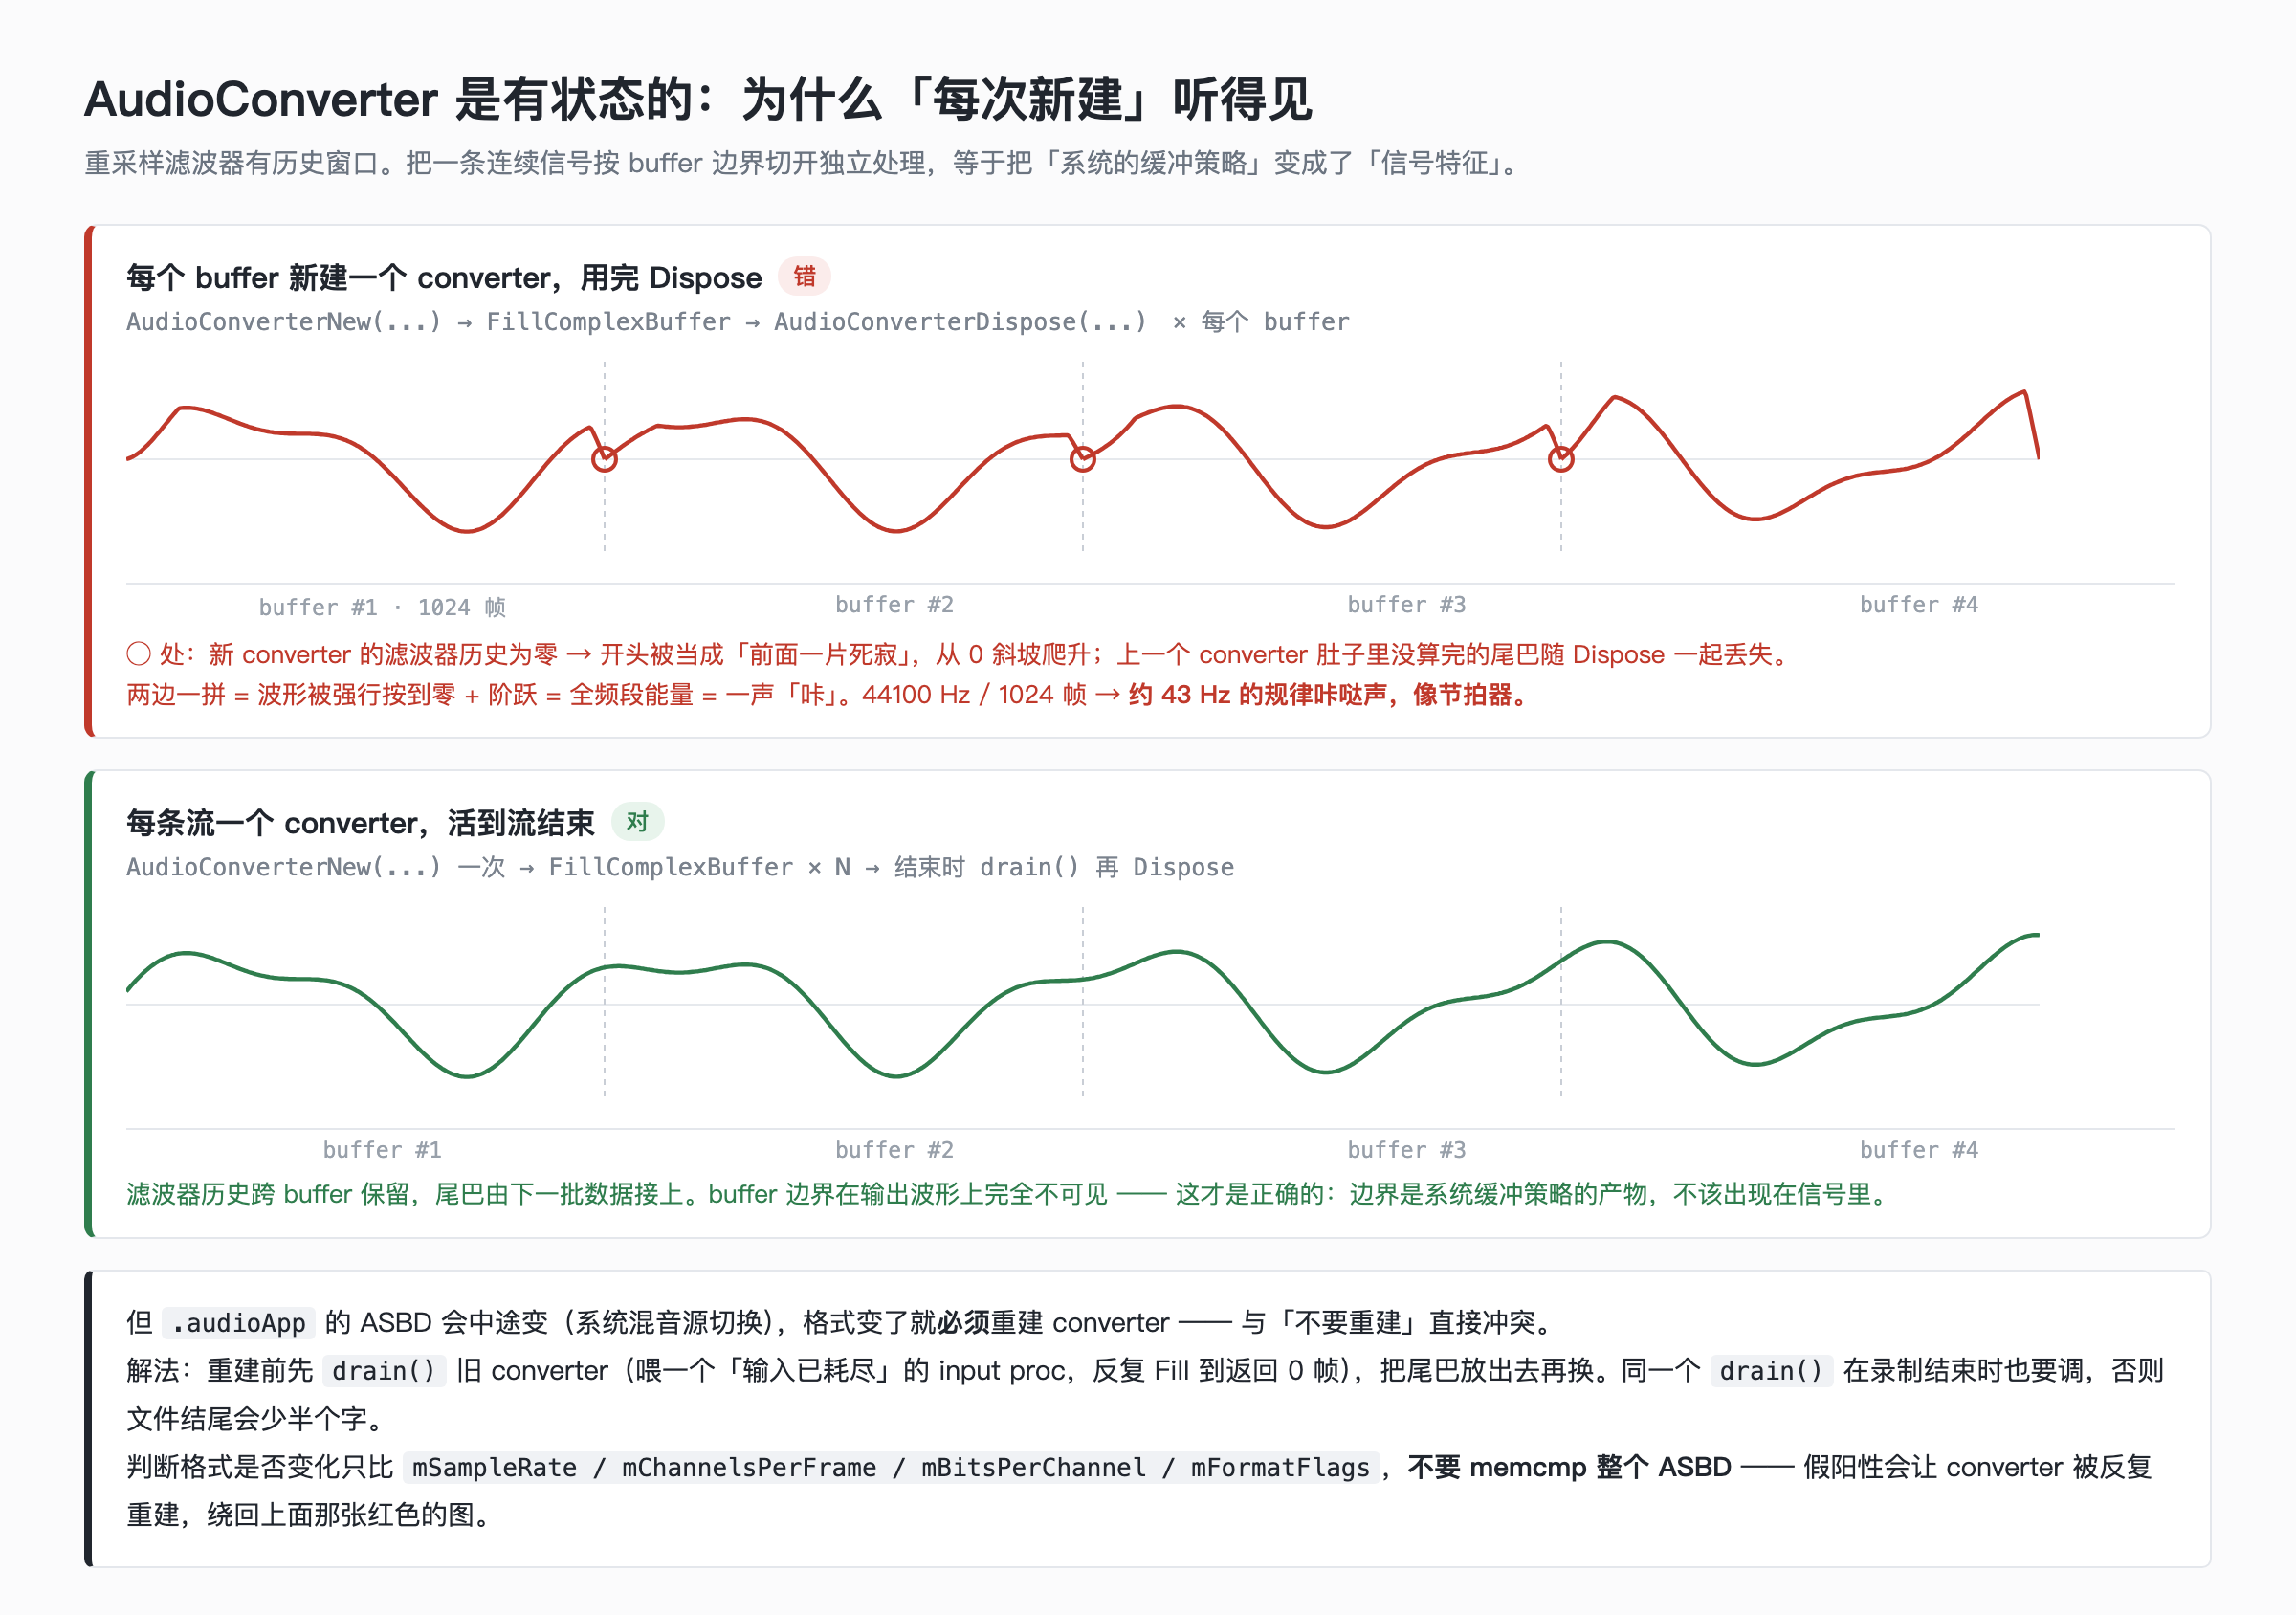
现在说重点。AudioConverter 在做采样率转换的时候,内部是一个多相插值滤波器。滤波器有历史窗口——计算第 N 个输出采样点,需要用到输入信号第 N 点前后各若干个采样点。
这意味着两件事:
- 转换器会留一小段输入在肚子里(尾巴),等下一批数据来了才能算完。
- 转换器会滞后若干采样点输出(滤波器群延迟)。
所以,如果你写成这样:
// 错的,而且看起来最"干净"
func convert(_ abl: ..., srcFormat: ASBD) -> [Float] {
    var conv: AudioConverterRef?
    AudioConverterNew(&src, &dst, &conv)
    defer { AudioConverterDispose(conv!) }     // ← 每个 buffer 建一个,用完就扔
    ...
}
你会得到每个 buffer 边界一个"咔哒"声。
为什么?因为新建的转换器滤波器历史是零,它在处理这批数据的开头时,会认为"前面是一片死寂",于是算出一个从 0 突变到实际值的斜坡;同时上一个转换器肚子里的尾巴被 Dispose 一起扔了。两边一拼,波形上就是一个不连续的断口。断口在时域上是阶跃,阶跃在频域上是全频段的能量——人耳听起来就是"咔"。
buffer 是 1024 帧、采样率 44100 的话,这个咔哒声的频率是 44100 / 1024 ≈ 43 Hz——规律得像节拍器,正好对上第一节列的那个症状。
这是这篇文章里我认为最反直觉的一条:在绝大多数领域里,"无状态、每次新建、用完销毁"是更安全的写法。在音频重采样里,它是错的,而且错得听得见。
无状态在这里之所以危险,是因为音频流的语义本来就是有状态的。你手上那 1024 个采样点不是一个独立的对象,它是一条连续信号被任意切开的一段。切口在哪儿完全取决于系统怎么排的缓冲区,跟信号本身毫无关系。任何"按 buffer 独立处理"的写法,都在无意中把一个实现细节(缓冲区边界)变成了信号特征。
所以规则是:每条流一个转换器,活到流结束。 这个转换器是流的一部分,不是函数的局部变量。
但格式会变,那就必须重建——冲突怎么解
上一节说了 .audioApp 的 ASBD 会中途变。变了就必须换转换器(AudioConverterNew 的输入格式是构造时定死的)。
这两条要求是直接冲突的:不要重建(保住状态) vs 必须重建(格式变了)。
解法是:重建时先把旧转换器排空。
final class StreamConverter {
    private var conv: PCMConverter?
    private let dstFormat: ASBD

    func push(_ abl: UnsafeMutableAudioBufferListPointer,
              srcFormat: ASBD,
              pts: CMTime,
              into sink: (UnsafeMutableAudioBufferListPointer, CMTime) -> Void) {

        if let c = conv, !c.srcFormat.isSameLayout(as: srcFormat) {
            // 格式变了:先把旧转换器肚子里的尾巴 flush 出去
            if let tail = c.drain() {
                sink(tail, pendingTailPTS)
            }
            conv = nil
        }
        if conv == nil {
            conv = PCMConverter(src: srcFormat, dst: dstFormat)
        }
        conv?.convert(abl, pts: pts, into: sink)
    }
}
drain() 就是拿一个"输入已耗尽"的 input proc 去反复调 FillComplexBuffer,直到它返回 0 帧:
func drain() -> UnsafeMutableAudioBufferListPointer? {
    guard let c = converter else { return nil }
    var ctx = InputContext(abl: emptyABL, consumed: true, asbd: srcFormat)  // 一上来就是"没有输入"
    var outFrames: UInt32 = 4096
    let out = allocateOutputABL(frames: outFrames)
    let st = AudioConverterFillComplexBuffer(c, inputProc, &ctx, &outFrames, out.unsafeMutablePointer, nil)
    guard st == noErr, outFrames > 0 else { free(out.unsafeMutablePointer); return nil }
    trim(out, toFrames: outFrames)
    return out
}
同一套 drain() 在录制结束时也要调一次,否则最后几十毫秒的音频会被吞掉。录屏文件结尾少半个字——这个 bug 特别难被发现,因为大家试录的时候习惯说完话停两秒再点停止。
还有一个细节:isSameLayout(as:) 应该比什么?我的做法是比 mSampleRate / mChannelsPerFrame / mBitsPerChannel / mFormatFlags 这四个,不要直接 memcmp 整个 ASBD 结构体——里面有 mReserved 和一些可能被系统填不同值但语义等价的字段,memcmp 会给你假阳性,导致转换器被反复重建,反而回到咔哒声。
五、坑三:没有一条流可以当时钟
现在到了这篇文章真正的核心。
你有两路音频要混成一路。最自然的写法是"等两边都到齐了,加一加,输出":
// 错的
while let m = micQueue.popFirst(), let a = appQueue.popFirst() {
    output(mix(m, a))
}
这段代码在录屏场景下会永远输出不了任何东西——只要 App 没在出声,appQueue 就是空的,循环一次都进不去。
好,那改成"有谁就用谁":
// 还是错的
if let m = micQueue.popFirst() { output(m) }
if let a = appQueue.popFirst() { output(a) }
现在时间轴乱了:麦克风的第 1 个 buffer 和 App 的第 1 个 buffer 被顺序写进同一条轨道,变成了先后关系,而它们本该是同时发生的。
问题的根源在于:你在找一条"主流"来驱动输出,但这里没有任何一条流能担任这个角色。
.audioApp不行:稀疏,静音时完全不来,间隔无上界。.audioMic不行:用户可以在录制中途关掉麦克风开关,这一路会直接断掉,而且不会通知你。你的整个输出就停在那一刻了。.video不行:ReplayKit 的视频是可变帧率的。画面静止时它可以几秒不送一帧(这是它省电和省内存的设计),恢复变化后再连着送。拿视频当音频的时钟,静止画面时音频就断了。
三条输入,没有一条是可信的心跳。
换个问法:把"同步"改写成"寻址"
一旦承认没有主流,正确的模型就浮出来了:不要让任何输入驱动输出。自己建一条时间线,把所有输入当成"往这条时间线上的某个位置写数据"的事件。
具体来说:
- 收到第一个音频 buffer 时(不管哪一路),记下它的 PTS 作为
t0,这就是输出时间线的零点。 - 输出时间线的单位是采样点索引,不是秒。工作采样率 48000 的话,索引
n对应的时间就是t0 + n/48000。 - 每收到一个 buffer,把它的 PTS 换算成索引
n,然后把转换后的 PCM 写到两个环形缓冲的n位置(一个 mic ring,一个 app ring)。 - 一个独立的"混音游标"
w沿着时间线单调前进。每次前进固定步长(比如 480 个采样点 = 10ms),把两个环形缓冲在[w, w+480)区间的内容读出来混合,输出一个 packet,然后w += 480。 - 环形缓冲初始化为全 0。没有数据写进去的区间,读出来天然就是静音。
第 5 条把"App 音是稀疏的"这个麻烦事彻底消解掉了:不需要检测间隙,不需要生成静音包,不需要状态机。稀疏流写进一块预置为静音的画布,空白处自然就是静音。
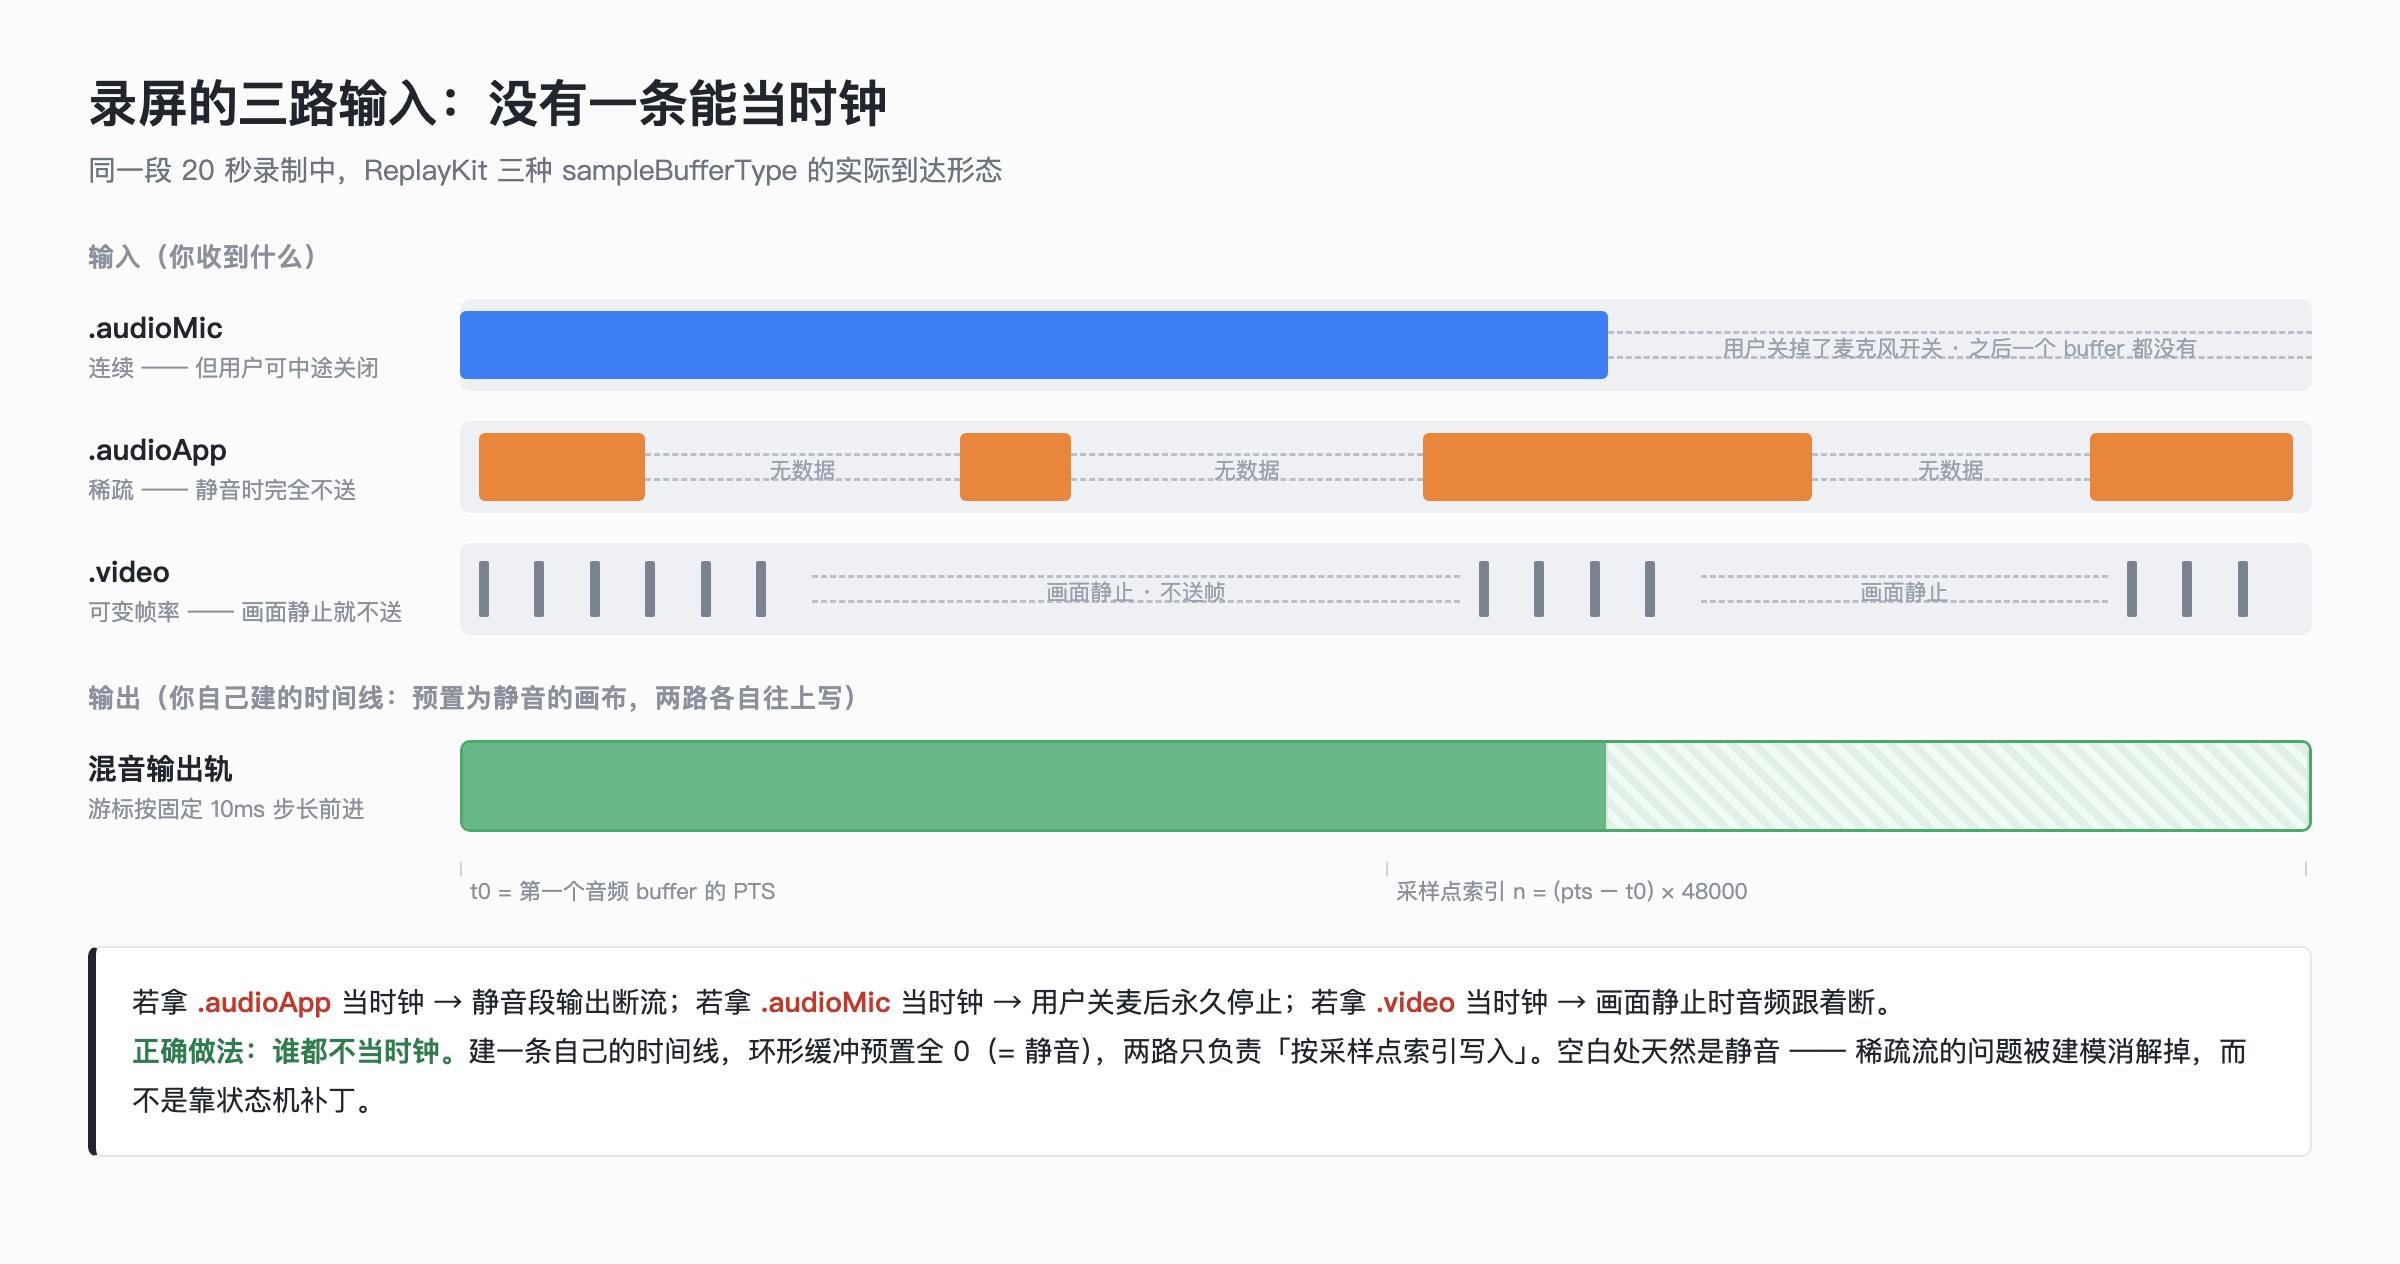
这个模型的本质是:把"两条流怎么对齐"这个同步问题,改写成了"每个采样点该放在哪个地址"这个寻址问题。 同步问题需要协调两个独立的时间源,是个分布式问题;寻址问题只需要一个基准和一个除法,是个算术问题。
混音游标该走多快?
w 不能想推多快推多快——推到还没写入数据的区间,就把本该有声音的地方输出成静音了。
所以游标要滞后于已收到的数据,滞后量就是你的抖动容忍度:
// 每次收到任意一路数据后调用
func pump() {
    // 已经安全可读的边界 = 收到过数据的最大位置 - 安全余量
    let safeEnd = maxWrittenIndex - safetyMargin      // safetyMargin = 0.2s × 48000 ≈ 9600
    while cursor + frameSize <= safeEnd {
        let mixed = mixFrame(at: cursor, count: frameSize)
        emit(mixed, at: cursor)
        cursor += frameSize
    }
}
safetyMargin 怎么选?它是延迟和完整性的交易:
- 太小:某一路稍微晚到一点,那段就被输出成静音了,听起来是"掉字"。
- 太大:内存占用上升(回到第二节的算术:每秒 384KB/路),而且录制结束时要 flush 的尾巴变长。
录屏不是实时通话,没有端到端延迟要求,所以可以给得比 VoIP 大方得多。我用 200ms 作为起点(两路合计约 300KB,在 50MB 预算里可以接受),实测两路的到达抖动远小于这个数。
注意 maxWrittenIndex 要取两路里较大的那个,不是较小的。取较小的话,麦克风关掉之后 maxWrittenIndex 就永远不涨了,游标停死,整个输出断流——这正好是"用某一路当时钟"的错误换了个马甲又爬回来了。
PTS → 索引:别用浮点秒
换算写成这样是有隐患的:
// 有隐患
let index = Int(CMTimeGetSeconds(pts - t0) * 48000.0)
CMTimeGetSeconds 返回 Double。录 30 分钟,秒数到 1800,Double 在这个量级的精度还够,问题不在精度本身,在于每次都做一次独立的浮点乘法再取整,误差不累加但会抖动:相邻两个 buffer 可能因为舍入方向不同,算出的索引差 1023 或 1025 而不是 1024。写进环形缓冲就是重叠一个采样点或者空一个采样点。空一个采样点是一个单点的 0,在波形上是一个针状的坑——高频"沙沙"声就是这么来的。
用 CMTime 的整数运算,把时间基直接换成采样率:
let rel = CMTimeSubtract(pts, t0)
let inSamples = CMTimeConvertScale(rel,
                                   timescale: CMTimeScale(workingSampleRate),
                                   method: .roundHalfAwayFromZero)
let index = Int(inSamples.value)
时间基是 48000,value 就直接是采样点索引,全程整数。
更稳的做法是只在两种情况下相信 PTS:流的第一个 buffer,以及检测到大间隙(比如 > 100ms)之后的第一个 buffer。其余时候用"上一个索引 + 上一个 buffer 的帧数"直接推。这样连续段内部是逐采样点严格连续的,绝不可能出现单点空洞;而间隙处又能靠 PTS 重新锚定,不会累积漂移。
(PTS、时间基、漂移这一大类问题我在音画同步那篇里单独写过,这里不重复展开。)
六、坑四:直接相加,既削顶又淹没人声
时间对齐解决了,现在是电平。
最朴素的混音:
out[i] = mic[i] + app[i]
两个问题同时发生。
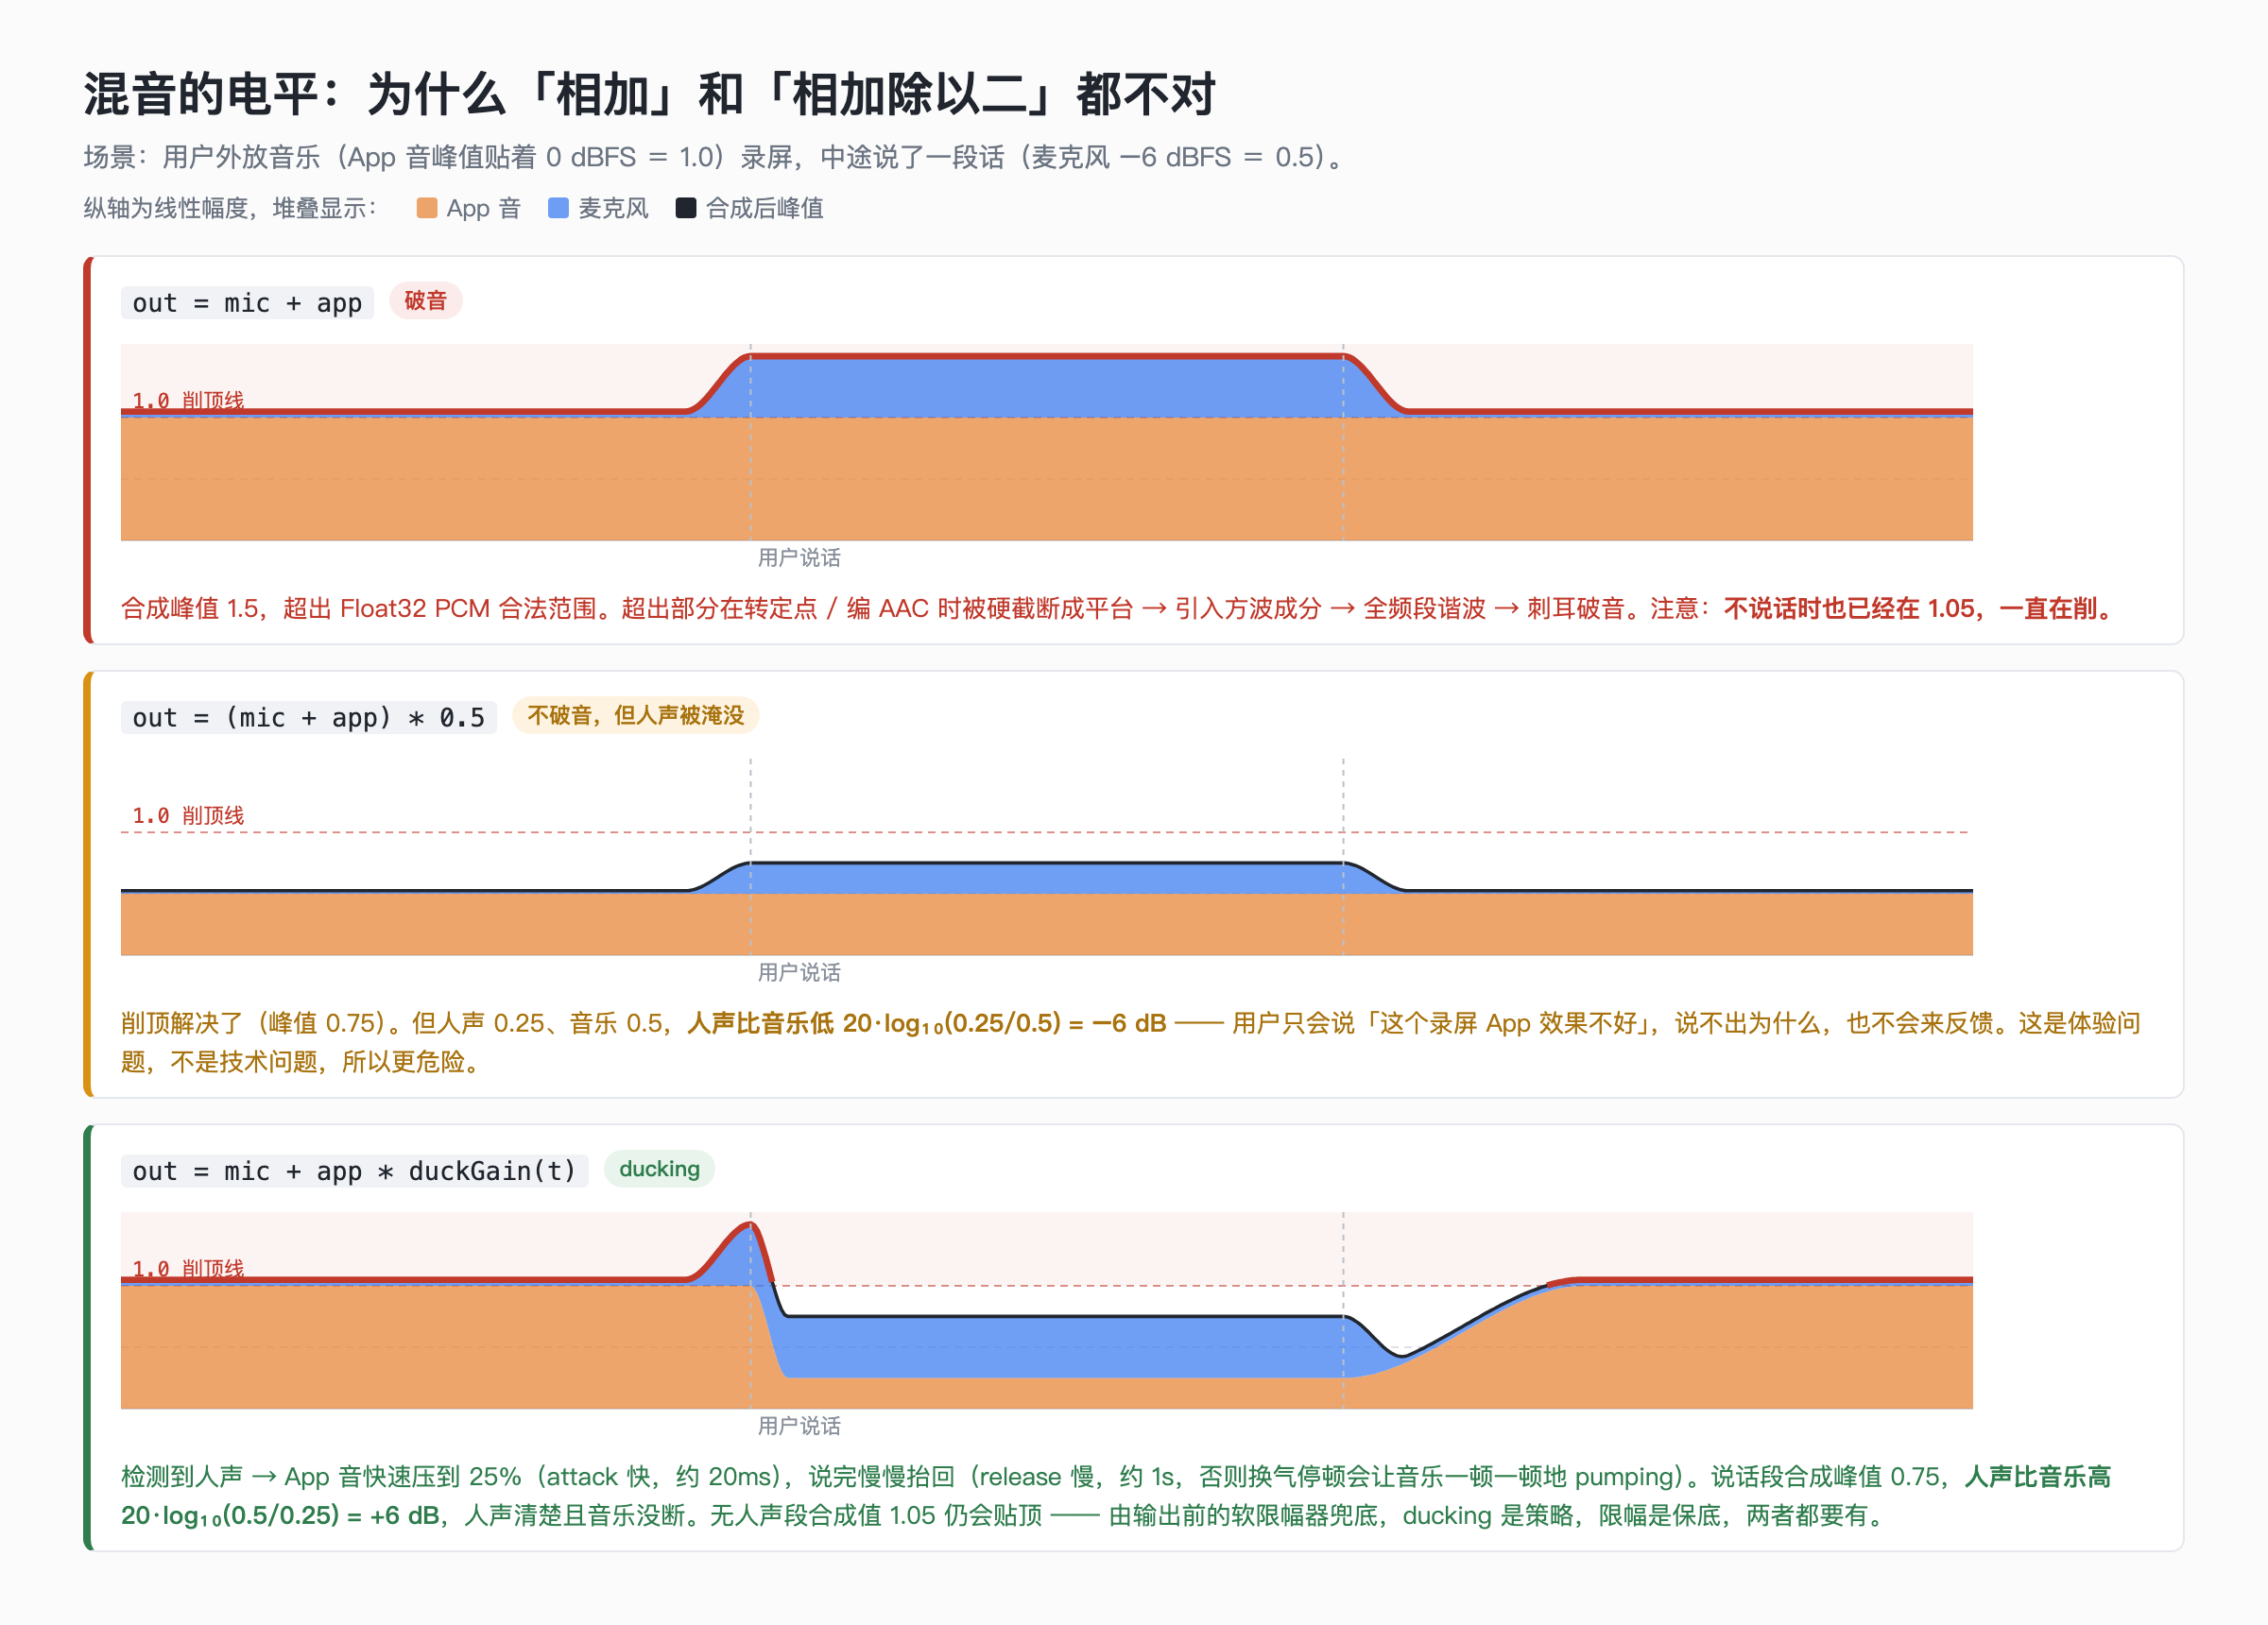
问题一:削顶。 Float32 PCM 的合法范围是 [-1.0, 1.0]。App 音是成品音频,基本都做过响度归一化,峰值贴着 0 dBFS。麦克风人声凑近了说也能到 -6 dBFS。两个一加,峰值 1.5,超出的部分在最终转成整型 PCM 或者编码成 AAC 时被 clip 成方波——方波在频域上是无穷多个谐波,听起来是刺耳的破音。
out[i] = (mic[i] + app[i]) * 0.5 能解决削顶,但引出:
问题二:人声被淹没。 除以 2 之后,本来 -6 dBFS 的人声变成 -12 dBFS,本来 0 dBFS 的背景音乐变成 -6 dBFS。人声和音乐差了 6 dB,人耳听起来就是"音乐盖过说话"。
而这两个问题的严重性是不对称的:削顶是技术问题,破音谁都听得出来,一定会被反馈;人声被淹没是体验问题,用户只会觉得"这个录屏 App 效果不好",说不出为什么,也不会来反馈——直接影响留存。
解法:ducking(闪避)
正确做法是让 App 音在有人说话的时候自动让位。这是广播行业几十年的标准手法(DJ 说话时背景音乐自动压低)。
实现只需要一个包络跟随器:
final class Ducker {
    private var envelope: Float = 0      // 麦克风能量包络
    private var gain: Float = 1          // 当前施加在 App 音上的增益

    // 参数:都可以做成配置
    let threshold: Float = 0.02          // 说话判定阈值(约 -34 dBFS)
    let duckGain: Float = 0.25           // 说话时 App 音压到 25%(约 -12 dB)
    let attackCoef: Float = 0.02         // 增益压下去要快
    let releaseCoef: Float = 0.0008      // 增益抬回来要慢
    let envAttack: Float = 0.05          // 包络跟随:上升快
    let envRelease: Float = 0.001        // 包络跟随:下降慢

    func process(mic: UnsafePointer<Float>, app: UnsafeMutablePointer<Float>,
                 out: UnsafeMutablePointer<Float>, count: Int) {
        for i in 0..<count {
            // 1. 整流 + 单极点平滑,得到麦克风的瞬时能量包络
            let rectified = abs(mic[i])
            envelope += (rectified - envelope) * (rectified > envelope ? envAttack : envRelease)

            // 2. 决定目标增益
            let target: Float = envelope > threshold ? duckGain : 1.0

            // 3. 平滑趋近,避免增益突变(增益突变本身就是一种失真)
            let coef = target < gain ? attackCoef : releaseCoef
            gain += (target - gain) * coef

            // 4. 混合
            out[i] = mic[i] + app[i] * gain
        }
    }
}
三个参数的取值理由:
- attack 快、release 慢:说话一开始就要立刻让位,否则第一个字被盖住;说完之后要慢慢抬回来,否则句子之间的换气停顿会让音乐一顿一顿地"抽"(这个现象叫 pumping,是最容易听出来的廉价感)。我用的 release 时间常数在 1 秒量级。
- duckGain 不要给到 0:完全静音会让用户以为音乐断了。压到 25% 左右,人声清楚,音乐还在。
- threshold 要留出底噪的余量:手机麦克风的环境底噪在安静房间里大概 -50 dBFS 量级,嘈杂环境能到 -35。阈值给太低,环境噪声就会一直把音乐压着不放。
最后再挂一个限幅器
ducking 是概率性的保护,不是保证。总有 ducking 还没跟上、或者用户对着麦克风大喊的时候。所以输出前必须有一道硬保底:
@inline(__always)
func softClip(_ x: Float) -> Float {
    // tanh 形软限幅:|x| 远小于 1 时 tanh(x) ≈ x(近似恒等,不染色),
    // 越接近 ±1 曲线越平,超过 1 的部分被平滑地压回来,永远不越界。
    // 比 max(-1, min(1, x)) 的硬截断听起来自然得多:硬截断把峰顶削成平台
    // (= 引入方波成分 = 全频段谐波),软限幅只是把峰顶压圆。
    return tanhf(x)
}
实际工程里我更倾向用带 lookahead 的峰值限幅器(提前几毫秒看到峰值,提前降增益,完全避免失真),但那要额外的延迟缓冲。录屏场景下 tanh 软限幅的性价比已经足够——它把"破音"降级成了"稍微有点压缩感",这个交易在录屏场景稳赚。
七、坑五:回声,以及为什么这是一个"看得见却够不着"的问题
用户外放着音乐录屏,同时开麦说话。你会在最终文件里听到:音乐(来自 .audioApp),加上人声,再加上一份延迟了几十毫秒、经过手机扬声器和房间反射的、闷闷的音乐(来自 .audioMic)。
两份同样内容、有相对延迟的信号叠在一起,就是梳状滤波:某些频率相加增强,某些频率相消。听感上是"空洞的、像在罐子里"的回声。
这个问题的处理路径,是我做录屏音频时觉得最讽刺的一段。
AEC(声学回声消除)的原理是:你有一个参考信号(远端声音),你知道它被播出去了,于是你用自适应滤波器估计"参考信号 → 麦克风"这条声学路径的冲激响应,然后从麦克风信号里把估计出来的回声减掉。
AEC 最难的部分从来是拿到干净的、时间对齐的参考信号。在 VoIP 里,这需要音频框架深度参与——它得知道什么时候把哪一段 PCM 送给了扬声器。
而在录屏里,参考信号就是 .audioApp,它就摊在你手上,格式已知,PTS 已知,还刚刚被你精确地对齐到了同一条时间线上。 这是一个 AEC 场景能想象的最理想的输入条件。
然后你会发现:没有任何一个 iOS 公开 API 让你把这个参考信号喂进系统的 AEC。
系统的回声消除挂在 AVAudioSession 的 .voiceChat 模式和 AVAudioEngine 的 setVoiceProcessingEnabled(_:) 上,它们消的是系统自己知道的播放路径。ReplayKit 给你的 .audioMic 是已经采集完成的 CMSampleBuffer,不是 AVAudioInputNode 的输出;你没有一个节点可以把 voice processing 挂上去,也没有一个入口告诉系统"这段是我的参考信号"。而且 Broadcast Extension 的运行环境本来就对音频会话的控制权极其有限——那是宿主 App 的会话,不是你的。
这就是我说的"看得见却够不着":你手里握着一个近乎完美的参考信号,但没有任何管道能把它送到需要它的地方。
于是现实中的三条路:
路线 A:自己实现自适应滤波(NLMS)。
技术上可行,参考信号和麦克风信号都在你手上,时间线也对齐了。但工程成本很高:需要估计并跟踪时延(扬声器输出到麦克风采到,几十毫秒且随音量和握持姿势变化)、需要双讲(double-talk)检测防止用户说话时滤波器发散、需要非线性处理来对付手机扬声器在大音量下的失真(线性滤波器对付不了非线性失真,这是手机 AEC 最难的部分)。而且这些都要跑在一个 50MB 内存上限、还要同时编码视频的进程里。
我的判断:对绝大多数录屏产品,这个投入产出比不成立。 这是一个专业团队做半年的活儿。
路线 B:检测耳机,用交互规避。
戴耳机的时候,扬声器不出声,声学回路根本不存在,问题自动消失。所以最有效的一步是:在用户同时打开"麦克风"和"App 音"时,提示他戴耳机。
一行信号处理都不用写,解决了大部分情况。前提是你的产品愿意承认这个限制并把它讲给用户听——很多团队卡在这里,觉得"提示用户是产品能力不足的表现",然后花三个月去做一个做不好的 AEC。
路线 C:加大 ducking 深度。
这条有点绕,但很实用:麦克风里混进来的回声,内容和你手上的 App 音是同一份。 也就是说,回声携带的信息量为零——它是纯粹的重复。
那么在用户说话的时候把 App 音压得更狠(比如压到 10% 而不是 25%),损失的是"重复内容的一份拷贝",换来的是回声在混音结果里的相对占比大幅下降。它不消除回声(麦克风那一路的回声还在),但它让总的梳状效应变弱,因为参与干涉的两份信号能量差拉大了。
这是一个信号处理上"不正确"但体验上有效的手段。工程里这种手段值不值得用,取决于你有没有诚实地知道自己在做什么权衡——用它是因为算过账,不是因为不知道 AEC 是什么。
八、诚实对比:什么时候你根本不该做这些
前面写了六节,全是在 Broadcast Extension 里手工搭音频管线。现在说反面。
如果你只需要"录当前这个 App 的屏,带声音",用 RPScreenRecorder 就够了,别碰 Extension。
RPScreenRecorder.shared().isMicrophoneEnabled = true
RPScreenRecorder.shared().startRecording { error in ... }
系统帮你把 App 音和麦克风混好,出一个 .mp4,你一行音频代码都不用写。这篇文章里的全部内容对你都是无关知识。
如果你需要录整个系统(跨 App),才必须走 Broadcast Extension,才有这篇的问题。
即使在 Extension 里,还有一个岔路:写两条音频轨,还是混成一条?
AVAssetWriter 支持添加多个音频轨(多个 AVAssetWriterInput with mediaType: .audio)。写两条的好处很实在:不可逆的决定被推迟了——用户录完之后还能调麦克风音量、还能把 App 音单独静音、还能把人声导出去做单独处理。混音是有损且不可逆的。
但它的代价是兼容性:
- iOS 相册、大部分播放器、大部分社交平台只播第一条音频轨。用户导出去发给朋友,朋友只听到麦克风的声音。
- 大部分视频编辑软件对多音轨 MP4 的支持参差不齐。
- AAC 编码两条轨的 CPU 和内存开销翻倍——在 50MB 的 Extension 里,这不是小事。
我的选择:Extension 里混成一条,理由是"文件出去之后必须无条件可播"。
如果产品确实需要后期调音量,正确的做法不是导出多音轨文件,而是在自己的 App 内同时存一份"麦克风原始轨"作为旁路文件(一条单声道 AAC,码率给低点,几十 KB/秒),编辑时用它替换。这样默认文件保持最大兼容,专业需求另有通路。这个决定的本质是:把"通用性"和"可编辑性"这两个互相冲突的目标分给两个产物,而不是让一个产物同时满足。
九、收尾:从这件事里能拿走什么
第一,"没有可信时钟"是一类问题,不是一个问题
录屏音频的核心困难,剥掉所有 API 细节之后是这样一句话:你有多个异步输入,每个都能给你时间戳,但没有一个能保证持续产出。
这个形状你会在很多地方见到:
- 多传感器融合(IMU 高频、GPS 低频且会丢星、相机中频)
- 分布式日志聚合(多个服务各自打点,各自可能静默)
- 多路直播合流(某一路推流断了,节目不能停)
它们的错误解法都长得一样:挑一路当主时钟,然后被那一路的中断拖死。
正确解法也都长得一样:自己建一条时间线,把所有输入降级成"往时间线上写"的事件,让消费者按自己的节奏在时间线上前进。 时间线的空白处要有一个语义明确的默认值——音频是静音(全 0),传感器可能是"上一个值保持"或"插值",日志可能是"无事件"。这个默认值的选择,就是整个设计里最关键的一次建模。
一旦这么做,"同步"就变成了"寻址"。前者是分布式协调问题,后者是算术问题。能把协调问题降级成算术问题的时候,一定要降。
第二,无状态不总是更安全
我们被教育了太多年"函数要纯、要无状态、要幂等"。这些在业务代码里几乎总是对的。
但在处理连续信号的时候,无状态是一种错误的建模——因为你手上那一段数据的边界,是系统缓冲策略的产物,不是信号本身的性质。任何"按 buffer 独立处理"的写法,都在偷偷地把实现细节提升成了信号特征。重采样是这样,回声消除的滤波器是这样,编码器的帧间预测也是这样(这就是为什么编码器不能每帧新建)。
判断的方法很简单:问一句"如果上游把 buffer 切分方式改了,我的输出会变吗?" 会变,就说明你的处理和切分方式耦合了,而切分方式是你控制不了的东西。
第三,"够不着的完美方案"要能识别出来,并且尽快放弃
回声那一节是我做这块时印象最深的。参考信号完美地摊在手上,理论上的最优解清清楚楚,但中间缺一根管道,而这根管道不在你的权限范围内。
这种情况在移动端开发里非常常见——系统给了你能力 A 和能力 B,但没给你把它们接起来的接口。这时最贵的不是绕路的成本,是"我明明差一点就能做到"这个念头带来的沉没成本。
识别标准我总结成一句:如果最优解依赖一个你无法创造的接口,那它就不是"难做",是"做不了"。 做不了的事情要在第一周就判死,然后把精力放在路线 B 和路线 C 上——它们不优雅,但它们能在这周上线。
回到标题。录屏的音频比视频难,难点不在信号处理,在于音频是这条管线里唯一一个"时间不能商量"的部分。视频可以变帧率、可以丢帧、可以降分辨率,全都是可协商的降级。音频只有一条路:每一个采样点都必须在它该在的位置上,不多不少。
把这个约束想清楚,剩下的都是算术。
如果你正在排查录屏音频的问题,最快的定位方法是先把混音那一步关掉,两路各写一个 .caf 原始文件出来,用波形软件打开对齐看。90% 的问题(格式错、索引错、稀疏流被当连续流)在波形上一眼就能看出来,比在代码里读半天有效得多。
关于本文代码
文中的 Swift 示例用于说明思路、API 调用形态和参数量级,未逐行编译验证,直接复制到工程里需要补全上下文(AudioStreamBasicDescription 的完整构造、AudioBufferList 的分配与释放配对、环形缓冲的并发保护与内存屏障、CMTime 的 flag 检查、AudioConverter 各状态码的分支处理、以及 Extension 内的线程约束等)。softClip 那段刻意写得简化,实际工程建议用带 lookahead 的峰值限幅器。
文中的数值(384 KB/秒、44100 / 1024 ≈ 43 Hz、各类 dBFS 量级)均为按公开的采样率、位深、声道数直接计算或按行业常规量级给出,可自行复算。涉及的系统行为(.audioApp 的稀疏性与格式变化、ReplayKit 视频的可变帧率、Broadcast Extension 的内存上限量级、voice processing 的可用范围)以公开文档与实际调试观察为准,不同 iOS 版本与设备可能存在差异,请以你手上的设备实测为准。