一、先说一个你迟早会遇到的场景
你做了一个录屏功能。ReplayKit 给你视频 sample,也给你 App 音频 sample,你老老实实喂给 AVAssetWriter,出了 mp4,能播。测试同学录了十几秒,说"挺好的"。
上线。第二周开始收到反馈:"录长了以后声音对不上口型。"
你自己录一遍复现。前 30 秒完全正常,1 分钟的时候你隐约觉得有点怪但说不出哪怪,5 分钟的时候声音明显比画面早了将近半秒,10 分钟的时候已经没法看了。
这个 bug 有几个特征,值得先记下来,因为它们几乎定义了整个问题域:
- 短样本测不出来。 你的单元测试录 3 秒,QA 录 20 秒,全过。
- 它是单调的,不是随机的。 每次录,偏移的方向都一样,量级和时长成正比。这说明它不是"抖动",是"漂移"——有一个恒定的速率差在积分。
- 没有任何一层报错。
AVAssetWriter全程status == .writing,append全返回true,编码器没有丢帧回调,文件的 moov 结构完全合法。 - 修好之后,你会发现同一个根因还藏在另外三个地方。
音画同步这个题目的难点不在"知道什么是 PTS"。PTS 是什么,官方文档三行讲完了。难点在于:它是一个由六七个独立子系统各自贡献误差、最后在时间轴上求和的问题,而你只能在最终产物里看到那个和。这篇文章按我实际踩的顺序,把这几个来源拆开写。
先给结论,方便你对号入座:
| 现象 | 大概率根因 |
|---|---|
| 从头就偏,偏移量恒定,不随时长增长 | 两条流各自归零,起点没对齐 |
| 偏移量随时长线性增长 | 时间戳是"累加"出来的,不是"重算"出来的 |
| 只在接了麦克风之后偏 | 重采样器的实际输出帧数 ≠ 理论值 |
| 只在某些导入素材上偏,且画面还会轻微倒退 | 把 PTS 当 DTS 用了,素材有 B 帧 |
| 变速/倒放之后偏 | 时间投影的方向搞反了 |
| 不是恒定偏移,而是画面时快时慢地"呼吸" | 纠偏做成了连续的,没有死区 |
二、把账算死:为什么是 9.4 毫秒每秒
在讲坑之前,先把最典型的那个漂移算出来。这个算术是整篇文章的锚点。
AAC 编码,采样率 44100 Hz,每个 AAC 帧固定 1024 个采样点。那么一个音频包代表的时长是:
1024 / 44100 = 0.023219954648526... 秒 = 23.219954648... 毫秒
这是一个无限循环小数。它不能被任何十进制的毫秒、微秒、纳秒精确表示。
现在假设你的时间戳用毫秒做单位(CMTime 的 timescale = 1000,或者你自己维护一个 Int64 毫秒计数器——这在自己写 muxer 或者跟服务端对接时非常常见)。你要给第 n 个包一个 PTS。最自然的写法是:
// 反面教材
var currentPTS: Int64 = 0            // 毫秒
func nextAudioPTS() -> Int64 {
    let pts = currentPTS
    currentPTS += 23                  // 1024/44100 ≈ 23.22ms,取整
    return pts
}
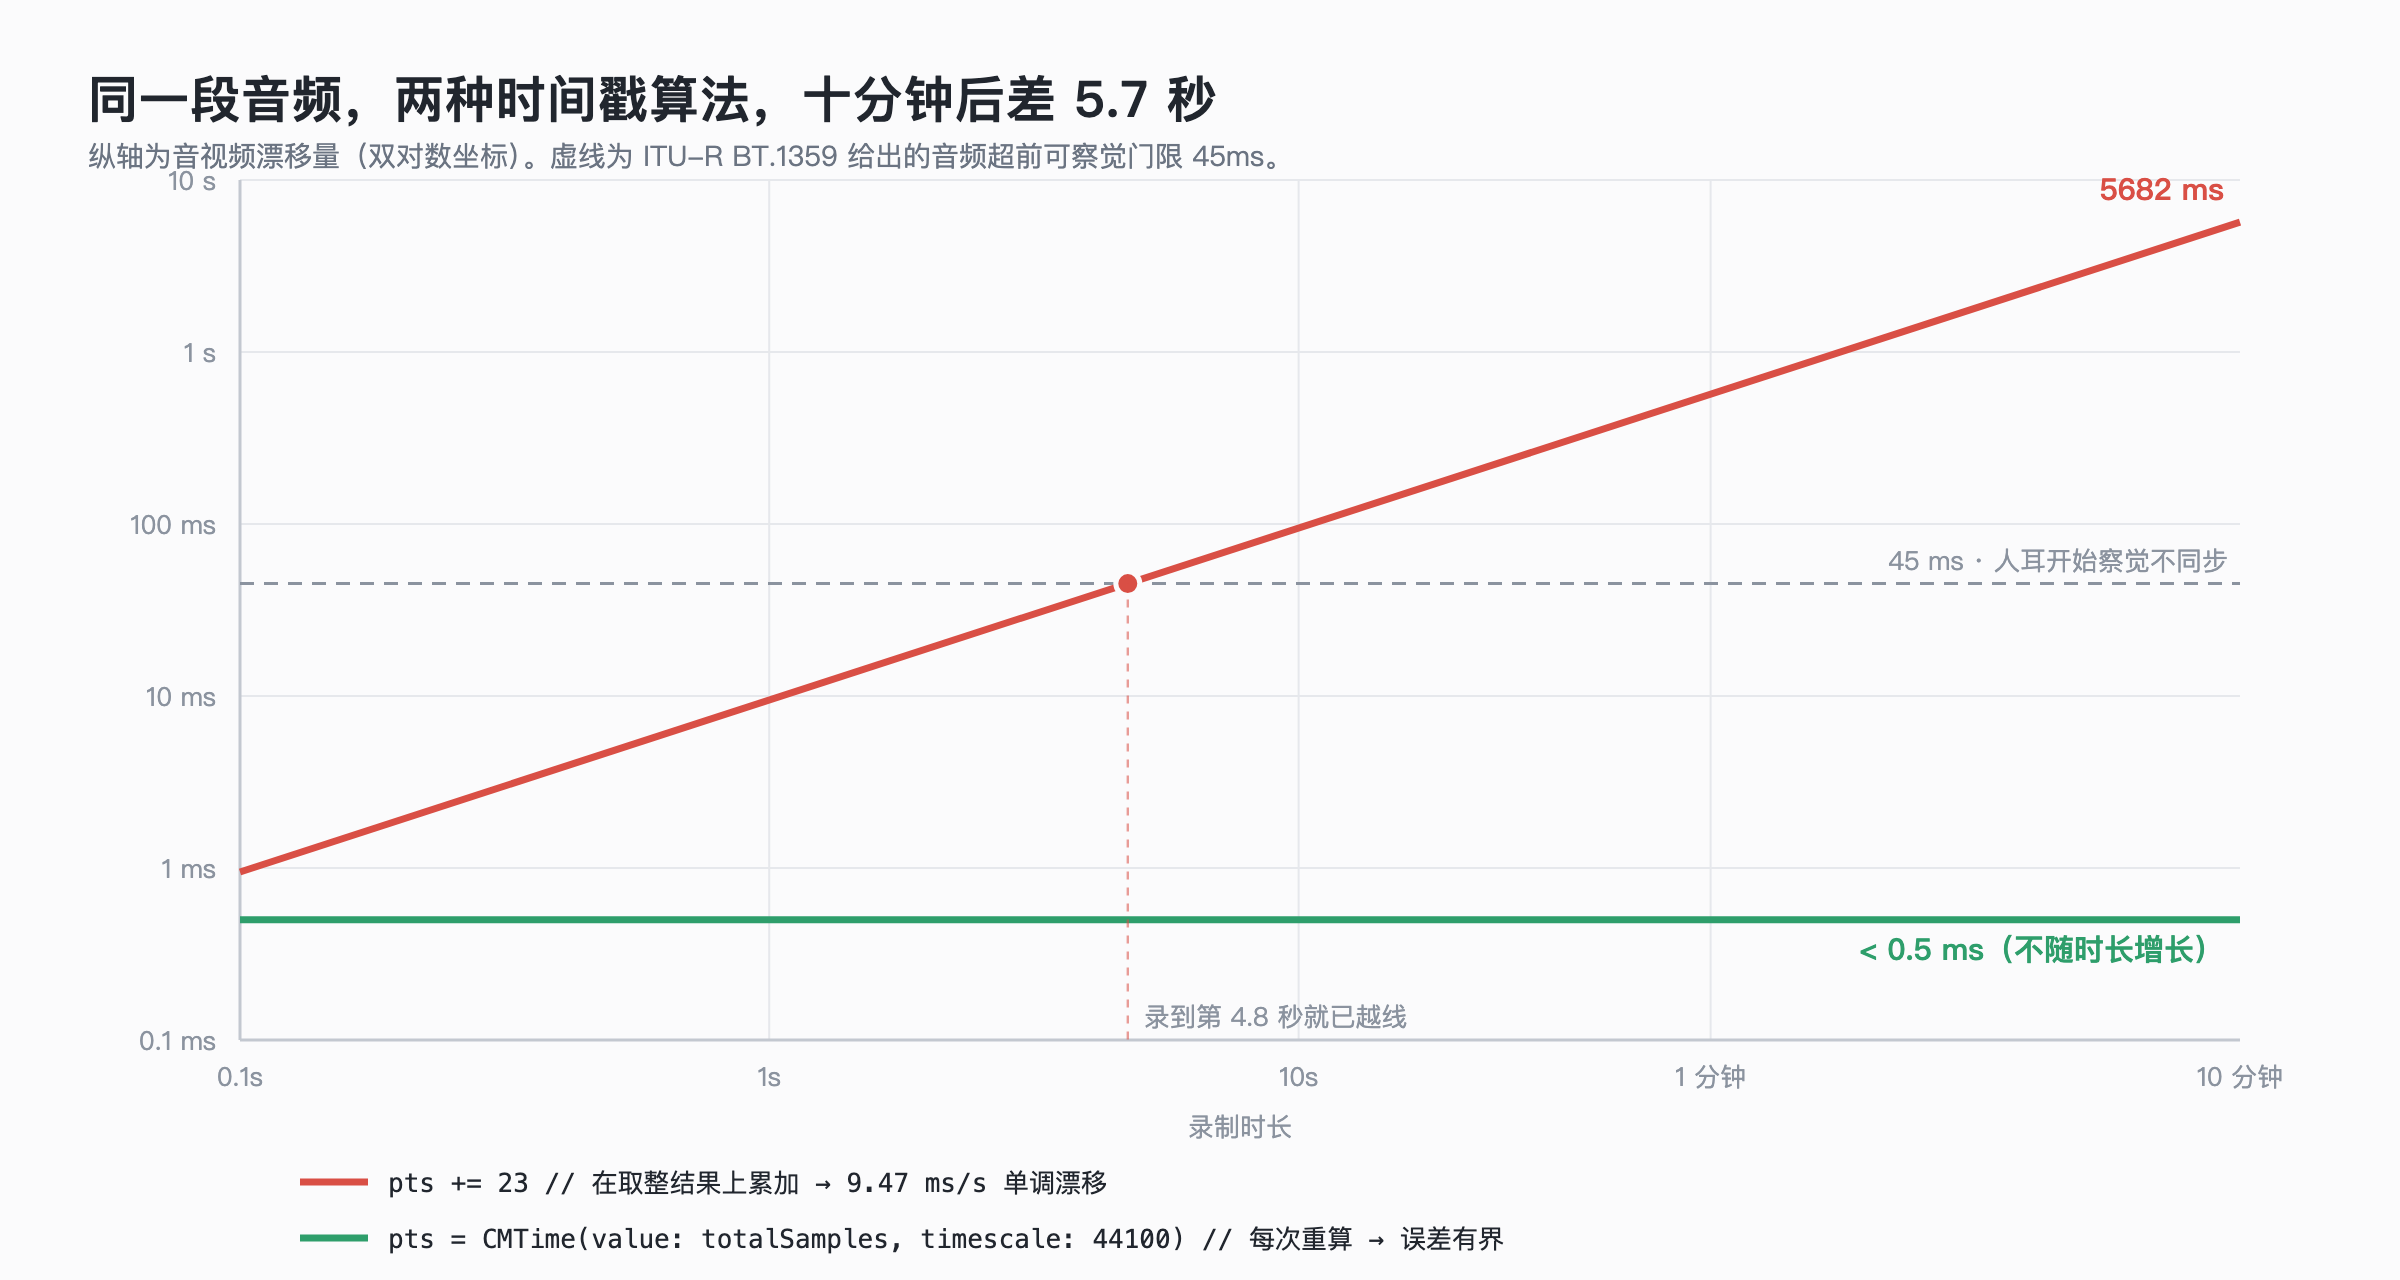
每个包丢 0.219954... 毫秒。一秒钟有 44100 / 1024 = 43.066 个包。于是:
43.066 × 0.21995 ≈ 9.47 毫秒 / 秒
每秒漂 9.47 毫秒。 一分钟 0.57 秒,十分钟 5.7 秒。
对照第一节那个场景:1 分钟"隐约觉得怪"(0.57 秒,已经过了可察觉阈值但还没到难受),5 分钟"明显早了半秒"——等一下,5 分钟按这个算是 2.8 秒,不止半秒。是的,实际项目里通常不会这么极端,因为往往只有一部分链路在做毫秒取整,另一部分是精确的,两者相减才是净漂移。但方向和量级是这么来的。
现在关键的一步。很多人看到这个算术,第一反应是"那我提高精度,用微秒不就行了"。
用微秒,每包误差从 0.22ms 降到 0.00045ms,每秒漂 0.02ms,十分钟漂 12ms。看起来是解决了。
但这只是把问题推远,没有消灭它。 而且它掩盖了真正的根因。
真正的根因不是"取整",是**"在取整后的值上继续累加"**。你把一个有损的结果当成了下一次计算的基准,误差就从"有界"变成了"积分"。
正确的写法不是提高精度,是换一个自变量——用采样点计数当自变量,每次从零重算:
// 正确:totalSamples 是精确的整数,永不失真
private var totalSamples: Int64 = 0

func nextAudioPTS(sampleRate: Int32) -> CMTime {
    let pts = CMTime(value: totalSamples, timescale: sampleRate)
    totalSamples += 1024
    return pts
}
注意两件事:
totalSamples是整数,+= 1024永远精确,没有任何舍入。timescale取sampleRate本身(44100),于是1024/44100在CMTime里是精确表示的有理数,连近似都没有发生。
于是就有了第一条可以直接抄走的规则:
音频时间戳的 timescale 必须等于采样率。 44100Hz 的流用
timescale = 44100,48000Hz 的用 48000。不要用 1000,不要用 600,不要用 1000000000。
用采样率当 timescale,所有 PTS 都是整数分子,整条链路零舍入。用毫秒,你从第一个包开始就在积累一个确定性的、单调的、不可逆的误差。
而即使你被迫要转成毫秒(比如给服务端的协议只收毫秒),只要你保留 totalSamples 作为唯一真值源、每次从它重算,误差就永远 ≤ 半个 tick,不累积:
let ms = (totalSamples * 1000) / Int64(sampleRate) // 每次重算,误差有界
这个模式——保留精确的自变量,每次重算,绝不在结果上迭代——不止用于音频。你写定时器的时候,nextFire = now + interval 是错的(会漂),nextFire = startTime + n * interval 是对的。同一个错误,换了层皮。
三、坑 1:两条流各自归零,起点就已经错了
这是"从第一帧就偏、且偏移量恒定"的那一类。
录屏的两条流是异步到达的。视频帧只在屏幕内容变化时产生(ReplayKit 不会给你固定 60fps 的稳定流,静止画面时它就不送了),音频是设备时钟驱动的,只要有声音就恒定送包。所以第一个视频 sample 和第一个音频 sample 的到达时刻,差多少完全不由你决定,几十到几百毫秒都可能。
然后你写了这样的代码:
// 反面教材
private var videoStart: CMTime?
private var audioStart: CMTime?

func handle(video sb: CMSampleBuffer) {
    let pts = CMSampleBufferGetPresentationTimeStamp(sb)
    if videoStart == nil { videoStart = pts }          // 视频自己归零
    let rebased = CMTimeSubtract(pts, videoStart!)
    // ...
}

func handle(audio sb: CMSampleBuffer) {
    let pts = CMSampleBufferGetPresentationTimeStamp(sb)
    if audioStart == nil { audioStart = pts }          // 音频自己归零
    let rebased = CMTimeSubtract(pts, audioStart!)
    // ...
}
看起来对称、优雅、每条流都从 0 开始。
但它把两条流之间真实存在的时间差抹掉了。如果视频第一帧比音频第一包晚到 180ms,这 180ms 是物理事实——它意味着"录制开始后 180ms 屏幕才发生第一次变化"。你把它归零,等于宣称这两个事件同时发生。结果就是整条视频的画面比声音早了 180ms,恒定,不随时长变化。
正确做法是用一个共同的零点,取两条流中先到的那个:
private let lock = NSLock()
private var sessionStart: CMTime?

/// 返回相对于会话起点的时间戳;两条流共用同一个起点
private func rebase(_ pts: CMTime) -> CMTime {
    lock.lock(); defer { lock.unlock() }
    if sessionStart == nil {
        sessionStart = pts          // 谁先来谁定零点
    }
    return CMTimeSubtract(pts, sessionStart!)
}
有个前提必须确认:两条流的 PTS 得在同一个时钟域里,相减才有意义。ReplayKit 给的 sample buffer,视频和音频的 PTS 都锚在 mach_absolute_time 的主机时钟上,可以直接相减。但如果你的音频来自 AVAudioEngine 的 tap(AVAudioTime 里的 hostTime)、视频来自 AVCaptureSession,就要先确认两者的 CMClock 是不是同一个:
// 检查 sample buffer 挂的时钟
let clock = CMSampleBufferGetOutputPresentationTimeStamp(sb)
// AVCaptureSession 上可以直接问
let captureClock = captureSession.masterClock   // CMClock?
let hostClock = CMClockGetHostTimeClock()
不在同一个域,就得用 CMSyncConvertTime(_:from:to:) 换算,而不是直接减。直接减出来的差值是两个无关时钟的差,随便什么值都可能。
还有一个容易忽略的细节:如果视频先到,你还要处理"音频前面缺一段"的情况。有的实现会在这里补静音,有的会把 writer 的 session start time 设到第一个音频包。前者更安全——AVAssetWriter 的 startSession(atSourceTime:) 一旦定了,比它早的 sample 会被直接丢弃或被 clamp,而这个丢弃是静默的。
writer.startWriting()
writer.startSession(atSourceTime: .zero)   // 归零后的坐标系,起点就是 0
四、坑 2:重采样器的输出帧数不等于你算的那个数
这是"接了麦克风之后才偏"的那一类。
录屏要混两路音:App 内部声音(ReplayKit 给的 audioApp)和麦克风(audioMic)。这两路的格式经常不一样——App 音可能是 44.1kHz 立体声,麦克风是 48kHz 单声道,或者反过来,且会随着设备、路由(插耳机、连蓝牙)变化。你得重采样到统一格式再混。
用 AVAudioConverter:
let converter = AVAudioConverter(from: inFormat, to: outFormat)!

func convert(_ input: AVAudioPCMBuffer) -> AVAudioPCMBuffer? {
    let ratio = outFormat.sampleRate / inFormat.sampleRate
    let capacity = AVAudioFrameCount(Double(input.frameLength) * ratio) + 1024
    guard let output = AVAudioPCMBuffer(pcmFormat: outFormat,
                                        frameCapacity: capacity) else { return nil }

    var consumed = false
    var error: NSError?
    let status = converter.convert(to: output, error: &error) { _, outStatus in
        if consumed { outStatus.pointee = .noDataNow; return nil }
        consumed = true
        outStatus.pointee = .haveData
        return input
    }
    guard status != .error else { return nil }
    return output
}
这段代码本身没问题。问题在调用方怎么推进时间戳。
// 反面教材
let outFrames = Int64(Double(input.frameLength) * ratio)   // 理论值
totalOutSamples += outFrames
converter.convert 返回后,output.frameLength 才是真正产出的帧数,它和理论值不一定相等。 原因有几个:
- 重采样比不是整数时(48000 → 44100 是 147:160),每次调用的输出帧数会在两个相邻整数之间摆动。你算出来的是平均值,实际是这一次的值。
- 转换器内部有滤波器延迟(priming)。前几次调用可能返回 0 帧,或者返回的帧数明显少于理论值——数据还在内部缓冲里没吐出来。
.inputRanDry状态下它会吐出比预期少的数据,等你下次喂。
所以规则是:
永远用
output.frameLength推进时间戳,不用理论值。
guard let converted = convert(input), converted.frameLength > 0 else { return }
let pts = CMTime(value: totalOutSamples, timescale: Int64(outFormat.sampleRate))
totalOutSamples += Int64(converted.frameLength)     // 实际值
注意这里又回到了第二节那条规则:totalOutSamples 是精确整数,PTS 每次从它重算,timescale 是采样率。三条规则是同一条。
顺带说 priming 的另一面:转换器前面吐出来的那几十个采样点是滤波器的瞬态,理论上应该丢掉(AAC 编码器也有类似的 encoder delay,通常 2112 个采样点,标准做法是在容器里用 edit list 标注)。对录屏这种场景,几十个采样点是 1 毫秒不到,远在感知阈值以下,我一般不处理——但你要知道它存在,因为在需要"多段拼接后严丝合缝"的编辑场景里,每段都少那么一点点,拼十段就出来了。
这是不是又是一个"在结果上累加"的问题? 是的。这已经是第三次以不同面貌出现了。
五、坑 3:把 PTS 当 DTS,B 帧素材上炸
前面几个坑都在音频侧。这一个在视频侧,但它的症状是音画不同步——这是我觉得这个坑最值得写的地方:你查了半天音频,根因在视频,而且和音频毫无关系。
先把 PTS 和 DTS 的区别讲清楚,因为大量中文材料把这个讲拧了。
- PTS(Presentation Time Stamp):这一帧应该在什么时刻显示。
- DTS(Decode Time Stamp):这一帧应该在什么时刻送进解码器。
没有 B 帧时,两者相等。有 B 帧时,解码顺序和显示顺序不一致:
显示顺序:  I0   B1   B2   P3   B4   B5   P6
解码顺序:  I0   P3   B1   B2   P6   B4   B5
B1 要参考 I0 和 P3 双向预测,所以 P3 必须先解出来。于是编码器输出的顺序是解码顺序,PTS 在这个序列里是乱序的(0, 3, 1, 2, 6, 4, 5),DTS 是单调递增的。
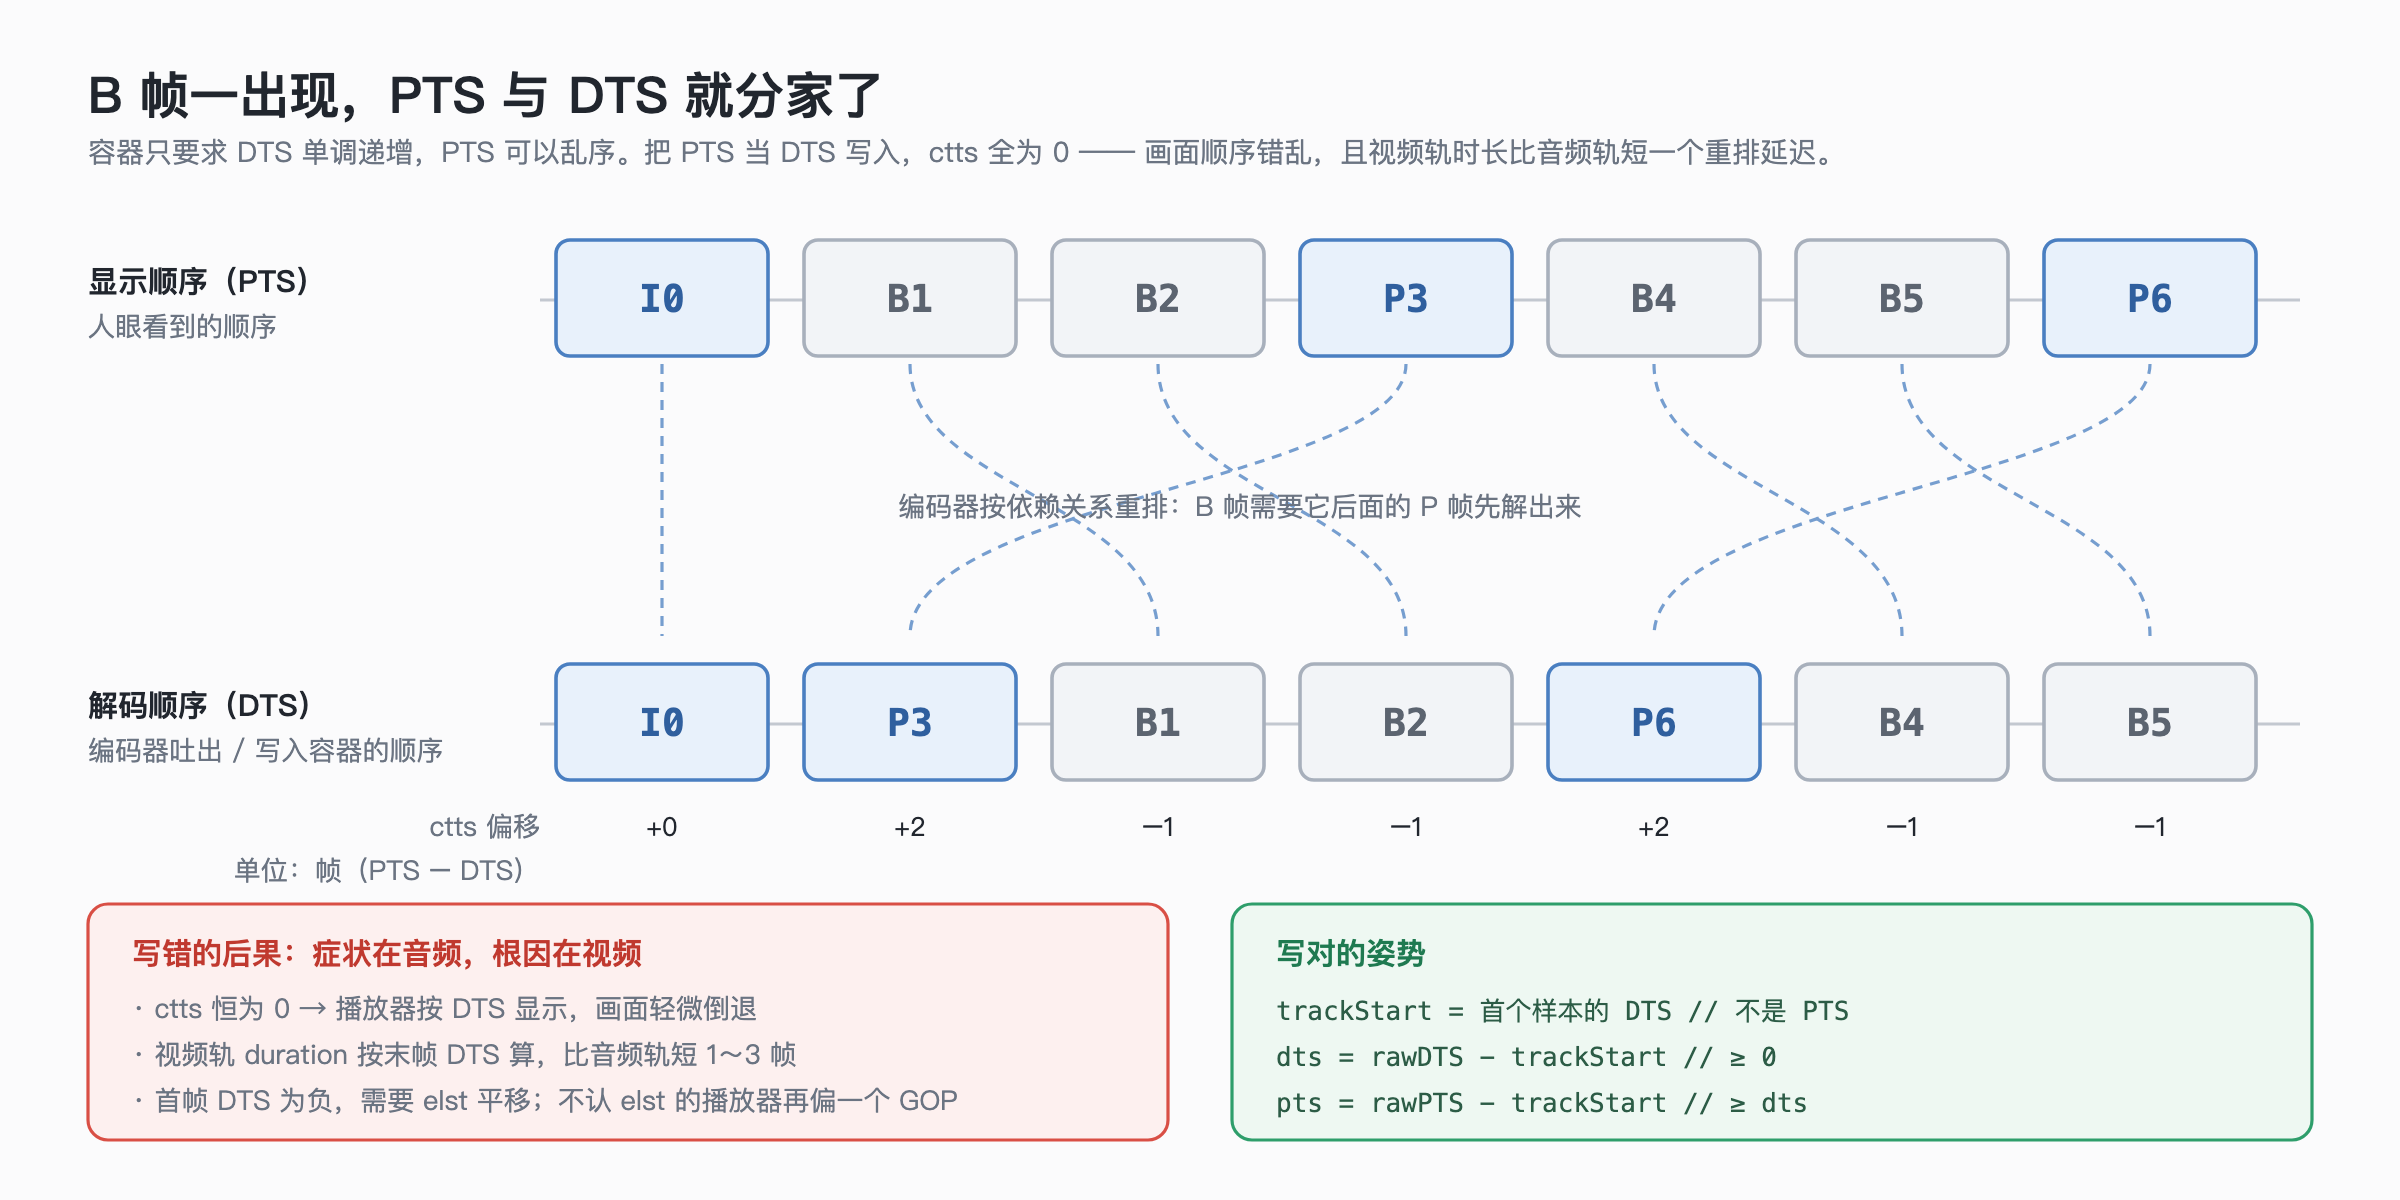
容器(mp4)的核心约束是:DTS 必须单调递增。PTS 可以乱序。 mp4 里 stts 存的是解码时间的增量,ctts 存的是 PTS 相对 DTS 的偏移(composition offset)。
现在看常见的第一版 muxer 代码:
// 反面教材
let pts = CMSampleBufferGetPresentationTimeStamp(sampleBuffer)
appendSample(pts: pts, dts: pts, data: ...)     // 没有 B 帧的时候,这是对的
对于录屏,这段代码完全正确,因为录屏编码通常关掉帧重排(低延迟、且屏幕内容 B 帧收益小):
VTSessionSetProperty(session,
                     key: kVTCompressionPropertyKey_AllowFrameReordering,
                     value: kCFBooleanFalse)
关掉之后 PTS ≡ DTS,怎么写都对。所以这个 bug 在录屏产品里可能永远不暴露。
然后你做编辑器,开始处理用户导入的素材。 别人相机拍的、别人 App 导出的、从网上下的——里面有 B 帧。这时候上面那行代码就变成了:
ctts全是 0,播放器按 DTS 顺序显示,画面在 B 帧段落轻微倒退/抖动(很多人以为是解码性能问题)。- 更隐蔽的:视频轨的 duration 算错了。 轨道时长是按最后一个样本的 DTS + duration 算的,而真实的显示时长应该到最大 PTS。有 B 帧重排时两者差一个重排延迟(通常 1~3 帧,30fps 下 33~100ms)。音频轨没这个问题,时长是准的。于是
mvhd里两条轨道时长不一致,后续任何按轨道时长做对齐的环节(拼接、转码、某些播放器的 seek)都会引入一个偏移。
症状是音画不同步,根因在 DTS。
还有一个更刺激的:第一帧的 DTS 可能是负数。 开了帧重排,第一个输出的帧其 DTS 会小于其 PTS;如果你把 PTS 归零到 0,DTS 就是负的。而 stts 里的时间是无符号的。标准解法是写一个 edit list(elst box)把整条轨道往后平移,但不是所有播放器都正确处理 elst——不处理的那些,就把这个重排延迟当成了真实内容,视频比音频晚了一个 GOP 重排的量。
实际处理上,最省事的做法是:不要自己归零 DTS,把整条流平移到 DTS 从 0 开始,而不是 PTS 从 0 开始,然后让 PTS 相对它为正:
// 以第一个样本的 DTS 作为零点(它是全流最小的时间戳)
if trackStart == nil {
    trackStart = CMSampleBufferGetDecodeTimeStamp(sampleBuffer)
    if trackStart == .invalid {                       // 无 B 帧时 DTS 可能是 invalid
        trackStart = CMSampleBufferGetPresentationTimeStamp(sampleBuffer)
    }
}
let dts = CMTimeSubtract(rawDTS, trackStart!)         // ≥ 0
let pts = CMTimeSubtract(rawPTS, trackStart!)         // ≥ dts
注意 CMSampleBufferGetDecodeTimeStamp 在没有 B 帧时返回 kCMTimeInvalid,得兜底。这种"API 在一半情况下返回 invalid 而不是等于另一个值"的设计,是 Core Media 里的常见模式,也是这类 bug 的温床。
用 AVAssetWriter 的话它替你处理了 ctts 和 elst,这一节可以跳过。但只要你要自己写 muxer、或者要把编码结果发给服务端/RTMP,DTS 就是你的事了。
六、坑 4:变速的时候,投影方向反了
编辑器里做 0.5x / 2x / 倒放。直觉写法:
// 反面教材
let newPTS = CMTimeMultiplyByFloat64(oldPTS, multiplier: 1.0 / rate)
对每个 sample 做一次,音视频各做各的。
这是错的,而且错得很隐蔽——短片段完全看不出来,长片段、多段拼接之后才出来。
原因是量化格点不同。视频 PTS 的 timescale 是 600(或者 30000/1001),音频是 44100。同一个源时间 t 乘以同一个 rate,落到两条流上会被舍入到各自网格的不同位置。单次误差是微秒级,无所谓;但你是在逐 sample 累积地做这件事,而且两条流的采样密度差 1000 倍(视频 30 个/秒,音频 43 个包/秒但 44100 个采样点/秒),误差的统计行为完全不同。更糟的是 CMTimeMultiplyByFloat64 会经过 double,而 double 在大 timescale × 长时长的组合下开始丢有效位。
正确的做法是把投影方向反过来:
- 错误方向:源时间 → (乘 rate)→ 时间线时间。每个源 sample 各自算自己落在时间线的哪里。
- 正确方向:时间线时间 → (除 rate)→ 源时间。 先把输出时间轴按输出格式的网格定死(视频按帧号 n / fps,音频按采样点数 m / sampleRate,都是精确有理数),再反过来问"这个输出时刻需要源里的哪个位置"。
// 输出第 n 帧,输出帧率 fps,速率 rate
func sourceTime(forOutputFrame n: Int64, fps: Int32, rate: Double,
                segmentStart: CMTime) -> CMTime {
    // 输出时间:精确有理数,零舍入
    let outTime = CMTime(value: n, timescale: fps)
    // 反投影到源
    let delta = CMTimeMultiplyByFloat64(outTime, multiplier: rate)
    return CMTimeAdd(segmentStart, delta)
}

// 输出第 m 个采样点
func sourceTime(forOutputSample m: Int64, sampleRate: Int32, rate: Double,
                segmentStart: CMTime) -> CMTime {
    let outTime = CMTime(value: m, timescale: sampleRate)
    let delta = CMTimeMultiplyByFloat64(outTime, multiplier: rate)
    return CMTimeAdd(segmentStart, delta)
}
关键差别:输出侧的时间戳永远是精确的(n/fps 和 m/sampleRate 都是整数分子除以固定分母),舍入只发生在"去源里取哪个数据"这一步,而那一步的误差不进入输出时间轴、不累积、最多让你多取或少取一个采样点。
倒放同理,只是 n 从大到小,rate 取负号后加上段长。音频倒放还得处理"AAC 帧不能简单倒序"——得先解到 PCM,按采样点反转,再重编码。而且反转后要注意声道交织(interleaved)格式下不能直接 reverse() 整个 buffer,得按 frame 为单位反转。
这条规则同样可以抽象出来:
让输出网格做自变量,让输入做被查询方。 不要让每个输入元素自己去争夺输出位置。
七、坑 5:谁是主时钟——这个选择是单向的
到这里为止都是"减少误差"。但误差不可能归零:设备的音频时钟晶振和你算 PTS 用的名义采样率就是有偏差的(几十 ppm 是常态,44100 标称的设备实际可能跑在 44099.7 Hz),长时间录制一定会有残余漂移。所以还得有一个持续纠偏机制。
纠偏的第一个问题是:谁追谁?
答案在实践中几乎没有争议:视频追音频,永远不要反过来。
理由不是技术上的对称性,是感知上的不对称性:
- 视频少显示一帧或多显示一帧,人眼在正常内容下基本察觉不到(33ms 的时基抖动,在有运动的画面上勉强能感觉到"顿"了一下)。
- 音频丢一个包或者重复一个包,是爆音。变速播放音频不做变调补偿的话,是变调。这两个人耳一秒钟就抓到。
所以纠偏的实现是单向的:音频时间戳直接透传(它就是时钟本身),视频时间戳向音频对齐,手段是丢帧或复制帧。
/// 音频是权威时钟:它的时间戳原样写入,不做任何调整
func appendAudio(_ sb: CMSampleBuffer) {
    audioInput.append(sb)                       // 不纠偏
    lastAudioPTS = CMSampleBufferGetPresentationTimeStamp(sb)
}
这条规则有个推论,值得单独说:如果你的架构里音频链路可能阻塞(比如混音在主线程、或者音频要过一个可能卡住的处理器),你就没有主时钟了。 音频一卡,权威时钟停摆,视频对着一个不走的钟对齐,全线崩溃。所以音频链路必须是整个管线里优先级最高、最不可能被阻塞的那条——不是因为音频重要,是因为它是时钟。
我把这个当成录屏/直播管线的一条硬约束:音频处理链路上不允许有任何可能等待的操作(不加锁竞争、不做文件 IO、不分配大内存、不调用可能触发 IPC 的 API)。这是个架构约束,不是性能优化。
八、最反直觉的一条:容忍固定偏移,零容忍抖动
现在到了这篇文章我觉得最值钱的一段。
你知道了要纠偏,也知道了视频追音频。于是很自然地写出这样的纠偏逻辑:
// 反面教材
let drift = CMTimeSubtract(videoPTS, audioPTS)
let corrected = CMTimeSubtract(videoPTS, CMTimeMultiplyByFloat64(drift, multiplier: 0.1))
// 每帧纠掉 10% 的偏差,平滑收敛
"平滑收敛"听起来很专业。它是错的。
因为人眼对"固定偏移"的容忍度,远高于对"时基抖动"的容忍度。
这个反直觉在两个层面:
第一层:容忍阈值本身很宽,而且不对称。
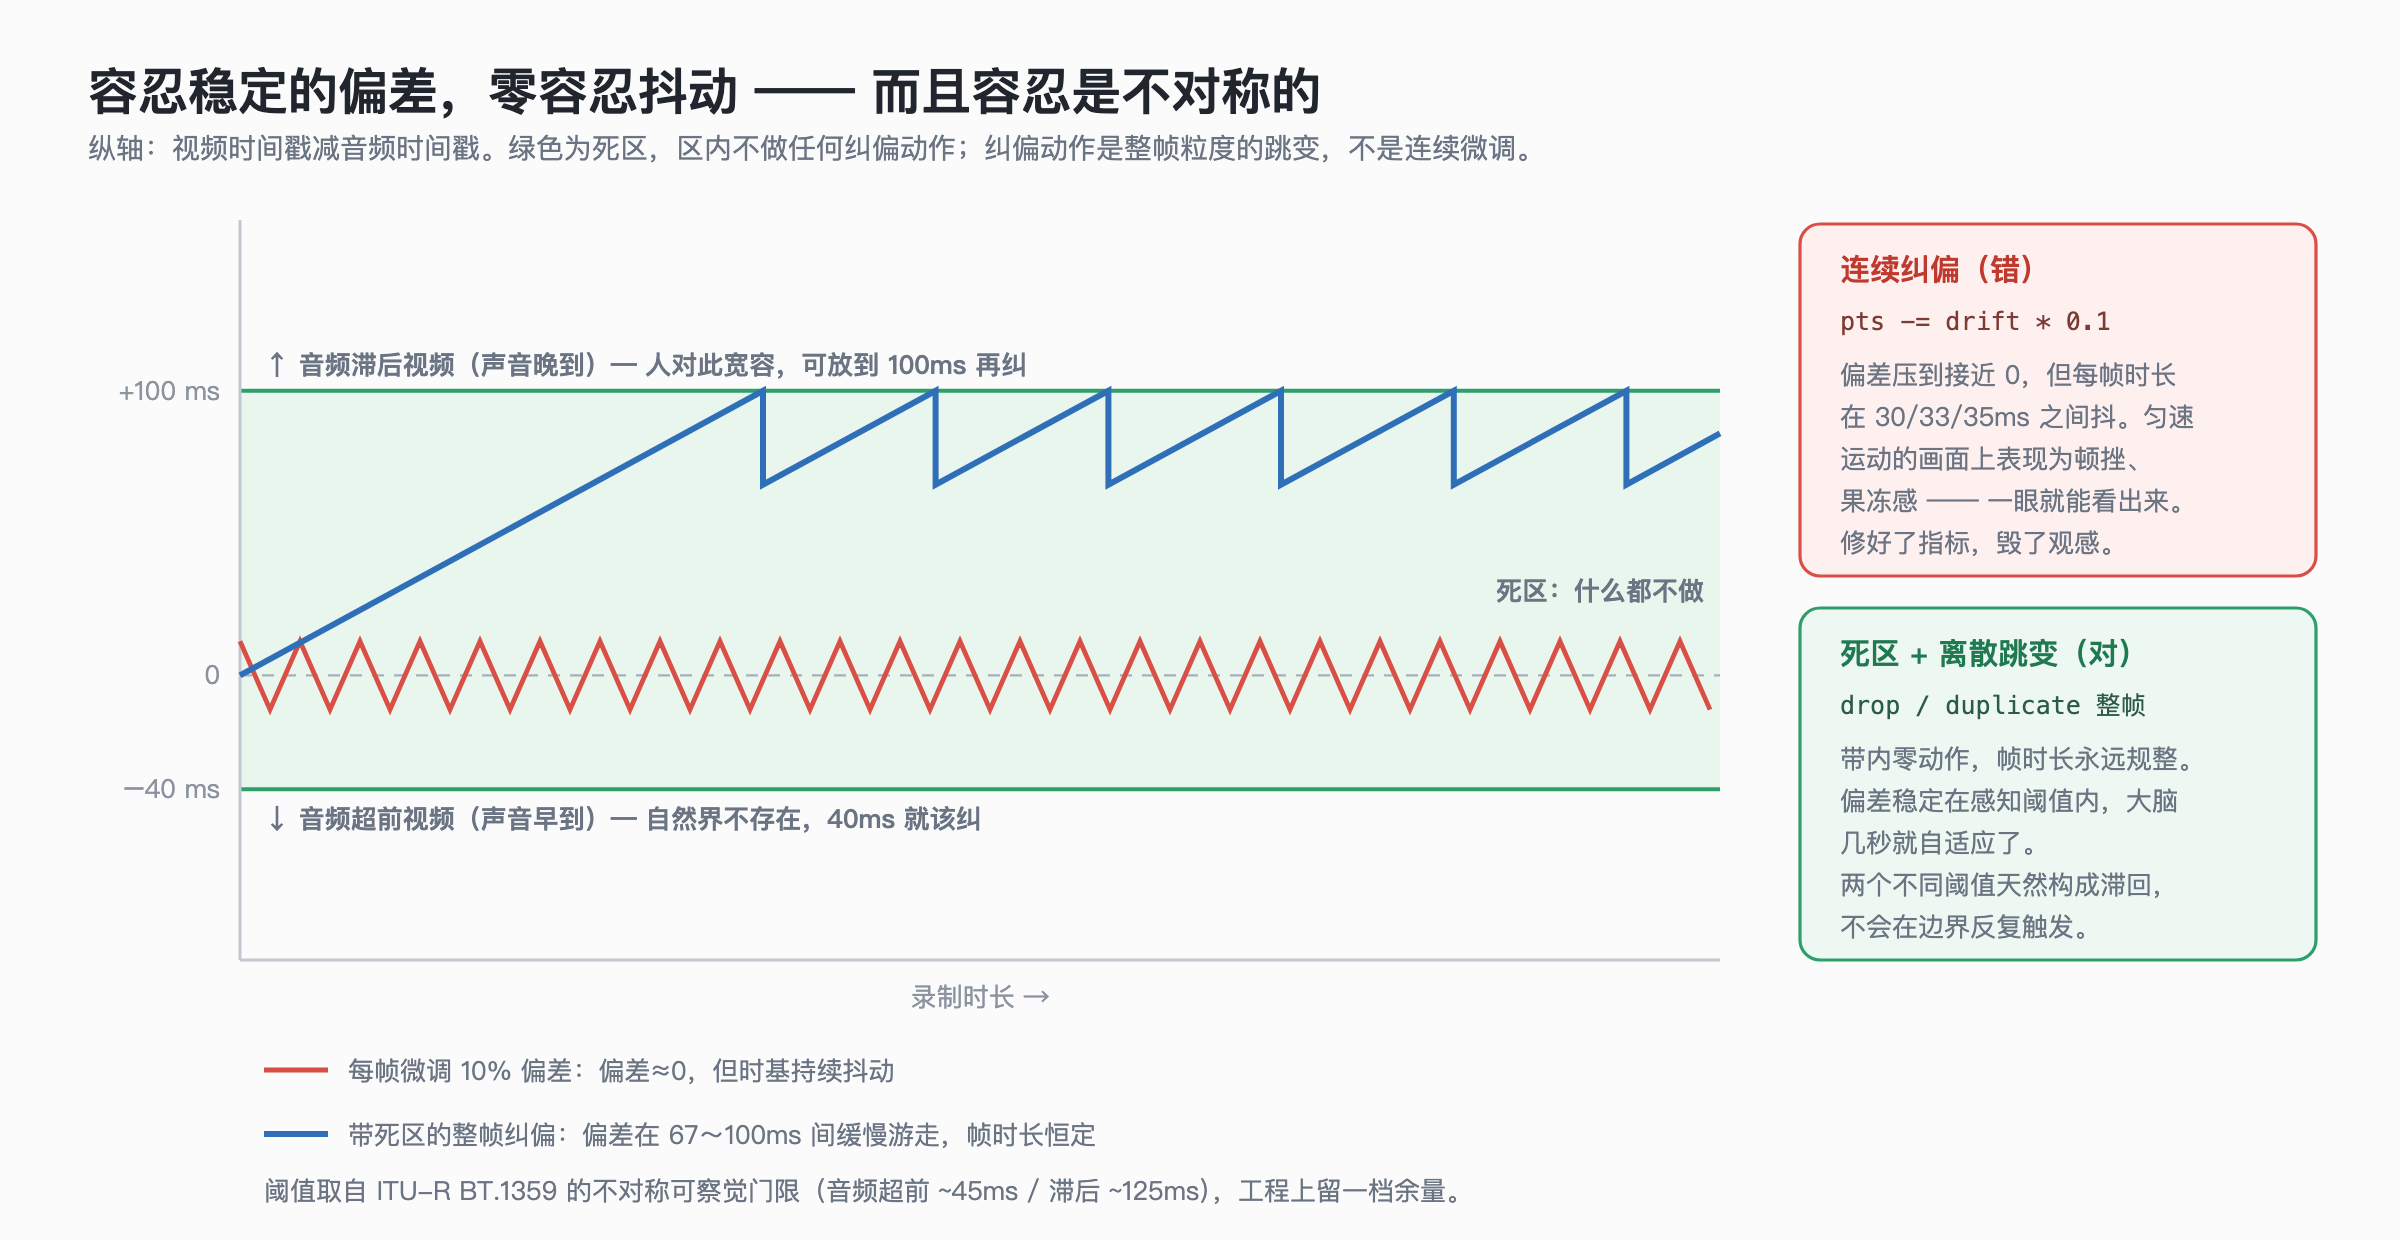
ITU-R BT.1359 给出的音视频不同步可察觉门限是:音频超前画面约 45 毫秒开始可察觉,音频滞后画面约 125 毫秒才开始可察觉。相关的广播运行容差(如 ATSC IS-191)给的是更严的运行区间,但不对称的形状是一致的:对"声音晚"的容忍度是对"声音早"的两三倍。
为什么不对称?因为这是物理世界的先验。光速远快于声速,现实中你看到远处的动作总是先于听到它的声音——300 米外的一次撞击,声音晚到快 1 秒,人类完全不觉得异常。反过来,"声音先于事件发生"在自然界不存在,所以大脑对它极其敏感。
这个不对称直接改变工程决策:你的纠偏阈值应该是不对称的。 音频超前视频超过 ~40ms 就该处理;音频滞后视频,可以放到 ~100ms 才处理。用一个对称的 ±50ms 阈值,你在一侧过度纠偏(做了不必要的动作),在另一侧纠偏不足。
第二层(更反直觉):稳定的 80ms 偏移,观感好于在 0 和 40ms 之间来回修正。
因为连续纠偏意味着你在不断微调视频帧的时长:这一帧 33ms,下一帧 30ms,再下一帧 35ms。对于匀速运动的画面(横向滚动的列表、平移的镜头、游戏里的移动),时基抖动会表现为可见的"顿挫"或"果冻感"——人的视觉系统对运动的时间一致性非常敏感,这正是 24fps 电影感、判断掉帧、以及 VRR 显示器要解决的那个问题。
而一个恒定的 80ms 偏移,只要它稳定,观众看几秒就适应了——大脑本来就在做视听时间对齐的自适应(这是有神经科学证据的现象,通常称为 temporal recalibration)。
所以正确的纠偏是带死区(dead zone)+ 离散跳变,不是连续平滑:
private let driftThresholdAudioAhead  = CMTime(value: 40,  timescale: 1000)  // 音频超前
private let driftThresholdAudioBehind = CMTime(value: 100, timescale: 1000)  // 音频滞后

/// 返回:这一帧该怎么处理
enum FrameAction { case pass, drop, duplicate }

func decide(videoPTS: CMTime, audioPTS: CMTime) -> FrameAction {
    // drift > 0 表示视频领先音频(= 音频滞后)
    let drift = CMTimeSubtract(videoPTS, audioPTS)

    if drift > driftThresholdAudioBehind {
        // 视频跑太快了,让它等一等:复制一帧,把视频时间轴往后推
        return .duplicate
    }
    if drift < CMTimeMultiply(driftThresholdAudioAhead, multiplier: -1) {
        // 视频落后音频超过 40ms(音频超前),丢一帧追上去
        return .drop
    }
    return .pass    // 死区内:什么都不做
}
三个设计要点:
- 死区内绝对不动。 不是"少动一点",是零动作。任何在死区内的微调都是纯粹的抖动源。
- 纠偏是整帧粒度的离散动作(丢一帧 / 复制一帧),不是分数微调。因为容器里的每帧时长本来就该规整,分数微调会让
stts变成一堆不重复的值,文件更大、播放器 seek 更慢。 - 阈值不对称,按本节前面那个感知不对称来设。
顺带一提,第 3 点还带来一个好处:滞回(hysteresis)。用两个不同的阈值本身就构成了滞回带,天然避免了在单一阈值附近反复触发纠偏的振荡。
归纳成一句话:同步的目标不是让偏差为零,是让偏差稳定在感知阈值内。 这两个目标在工程上是冲突的——追求零偏差必然引入抖动,而抖动比偏差更难受。
九、诚实说:什么时候你不该做这些
前面写了这么多,得说清楚适用边界,不然是害人。
如果你的场景是:单一来源的采集(一个 AVCaptureSession 同时出音视频)、直接喂 AVAssetWriter、不做变速、不导入外部素材——那你什么都不用做。
AVCaptureSession 给的两条流本来就锚在同一个 master clock 上,AVAssetWriter 会正确处理 ctts / elst / 轨道时长。你唯一该做的是把系统给你的 PTS 原样透传,别自作聪明去"修正"它:
// 绝大多数场景,这就是全部正确答案
videoInput.append(sampleBuffer)      // PTS 用系统给的,别动
audioInput.append(sampleBuffer)
我见过(也写过)的一大类同步 bug,恰恰是因为在这种场景下自己去算了时间戳。系统给的 PTS 是硬件时钟采样的,比你任何一种推算都准。
真正需要这篇文章里那套东西的,是以下几种情况:
- 两条流来自不同的子系统(ReplayKit 视频 +
AVAudioEngine麦克风),时钟域可能不同。 - 中间有重采样、混音、变速这类会改变采样点数量的处理。
- 你自己写 muxer,或者要把编码结果推到 RTMP / WebRTC / 自定义协议(这时候 DTS 是你的事)。
- 需要长时间录制(> 10 分钟),残余漂移会被时长放大。
- 多段素材拼接,每段的小误差会累加。
如果你不在这五种情况里,用系统方案,别学我。
十、退到更高一层看
把这篇里的几条规则并排放,会发现它们其实是同一件事的几个投影:
| 具体规则 | 抽象形式 |
|---|---|
| 用 totalSamples 重算 PTS,不累加毫秒 | 保留精确自变量,永不在有损结果上迭代 |
| timescale 取采样率 | 让表示能精确容纳你的量化单位 |
| 用 converter 实际输出的 frameLength | 相信被观测值,不相信推算值 |
| 变速时从输出网格反投影到源 | 让输出做自变量,输入做被查询方 |
| 音频是主时钟,视频单向追随 | 选一个权威时钟,不做双向协商 |
| 死区 + 离散纠偏 | 容忍稳定的偏差,零容忍抖动 |
右边这一列里没有一条是音视频特有的。
"保留精确自变量、每次重算"——这是定时器漂移、动画进度、分页游标的同一个解法。 "选一个权威时钟,单向追随"——这是分布式系统里主从复制、NTP、传感器融合的同一个结构;双向互相对齐的系统会震荡,这在控制论里叫正反馈。 "容忍稳定的偏差,零容忍抖动"——这是网络抖动缓冲(jitter buffer)宁可加固定延迟也不让播放速率波动的理由,是 TCP 的 RTT 估计用平滑而非瞬时值的理由,也是 UI 里"稳定的 200ms 加载"体验好于"50~400ms 随机加载"的理由。
音画同步之所以是个好的练习题,是因为它把这几个原则同时压在一个能被人直接感知的输出上——你写错了,用户不用看日志,看一眼就知道。
最后回到标题:同步不是对齐一次,是选一个时钟、然后带着死区持续纠偏。 对齐一次的系统,只在对齐的那一刻是对的。
如果你正在排查这类问题,欢迎在评论区贴上你的时间戳序列片段(几十个 PTS 就够)——偏移是恒定的还是线性增长的、是单调的还是振荡的,基本上一眼能定位到上面六类里的哪一类。
关于本文代码
文中的 Swift 示例用于说明思路和 API 调用形态,未逐行编译验证,直接复制到工程里可能需要补全上下文(错误处理、线程约束、可选值解包、CMTime 比较运算符的重载等)。涉及的系统行为(AVAudioConverter 的输出帧数、CMSampleBufferGetDecodeTimeStamp 在无 B 帧时返回 invalid、AVAssetWriter 对 session start time 之前样本的处理)以公开文档与实际调试观察为准,不同 iOS 版本可能有差异,请以你手上的设备实测为准。ITU-R BT.1359 的门限数值引自公开标准文本。