当 AI 应用从 Demo 进入生产,麻烦通常不在 Prompt,而在模型调用本身:这次请求交给谁?主模型限流后怎么处理?成本怎么控制?流式响应中断后能不能切换?多实例运行时,配额和健康状态如何保持一致?
LLMRix Model Router 把这些问题收进了一层面向 Java 的开源路由框架。
这两年,模型接入的门槛已经降了很多。
用一个 SDK、写几行代码,应用就能调用 OpenAI、DeepSeek 或其他兼容接口。进入生产环境后,问题会换一批:上游会限流、超时,也可能发生区域性故障;模型的能力、价格、上下文窗口和响应速度各不相同。业务代码如果直接绑定供应商,换一次模型,接口、异常处理、监控和配置往往都要跟着改。
简单轮询或反向代理也解决不了这些判断。它们不知道请求是否需要工具调用,不知道图片输入应排除哪些模型,也不知道某个候选是否已经超出成本预算或处于冷却期。
LLMRix Model Router 就位于这层边界上。它是面向 Java 的多模型路由与编排框架,把供应商差异、模型选择、故障切换、配额、成本和观测从业务代码中移出来。
它位于 AI 应用和模型服务之间,承担运行时决策与请求转发。聊天 SDK 解决“如何调用”,Router 还要判断“调用谁、何时重试以及如何收敛状态”。
1. 架构总览:把决策、执行和基础设施拆开
项目的架构取舍很清楚:路由策略可以变化,请求执行的正确性不能跟着变化。为此,LLMRix 将系统拆成几层,各层有明确边界:
- 接入层:提供嵌入式 Java API、Orion 远程客户端,以及 Spring Boot 下的 OpenAI 兼容 HTTP/SSE 接口。
- 统一契约层:在
llmrix-model-open中定义 Chat、Embedding、Rerank、Audio、Image、Video 等模型接口、请求/响应对象和异常类型。 - 路由核心层:
llmrix-model-router-core负责目标模型、能力匹配、策略选择、执行预算、超时、重试、健康和生命周期事件。 - 集成层:
llmrix-model-router-integrations提供 OpenAI、DeepSeek、OpenRouter、Ollama、Redis、Bucket4j、ONNX、Shadow、评测和 Fugu 适配器。 - 状态与观测层:状态可以落在本地内存/Caffeine,也可以落到 Redis;事件通过 Listener 暴露,Spring 再接入 Micrometer、Observation 和 Actuator。
- 基础设施层:TLS、WAF、外部负载均衡、密钥管理、Redis 高可用和容器编排交给部署环境负责。
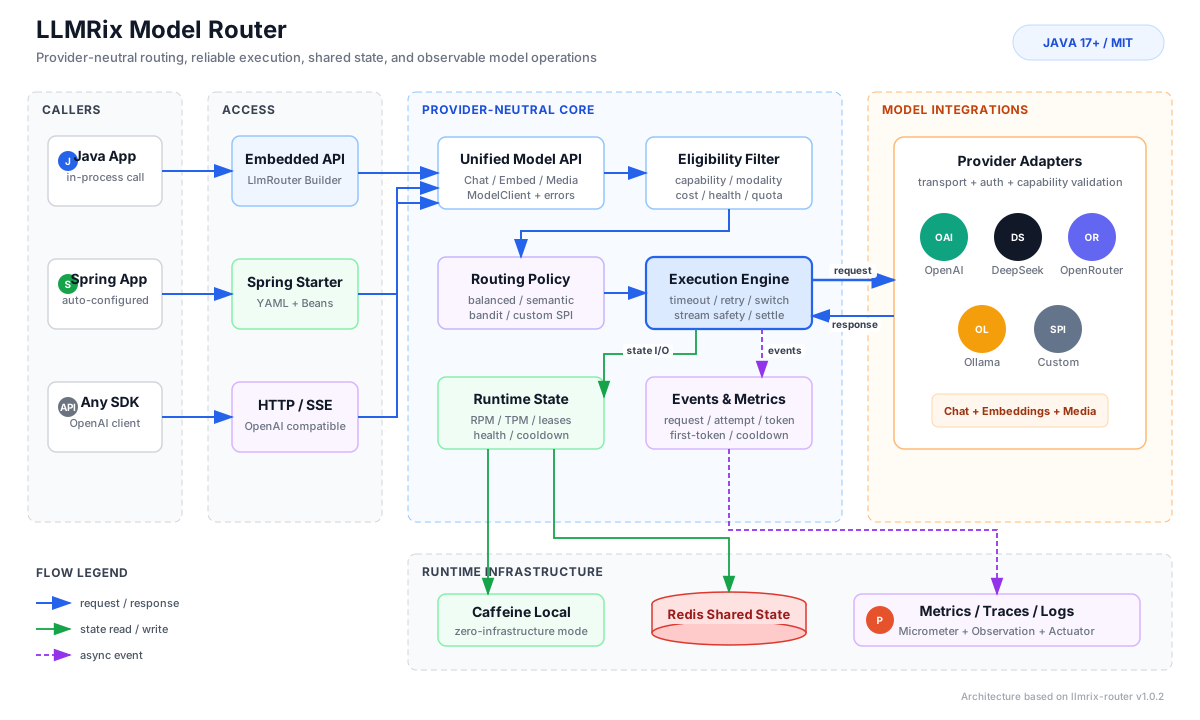
中间的 Router Core 是决策和执行的交界处。它不绑定某一家供应商,也不把业务请求改写成供应商私有对象,而是用统一的 ModelClient 和 ModelTarget 管理候选。新增供应商时,改动主要集中在 Provider SPI 和 Transport 适配器,不会扩散到路由策略或业务代码。
1.1 生产模块与职责
| Maven Artifact | 职责 | 典型使用方式 |
|---|---|---|
llmrix-model-open |
公共模型契约、通用异常、认证 SPI、OpenAI 兼容传输与适配器 | 开发客户端或自定义集成时复用统一类型 |
llmrix-model-router-core |
Router Builder、模型目标、策略、执行器、状态 SPI、配额、健康与事件 | 在普通 Java 应用中嵌入 Router |
llmrix-model-router-integrations |
内置供应商、Redis、Bucket4j、ONNX、Shadow、评测与 Fugu | 使用官方集成或高级路由能力 |
llmrix-model-router-spring-starter |
自动配置、YAML 属性、HTTP/SSE、认证、Actuator 与 Micrometer | 构建 Spring Boot 路由服务 |
llmrix-model-orion |
无框架依赖的远程 Java 客户端 | 从 Java 服务调用独立 Router |
llmrix-model-orion-spring-starter |
Orion 自动配置与 Micrometer 适配 | 在 Spring Boot 业务服务中注入远程模型客户端 |
这样的模块边界方便按需引入依赖。远程业务服务可以只依赖 Orion 和公共模型契约,不必把 Redis、ONNX 或整套 Router Runtime 一起带进来。
1.2 一次请求的决策时序
下面的时序图按源码的执行顺序绘制,包含能力匹配、配额控制和故障切换。图中分开标出了成功返回、首个可见输出前重试,以及流式输出开始后不再重放三条路径:
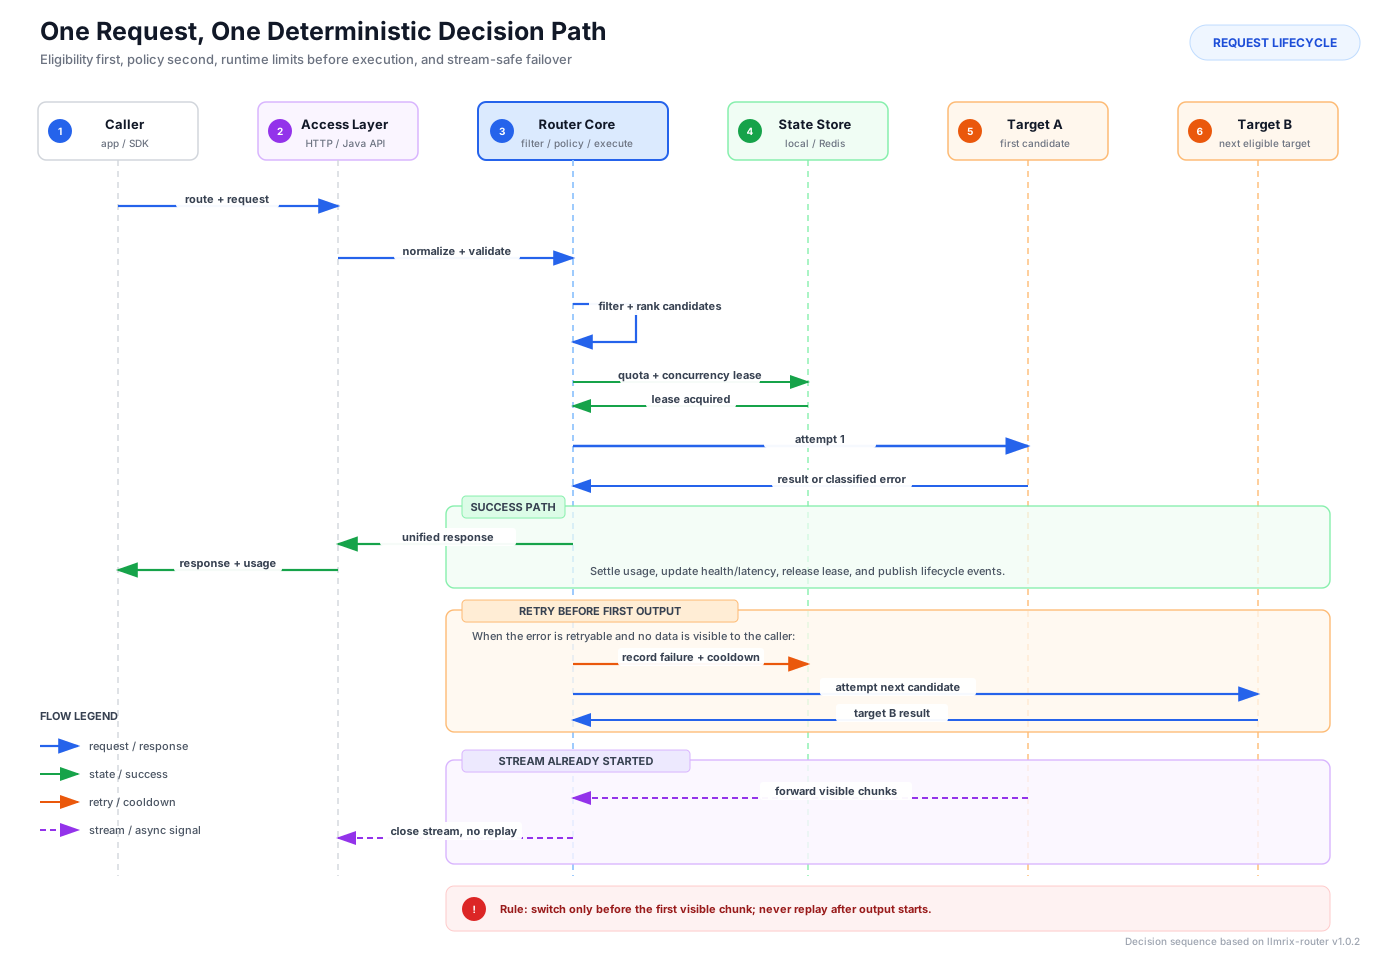
“适不适合这次请求”和“这次调用能否完成”由两部分处理:候选快照与策略负责前者,执行器、状态存储和异常分类负责后者。
2. 功能矩阵:模型选择与运行治理
| 能力域 | 具体能力 | 能解决的问题 |
|---|---|---|
| 模型抽象 | Provider-neutral ModelClient、多模态请求/响应、统一异常 |
业务代码不再绑定供应商 SDK |
| 能力匹配 | operations、features、input-modalities、traits |
避免把工具、图片、音频请求发给不支持的模型 |
| 路由策略 | priority、round-robin、weighted random、least-busy、latency-aware、cost-aware、balanced、cache-aware | 按业务目标在稳定性、成本、延迟和缓存命中之间取舍 |
| 动态决策 | semantic scoring、contextual bandit、可自定义 RoutingStrategy |
用请求语义或反馈数据持续改进选型 |
| 可靠性 | 每次尝试超时、总预算、重试谓词、失败阈值、目标冷却、候选池继续执行 | 应对限流、超时、临时故障和局部不可用 |
| 流式安全 | 首 token 超时、流空闲超时、首块前切换、取消传播、工具请求避免盲目重放 | 防止重复输出和有副作用的工具调用被重放 |
| 成本治理 | 输入/输出/缓存/推理 token 定价、请求 maxCostUsd、路由 RPM/TPM |
让成本约束进入请求决策,而不是事后统计 |
| 配额与并发 | 目标级限制、路由级限制、认证配额分区、本地 Caffeine、Redis 原子租约 | 控制单模型、单路由和单租户的资源使用 |
| 多模态 | Chat、Responses 核心子集、Embeddings、Rerank、Audio、Image、Video | 统一处理文本、图像、音频、文件和视频工作流 |
| 评测与编排 | Online Shadow、离线 Evaluation、Fugu Worker/Thinker/Verifier、ONNX 策略 | 在不影响主流量的情况下比较模型并组织多轮协作 |
| 可观测性 | Router/Fugu Listener、Micrometer、Observation、Actuator、request ID | 解释“选了谁、耗时多少、为何重试、花了多少” |
| 扩展性 | ModelProvider、ProviderAuthenticator、ModelPricingResolver、RouterStateStore |
接入企业代理、签名认证、内部价格目录和自有状态系统 |
2.1 模型声明为什么要分成四类
LLMRix 没有把“模型能力”简化成一个布尔值,而是要求配置分别声明:
operations:它能执行什么操作,例如chat、embeddings、rerank、video-generation;features:它支持什么协议特性,例如streaming、tools、structured-output、prompt-cache;input-modalities:它能接收什么输入,例如vision、video、audio、file;traits:它更擅长什么类型的任务,例如code、reasoning、long-context。
四类声明彼此独立。应用启动时先校验,收到请求后再按声明筛选。相比维护一份“万能模型列表”,这种方式更容易审计,也能减少生产环境中的能力错配。
3. 从“调用模型”改为“调用路由”
LLMRix 让应用依赖稳定的路由名,而不是上游模型名。
例如,业务只请求 general、code 或 reasoning。至于这次请求最终交给 OpenAI、DeepSeek、OpenRouter 还是本地 Ollama,由路由器根据能力、健康状态、延迟、成本和策略决定。
模型调整因此落在路由配置中,而不是业务代码里。新增供应商、替换模型或改变选型策略时,上层应用通常不需要重写。
LLMRix 提供三种接入方式:
- 作为嵌入式 Java SDK,直接放进现有应用进程;
- 作为 Spring Boot Starter,通过配置完成自动装配;
- 作为独立的 OpenAI 兼容服务,对其他语言和已有工具提供统一 HTTP 接口。
Java 服务需要远程调用 Router 时,可以使用项目自带的轻量客户端 Orion。供应商密钥只保留在 Router 端,客户端只接触路由名和统一协议。
4. 一次请求如何被处理
LLMRix 处理的不是一张模型清单,而是一条有明确边界的执行流水线。
收到请求后,Router 先检查操作类型、工具调用、结构化输出、输入模态、上下文长度和调用方传入的路由约束。无法满足条件的模型会在执行前排除。带图片的对话不会发送给只支持文本的模型;请求要求 reasoning 或 code 特征时,未声明这些特征的候选也不会进入选择阶段。
剩余候选再交给路由策略排序。项目内置优先级、轮询、加权随机、最空闲、延迟优先、成本优先、平衡评分和 Prompt Cache 亲和等策略,也提供语义路由与上下文多臂老虎机实现。团队还可以实现 RoutingStrategy,把数据地域、租户等级、合规标签或内部模型评分纳入选择规则。
开始调用前,Router 会申请配额和并发租约,并检查单次请求的成本预算。调用成功后,它按实际 token 用量结算成本、释放租约并发布生命周期事件。调用失败时,Router 根据异常类型判断是否重试、是否让目标进入冷却,以及是否继续尝试候选池中的下一个目标。
因此,“选谁”和“怎么调用”是两层职责:策略负责排序,执行器负责超时、重试、配额、健康和资源释放。选型算法可以替换,执行规则仍然保持一致。
5. 流式输出:首块之后不再重放
普通请求的故障切换相对直接,流式响应则不同。
假设模型 A 已经向用户输出了半句话,连接此时中断。若系统切到模型 B 并从头重放,用户会看到重复内容,工具调用也可能被执行两次。
LLMRix 的规则是:第一个数据块对调用方可见之前,可以切换候选;输出开始后,不再重放请求。Router 分别管理首 token 超时和流空闲超时,并把取消信号传给仍在运行的上游请求。
这项规则直接关系到调用方看到的内容是否一致。它把流式响应的边界写进了执行器,而不是留给业务代码自行处理。
6. 从 Chat 到多模态模型接口
截至 1.0.2,LLMRix 支持 Chat、Responses API 核心子集、Embeddings、Rerank、音频、图片和视频操作,Spring Boot Starter 也提供对应的 OpenAI 风格端点。Chat 和 Responses 端点都支持 JSON 与 SSE 流式响应。
内置集成包括 OpenAI、DeepSeek、OpenRouter 和 Ollama。各供应商支持的操作并不完全相同,Router 会读取每个目标的 operations、features、input-modalities 和 traits,不会把“OpenAI 兼容接口”当成能力完全相同的服务。
显式声明能力有两个实际作用。配置错误可以在启动阶段暴露,路由策略也能在请求发往上游之前完成筛选。
6.1 内置供应商能力范围
| 集成 | 已实现的主要操作 | 适合的场景 |
|---|---|---|
| OpenAI | Chat、Embeddings、Audio、Images、Videos | 使用 OpenAI 原生多模态接口 |
| DeepSeek | Chat | 通用对话、代码与推理路由 |
| OpenRouter | Chat、Embeddings、Rerank | 通过统一上游访问多家模型及免费模型 |
| Ollama | Chat、Embeddings | 本地开发、离线环境和私有模型 |
| 自定义 Provider | 由 ModelProvider 实现决定 |
企业模型平台、内部代理、专有协议 |
“集成支持”不代表该供应商下的所有模型都支持同一操作。最终能力取决于具体模型、供应商账号和配置声明。例如,某个 OpenRouter 模型可能支持文本对话,却不接受图片输入。Router 只按目标声明筛选,不会替模型补出未声明的能力。
6.2 OpenAI 兼容端点
| Endpoint | 用途 |
|---|---|
POST /v1/chat/completions |
同步或 SSE 流式对话 |
POST /v1/responses |
Responses API 核心子集,支持 JSON 和 SSE |
POST /v1/embeddings |
文本或 token 数组向量化 |
POST /v1/rerank |
Query 与文档重排序 |
POST /v1/audio/transcriptions |
音频转写 |
POST /v1/audio/translations |
音频翻译 |
POST /v1/audio/speech |
文本转语音 |
POST /v1/images/generations |
图片生成 |
POST /v1/images/edits |
Multipart 图片编辑 |
POST /v1/videos |
创建视频生成任务 |
GET /v1/videos/{video_id} |
查询视频任务状态 |
GET /v1/videos/{video_id}/content |
下载已完成的视频 |
DELETE /v1/videos/{video_id} |
删除视频任务 |
POST /v1/videos/{video_id}/remix |
基于已有视频创建 Remix 任务 |
GET /v1/models |
获取可调用的路由标识 |
7. 单机使用本地状态,多实例共享运行状态
开发和小规模部署可以直接使用内存状态,不需要额外基础设施。本地配额分区由 Caffeine 管理,并设置容量和空闲期限,避免动态租户键无限增长。
Router 扩展为多个实例时,可以切换到 Redis。健康状态、并发租约、RPM、TPM 和多臂老虎机状态都能跨实例共享,更新通过 Redis 原子操作完成。Redis 模式采用 fail-closed:配置错误或存储不可用时,系统不会静默退回 JVM 本地状态,避免出现“看起来有限流,实际每台机器各算一份”的情况。
本地模式适合试用和小规模服务,Redis 模式用于水平扩展时的共享约束。
7.1 推荐的生产部署拓扑
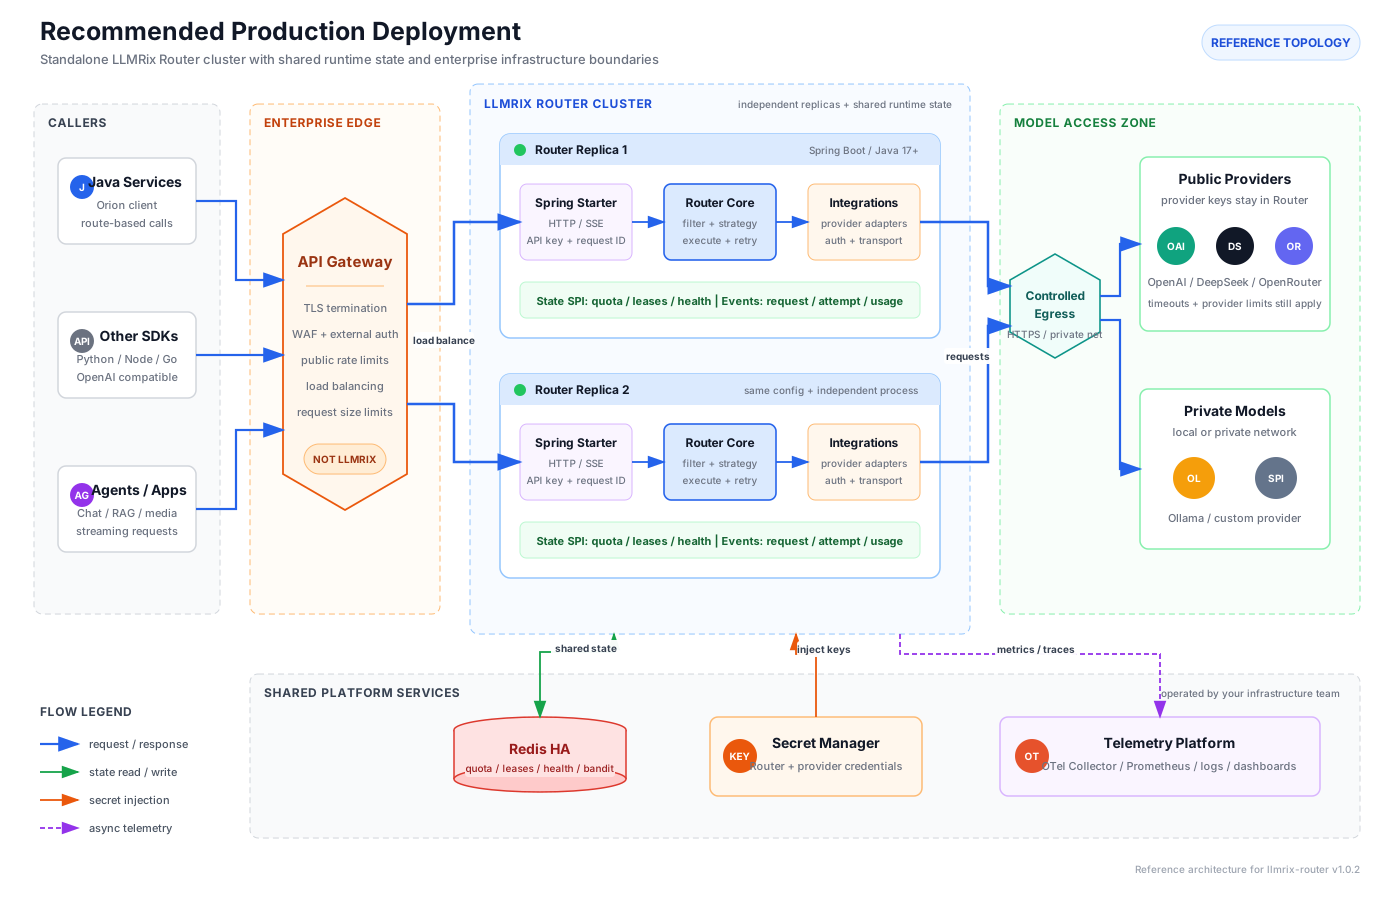
这张生产部署图沿用前面的模块边界,并补上运行环境中的外部组件:
- 调用方层:Java 服务可以使用 Orion,其他语言和 Agent 使用 OpenAI 兼容 HTTP/SSE。调用方只传路由名和业务约束,不持有供应商密钥。
- 企业入口层:API Gateway 负责 TLS、WAF、外部身份认证、公网限流、请求体限制和实例负载均衡。这一层不属于 LLMRix。
- Router 集群层:每个副本包含 Spring Starter/HTTP 接入、Router Core 决策执行和 Integrations 供应商适配,对应架构纵览中的接入层、核心层和集成层。副本使用相同路由配置,但运行在独立进程中。
- 共享状态层:Redis HA 保存跨副本的 RPM/TPM、并发租约、健康冷却和 Bandit 状态。Redis 模式 fail-closed,不会在共享状态不可用时静默退回本地限流。
- 模型访问层:Router 通过受控公网出口访问 OpenAI、DeepSeek、OpenRouter,通过私网访问 Ollama 或自定义 Provider。上游超时、配额和账号限制仍然有效。
- 平台服务层:Secret Manager 向 Router 注入 API Key 和供应商凭据;Router 的指标、Trace 和日志流向企业观测平台。LLMRix 产生事件和指标,不负责部署这些平台。
主链路是“调用方 → 企业网关 → Router 副本 → Provider Adapter → 模型服务”,响应沿同一连接返回。绿色链路表示 Router 与 Redis 的状态读写,橙色链路表示密钥注入,紫色虚线表示异步遥测。这三类链路都不进入模型响应正文。
小规模系统可以省略网关和 Redis,把 Router 嵌入业务服务或运行单个实例。Router 水平扩展后,应使用共享 Redis 状态,并把入口安全和公网流量治理交给网关。Router 的 API Key 认证负责 Client-to-Router 边界,供应商密钥只保留在 Router 部署环境或密钥管理系统中。
8. 可观测性从请求开始记录
模型路由缺少解释信息,线上排障会很慢。至少要能查到请求选中了谁、为什么重试、哪个候选进入冷却、首 token 等了多久,以及成本花在哪里。
LLMRix 在核心层定义请求开始、路由选择、尝试开始与结束、首 token、用量记录、目标冷却和请求完成等生命周期事件。Spring 集成接入 Micrometer、Observation 和 Actuator 后,可以输出请求量、耗时、尝试次数、首 token 延迟、候选可用性、在途请求和 token 用量等指标。
项目不负责部署 Prometheus、Grafana 或 OpenTelemetry Collector,但提供了稳定的观测边界。已有监控体系的 Java 团队可以直接接入,不必再维护一套专用控制台。
9. 让模型选择利用反馈
在常规路由之外,LLMRix 还提供几项用于评测和反馈的能力。
语义路由根据请求内容给候选评分。上下文多臂老虎机结合选择次数与奖励反馈,在使用当前优选模型和探索其他模型之间调整权重。
Online Shadow 按采样率把无副作用请求发送给影子模型,不影响主请求结果。离线评测组件则汇总多个模型在样本集上的质量、延迟和失败情况。
Fugu 编排支持 Worker、Thinker、Verifier 等角色在限定轮次、token 预算和成本预算内迭代。生成、反思和验证都有停止条件、重试与回退机制。运行时可以加载 ONNX 策略,但训练和策略发布仍由离线系统完成。
这些能力不是所有团队的起点。它们表明 LLMRix 除了静态负载均衡,也为可评估、可学习的模型决策预留了接口。
10. 快速接入
项目要求 Java 17 或更高版本,推荐 Java 21。核心制品已经发布到 Maven Central,并采用 MIT License。
不使用 Spring 时,引入 Core 和 Integrations 即可:
<dependency>
  <groupId>com.llmrix.model</groupId>
  <artifactId>llmrix-model-router-core</artifactId>
  <version>1.0.2</version>
</dependency>
<dependency>
  <groupId>com.llmrix.model</groupId>
  <artifactId>llmrix-model-router-integrations</artifactId>
  <version>1.0.2</version>
</dependency>
<button class="v-md-copy-code-btn" type="button">
  <i>
    <svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
      <path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
    </svg>
  </i>
</button><!--beforeend--></div><!--afterend--></div><p>接着把模型注册到路由池:</p>
try (LlmRouter router = LlmRouter.builder()
        .integration("openai", provider -> provider
            .apiKey(System.getenv("OPENAI_API_KEY"))
            .model("gpt-4.1-mini", model -> model
                .operations(ModelOperation.CHAT)
                .features(ModelFeature.TOOLS)))
        .integration("deepseek", provider -> provider
            .apiKey(System.getenv("DEEPSEEK_API_KEY"))
            .model("deepseek-chat", model -> model
                .operations(ModelOperation.CHAT)
                .features(ModelFeature.TOOLS)
                .traits(ModelTrait.CODE)))
        .route("general", route -> route
            .strategy("balanced")
            .quota(600L, 100_000L)
            .models("openai/gpt-4.1-mini", "deepseek/deepseek-chat"))
        .build()) {
    ChatResponse response = router.chat("Review this Java code");
}
<button class="v-md-copy-code-btn" type="button">
  <i>
    <svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
      <path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
    </svg>
  </i>
</button><!--beforeend--></div><!--afterend--></div><p>使用 Spring Boot 的团队可以改用 Starter 和 YAML 配置。非 Java 调用方可以启用 OpenAI 兼容 HTTP API,将现有 SDK 的 <code>base_url</code> 指向 Router。请求中的 <code>model</code> 填路由名,不填供应商的真实模型 ID。</p>
11. 配置与调用示例
11.1 示例一:Spring Boot 配置多条业务路由
在 Spring Boot 服务中,路由可以完全由 YAML 管理。下面把普通对话、代码分析、向量检索和重排序拆成四条路由,并为普通对话设置共享 RPM/TPM 配额:
llmrix:
  model:
    router:
      enabled: true
      default-route: general
      routes:
        general:
          strategy: balanced
          quota:
            requests-per-minute: 600
            tokens-per-minute: 100000
          models:
            - integration: openai
              model: gpt-4.1-mini
            - integration: deepseek
              model: deepseek-chat
        code:
          strategy: cost-aware
          models:
            - integration: deepseek
              model: deepseek-chat
            - integration: openrouter
              model: cohere/north-mini-code:free
        embeddings:
          strategy: latency-aware
          models:
            - integration: openai
              model: text-embedding-3-small
            - integration: openrouter
              model: nvidia/nemotron-3-embed-1b:free
        rerank:
          strategy: priority
          models:
            - integration: openrouter
              model: nvidia/llama-nemotron-rerank-vl-1b-v2:free
      execution:
        timeout: 30s
        max-retries: 1
      http:
        enabled: true
        auth:
          mode: api-key
          bootstrap-key: ${LLMRIX_MODEL_ROUTER_API_KEY}
      integrations:
        openai:
          provider: openai
          api-key: ${OPENAI_API_KEY}
          models:
            - name: gpt-4.1-mini
              operations: [chat]
              features: [streaming, tools]
            - name: text-embedding-3-small
              operations: [embeddings]
        deepseek:
          provider: deepseek
          api-key: ${DEEPSEEK_API_KEY}
          models:
            - name: deepseek-chat
              operations: [chat]
              features: [streaming, tools]
              traits: [code]
        openrouter:
          provider: openrouter
          api-key: ${OPENROUTER_API_KEY}
          models:
            - name: cohere/north-mini-code:free
              operations: [chat]
              traits: [code]
            - name: nvidia/nemotron-3-embed-1b:free
              operations: [embeddings]
            - name: nvidia/llama-nemotron-rerank-vl-1b-v2:free
              operations: [rerank]
<button class="v-md-copy-code-btn" type="button">
  <i>
    <svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
      <path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
    </svg>
  </i>
</button><!--beforeend--></div><!--afterend--></div><p>路由中的 <code>models</code> 是完整候选池。系统在池内选择目标,失败后继续尝试,不需要另外维护容易失真的 <code>fallbacks</code> 列表。供应商的 <code>base-url</code> 可以指向官方端点、企业代理或私有网关。</p>
11.2 示例二:用路由提示表达业务约束
路由名表达稳定的业务意图,RoutingHints 表达单次请求的临时约束。例如,下面的代码审查请求要求模型具备代码特征,同时把成本限制在 5 美分以内:
ChatRequest request = ChatRequest.builder()
    .userMessage("Find the race condition in this Java code")
    .routingHints(RoutingHints.builder()
        .require(ModelTrait.CODE)
        .maxCostUsd(0.05)
        .maxLatency(Duration.ofSeconds(8))
        .attribute("tenant", "acme")
        .build())
    .build();


ChatResponse response = router.chatRoute("code").chat(request); ChatResponse response = router.chatRoute("code").chat(request);
<button class="v-md-copy-code-btn" type="button">
  <i>
    <svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
      <path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
    </svg>
  </i>
</button><!--beforeend--></div><!--afterend--></div><p>提示可以要求特定操作、工具或输入模态,可以允许或拒绝指定目标,也能设置最大成本、最大延迟并传递租户或业务标签。认证请求还可通过 <code>RoutingHints.AUTH_QUOTA_KEY</code> 为不同调用方分配独立配额分区。</p>
11.3 示例三:通过 OpenAI 兼容 HTTP API 接入现有应用
启用 Spring Starter 的 HTTP 端点后,Python、Node.js、Go 或已有 OpenAI SDK 不需要了解 Router 的内部实现。把 base_url 指向 Router,再把模型字段改成路由名即可:
export BASE_URL=http://127.0.0.1:8080
export API_KEY=your-llmrix-http-key
curl --no-buffer "BASE_URL</span>/v1/chat/completions"</span> <span class="token punctuation">\</span><span class="token punctuation">\</span> <span class="token parameter variable">-H</span> <span class="token string">"Authorization: Bearer <span class="token variable">API_KEY" </span></span> -H "Content-Type: application/json" </span></span> -d '{
"model": "code",
"messages": [{"role": "user", "content": "Review this pull request"}],
"stream": true,
"temperature": 0
}' curl --no-buffer "API_KEY" </span></span> -H "Content-Type: application/json" </span></span> -d '{
"model": "code",
"messages": [{"role": "user", "content": "Review this pull request"}],
"stream": true,
"temperature": 0
}'
<button class="v-md-copy-code-btn" type="button">
  <i>
    <svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
      <path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
    </svg>
  </i>
</button><!--beforeend--></div><!--afterend--></div><p>HTTP 层除了 Chat Completions,还提供 Responses 核心子集、Embeddings、Rerank、音频转写与翻译、语音合成、图片生成与编辑、视频任务和 Models 目录。控制器级错误使用 OpenAI 风格结构,包含 <code>error.message</code>、<code>error.type</code>、<code>error.code</code> 和 <code>error.param</code>。在进入控制器前被拒绝的认证请求可能返回更精简的错误体。调用方应按 HTTP 状态和错误类型处理,不要匹配完整错误文本。</p>
11.4 示例四:Orion 客户端调用远程 Router
模型密钥需要集中保管,或业务服务需要与 Router 独立扩缩容时,可以使用 Orion:
OrionModelClient client = OrionModelClient.builder()
    .baseUrl("https://router.example.com/v1")
    .apiKey(System.getenv("LLMRIX_API_KEY"))
    .defaultModel("general")
    .defaultEmbeddingModel("embeddings")
    .defaultRerankModel("rerank")
    .build();


ChatResponse answer = client.chat(ChatRequest.user("Summarize this incident"));
EmbeddingResponse vector = client.embed(EmbeddingRequest.text("Text to index"));
RerankResponse ranked = client.rerank(new RerankRequest(
"refund policy", List.of("Support contact", "Refunds within 30 days"))); ChatResponse answer = client.chat(ChatRequest.user("Summarize this incident"));
EmbeddingResponse vector = client.embed(EmbeddingRequest.text("Text to index"));
RerankResponse ranked = client.rerank(new RerankRequest(
"refund policy", List.of("Support contact", "Refunds within 30 days")));
<button class="v-md-copy-code-btn" type="button">
<i>
<svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
<path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
</svg>
</i>
</button><!--beforeend--></div><!--afterend--></div><p>Orion 支持按请求添加 request ID 和受控的自定义 Header,也支持异步 <code>CompletionStage</code>、<code>Flow.Publisher<ChatChunk></code> 流式调用,以及音频、图片和视频等类型化模型。远程错误和上游 HTTP 状态会映射为客户端异常,业务侧可以统一处理。</p>
11.5 示例五:多模态请求与能力筛选
多模态请求不需要调用方手工挑选供应商。Router 根据目标声明的输入模态排除不支持的候选:
ChatRequest multimodal = ChatRequest.builder()
    .message(Message.user(
        new TextPart("Compare this diagram with the attached report."),
        new ImagePart("https://example.com/diagram.png", "high"),
        new FilePart("https://example.com/report.pdf", "report.pdf")))
    .build();


ChatResponse analysis = client.chatModel("multimodal").chat(multimodal); ChatResponse analysis = client.chatModel("multimodal").chat(multimodal);
<button class="v-md-copy-code-btn" type="button">
  <i>
    <svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
      <path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
    </svg>
  </i>
</button><!--beforeend--></div><!--afterend--></div><p>对应的模型配置需要声明 <code>input-modalities: [vision, file]</code>,音频和视频输入同理。这样,“模型支持情况”会成为可校验配置,不再依赖隐含约定,也能减少请求到达上游后才暴露的能力错误。</p>
11.6 示例六:把路由解释、指标和成本接入运维系统
排查请求时,可以先查看路由候选和排除原因,再通过 Listener 或 Micrometer 获取运行指标:
RouteExplanation explanation = router.chatRoute("code")
    .explain(ChatRequest.user("Find the race condition"));


System.out.println("selected=" + explanation.selectedTarget());
System.out.println("eligible=" + explanation.eligibleTargets());
System.out.println("excluded=" + explanation.excludedTargets()); System.out.println("selected=" + explanation.selectedTarget());
System.out.println("eligible=" + explanation.eligibleTargets());
System.out.println("excluded=" + explanation.excludedTargets());
<button class="v-md-copy-code-btn" type="button">
  <i>
    <svg viewBox="64 64 896 896" focusable="false" data-icon="copy" width="1em" height="1em" fill="currentColor" aria-hidden="true">
      <path d="M832 64H296c-4.4 0-8 3.6-8 8v56c0 4.4 3.6 8 8 8h496v688c0 4.4 3.6 8 8 8h56c4.4 0 8-3.6 8-8V96c0-17.7-14.3-32-32-32zM704 192H192c-17.7 0-32 14.3-32 32v530.7c0 8.5 3.4 16.6 9.4 22.6l173.3 173.3c2.2 2.2 4.7 4 7.4 5.5v1.9h4.2c3.5 1.3 7.2 2 11 2H704c17.7 0 32-14.3 32-32V224c0-17.7-14.3-32-32-32zM350 856.2L263.9 770H350v86.2zM664 888H414V746c0-22.1-17.9-40-40-40H232V264h432v624z"></path>
    </svg>
  </i>
</button><!--beforeend--></div><!--afterend--></div><p>Spring Boot 中的常用指标包括 <code>llm.router.requests</code>、<code>llm.router.attempts</code>、<code>llm.router.request.duration</code>、<code>llm.router.first.token</code>、<code>llm.router.cooldowns</code>、候选可用性和在途请求数量。用量事件分别记录输入、输出、缓存输入、缓存写入和推理 token,可用于按路由、供应商和租户汇总成本。</p>
11.7 示例七:用 Shadow 和 Fugu 做渐进式质量升级
替换模型时不必一次切换全部流量。Online Shadow 按采样率异步调用影子模型,主请求仍由当前生产路由返回。评测组件记录响应质量、延迟、失败和成本,团队可以根据在线对比数据决定是否调整策略。
需要多轮生成、思考和验证时,可以把多个 ChatModel 组合成 Fugu 编排:
- Worker 负责生成初始答案;
- Thinker 提供改进建议;
- Verifier 检查是否满足接受条件;
maxTurns、token budget、成本预算和超时共同限制最坏情况;- 候选失败时依据策略重试、冷却并回退到备用模型。
这些限制为多轮 AI 工作流划定资源边界,也避免把整套编排逻辑写成一段难以观测的业务代码。
12. 典型落地场景
| 场景 | 推荐路由设计 | 重点能力 |
|---|---|---|
| 智能客服 | general、reasoning、translation 分路由 |
稳定优先、租户配额、故障切换、用量统计 |
| 代码助手 | code-fast 与 code-deep 分层 |
代码特征、成本预算、工具调用、长上下文 |
| 企业 RAG | embeddings、rerank、answer 串联 |
向量化、重排序、结构化输出、链路观测 |
| 多模态审核 | vision、audio、video 按操作拆分 |
输入模态筛选、文件安全、二进制响应 |
| 模型迁移评估 | 主路由外挂 Online Shadow | 采样、隔离超时、质量评分、A/B 报告 |
| 混合云与本地模型 | 公有模型与 Ollama/私有 Provider 组成候选池 | 数据边界、自定义认证、健康与延迟策略 |
| 多 Agent 工作流 | Fugu 或自定义 Router 组织角色 | 多轮预算、停止条件、验证、回退与事件流 |
13. 建议的上线顺序
- 先选一条非核心 Chat 路由,接入两个上游模型,统一请求、响应和异常类型。
- 再补齐每个目标的 operations、features、modalities、traits、上下文窗口、定价和并发限制。
- 接入 request ID、Micrometer/Observation,以及首 token 延迟、重试、冷却、用量和成本看板。
- 用 Shadow 收集对比数据后,再逐步启用 cost-aware、semantic 或 contextual bandit。没有数据之前,先用简单策略。
13.1 上线检查清单
- 供应商密钥来自环境变量或专用 Secret Manager,不进入 Git、YAML 模板和日志;
- 对外服务部署在 TLS、WAF、网关认证和外部流量限制之后;
- 多实例使用 Redis 共享配额、并发租约和健康状态,并为 Redis 配置高可用;
- 为每个模型显式填写实际能力、上下文窗口、定价、RPM、TPM 和最大并发;
- 路由按业务意图命名,不把供应商或具体版本暴露给业务调用方;
- 请求总超时、首 token 超时和流空闲超时均按真实链路延迟设置;
- 重试次数保持有界,区分可重试异常与参数、权限、内容安全等不可重试错误;
- Prompt 观测默认关闭;确需采集时限定路由、长度并配置脱敏器;
- Shadow 仅用于无副作用请求,工具调用请求默认不进入影子流量;
- 为 429、503、首 token 延迟、冷却次数、候选可用性和成本异常设置告警;
- 升级前阅读
CHANGELOG.md,并在预发环境执行 HTTP/SSE 与多模态回归测试。
14. 适用团队与产品边界
出现以下情况时,LLMRix 比直接维护多套供应商 SDK 更合适:
- Java 或 Spring Boot 是主力技术栈;
- 已经接入两个以上模型供应商;
- 需要按能力、成本、延迟或租户策略选择模型;
- 对限流、故障切换、流式正确性和可观测性有生产要求;
- 希望在进程内 SDK 与独立路由服务之间自由选择部署形态。
LLMRix 也有明确边界。它不是模型托管平台、训练平台、密钥管理系统或完整的 API Gateway。TLS、WAF、外部负载均衡、Redis 高可用、密钥托管和容器编排仍由相应基础设施负责。需要完整网关能力时,可以把它部署在 Nginx、APISIX、Higress 或云负载均衡之后。
项目目前还很年轻。仓库创建于 2026 年 7 月,社区规模有限,暂时没有管理控制台、官方容器镜像或 Kubernetes Helm Chart。内置供应商也不算多。复杂企业环境通常需要通过 SPI 接入内部代理、认证和定价系统。
不过,仓库不只包含概念说明。当前代码有 6 个可发布制品和 43 个测试类。笔者在 2026 年 9 月 3 日基于主分支,使用 Java 21 执行完整的 mvn test:共运行 199 项测试,0 失败、0 错误、0 跳过。测试覆盖核心路由、配额与健康状态、协议映射、SSE、多模态控制器、Spring 自动配置、服务启动和 Orion 客户端等路径。这些结果能说明代码具备基本的工程完整性,但不能代替生产案例或性能基准。
15. 结语
AI 应用刚起步时,直接调用一个模型通常最快。模型数量增加、流量上升或业务变得重要之后,模型选择才需要成为独立的基础设施能力。
LLMRix Router 提供的是一条稳定的模型边界。上层应用表达需要什么;Router 判断哪些模型能处理、该选哪个、失败后如何继续,并记录调用成本。
如果代码里已经散落着多套供应商 SDK、重试循环和模型名称,可以先拿一条非核心路由验证。统一接口后,再接入健康、成本和配额策略;等 Shadow 与评测积累了数据,再调整选型方式。
延伸阅读:服务端部署 · Orion 客户端 · HTTP API · Maven Central
开源协议:MIT
当前版本:1.0.2
运行要求:Java 17+,推荐 Java 21;Spring Boot 3.x 可选