先交代一下背景。我做了 12 年 Java 后端,主要做支付中台和高并发系统,每天跟 Spring Cloud、MySQL、Redis、K8s 打交道。今年决定做点不一样的事:一个人从 0 到 1 做一款手机 App。不指望一夜暴富,就是想验证「一个人 + 端侧 AI」能不能做出一个真正好用的音频工具。
1个月后,TS Video to MP3 上架了 App Store,Android 版同步开发中。这篇文章记录整个过程中的技术选型和踩坑,希望对同样想做端侧 AI 应用的独立开发者有帮助。
前阵子做了一款端侧 AI 音频 App,把过程中的技术决策和踩坑整理成文。先说结论:移动端跑人声分离模型完全可行,但工程细节远比想象多,尤其是模型参数与推理后端的匹配。下文按「选型 → 架构 → 踩坑」展开。
产品是什么
TS Video to MP3 是一个音频工具包,核心功能:
-
视频转 MP3:支持 MP3 / M4A / WAV / FLAC / OGG / AAC / OPUS 七种格式互转
-
AI 人声分离:提取伴奏 / 去人声,约 3 秒出结果,带卡拉 OK 模式(可保留少量引导人声)
-
铃声制作:一键生成 iPhone 的 m4r 格式
-
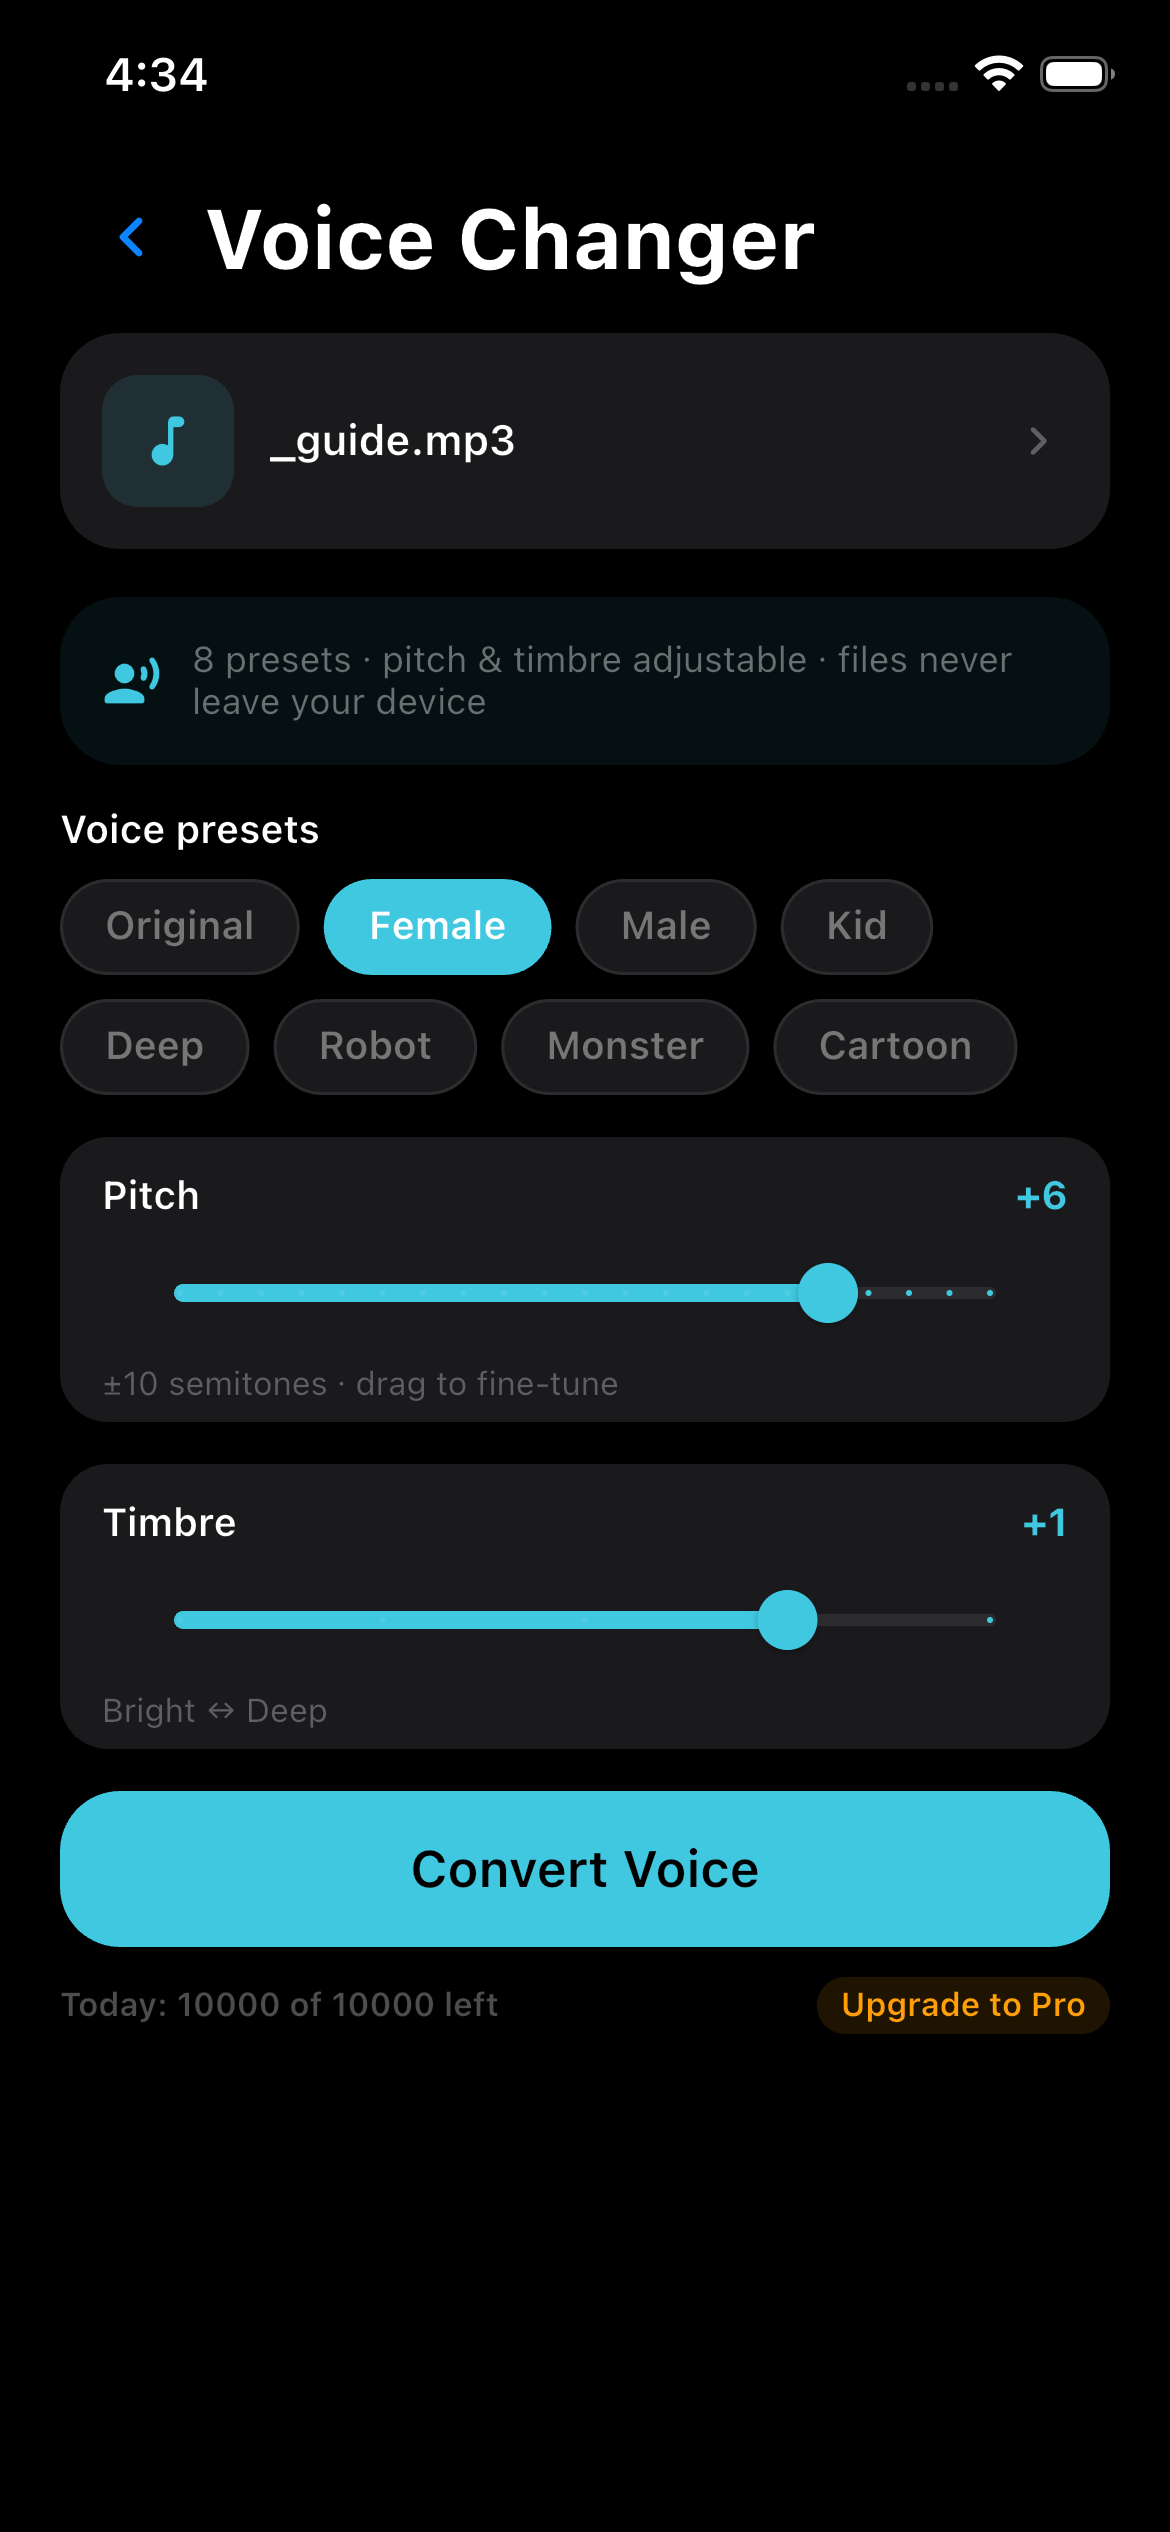
裁剪拼接、RNNoise 智能降噪、10 段均衡器、变声器
-
效果链:把「降噪 → EQ → 增益」存成工作流,批量转换一键复用
所有处理都在手机本地完成,文件不出设备,不联网也能用。
核心决策:为什么坚持端侧
做音频处理 App,第一反应是接云端 AI:上传文件 → GPU 推理 → 下载结果。但作为一个没有融资的个人开发者,我算了一笔账:
- 服务器成本:云端 GPU 推理按量收费,个人开发者扛不住;自建 GPU 服务器更不现实。
- 排队体验:云端方案普遍要排队,一首歌传上去等半天,体验很差。
- 隐私:音频是私密数据,「文件不出手机」是天然的信任加分项,也是和竞品最直观的差异。
结论:全部本地推理。剩下唯一的问题——手机芯片到底跑不跑得动人声分离?
技术选型
人声分离模型:Demucs vs Spleeter
-
Demucs(Meta 出品)音质最好,但模型大、手机端推理太慢,交互式使用不现实。
-
Spleeter(Deezer 开源)久经考验,2stems 在卡拉 OK / 粗分轨场景质量够用,两个 ONNX 文件各约 37MB,可以直接打进 App 安装包。
我选了 Spleeter 2stems(人声 / 伴奏两分轨)。没上 4stems——移动端算力预算下不划算。
推理运行时:ONNX Runtime vs TFLite vs Core ML
-
TensorFlow Lite 转 Spleeter 计算图很痛苦,自定义算子多。
-
Core ML 绑死 Apple 生态,Android 要另搞一套。
-
ONNX Runtime:一套模型双端复用(iOS / Android),有移动端优化和量化支持,同一个 .onnx 文件桌面端手机端都能跑,调试效率高。
最终选 ONNX Runtime。
模型精度:int8 → fp16 → fp32 的回归
量化是典型的坑。int8 量化后体积减半,但分离质量明显劣化——人声残留、高频伪影,而且这类劣化很难用指标评估,只能一条条歌试听对比。试了几轮后我放弃量化,直接用 fp32 原始训练精度:两个文件共 74MB,对现代手机完全可接受,换来零质量损失。
推理加速:iOS 用 Core ML EP(A13 及以上走神经引擎),Android 用 NNAPI,不可用时自动回退 CPU。
架构设计
Flutter 跨端 + ffmpeg 做音频处理 + ONNX Runtime 做 AI 推理:
UI (Flutter)
  │
  ├── ffmpeg_builder.dart     纯 Dart 命令构建层(无 Flutter 依赖,可单测)
  │        └── ffmpeg_service.dart   平台通道封装(iOS/Android 原生执行)
  │
  └── onnx_runtime            模型推理(CoreML EP / NNAPI / CPU 回退)
一个值得说的设计:ffmpeg 命令构建层用纯 Dart 写、不带 Flutter 依赖,所有命令组合都能单测——「裁剪 30 秒 + 淡入淡出 + 转 m4r」这类组合命令,靠单测保证不写错参数。ffmpeg 的坑太多:参数顺序、seek 精度、声道重映射,一个不对整条链路就废。
踩坑记录
1. STFT 参数必须与训练时完全一致(最耗时)
Spleeter 对 STFT 参数极其敏感:帧长、hop、窗函数、center 设置必须与训练时一致,否则模型能跑、输出也有声音,但结果是「微妙地错」——音长漂移、warbling 伪影。这个 bug 最难查:模型不报错,只能按官方实现逐参数核对(n_fft=4096、hop=1024、75% 重叠、周期 hann 窗、center=False),再和桌面端参考实现逐样本对比才定位。
2. 量化回归难发现
见选型部分。教训:端侧模型量化后必须做听感回归,SNR 之类的指标好看不代表听感没问题。
3. 冷启动慢
App 启动后第一次分离要加载模型,明显卡顿。解法:短缓冲预热推理,把模型加载挪到后台,用户感知的首次分离时间大幅下降。
4. iOS / Android 结果不完全一致
同一个 ONNX 图在不同后端(CoreML / NNAPI)输出有细微差异。对工具类 App 可接受,但别指望双端 bit-identical,自动化测试要按后端分开设阈值。
5. ffmpeg seek 与时间轴错位
ffmpeg 输出流 seek 会导致淡入淡出(afade)时间轴错位——试听前半段静音甚至闪退。修法:先精确定位输入,再做时间轴相关滤镜,不依赖 seek 后的流内时间戳。
商业化:0 服务器成本的独立开发者模式
因为全部端侧,服务器成本为 0。商业模式是 Freemium:
-
免费下载:广告 + 每日转换额度
-
Pro:解锁无限转换 + 去广告
-
付费形态:周/年订阅 + 一次性买断,无强制订阅
买断制对独立开发者是长期主义:用户买断一次,之后每次更新都是纯增量,没有「不续费就变废」的割裂感。
一点感受
从立项到 App Store 上架约 1个月(Flutter 一套代码双端开发)。最大的感受:端侧 AI 的体验优势(秒出、离线、隐私)是用户真实感知得到的卖点,而「不花服务器钱」是独立开发者最大的护城河。
App 免费下载,App Store 搜「TS Video to MP3」;官网:tonescoop.app 产品免费下载:App Store 搜「TS Video to MP3」或访问 tonescoop.app
欢迎同行在评论区交流端侧推理、音频处理的问题。