Prime Agent 的价值不在多给工具,而在把长任务变成可恢复、可分派、可沉淀经验的工程工作流。
一个 Coding Agent 真正难处理的任务,通常不是改一行代码,也不是调用几个工具。难的是它已经跑了半小时,手里有一堆中间结论、脚本、日志、子任务和未完成的判断,然后用户关掉终端、换个问题、或者让它继续查另一条线索。
很多 Agent 系统会把这个问题简化成上下文窗口问题:窗口再大一点,摘要再聪明一点,历史再压缩一点。Prime Agent 的思路更像工程系统:别指望模型记住一切,把长任务拆成可恢复的会话,把中间状态放进可编程环境,把验证过的经验沉淀为下一次能复用的补充状态。
这也是它和普通工具式 Coding Agent 的分界线。工具越多,只能扩大一次任务的操作半径;工作流能自恢复、自分派、自积累,才会改变 Agent 处理复杂任务的方式。
长任务失败,往往不是模型不会写代码
短任务里,Agent 的能力很容易判断。能不能读文件,能不能改代码,能不能跑测试,能不能解释报错。问题规模一旦拉长,评价标准就变了。
一个真实的工程任务可能会经历这些状态:
- 读了半个仓库,才发现入口不在主服务,而在一层生成代码后面。
- 跑了三轮测试,失败原因分别来自配置、mock 和真实逻辑。
- 两个子方向都值得查,但其中一个最终证明是噪音。
- 中途产生的脚本、日志切片和调用图,比聊天记录本身更有价值。
- 下一次再做类似审查时,团队不想让 Agent 从零摸索。
普通工具式 Agent 会把 read、edit、bash、search 这些工具直接暴露给模型。这个模式对短任务很顺手,但它有一个天然问题:每次工具结果都往对话里塞,模型要在聊天上下文里同时承担控制流、数据存储、状态恢复和任务调度。
Prime Agent 选择了一条更绕但更适合长任务的路。它默认只给模型一个 ipython 工具,让模型在一个持久 Python REPL 里组织工作。文件读取、shell 命令、临时分析脚本、MCP、skills、子 Agent,都可以通过 Python 组合起来。
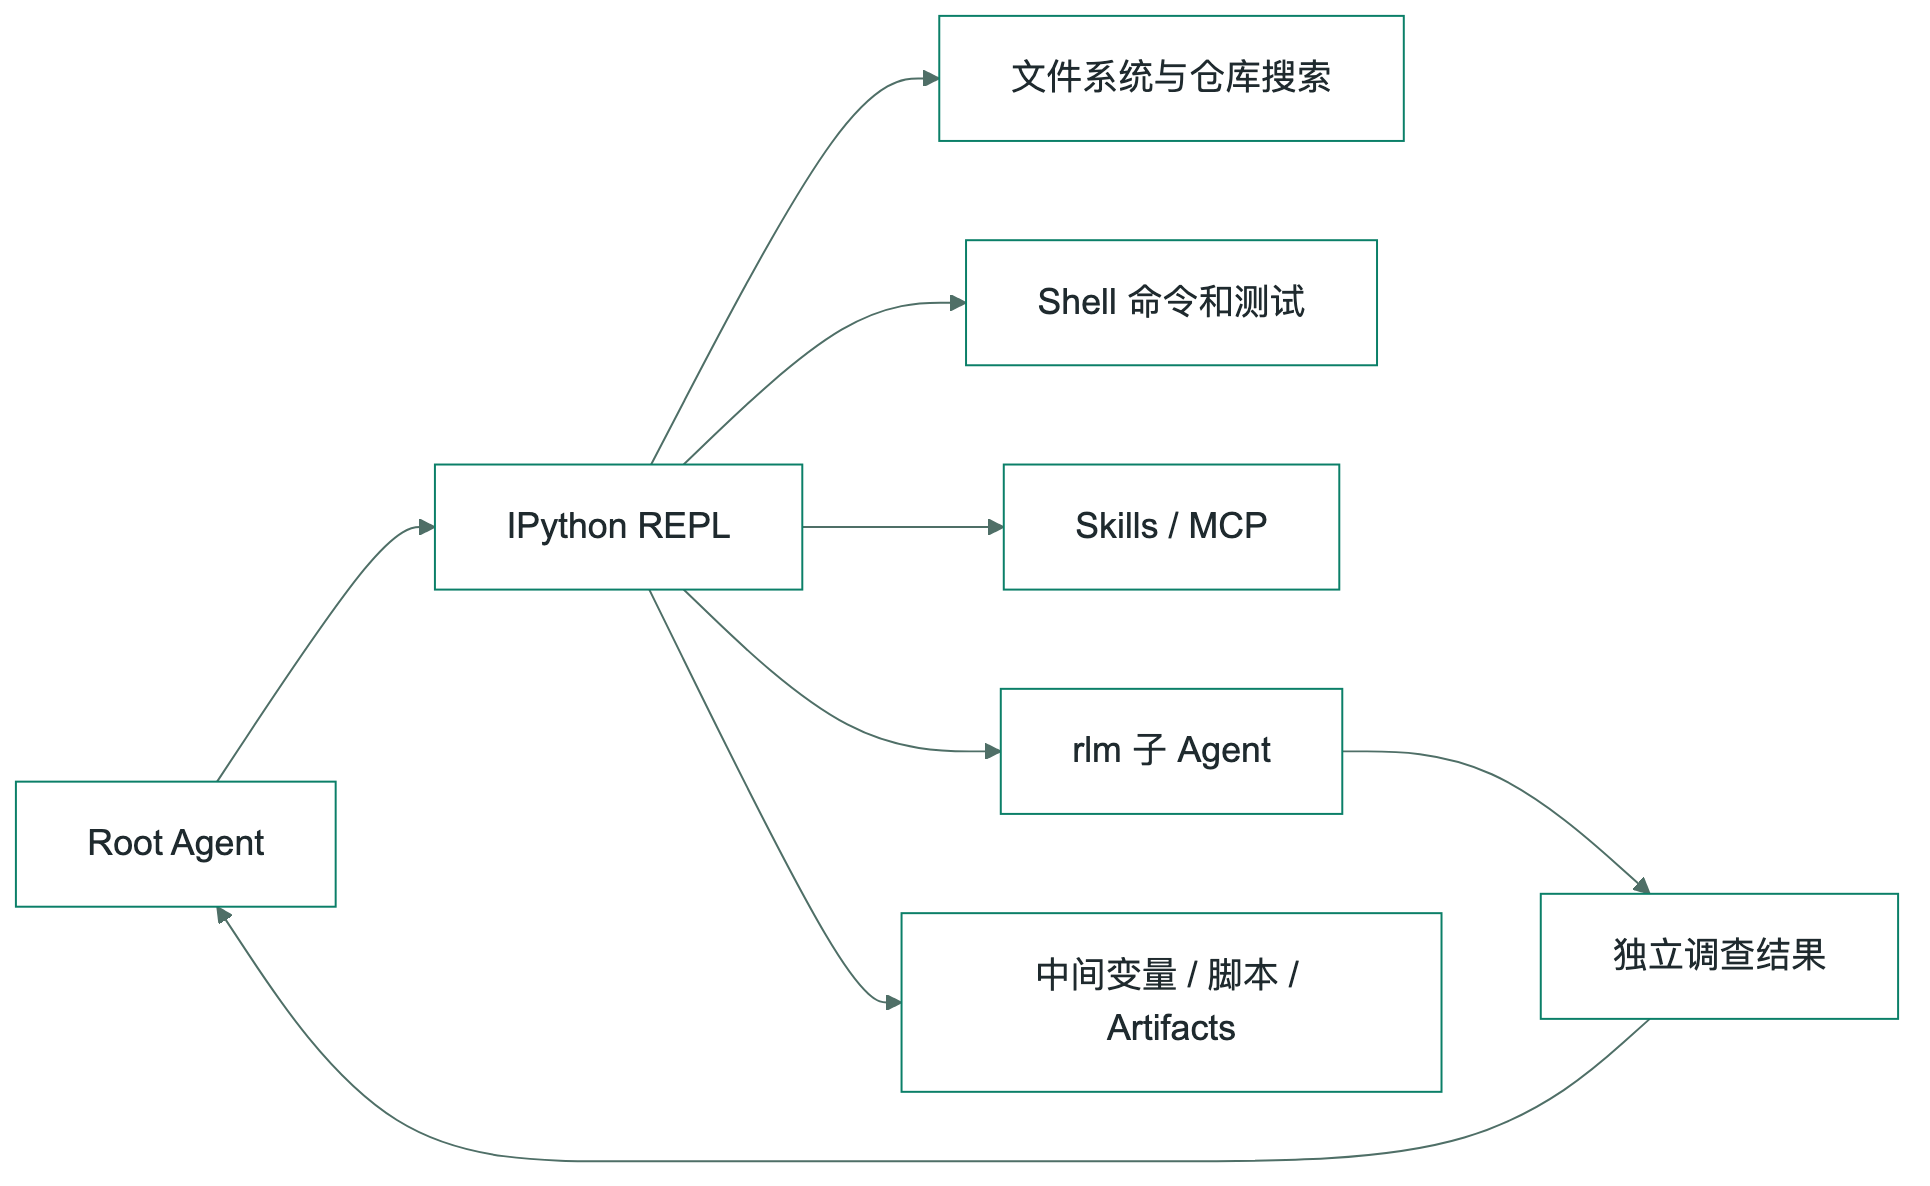
图:Prime Agent 将工具调用收束到可恢复的 REPL 工作流
这个设计的关键不在 Python 本身,而在控制权的位置发生了变化。模型不再把每一步工具调用都当成对话片段处理,而是可以写循环、建索引、保存变量、生成临时脚本,并在需要时把独立调查分派出去。
图:Prime Agent 把工具调用、中间状态和子任务统一放进可恢复工作流。
RLM 的价值:让模型递归调用模型,而不是硬扛上下文
RLM 是 Recursive Language Model。它不是一个新模型,也不是某家 provider 的接口。更准确的说法是:它是一种 Agent 运行方式,让父 Agent 可以把语言模型当作可递归调用的工作单元。
在 Prime Agent 里,父 Agent 遇到可拆分任务时,可以通过 rlm(...) 启动 child Agent。child Agent 拥有自己的上下文、会话目录和执行过程,完成后再把结果通过消息或文件交回父 Agent。父 Agent 不必把所有中间探索都塞进主上下文。
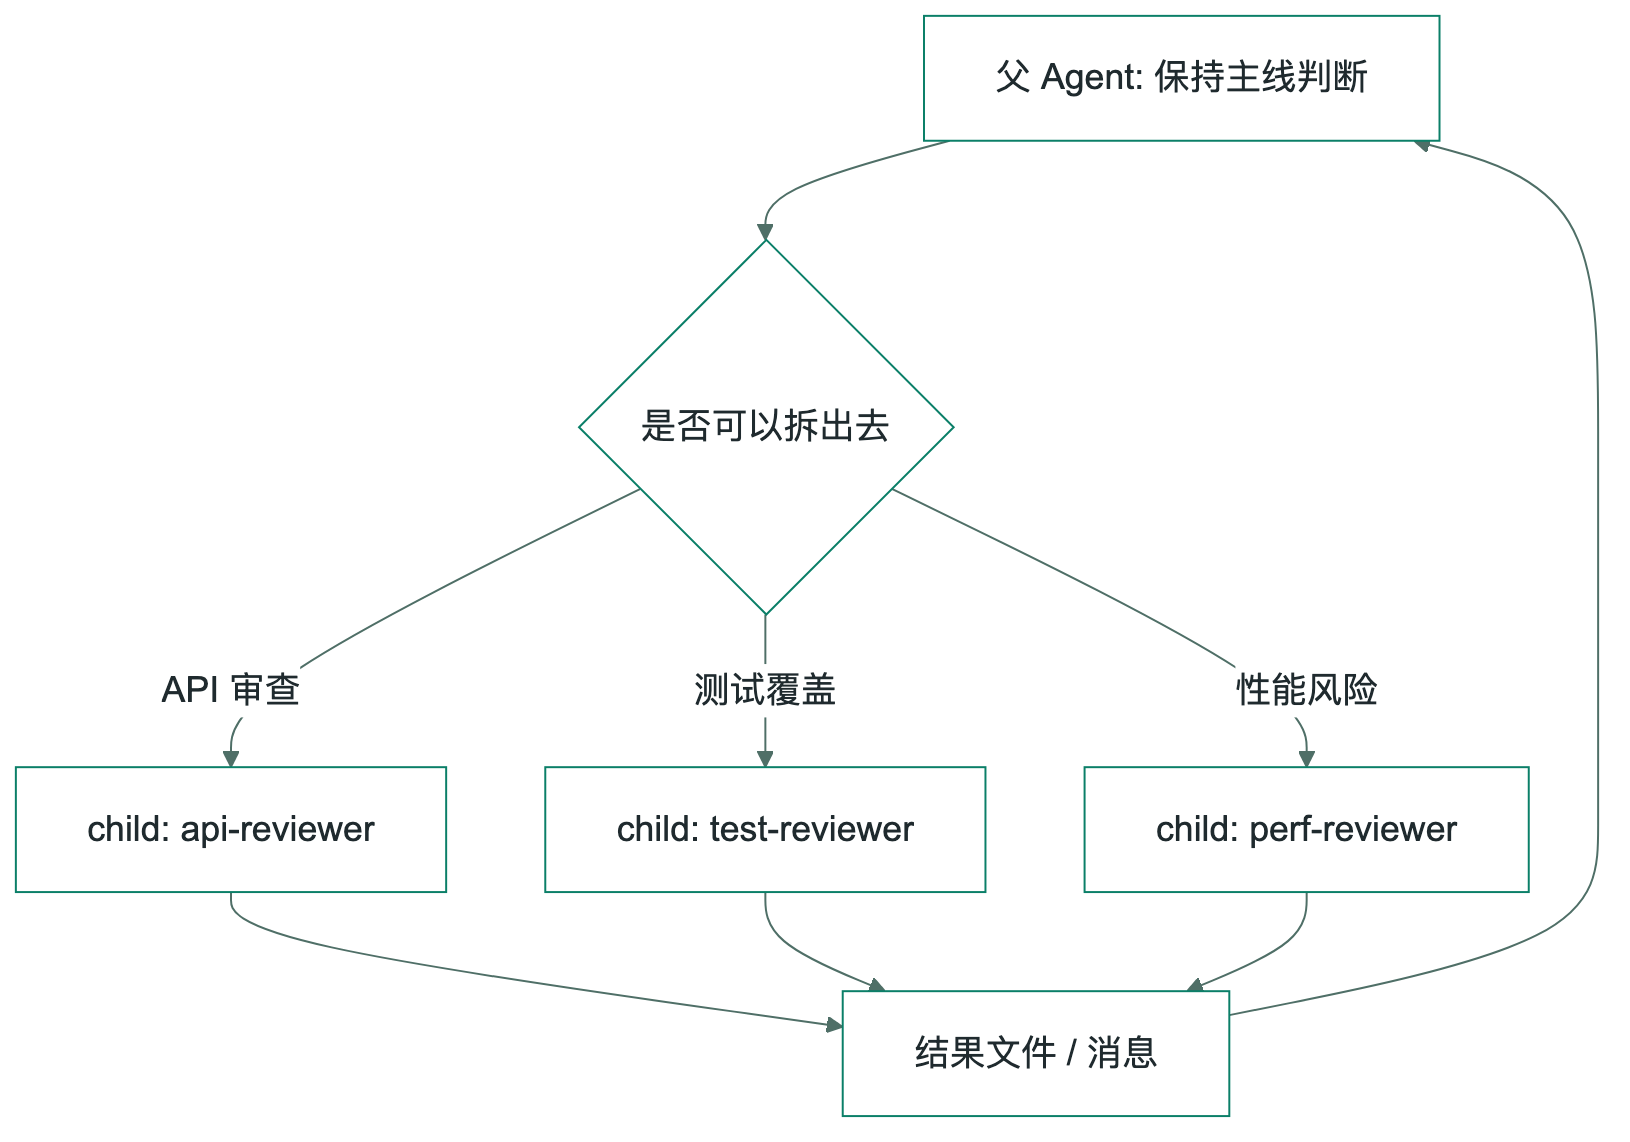
图:RLM 让父 Agent 把独立调查拆给 child run
这和多开几个聊天窗口不是一回事。Prime Agent 的 child run 由 runtime 管理,有 admission、session 目录、深度限制、模型参数和回收路径。rlm() 调用本身只确认子任务被接收,后续结果通过异步方式回来。这一点对慢任务很重要,因为有些调查不该阻塞主 Agent,也不该把半成品结论同步塞回主上下文。
RLM 带来的收益可以拆成三层:
| 层次 | 解决的问题 | Prime Agent 的处理方式 |
|---|---|---|
| 控制流 | 大任务无法靠线性对话推进 | 父 Agent 保持主线,子 Agent 分担独立调查 |
| 状态 | 中间结果容易丢失或污染上下文 | REPL、session artifacts 和结果文件保存过程状态 |
| 协作 | 多个调查方向需要并行推进 | rlm(...) |
| 以 callable 的形式启动 child Agent |
对工程任务来说,主 Agent 最重要的职责不是亲自看完每一行材料,而是决定哪些线索值得继续、哪些结论已经验证、哪些风险需要回到主线。
Self-improving 不是模型自己长脑子
Prime Agent README 里把自己称为 A Self-Improving RLM Agent。这个词容易被误读。这里的 self-improving 不是模型权重自动更新,也不是让系统偷偷改底层 system prompt。
它指的是一套可审查的经验沉淀机制。Prime Agent 有 Continual Harness。一次任务中,如果某个做法被真实仓库、真实命令和真实反馈证明有效,/refine 可以把它整理成 prompt note、memory、skill description 或 subagent specification。这些内容作为 supplemental state 注入后续会话,而不是覆盖 immutable base system prompt。

图:经验沉淀通过可审查状态进入后续会话
这套机制比泛泛的记忆更适合团队流程。记忆如果没有边界,迟早会变成垃圾场。Prime Agent 强调的是小步写入、证据支撑、可审查、可回滚。一次 release audit 的检查顺序、某类仓库的常见失败模式、线上问题复盘时的日志定位路径,都可以沉淀下来。下次遇到类似任务,Agent 不必从零开始撞墙。
这里的工程取舍很清楚:它没有承诺模型本身变聪明,而是把可复用的工作方法变成系统状态。这比“让模型记住一切”更可控,也更容易被团队接受。
哪些任务值得用 Prime Agent
Prime Agent 的运行时更重,复杂度也更高。它不适合所有场景。判断标准可以很朴素:如果 5 到 10 分钟能说清楚、查清楚、改完,用普通 Agent 更轻;如果任务会持续几十分钟到几小时,需要恢复状态、分派子任务、跑实验、沉淀经验,Prime Agent 才开始显出价值。
| 任务类型 | 典型场景 | Prime Agent 的优势 |
|---|---|---|
| 陌生代码库调研 | 找入口、模块边界、调用链、测试方式和风险点 | REPL 保存分析脚本和中间结果,子 Agent 分线调查 |
| 复杂 bug 根因分析 | 日志、配置、测试、历史改动交叉验证 | 状态留在变量、文件和 artifacts 里,后续不用重查 |
| 跨模块重构 | 盘点影响面,分批修改,跑检查,修回归 | daemon worker 支持长时间执行和 attach 恢复 |
| 质量治理和代码审查 | API、测试覆盖、性能、安全、迁移风险分线排查 | rlm(...) |
| 适合把独立审查交给子 Agent | ||
| 研究和评测 | benchmark、provider 对比、实验结果整理 | Python REPL 适合保存数据、脚本和分析过程 |
| 团队流程复用 | release audit、故障复盘、仓库迁移、规则生成 | /refine |
| 把验证过的经验沉淀为 Harness 状态 |
反过来,有几类任务不该强行使用 Prime Agent:
- 简单问答、短摘要、单文件小修,用普通 Claude Code、Codex 或 ChatGPT 就够。
- 固定 ETL、格式转换、批处理脚本,更适合写成确定性的普通程序。
- 不可信仓库、不可信 skill、不可信 extension,不该直接放到同一用户权限环境里跑。
- 对安全隔离要求极高的任务,需要外部容器、沙箱或受限用户环境兜底。
Prime Agent 不是 sandbox。IPython kernel 和 shell magic 都以用户 OS 权限运行。它能做的事越多,供应链和误操作的风险面也越大。
推荐阅读
Agent Team 真正缺的不是更多 Agent,而是同步协议
DeepSeek Harness 为什么能热换模型:插件依赖、事件日志与回滚机制
DeepSeek Harness:Agent 自我改进之前,先让 Harness 可观察、可组合、可回滚
别只给 AI 产品接模型:Agent 能做成事,靠的是策略和 Harness
AX Tree:Agent 操作电脑时,真正需要的不是截图,而是界面语义