上篇讲了路线选型和整体架构。本篇是 API 接通的实战细节:凭证获取、token 管理、草稿接口调用,以及调试期实际遇到的全部报错和处理办法。
一、获取凭证:AppID 与 AppSecret
公众号后台 →「设置与开发 → 开发接口管理 → 基本配置」:
- AppID 直接可见
- AppSecret 点「启用」,管理员微信扫码后显示,只完整显示一次,关闭页面后只能重置,务必立即保存
凭证不要写死在代码里,从环境变量或 .env 读取:
appid = os.environ.get("WECHAT_APPID")
secret = os.environ.get("WECHAT_APPSECRET")
二、access_token:获取与缓存
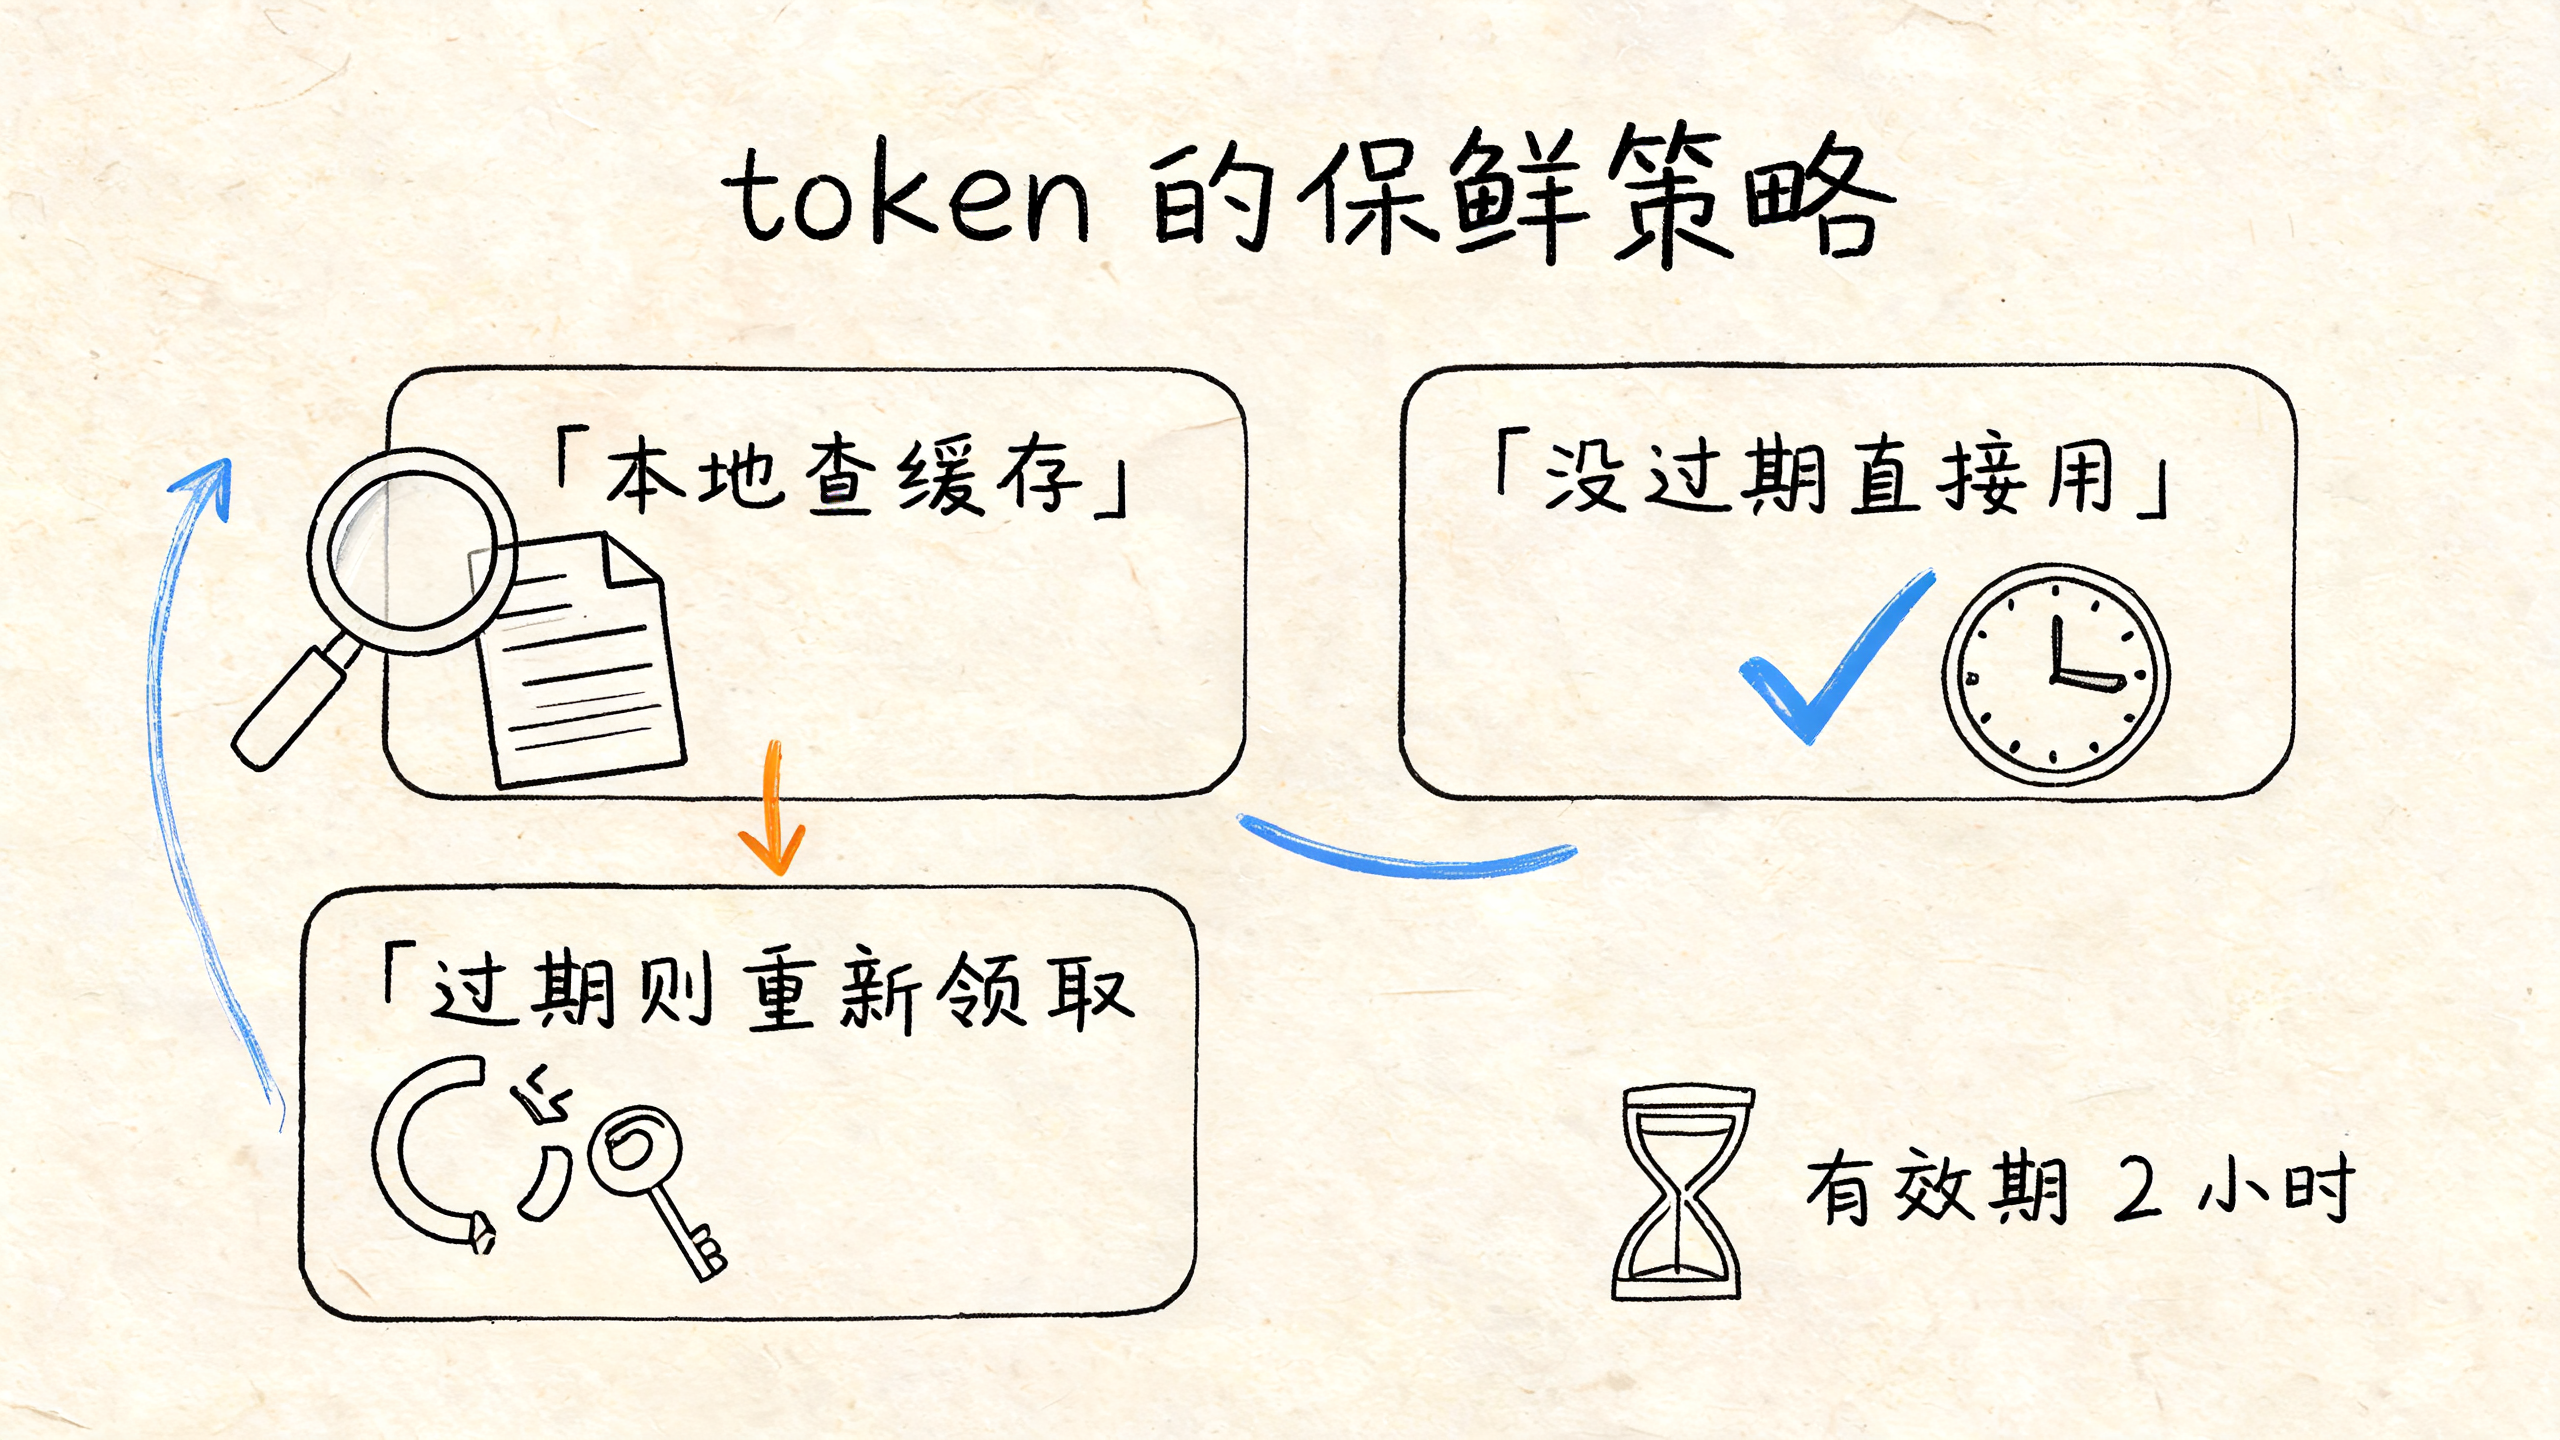
所有接口都凭 access_token 调用,有效期 7200 秒。批量推送时缓存复用,留 5 分钟余量提前刷新:
TOKEN_CACHE = Path("wechat_token.json")

def get_token(appid, secret):
    if TOKEN_CACHE.exists():
        cache = json.loads(TOKEN_CACHE.read_text(encoding="utf-8"))
        if cache.get("expires_at", 0) > time.time() + 300:
            return cache["access_token"]
    r = requests.get(f"{BASE}/cgi-bin/token", params={
        "grant_type": "client_credential",
        "appid": appid, "secret": secret}, timeout=15)
    data = r.json()
    assert data.get("access_token"), data  # 40164 在这里暴露
    TOKEN_CACHE.write_text(json.dumps({
        "access_token": data["access_token"],
        "expires_at": time.time() + data.get("expires_in", 7200)}))
    return data["access_token"]
三、坑 1:IP 白名单(家用宽带的动态 IP)
这是整个调试期最折磨人的问题,而且文档不会主动提醒你。
微信的安全机制:光凭 AppSecret 不够,调用方公网 IP 必须在后台「基本配置 → IP白名单」里登记,否则:
{"errcode": 40164,
 "errmsg": "invalid ip 59.57.238.3 ipv6 ::ffff:59.57.238.3, not in whitelist"}
家用宽带的公网 IP 是动态的——运营商定期回收、光猫重启都会换。我的实际经历:第一天把 58.23.x.x 加进白名单跑通了,第二天早上同样的代码又报 40164,IP 变成了 59.57.x.x。
应对方案:
- 短期:白名单支持多个 IP,新旧都留着;报错信息里自带当前 IP,照着重加一次 30 秒搞定
- 长期:脚本挪到固定 IP 的云服务器,彻底告别此问题
- 工程细节:脚本收到 40164 时把当前 IP 打印进错误提示,排查不用额外查 IP
四、坑 2 与坑 3:token 失效与额度
40001 / 42001(token 无效或过期):多个地方各自获取 token 会互相挤掉(新 token 签发后旧的在短暂宽限期后失效)。单机上靠共享缓存文件解决;多进程并发时注意加锁或串行。
45009(接口调用超当日限额):各接口有日调用上限。批量推送前先在本地做齐检查(标题长度、图片格式),别把额度浪费在必然失败的请求上——能在本地拦下的错误,就不要发到对端。
五、草稿接口调用
payload = {"articles": [{
    "title": title,          # ≤64 字符,超长本地先拦
    "author": author,
    "digest": digest,        # 摘要,≤120 字符
    "content": html,         # 见下篇:内联样式 + 微信域图片
    "thumb_media_id": thumb_id,
    "need_open_comment": 0, "only_fans_can_comment": 0,
}]}
r = requests.post(f"{BASE}/cgi-bin/draft/add",
                  params={"access_token": token},
                  data=json.dumps(payload, ensure_ascii=False).encode("utf-8"),
                  headers={"Content-Type": "application/json; charset=utf-8"},
                  timeout=60)
media_id = r.json()["media_id"]
两个细节:
- 中文内容必须
ensure_ascii=False后按 UTF-8 编码发送,否则标题摘要变乱码 - 拿到
media_id后我顺手做了状态回写:文章 frontmatter 的status改为已推草稿并记录wechat_media_id,后续批量维护时能一眼看出「哪篇推了哪篇没推」
六、排期策略:每天 1 篇怎么排
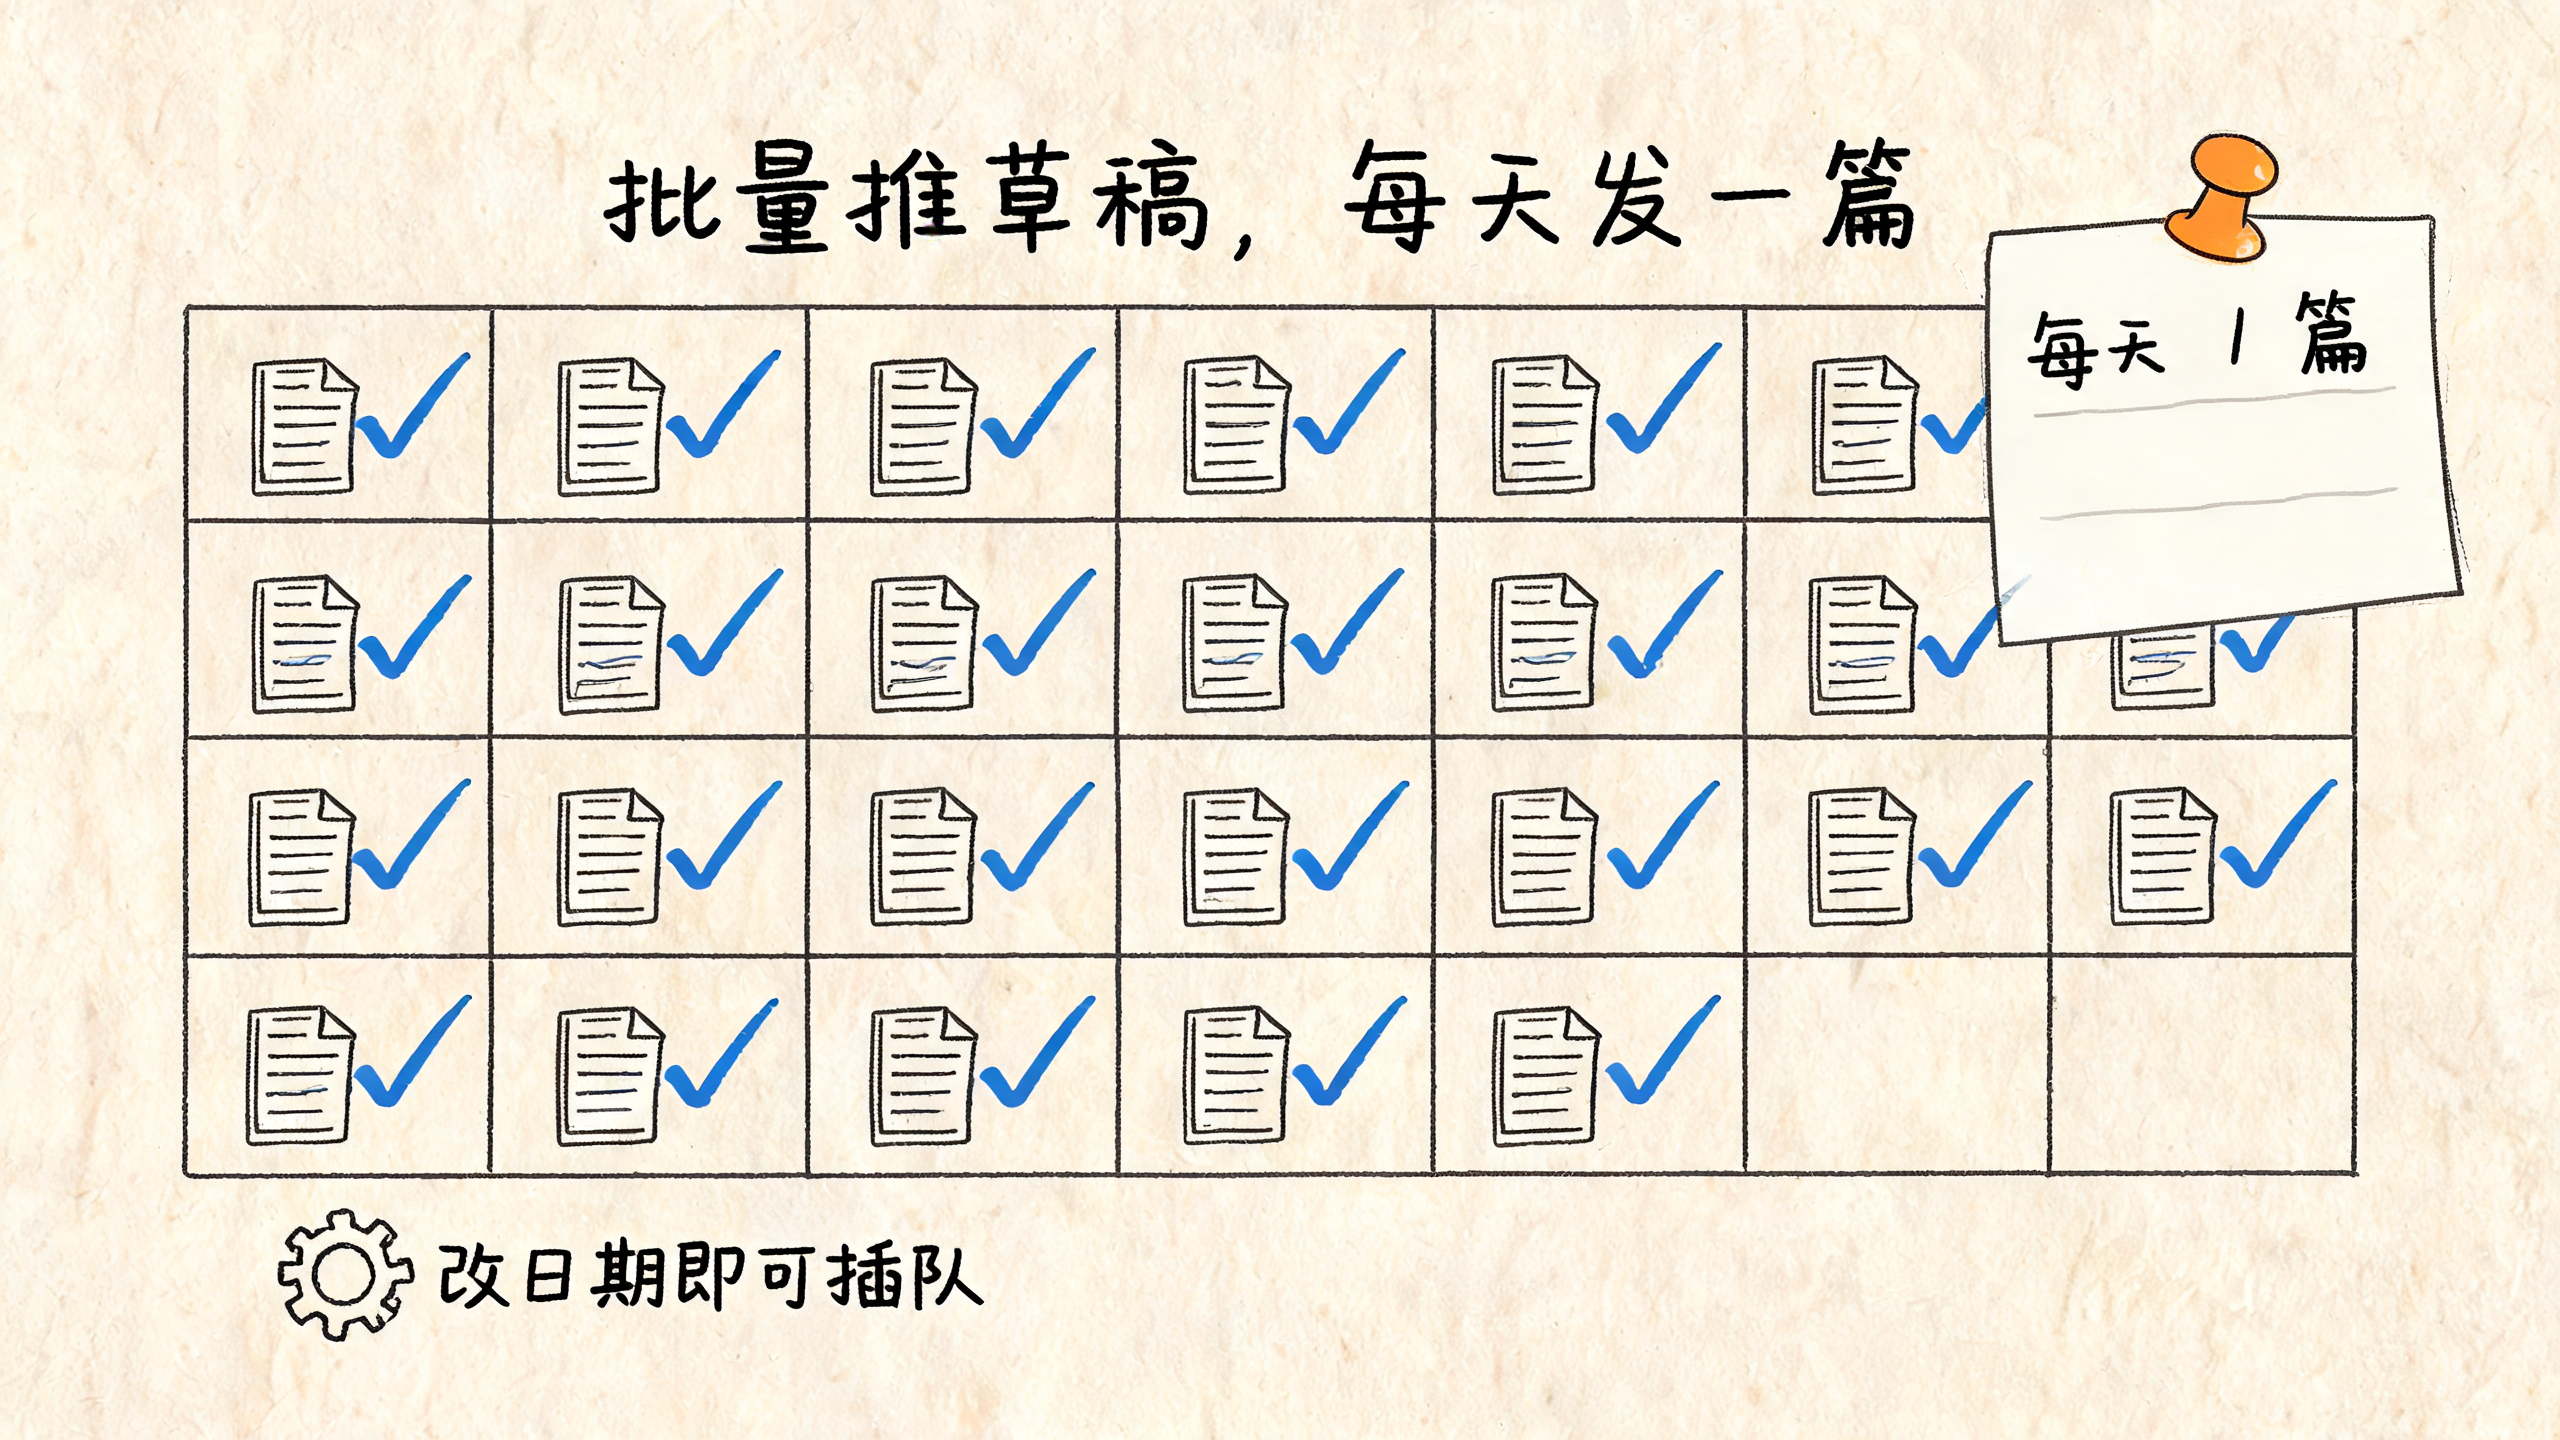
订阅号群发每天限 1 次,推草稿箱不限量,所以模式是「批量推草稿 + 每日定点发」:
- 每篇文章 frontmatter 记
created日期,一天一篇顺延排好 - 发布时按日期取当天那篇;要插队改日期即可,不动其他任何配置
- 保留人工点发表(订阅号助手 App 一键发),发布前过一遍排版;想全自动就调
freepublish/submit,脚本留个开关参数即可
七、报错对照表(实测整理)
| errcode | 含义 | 处理 |
|---|---|---|
| 40164 | 调用方 IP 不在白名单 | errmsg 里自带当前 IP,加进白名单;家用宽带 IP 会变 |
| 40001 / 42001 | token 无效/过期 | 删本地缓存重新获取 |
| 45009 | 接口超当日限额 | 本地先校验,减少无效调用 |
| 40007 | media_id 无效 | 检查封面素材是否上传成功 |
| 45110 | 草稿相关限制/内容问题 | 看 errmsg 具体描述 |
下篇预告
接口全通之后,最后一块硬骨头是「内容格式」:微信对正文图片、封面大小、CSS 写法各有铁规,每一个都能让推送结果「静默失败」。下篇《公众号自动发布实战(三)》讲排版转换的三大限制与完整实现代码。
如果这篇对你有用,欢迎关注看「AI 工具人 PM 实战」系列更新;你调第三方 API 时踩过最隐蔽的坑是什么?评论聊聊;觉得有用就收藏备用。