影刀RPA新手教程:人事HR自动化完全指南——简历解析考勤统计与入职流程
作者:林焱
我第一次用影刀RPA做人事HR自动化,是要处理300份简历,从中提取姓名、手机号、邮箱、工作经历等信息,然后自动录入到HR系统里。手动处理要花整整一周,用影刀RPA写了个流程,2小时全部搞定。这篇文章把我做人事HR自动化踩过的坑全部告诉你。
一、认识影刀与安装配置
去影刀RPA官网下载安装包,安装时勾选所有插件。安装完成后打开软件,界面分为三块:左边是指令面板,中间是流程编辑画布,右边是属性配置面板。
做人事HR自动化要用到"网页自动化"、"Excel"、"OCR"等分类下的指令,这些指令在社区版里就有,不需要升级到付费版。但如果你的流程指令数会超过100条,建议直接用创业版,不然写到一半发现指令数不够用就很尴尬。
新建应用时选择"Windows应用"或"Web应用"(取决于你要操作的是本地软件还是网页系统)。给应用起名叫做"人事HR自动化助手",方便以后在应用列表里找到它。
二、元素定位四合一:找准HR系统里的每一个输入框
人事HR自动化最难的不是数据处理,而是定位到HR系统里的具体输入框、下拉框、按钮这些元素。影刀RPA提供了四种定位方式。
元素捕获:点击指令面板的"捕获元素",鼠标变成十字准星,移到HR系统的任意位置点击。我第一次捕获HR系统里的姓名输入框,发现捕获到的是整个页面,不是里面的输入框。后来才知道要等鼠标移动到输入框边缘出现蓝色边框时再点击,才能准确捕获到输入框元素。
XPath语法(6种最常用写法):
//*[text()="提交"]                      匹配文字等于"提交"的任何元素
//button[@id="submitBtn"]            匹配id为submitBtn的button元素
//div[contains(@class,"form-input")]     匹配class包含"form-input"的div元素
//input[@type="text" and @name="name"]  多条件匹配
//*[starts-with(@id,"ipt_")]               id以ipt_开头的元素
//table//tr[position()>1]                    表格中从第二行开始的所有行
CSS选择器语法(8种最常用写法):
#submitBtn                     id选择器
.form-input .input-text        层级选择器
input[type="text"]            属性选择器
button:first-child             伪类选择器,匹配第一个button
tr:nth-child(odd)             奇数行选择器
*[class^="ipt_"]              属性开头匹配
*[class$="_name"]              属性结尾匹配
*[class*="input"]              属性包含匹配
XPath和CSS选型指南: XPath能向上遍历父节点,CSS只能向下遍历。如果你要定位的元素没有唯一标识,但它的父元素有,用XPath的".."可以很方便地到父元素再找兄弟元素。
XPath支持text()函数直接匹配文字内容,CSS不支持。比如HR系统里有很多个"提交"按钮,用XPath的text()可以精确定位到某一个。
但CSS选择器的执行速度比XPath快大约30%,这是我实际测试出来的。如果你要匹配的文字内容固定,用XPath的text()最方便。如果是纯结构定位,用CSS选择器性能更好。
正则表达式(3个最常用场景):
1[3-9]\d{9}           匹配手机号(1开头,第二位3-9,后面9位数字)
[\w.-]+@[\w.-]+\.\w+   匹配邮箱地址
(\d{4})-(\d{2})-(\d{2})   匹配日期格式(如1990-01-01)
三、变量与数据类型:HR数据存储的核心
处理人事HR数据时,最常用的变量类型是字符串(存储姓名、手机号、邮箱)、列表(存储多个简历数据)、字典(存储简历字段映射关系)。
字符串操作:
# 字符串拼接(生成简历文件名)
resume_filename = "简历_" + name + "_" + phone + ".pdf"

# 字符串索引
first_char = name[0]               # 取姓名的第一个字符(姓)
last_four = phone[-4:]           # 取手机号的最后四位

# 字符串替换(清理简历中的无用信息)
clean_text = resume_text.replace(" ", "")   # 移除空格
clean_text = clean_text.replace("\n", "")   # 移除换行符
列表操作:
# 从Excel读取的简历数据存到列表
resume_list = [
    ["张三", "13800001111", "zhangsan@qq.com", "本科"],
    ["李四", "13900002222", "lisi@qq.com", "硕士"]
]

# 遍历列表处理每份简历
for item in resume_list:
    name = item[0]
    phone = item[1]
    email = item[2]
    education = item[3]
    # 录入HR系统...
字典操作(存储简历字段映射):
# 简历字段映射字典
resume_fields = {
    "姓名": "name",
    "手机号": "phone",
    "邮箱": "email",
    "学历": "education",
    "工作经验": "work_exp"
}

# 键不存在时的两种处理方案
# 方案1:用get方法提供默认值
name = resume_dict.get("姓名", "未知")

# 方案2:先判断key是否存在
if "姓名" in resume_dict:
    name = resume_dict["姓名"]
else:
    name = "未知"
JSON数据处理(从HTTP接口获取HR数据):
import json
import requests

# 发送HTTP请求获取简历列表
response = requests.get("https://your-hr-system.com/api/resumes")
response_json = json.loads(response.text)

# 操作JSON数据
for item in response_json["data"]:

[video(video-oKqzFvNB-1782596870182)(type-csdn)(url-https://live.csdn.net/v/embed/525010)(image-https://v-blog.csdnimg.cn/asset/f4faa587144cb7070f19e8b36813806b/cover/Cover0.jpg)(title-店群矩阵自动化突破运营极限!)]

    name = item["name"]
    phone = item["phone"]
    email = item["email"]
    # 处理简历...

# JSON转文本存储
json_text = json.dumps(response_json, ensure_ascii=False, indent=2)
四、流程控制:让人事流程按顺序执行
批量处理简历最核心的是循环和判断。ForEach列表循环用来遍历Excel里的每一行简历数据。If条件判断用来检查简历必要字段是否完整。
For次数循环:当你知道要处理多少份简历时用这个。比如要处理50份简历,设置循环次数为50,每次循环处理一份。
相似元素循环:当你要操作HR系统里的多个相同格式的输入区域时用这个。比如简历录入界面有5个输入框,用相似元素循环一次性全部找到并填写。
ForEach列表循环(最常用):
# 从Excel读取的简历数据列表
resume_data = [
    {"name": "张三", "phone": "13800001111", "email": "zhangsan@qq.com"},
    {"name": "李四", "phone": "13900002222", "email": "lisi@qq.com"}
]

# ForEach循环遍历
for resume in resume_data:
    name = resume["name"]
    phone = resume["phone"]
    email = resume["email"]
    # 打开HR系统
    # 填写姓名
    # 填写手机号
    # 填写邮箱
    # 提交
While条件循环:当你不知道要处理多少份简历时用。比如从一个不断有新简历上传的文件夹里取简历来处理,只要文件夹里还有简历文件就继续循环。
无限循环:慎用。我曾经写了一个无限循环忘记设退出条件,影刀RPA跑了整整一夜,第二天早上发现电脑卡死,录入了几千条重复的简历。现在我在无限循环里一定加一个计数器和退出条件。
If条件判断:
# 检查简历必要字段是否完整
if name and phone and email:
    # 字段完整,录入HR系统
    input_resume_to_hr_system()
else:
    # 字段不完整,记录错误日志
    print("简历数据不完整:name=" + str(name))
Try-Catch异常处理:简历处理过程中可能遇到各种意外——HR系统页面加载超时、网络连接中断、输入框被禁用。用Try-Catch包住核心代码,出错了也不会中断整个流程。
try:
    # 尝试打开HR系统
    web.open("https://hr-system.com")
    # 填写简历信息
    web.input("姓名输入框", name)
    # 提交
    web.click("提交按钮")
except Exception as e:
    # 出错了记录日志,但不中断流程
    print("录入简历失败:" + str(e))
五、人事HR自动化实战案例
我要带你做一个真实可用的项目:简历自动解析与录入系统。需求是从邮箱下载简历附件(PDF/Word格式),然后自动解析简历内容,提取关键信息,最后自动录入到HR系统里。
简历文件格式(存储在指定文件夹里):
- 张三_13800001111.pdf
- 李四_13900002222.docx
- 王五_13700003333.pdf
HR系统界面:
- 姓名输入框:id="ipt_name"
- 手机号输入框:id="ipt_phone"
- 邮箱输入框:id="ipt_email"
- 学历下拉框:id="sel_education"
- 提交按钮:id="btn_submit"
影刀RPA流程设计:
第一步:用"文件循环"指令遍历文件夹里的所有简历文件。勾选"包含子文件夹",这样会递归遍历所有子文件夹里的简历文件。
第二步:在循环内部,用"OCR-识别"指令识别PDF格式的简历(如果是Word格式,用"Word-读取文字"指令)。
第三步:用正则表达式提取简历中的关键信息。用"正则表达式匹配"指令,匹配手机号、邮箱、姓名等。
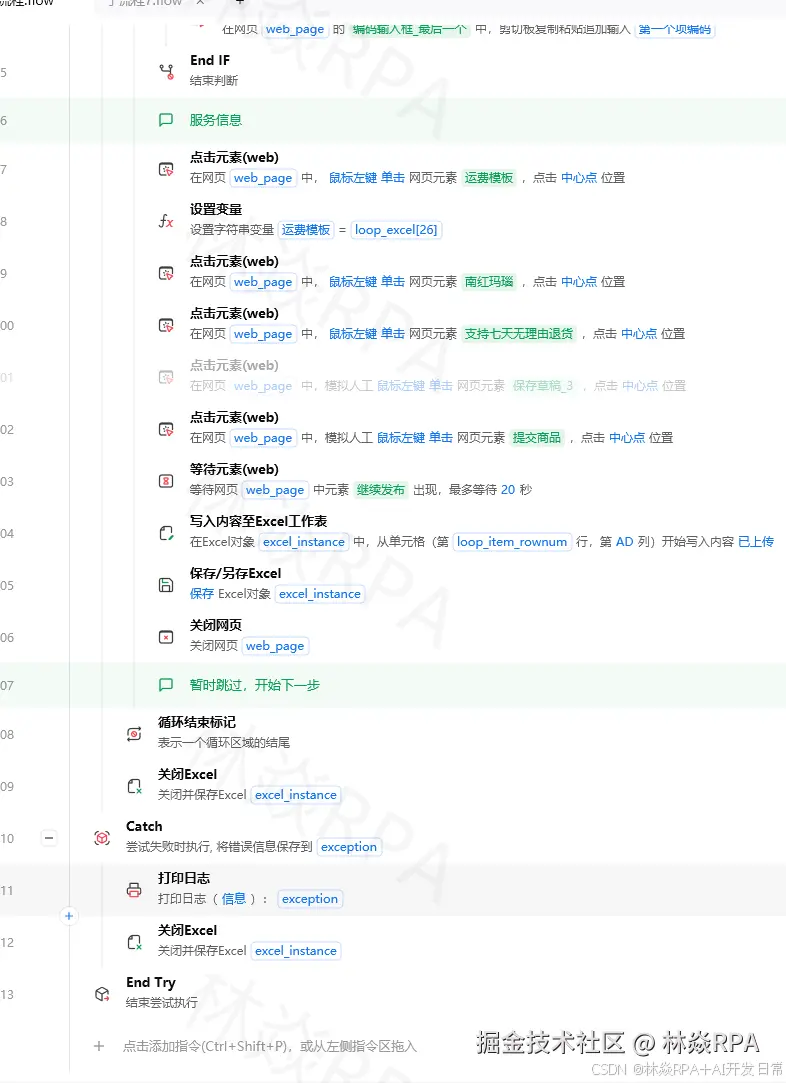
第四步:用"启动网页"指令打开HR系统。用"填写输入框"指令填写姓名、手机号、邮箱等信息。用"下拉框选择"指令选择学历。
第五步:用"点击元素"指令点击提交按钮。用"等待元素出现"指令等待"提交成功"提示出现。
第六步:用"Excel-写入"指令把录入结果写到Excel表格里,方便后续查看。
真实报错处理:
报错1:元素超时未出现
原因:HR系统页面加载慢,或者网络延迟导致页面元素没有及时出现。
解决:在"点击元素"指令前,用"等待元素出现"指令等待元素出现后再点击。或者增加超时时间设置(默认是20秒,可以改成60秒)。
报错2:输入框填写失败:元素不可交互
原因:输入框被禁用了,或者被其他元素遮挡了。
解决:用"图像识别-点击"指令点击输入框,让输入框获得焦点,然后再填写。或者用"JavaScript执行"指令直接修改输入框的value属性。
# 用JavaScript直接修改输入框的值
script = """
function(element, args) {
document.getElementById('ipt_name').value = args;
return true;

}
"""
web.execute_javascript(script, name)
报错3:OCR识别结果不准确
原因:简历PDF是扫描版,图片分辨率低,或者文字倾斜、模糊。
解决:用"图像处理-提高分辨率"指令提高图片分辨率。用"图像处理-倾斜校正"指令校正倾斜的文字。用"图像处理-锐化"指令提高图片清晰度。
六、简历解析:让非结构化数据变可用
简历通常是非结构化的文本(PDF或Word文档),需要从中提取结构化的信息(姓名、手机号、邮箱、学历、工作经验等)。影刀RPA可以通过OCR识别+正则表达式来解析简历。
OCR识别简历内容: 用"OCR-识别"指令,选择要识别的简历PDF文件路径,识别语言选择"中文+英文",输出结果存到变量resume_text里。
用正则表达式提取关键信息:
import re

# 提取手机号
phone_pattern = r'1[3-9]\d{9}'
phone = re.search(phone_pattern, resume_text)
if phone:
    phone = phone.group()

# 提取邮箱
email_pattern = r'[\w.-]+@[\w.-]+\.\w+'
email = re.search(email_pattern, resume_text)
if email:
    email = email.group()

# 提取姓名(假设姓名在简历最前面,且是2-4个中文字符)
name_pattern = r'^([\u4e00-\u9fa5]{2,4})'
name = re.search(name_pattern, resume_text)
if name:
    name = name.group(1)

# 提取学历
education_pattern = r'(本科|硕士|博士|大专|中专)'
education = re.search(education_pattern, resume_text)
if education:
    education = education.group()

# 提取工作经验年数
exp_pattern = r'(\d+)年工作经验'
work_exp = re.search(exp_pattern, resume_text)
if work_exp:
    work_exp = work_exp.group(1)
简历解析结果的处理: 解析出来的信息可能不完整(比如简历里没有写邮箱),需要做一些容错处理。
# 检查必要字段是否完整
if not name:
    name = "未知"
if not phone:
    print("简历解析失败:未找到手机号")
    continue  # 跳过这份简历
if not email:
    email = ""  # 邮箱可以为空

# 保存到Excel
excel_data.append([name, phone, email, education, work_exp])
七、考勤统计:让HR从繁琐的表格中解放
考勤统计是HR每月最繁琐的工作之一。影刀RPA可以自动从考勤系统导出考勤数据,然后自动统计每个员工的出勤天数、迟到次数、早退次数、请假天数等。
从考勤系统导出数据: 用"网页自动化"指令登录考勤系统,然后点击"导出"按钮,下载考勤数据Excel文件。
考勤数据统计:
用"启动Excel"指令打开考勤数据Excel文件,然后用"读取Excel内容"指令把数据读到变量attendance_data里。
import pandas as pd

# 用pandas读取Excel(需要先安装pandas:pip install pandas)
df = pd.read_excel("考勤数据.xlsx")

# 统计每个员工的考勤情况
attendance_summary = df.groupby("员工姓名").agg({
    "出勤状态": lambda x: (x == "正常").sum(),  # 出勤天数
    "迟到次数": lambda x: (x == "迟到").sum(),
    "早退次数": lambda x: (x == "早退").sum(),
    "请假天数": lambda x: (x == "请假").sum()
})

# 保存到新的Excel文件
attendance_summary.to_excel("考勤统计结果.xlsx")
考勤统计的常见坑:
坑1:考勤系统的导出按钮是动态加载的,页面加载完成后还要等几秒才会出现。解决办法是在点击"导出"按钮前,用"等待元素出现"指令等待按钮出现。
坑2:导出的Excel文件格式不固定,有的月份有"迟到次数"列,有的月份没有。解决办法是在读取Excel后,先检查必要的列是否存在,如果不存在就跳过或者给出默认值。
坑3:考勤数据里有合并单元格,导致读取出来的数据错位。解决办法是在读取Excel前,用"Excel-取消合并单元格"指令取消所有合并单元格。
八、入职流程自动化:让新员工快速上手
新员工入职时,需要完成一系列流程:创建企业邮箱、开通OA账号、分配工位、发放办公用品、安排入职培训等。影刀RPA可以自动化这些流程。
创建企业邮箱: 用"HTTP请求"指令调用企业邮箱的API接口,自动创建企业邮箱账号。
import requests
import json

# 调用企业邮箱API创建邮箱账号
url = "https://your-mail-system.com/api/create_mailbox"
headers = {"Authorization": "Bearer your_token_here"}
data = {
    "username": "zhangsan",
    "password": "Temp@123456",
    "name": "张三",
    "department": "技术部"
}

response = requests.post(url, headers=headers, json=data)
result = json.loads(response.text)

if result["success"]:
    print("企业邮箱创建成功:" + result["email"])
else:
    print("企业邮箱创建失败:" + result["message"])
开通OA账号: 用"网页自动化"指令登录OA系统,然后自动填写新员工信息,开通OA账号。
发送入职通知邮件: 用"发送邮件"指令给新员工发送入职通知邮件,包含企业邮箱账号密码、OA系统地址、入职培训安排等信息。
# 邮件配置
# SMTP服务器:smtp.qq.com
# 端口:465
# 发件人:hr@company.com
# 收件人:zhangsan@qq.com
# 主题:欢迎加入我们公司!
# 正文:
# 亲爱的张三,欢迎加入我们公司!
# 您的企业邮箱账号是:zhangsan@company.com,临时密码是:Temp@123456
# 请登录后及时修改密码。
# OA系统地址:https://oa.company.com
# 入职培训安排详见附件。
# 附件:入职培训安排.pdf
九、数据处理:Excel驱动人事管理
人事HR数据通常存在Excel里。影刀RPA操作Excel有一套完整的指令。
读取Excel的常见坑:
坑1:Excel文件被占用。如果Excel文件在手动打开状态下,影刀RPA无法读取。解决办法是在"启动Excel"指令里勾选"如果已打开则复用",或者用"关闭Excel"指令先关掉。
坑2:Sheet名称不对。默认读取的是第一个Sheet,但如果你的数据在第二个Sheet里,要指定Sheet名称。我第一次做的时候就因为Sheet名称是中文"简历数据",而指令里写的是"Sheet2",导致读出来的数据全是空。
[video(video-X5sAsGCj-1782596876893)(type-csdn)(url-live.csdn.net/v/embed/524…)]
坑3:空行问题。Excel表格里如果有空行,"读取Excel内容"指令会把空行也读进去。读出来之后用If条件判断过滤掉空行,或者先在Excel里把空行删掉。
Excel公式在人事HR中的应用:
如果要根据入职日期自动计算工龄,可以用公式:
=DATEDIF(C2, TODAY(), "Y") & "年" & DATEDIF(C2, TODAY(), "YM") & "个月"
这个公式的意思是:计算C2单元格的入职日期到今天之间相差多少年多少个月。
如果要根据考勤数据自动判断是否需要发起绩效改进计划(PIP),可以用公式:
=IF(AND(D2>3, E2>3), "需要发起PIP", "正常")
这个公式的意思是:如果D2单元格的迟到次数大于3次,且E2单元格的早退次数大于3次,则显示"需要发起PIP",否则显示"正常"。
十、鼠标键盘图像自动化
操作HR系统时,有些操作没有现成的指令,需要用模拟键鼠的方式。比如HR系统里面的"批量导入"功能,用"发送快捷键"Ctrl+Shift+I可以快速打开导入界面。
模拟模式vs驱动模式: 模拟模式是模拟鼠标移动和点击,速度快但容易被某些安全软件拦截。驱动模式是底层驱动模拟,更稳定但速度稍慢。我建议默认用模拟模式,如果遇到指令执行不稳定再切换到驱动模式。
虚拟键盘驱动: 如果要模拟打字输入姓名,用"模拟输入"指令。如果要模拟快捷键,用"发送快捷键"指令。比如Ctrl+A全选、Ctrl+C复制、Ctrl+V粘贴、Tab键切换输入框。
图像识别: 如果HR系统界面上某个按钮找不到元素,可以用图像识别点击。用"图像识别-等待出现"指令等待按钮出现,然后用"图像识别-点击"指令点击按钮。图像识别的锚点有9个位置(上、下、左、右、左上、右上、左下、右下、中心),选哪个位置取决于按钮的形状。方形按钮选中心,长条形按钮选中心偏右的位置。
十一、进阶技能:Python协同处理人事数据
影刀RPA内置了Python环境,可以直接调用Python的第三方库来处理人事HR数据。最常用的是pandas库(处理Excel数据)、requests库(调用HR系统API)。
安装pandas库: 在影刀RPA的"Python-执行代码"指令里,先用pip安装库:
import subprocess
subprocess.check_call(['pip', 'install', 'pandas'])
subprocess.check_call(['pip', 'install', 'openpyxl'])  # 用于读写xlsx格式
用pandas处理考勤数据:
import pandas as pd

# 读取考勤数据
df = pd.read_excel("考勤数据.xlsx")

# 数据清洗:去除空行
df = df.dropna(subset=["员工姓名"])

# 数据统计:计算每个员工的出勤天数
attendance_summary = df.groupby("员工姓名").apply(lambda x: {
    "出勤天数": (x["出勤状态"] == "正常").sum(),
    "迟到次数": (x["出勤状态"] == "迟到").sum(),
    "早退次数": (x["出勤状态"] == "早退").sum(),
    "请假天数": (x["出勤状态"] == "请假").sum()
})

# 转换成DataFrame
result_df = pd.DataFrame.from_dict(attendance_summary, orient="index")

# 保存到Excel
result_df.to_excel("考勤统计结果.xlsx")
用Python调用HR系统API:
import requests
import json

# 登录HR系统获取token
login_url = "https://your-hr-system.com/api/login"
login_data = {
    "username": "hr_admin",
    "password": "your_password"
}

login_response = requests.post(login_url, json=login_data)
login_result = json.loads(login_response.text)
token = login_result["token"]

# 使用token调用API创建员工档案
create_url = "https://your-hr-system.com/api/employee/create"
headers = {"Authorization": "Bearer " + token}
employee_data = {
    "name": "张三",
    "phone": "13800001111",
    "email": "zhangsan@company.com",
    "department": "技术部",
    "position": "软件工程师",
    "join_date": "2024-01-15"
}

create_response = requests.post(create_url, headers=headers, json=employee_data)
create_result = json.loads(create_response.text)

if create_result["success"]:
    print("员工档案创建成功:" + create_result["employee_id"])
else:
    print("员工档案创建失败:" + create_result["message"])
十二、系统联动:飞书通知与定时任务
HR流程执行完之后,通常需要通知相关人员。影刀RPA可以对接飞书,自动发送消息通知。
飞书消息通知配置: 用"飞书-发送消息"指令,填写应用App ID和App Secret,然后填写接收人的open_id和消息内容。
新员工入职通知:
姓名:张三
部门:技术部
职位:软件工程师
入职日期:2024-01-15
企业邮箱:zhangsan@company.com
请及时安排入职培训。
飞书多维表格记录员工信息: 每次录入新员工信息后,把员工信息写到飞书多维表格里,方便后续跟踪员工状态。用"飞书多维表格-添加记录"指令,填写表格ID和字段值。
定时任务配置: 如果要每天自动统计前一天的考勤数据,用"定时任务"指令。设置触发方式为"按CRON表达式",比如"0 9 * * *"表示每天早上9点执行。
常见报错速查表:
| 报错信息 | 原因 | 解决方法 |
|---|---|---|
| 元素超时未出现 | 页面加载慢或网络延迟 | 增加等待时间,或用等待元素出现指令 |
| 输入框填写失败:元素不可交互 | 输入框被禁用或被遮挡 | 用图像识别点击,或用JavaScript直接修改value |
| OCR识别结果不准确 | 图片分辨率低或倾斜 | 提高分辨率,校正倾斜,锐化图片 |
| Can not convert Array to String | Excel某单元格是数组 | 用"列表转换为文本"指令转换 |
| 文件已被另一个进程使用 | Excel文件被占用未关闭 | 每次循环结束前关闭Excel文件 |
| KeyError: '姓名' | 字典里没有'姓名'这个键 | 用dict.get('姓名',默认值)方式安全取值 |
#影刀RPA #人事HR自动化 #简历解析 #考勤统计 #入职流程 #RPA教程 #新手入门 #自动化办公 #HR自动化
作者:林焱