

花一万二买4090跑大模型,三个月后我看了眼电费单,人麻了
那天晚上十一点,我蹲在工位底下理线,老板从上面路过,低头看了我一眼说:"badhope,你又在搞什么?"
我说:"装机。"
他说:"你不是有工位电脑吗?"
我说:"那个跑不了大模型。"
他翻了个白眼走了。我当时觉得他不懂技术,现在想想,他可能只是比我更早看透了这件事的本质。
我叫badhope,三线城市小厂搬砖工,月薪刚够吃饭。但上个月我做了一件让所有人都觉得我疯了的事——花一万二买了块RTX 4090。
理由很充分:我要在本地跑大模型。ChatGPT要翻墙,API要花钱,数据安全没保障。本地部署,一切尽在掌控。
多完美的逻辑。
直到三个月后,我蹲在电表前面,看着那个数字以肉眼可见的速度往上蹿,才意识到一个问题:
⚠️ 我不是在拥抱AI未来,我是在给黄仁勋打工。
更扎心的是,我后来算了一笔账,发现花在这块显卡上的钱,够雇两个实习生干一年——他们还自带电脑。
这篇文章不是来劝你别用本地大模型的。是来帮你算一笔你一直不敢算的账。
一、事情的起因:一个程序员的AI焦虑
先说说我为什么会走上这条路。
我们公司是个三十多人的小厂,做企业内部系统的。老板前阵子参加了个饭局,回来就跟我说:"badhope,现在AI很火,咱们也搞一个,能不能搞个本地的大模型,不花钱的那种?"
你看,"不花钱的那种"——这句话就是一切悲剧的起点。
我当时也是上头了。心想这不就是我的机会吗?在公司搞个大模型,从此我就是AI负责人,升职加薪走上人生巅峰。
于是我开始了调研。先看了ChatGPT的API,按量付费,看起来不贵。但老板说了,数据不能出去,公司内部数据有保密要求。
那就本地部署。
查了一圈,跑个7B模型至少要8GB显存,跑个像样的得24GB。RTX 4090,24GB GDDR6X,完美。
淘宝搜了一下价格:12000块。
我咽了口口水,刷了信用卡。
显卡到的那天,我像过年一样。拆箱、装机、装驱动、装CUDA、装PyTorch、下模型权重。折腾到凌晨三点,终于在终端里看到了模型吐出的第一个回复:
User: 你好
Model: 你好!有什么可以帮助你的吗?
我激动得差点从椅子上蹦起来。那一刻,我觉得自己站在了技术的最前沿。
然而,前沿的空气里,弥漫着一股焦糊味——是显卡散热硅脂在高温下散发出来的。
那是代价的味道。
二、血亏账本:你的显卡每天吃掉多少钱?
兴奋劲儿过了之后,现实开始一点一点地显现。
❌ 电费——真正的隐形杀手
第一个信号是电费。
我租的房子是商电,0.8元一度。以前每月电费七八十块,装了4090之后,直接飙到两百多。我当时还以为是电表坏了,叫房东来看,房东看了一眼我那嗡嗡作响的机箱,说:"这玩意儿比空调还费电。"
我不信,回去认真算了一笔账。
显卡满载功率:450W
CPU+主板+其他:150W
总功率:600W
每天开机时长:10小时
日耗电:6度
电价(阶梯/商电):0.8元/度
日电费:4.8元
月电费:144元
年电费:1728元
一年1728块,光电费。这还没算夏天显卡把房间烤成烤箱,不得不开空调降温的额外开销。
我又把其他成本列了张表,不列不知道,一列吓一跳:
| 成本项 | 金额 | 说明 |
|---|---|---|
| 显卡购置 | 12,000元 | RTX 4090,按3年折旧 |
| 年折旧费 | 4,000元 | 每天11元 |
| 年电费 | 1,728元 | 每天4.8元 |
| 散热空调费 | 600元/年 | 夏天显卡烤房间 |
| 时间成本 | 无法估量 | 调环境、修Bug、等推理 |
💡 你那块4090,哪怕只跑个7B模型,风扇也得转得像直升机起飞。显卡是有寿命的——显存颗粒、电容、散热硅脂,都在随着每次"推理"而老化。这叫"显卡折旧税"。
折旧这个事儿很多人没概念。显卡不像CPU,CPU你正常用个五六年性能几乎不衰减,但显卡不一样。
显卡满载跑大模型的时候,显存温度能到90度以上,VRAM颗粒在反复的高温循环中加速老化。你以为你买了块显卡能用五年,实际上高强度跑模型两年半就得开始担心花屏、死机、显存报错了。
二手市场那些"女生自用99新"的4090,你猜有多少是拿去挖矿或者跑模型之后出掉的?
三年总成本:约19,000元。
这还没算你因为调试Bug到凌晨三点、发际线后移两厘米的精神损失费。
📌 我当时算完这笔账,盯着屏幕发了五分钟的呆。
一万九。我一个月工资才多少?
三、碳基vs硅基:谁才是真正的生产力?
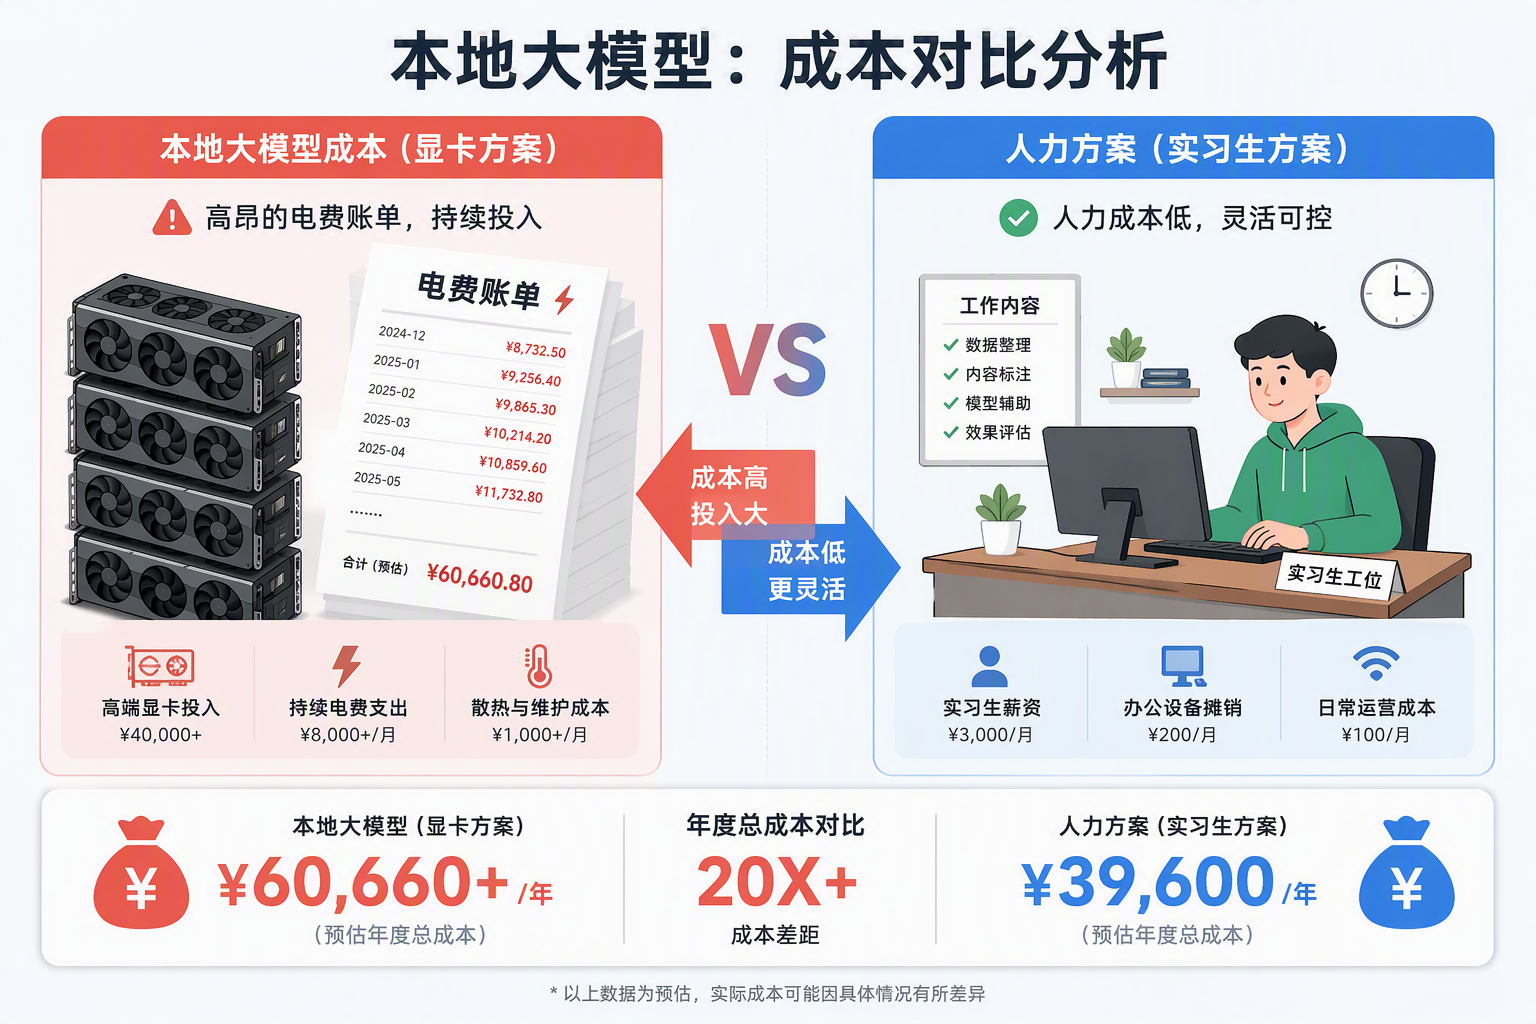
光算成本还不够直观,关键是产出。花了一万九,到底能干啥?
我决定拿身边最廉价的劳动力——实习生小王,来做一次正面PK。
✅ 场景1:处理Excel表格
老板让处理一份三千行的销售数据,做个透视表加图表。
我先丢给本地跑的Qwen-7B,模型吭哧吭哧跑了三分钟,吐出来一段Python代码。我拿去一跑,报错——pandas版本不对。改了版本再跑,又报错——列名对不上。
折腾了半小时,最后还是自己手动写的。
小王呢?噼里啪啦五分钟,透视表、图表、格式刷,全套搞定。还顺手把异常值标红了。
| 对比维度 | 本地大模型 | 实习生 |
|---|---|---|
| 响应时间 | 风扇狂转3分钟 | 噼里啪啦5分钟 |
| 处理结果 | "上下文长度溢出" | 透视表+图表+格式刷好了 |
| 你的感受 | 还得自己改 | "哥,做好了" |
| 评价 | 人工智障 | 即插即用 |
❌ 场景2:写代码
我让模型写一个用户登录接口。它写得有模有样,JWT、密码加密、错误处理,该有的都有。
但我一跑——SQL注入漏洞。它把用户输入直接拼进了SQL语句里。
我让它改,它改了,又改出了别的问题。来回拉扯了五六轮,我索性自己重写了。
小王写的虽然烂点,变量命名跟乱码似的,但至少能跑。而且你说"这里有个Bug",他会说"哥,我这就改",改完还给你买杯奶茶。
| 对比维度 | 本地大模型 | 实习生 |
|---|---|---|
| 代码质量 | 看着像回事,一跑全是Bug | 虽然烂点,但能跑 |
| 修改态度 | 你改它还是它改你? | "哥,我这就改" |
| 情绪价值 | 零 | 还能陪你吐槽产品经理 |
❌ 场景3:数据可信度
这个最致命。
有一次我让模型帮我分析一份用户画像数据,它给我整了一份漂亮的报告,各种占比、趋势、结论,看着特别专业。
我拿去给老板汇报。老板看完问了一句:"这个'35-40岁用户占比62%'的数据,原始数据里有吗?"
我回去一查,原始数据里根本没有这个年龄段。模型编的。
一本正经,胡说八道。
| 对比维度 | 本地大模型 | 实习生 |
|---|---|---|
| 出错率 | 一本正经胡说八道(幻觉) | 不懂就是不懂 |
| 责任归属 | AI犯错你背锅 | 实习生犯错实习生背锅 |
| 老板反应 | "数据哪来的?"→"AI编的"→毕业 | "重写!"→"好的哥" |
🔥 你用本地大模型的结果去汇报工作,老板问你数据哪来的,你说"AI编的"。老板当场让你"毕业"。而实习生犯错?那当然是实习生背锅啊!这才是成熟的职场生态!
小王如果不确定一个数据,他会说"哥,这个我不确定,你再看看"。模型不会。模型永远自信满满,哪怕它在胡扯。
这种"自信的错误"比"诚实的无知"危险一百倍。
四、那API调用到底多少钱?我帮你算了
说到这儿,肯定有人要问:那我不自己部署,直接调API呢?
我专门去查了几个主流大模型API的价格,整理如下:
DeepSeek-V3 API(2024年定价):
  输入:0.5元/百万tokens(缓存命中0.1元)
  输出:2元/百万tokens

通义千问Qwen-Max API:
  输入:2元/百万tokens
  输出:6元/百万tokens

GPT-4o API(海外):
  输入:$2.5/百万tokens(约18元)
  输出:$10/百万tokens(约72元)

Claude 3.5 Sonnet API:
  输入:$3/百万tokens(约21元)
  输出:$15/百万tokens(约108元)
看起来按量付费很贵?来算笔账。
🚀 假设你每天调用100次,每次平均输入2000 tokens、输出1000 tokens。以DeepSeek-V3为例:
日输入成本:100 × 2000 / 1000000 × 0.5 = 0.1元
日输出成本:100 × 1000 / 1000000 × 2 = 0.2元
日总成本:0.3元
月总成本:9元
年总成本:108元
一年108块。
而我本地部署一年光折旧加电费就5700多块。
就算你把调用频率翻十倍,每天调1000次,一年也才1080块。还是比本地部署便宜五倍以上。
而且API调用你不用管显卡散热、不用装CUDA、不用修环境冲突、不用凌晨三点爬起来看模型为什么突然OOM。
更关键的是——API的模型质量远超你本地能跑的7B模型。人家云端跑的是几百B参数的满血版,你本地那24GB显存只能跑个阉割版,能力差了好几个量级。
| 对比维度 | 本地部署7B | API调用(满血版) |
|---|---|---|
| 年成本 | 5,700元+ | 108-1,080元 |
| 模型质量 | 阉割版 | 满血版 |
| 维护成本 | 高(环境/散热/Bug) | 零 |
| 数据隐私 | 完全本地 | 数据需传输(可加密) |
| 可用性 | 看你显卡心情 | 99.9% SLA |
唯一的劣势就是数据隐私。但说实话,你一个三线城市小厂的企业内部系统,有多少数据是真正需要保密到连加密传输都不行的?
五、真相与选择:你是在用AI还是被AI用
⚠️ 消费主义陷阱

说到这儿,我得聊聊一个更深层的东西。
这事儿挺讽刺的。
我们一方面喊着"人口红利消失",一方面疯狂崇拜用昂贵的硅基芯片去替代廉价的人力。为什么?
| 硅基"优点" | 真相 |
|---|---|
| 不需要休息 | 但需要散热和维护 |
| 没有情绪 | 但有"幻觉" |
| 只需要电费 | 电费比实习生工资还贵 |
| 不会维权 | 但会宕机,而且总是在最关键的时候 |
你以为你在用AI,其实你是这条链路最底层的"矿工":
- 你是英伟达的矿工——花大价钱买显卡,黄仁勋的皮衣有你一份功劳
- 你是电力公司的矿工——每月老老实实交电费,电网公司感谢你的贡献
- 你是开源社区的免费测试员——帮忙找Bug、提Issue,别人拿你的反馈去完善模型然后收费
你看着那个黑框框里跑出来的字,就像看着一个永远不喊累、永远不顶嘴的"电子宠物"。但在这个游戏里,你才是被收割的那个。
最骚的是什么?是消费主义给你植入的那套话术。
"真正的程序员就该自己跑模型。""用API算什么本事?""本地部署才是真正的技术极客。"
这套话术的核心目的,就是让你心甘情愿地掏钱买硬件,然后觉得自己在追求技术理想。
你买了一万二的显卡,本质上和那些花三万买游戏本的大学新生没有区别——都是在为一种身份认同买单。
只不过他们买的是"游戏玩家"的标签,你买的是"AI极客"的标签。
标签不便宜。一万二呢。
✅ 本地大模型到底值不值得用?
说了这么多,不是让你把显卡扔了。本地大模型确实有其不可替代的场景,关键是你得搞清楚自己到底属不属于这些场景。
| 适合本地部署 | 不适合本地部署 |
|---|---|
| 数据隐私要求极高(医疗、金融) | 日常写代码、写文档 |
| 网络环境受限(内网、离线) | 处理Excel表格 |
| 需要微调专属模型 | 追求"极客优越感" |
| 有闲置GPU资源 | 还得专门买显卡 |
📌 关键看ROI。如果你公司本来就有GPU集群,跑本地模型是锦上添花。如果你是个人开发者,花一万多买显卡就为了跑个7B模型——这钱拿去雇个实习生,性价比高10倍。
我自己反思了一下,当时买4090的决策过程是这样的:
老板说"搞个本地大模型不花钱" → 我信了 → 买显卡 → 发现花钱如流水 → 老板说"怎么电费报销多了这么多" → 我说"跑模型耗电" → 老板说"那要不别跑了" → 我:???
整个链条里,唯一获益的是英伟达。
我现在把4090挂了闲鱼。标价九千五,挂了两周,砍到八千二才有人问。三个月亏了将近四千块。
六、理性选择:最后的账
💡 不同人群的AI方案推荐
吃一堑长一智。我把踩过的坑总结成一张推荐表,各位对号入座:
| 你的角色 | 推荐方案 | 月成本 | 理由 |
|---|---|---|---|
| 个人开发者 | 云端API(DeepSeek/通义) | 10-50元 | 按量付费,用多少花多少 |
| 创业小团队 | 云端API + 实习生 | 2000-3000元 | AI做重复活,人做创造性活 |
| 有GPU的企业 | 本地部署 + 云端API兜底 | 已有硬件成本 | 隐私数据本地跑,通用任务走云 |
| 学生党 | 免费API额度 | 0元 | 各平台都有学生免费额度 |
本地大模型不是不好,是"杀鸡用牛刀"。你不需要为了煮一碗泡面去买一口工业级大锅。
补充几点实操建议:
第一,先试API再考虑本地。 很多人连API都没调过,上来就要买显卡部署本地模型。这就像你连外卖都没点过,就要买一口锅自己学炒菜。先花十块钱调调API,感受一下大模型的能力边界,再决定要不要投入硬件。
第二,算清楚TCO再下单。 TCO就是总拥有成本(Total Cost of Ownership),不只是买显卡的钱。电费、散热、折旧、维护时间、机会成本,全部加起来算。我上面那张表就是TCO的简化版,19,000块三年。
第三,分清"需要"和"想要"。 你是真的需要本地部署,还是觉得有个4090很酷?如果是后者,我没意见,花钱买快乐天经地义。但别把快乐包装成"技术投资"。
✅ 核心认知钉死
最后再拉一张总表:
| 核心认知 | 一句话 |
|---|---|
| 本地部署的真实成本 | 3年约19,000元,比雇实习生还贵 |
| AI vs 人的本质区别 | AI犯错你背锅,人犯错人背锅 |
| 你以为你在用AI | 其实你是显卡厂商和电力公司的矿工 |
| 正确姿势 | 按场景选择,别为了"极客感"花冤枉钱 |
技术是工具,不是信仰。当你为了"本地部署"的优越感而忽视经济成本时,你就已经掉进了消费主义的陷阱。
📌 真正的技术人,不是用最贵的设备跑最酷的模型,而是用最合理的方案解决最实际的问题。至于那块4090——趁现在还能卖个好价钱,考虑考虑?
我现在闲鱼上那块4090终于卖出去了。买家是个大学生,说是要拿去跑Stable Diffusion画图。
我劝他也算笔账。他说没事,他宿舍电费不用自己交。
你看,这才是真正的赢家——有人替你交电费的时候,本地部署的ROI就成立了。
所以最后的结论很简单:如果你宿舍电费不用自己交,买。
否则,老老实实调API。
——badhope,写于显卡卖掉的第二天,电表终于安静了的夜晚

