

水牛先生(广西) 是一家以互联网渠道销售牛奶等乳品的公司,业务依托自主开发的线上系统运行。随着业务持续增长,数据库里的数据也在不断积累。团队一方面需要做好生产数据的备份与灾备,另一方面,BI 报表也需要用这些业务数据进行日常查询和分析。
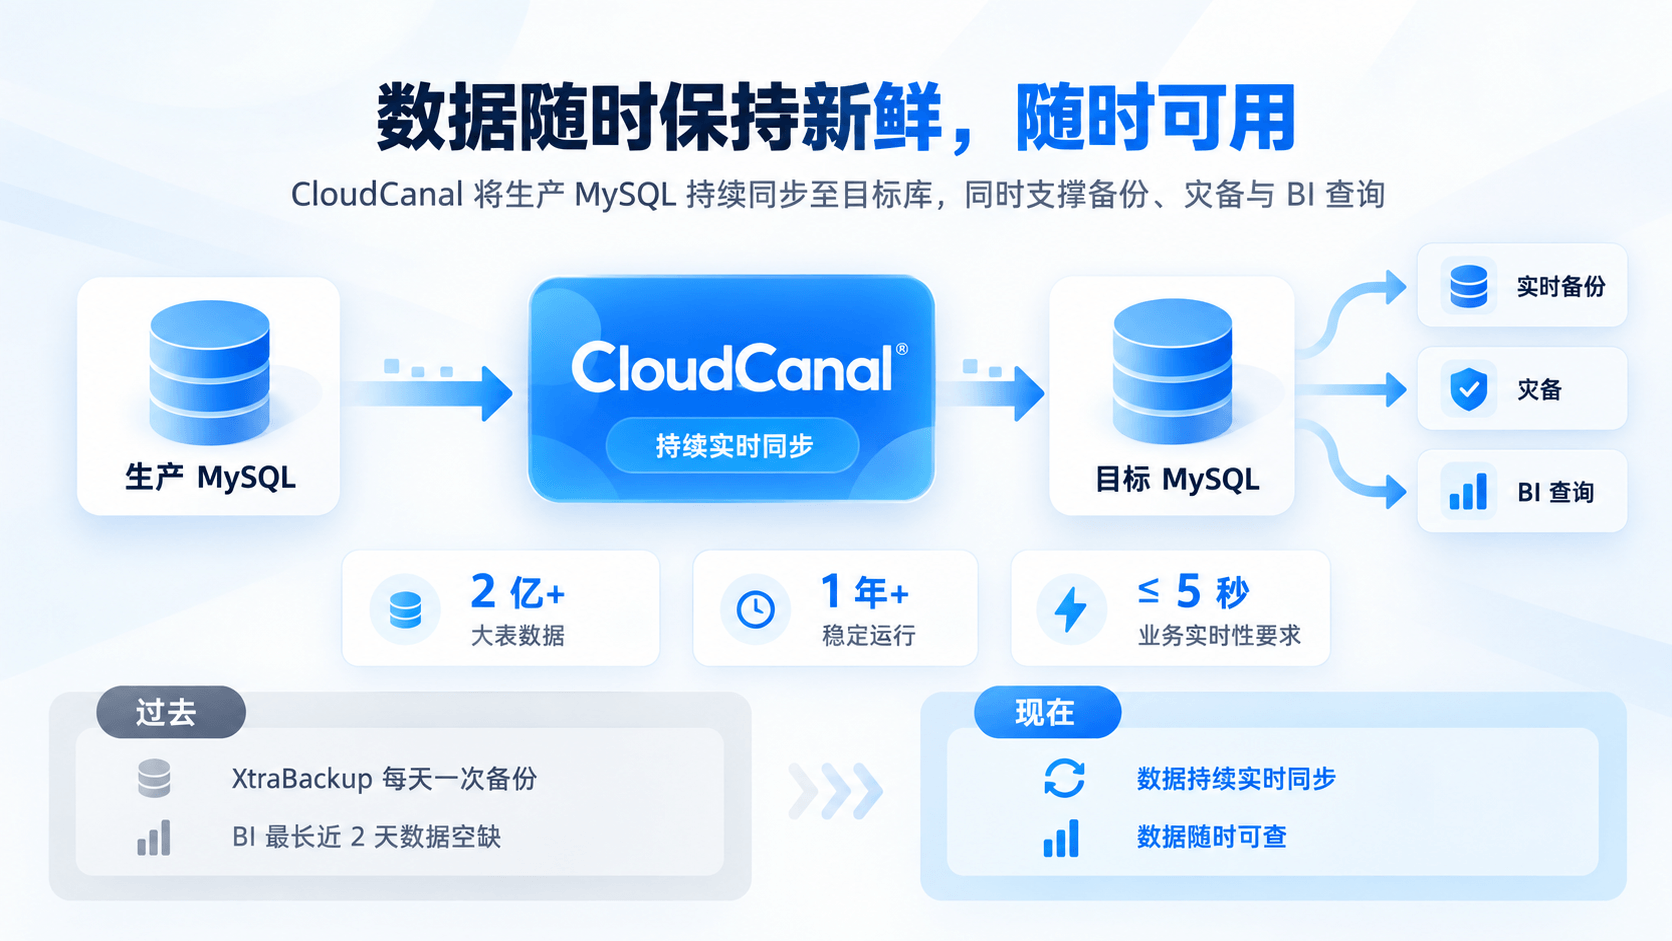
目前公司的核心业务数据主要存储在 MySQL 中,CloudCanal 负责在两套 MySQL 数据库之间建立实时同步链路。目标数据库 MySQL 同时承担实时备份、灾备以及 BI 查询的工作。
现在,同步链路已经稳定运行一年多,数据延迟始终控制在 5 秒内,保证数据随时可用。
从每天备份,到持续实时同步
在引入 CloudCanal 之前,团队主要通过 XtraBackup 每天固定执行一次数据备份。
对于基础的数据备份需求,这种方式已经足够了。但由于 BI 报表也依赖备份后的数据,数据什么时候能被看到,很大程度上取决于 XtraBackup 的执行时间以及后续的数据还原进度。
实际使用中,BI 数据有时会存在接近两天的数据空缺。业务人员虽然可以查询报表,但看到的往往并不是最新数据,分析和决策也不得不跟着备份与还原的节奏走。
随着 BI 对数据时效性的要求提高,团队希望将生产库 MySQL 的变化持续同步到目标库,而不是等待下一次备份和恢复,数据延迟希望保持在 5 秒以内。
为什么最终选择 CloudCanal
确定需要实时同步之后,团队也考虑过 Flink CDC、Canal 等方案。
从技术上看,自行搭建 CDC 链路并不是不可行,但对于业务团队来说,技术方案能不能实现只是其中一个考虑,更现实的问题是需要投入多少研发和维护成本。
如果自行搭建实时同步链路,除了数据同步本身,还需要考虑源端和目标端连接、任务配置、全量数据初始化、增量任务衔接、任务状态监控,以及运行过程中出现异常后的处理。链路一旦进入长期生产运行,后续的维护成本往往比研发成本更高。
而团队本身没有时间去开发维护一套自建 CDC 系统。因此,在对比方案之后,他们最终选择 CloudCanal,主要原因就是 开箱即用。
相比自行搭建数据同步链路,CloudCanal 将任务配置、同步运行和日常管理集中到一个平台,让团队可以更快建立 MySQL 到 MySQL 的实时同步链路,也减少了后续自建和维护 CDC 系统的投入。
方案与落地:一条简单、轻量的实时链路
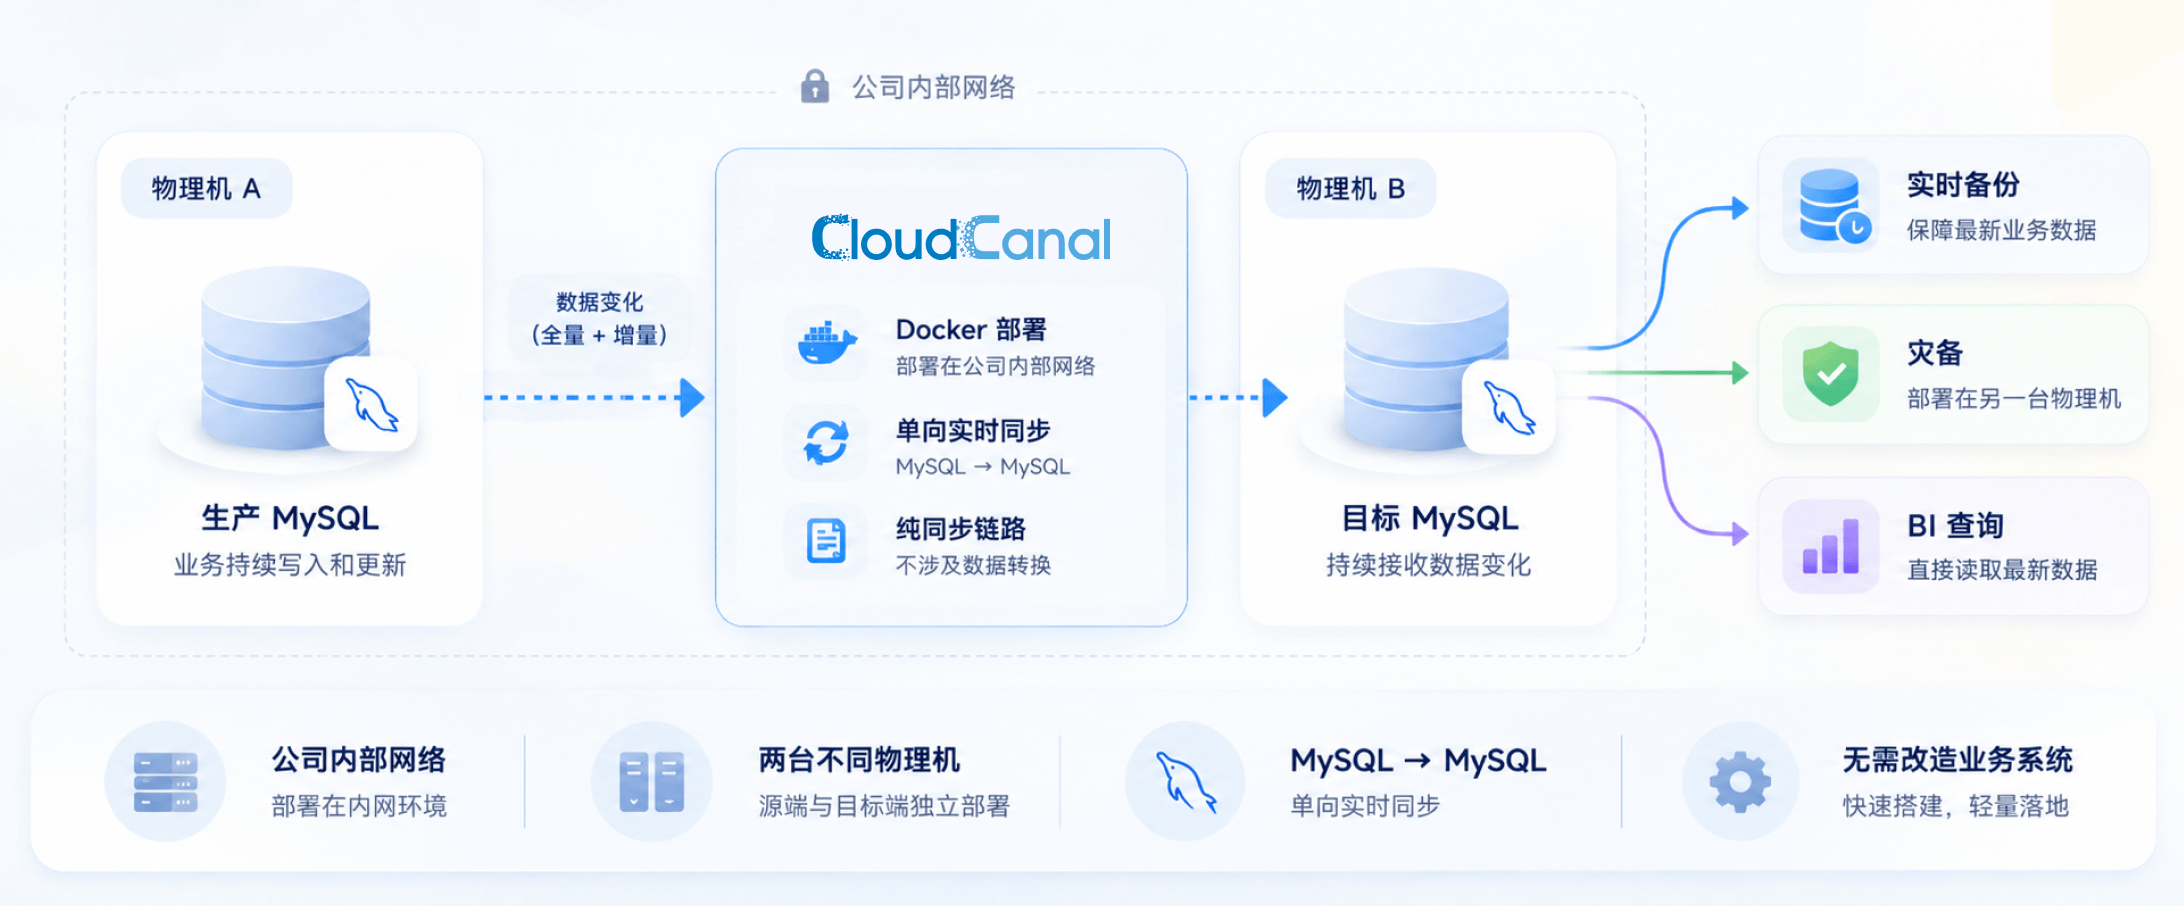
这条链路的结构并不复杂。CloudCanal 以 Docker 方式部署在公司内部网络中,在两台物理机之间建立 MySQL 到 MySQL 的单向实时同步,过程中无需改造现有业务系统。
目标端 MySQL 一套数据同时承担三类用途:实时备份、灾备,以及 BI 查询。一份目标数据支撑多种场景,既满足了对生产数据的保护需求,也让 BI 有了稳定的数据来源。
效果:BI 从天级更新到实时,大表稳定运行一年多
CloudCanal 上线后,目标 MySQL 可以持续接收生产库的数据变化,BI 查询不再需要等待下一次 XtraBackup 执行和数据还原,可以直接读取最新数据。
| 维度 | 使用 CloudCanal 之前 | 使用 CloudCanal 之后 |
|---|---|---|
| 数据更新方式 | XtraBackup 每天一次增量备份 | CloudCanal 实时同步,延迟 ≤ 5 秒 |
| BI 数据时效 | 最极端时近两天数据空缺 | 实时查看最新数据 |
| 实时同步能力 | 需自研 Flink CDC / Canal,无研发时间 | 开箱即用,无需自研维护 |
| 目标库查询方式 | 数据在备份里,需还原后才能查询 | 目标库持续可查,同时支撑备份、灾备与 BI |
| 运维难度 | 备份脚本、保留策略与恢复流程都需自行维护,恢复依赖人工操作,耗时随数据量增长 | 配置与运行集中在平台,任务状态随时可查,日常只需定时巡检 |
这条链路已持续服务备份、灾备和 BI 场景一年多,其中一张 MySQL 表的数据量接近 2 亿条。日常只需要一名运维人员定时查看任务运行状态,团队可以把更多时间投入到业务系统本身,不用长期维护底层同步链路。业务数据仍在持续增长,这条链路也具备继续支撑更大数据量的能力。
小结
这次数据链路的架构并不复杂,但解决的问题很典型。
过去,团队通过每天一次 XtraBackup 保留数据副本,BI 也只能跟着备份和还原节奏获取数据。引入 CloudCanal 后,MySQL 数据开始持续同步到目标库,原本可能存在近两天空缺的数据,现在可以实时更新。
对于水牛先生团队来说,CloudCanal 带来的变化很明显,让团队在不额外投入研发资源自建 CDC 的情况下,把原本周期性的数据库备份,升级成了一条长期稳定运行的实时数据链路,让数据随时保持新鲜、随时可用。

