复杂度 ——《机器学习理论导引》第三章学习笔记

286 阅读8分钟

《机器学习理论导引》笔记目录

0 感言

    代码调累了,主要还是现在没有找到合适的数据集,就让人很头大,感觉一切都像停滞了一样。希望一切好起来吧。

    终于在写完论文处理完大大小小的事情后重新开始进行学习,希望能够忽略一切的影响,全情投入自己想做的事情。这章比较难,笔记也分为上下两部分。

补更感想

    感觉这一章复杂度的讲解还是挺难挺抽象的,认识的朋友还有问我为啥最近更得慢的,说来还是因为很多写了一半第二次写的时候还要重温前面的内容。不过感谢组里学长的PPT,做得非常非常细致化,相较于原本就写得挺不错的书的基础上,逻辑层次更为清晰,所以其实我主要还是在学长的PPT的基础上进行复制粘贴整理优化。慢慢理解才是真。

    以及阅读进度我也进行了调整,截至开学前,以后每周大概抽两天的时间来进行这种基础的补充和学习,也就大概是更一章左右,然后把更多时间看论文和逐步开始做自己的工作。

3.1 数据分布无关

一些前置概念

  • 考虑二分类问题,H\mathcal{H} 为假设空间,其中假设是 X\mathcal{X} 到 Y={−1,+1}\mathcal{Y}=\{−1,+1\}的映射
  • 限制 (restriction)
    • 定义:对于数据集 D={x1,...,xm}⊂XD=\{\bold{x}_1,...,\bold{x}_m\}\subset \mathcal{X},H\mathcal{H} 在数据集 D 上的限制是从 D 到 {−1,+1}m\{-1,+1\}^m 的一族映射,其中 h 在 D 上的限制是一个 m 维向量。
    H∣D={(h(x1),...,h(xm))∣h∈H}\mathcal{H}_{|D}=\left\{\left(h(\bold{x}_1),...,h(\bold{x}_m)\right)|h\in\mathcal{H}\right\}
    • 意义:引入具体的数据集 D,从而将无限转化为有限
  • 增长函数 (growth function)
    • 定义:
    ΠH(m)=max⁡{x1,...,xm}⊂X⁡∣{(h(x1),...,h(xm))}∣h∈H∣\Pi_{\mathcal{H}}(m)=\max_{\{\bold{x}_1,...,\bold{x}_m\}\subset\mathcal{X}}⁡|\left\{\left(h(\bold{x}_1),...,h(\bold{x}_m)\right)\right\}|h\in\mathcal{H}|
    • 意义:一定程度上描述了假设空间 H\mathcal{H} 的表示能力,反映了它的复杂度
    • 联系:增长函数 ΠH(m)\Pi_{\mathcal{H}}(m) 表示假设空间 H\mathcal{H},
    ΠH(m)=max⁡∣D∣=m∣H∣D∣ \Pi_{\mathcal{H}}(m)=\max_{|D|=m}|\mathcal{H}_{|D}|
  • 对分 (dichotomy)
    • 定义:假设空间 H\mathcal{H} 中的假设对 D 中的样本赋予标记的每种可能结果
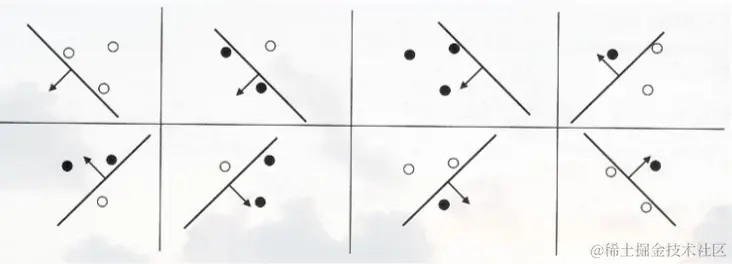
  • 打散 (shattering)
    • 定义:如果假设空间 H\mathcal{H} 能实现样本集 D 上的所有对分,那么称样本集 D 可以被假设空间 H\mathcal{H} 打散

图例1.打散的示意图

二分类任务-VC 维

  • 定义:假设空间 H\mathcal{H} 的 VC 维定义为能被 H\mathcal{H} 打散的最大样本集的大小
VC(H)=max⁡{m:ΠH(m)=2m}VC(\mathcal{H})=\max\{m:\Pi_{\mathcal{H}}(m)=2^m\}
  • 等价推论:假设空间 H\mathcal{H} 的 VC 维等于d
    • 存在大小为 d 的样本集 D 能被 H\mathcal{H} 打散
    • 任意大小为 d+1 的样本集 D' 都不能被 H\mathcal{H} 打散
  • 一些简单的示例
    • 阈值函数—— VC 维为1
      • 定义阈值函数为 ha(x)=sign(I(x<a)−12)h_a(x)=\text{sign}(\mathbb{I}(x<a)-\frac{1}{2})
      • 设 H\mathcal{H} 为 R\mathbb{R} 上的所有阈值函数,即 H={ha:a∈R}\mathcal{H}=\{h_a:a\in\mathbb{R}\}
      • 易知存在样本大小1的样本集 D 可以被 H\mathcal{H} 打散
      • 对于任意样本大小2的样本集 D={x1,x2}D=\{x_1,x_2\},考虑x1<x2x_1<x_2,那么 ha(x1)=−1,ha(x2)=+1h_a(x_1)=-1,h_a(x_2)=+1 的情况无法实现
    • 区间函数—— VC 维为2
      • 定义区间函数为 ha,b(x)=sign(I(x∈(a,b))−12)h_{a,b}(x)=\text{sign}(\mathbb{I}(x\in(a,b))-\frac{1}{2})
      • 令 H\mathcal{H} 表示所有 R\mathbb{R} 上区间函数所组成的集合,即 H={ha,b:a,b∈R,a<b}\mathcal{H}=\{h_{a,b}:a,b\in\mathbb{R},a<b\}
      • 令 D={1,2}D=\{1,2\},易知 H\mathcal{H} 可以打散 D
      • 对于任意样本大小为 3 的样本集 D′={x1,x2,x3}D'=\{x_1,x_2,x_3\},不妨设 x1<x2<x3x_1<x_2<x_3,那么分类结果 (+1,−1,+1)(+1,−1,+1) 不能被任何区间函数实现
  • 优势
    • 令假设空间 H\mathcal{H} 为有限集合。对于任意数据集 D,会有 ∣H∣D∣≤∣H∣|\mathcal{H}_{|D}|\le|\mathcal{H}|
    • 又因为当 ∣H∣<2∣D∣|\mathcal{H}|<2^{|D|},H\mathcal{H} 无法打散 D。因此可得 VC(H)≤log⁡2∣H∣VC(\mathcal{H})\le\log_2|\mathcal{H}|
    • 并且有限假设空间的 H\mathcal{H} 的 𝑉𝐶(H)𝑉𝐶(\mathcal{H}) 通常小于 log⁡2∣H∣\log_2|\mathcal{H}|,因此使用 VC 维衡量有限假设空间的复杂度更为准确

Sauer引理和Suaer定理

  • (Sauer 引理) 若假设空间 H\mathcal{H} 的 VC 维为 d,则对任意 m∈Nm\in\mathbb{N} 有
ΠH(m)≤∑i=0dCmi\Pi_{\mathcal{H}}(m)\le\sum_{i=0}^dC_m^i
  • 证明
    • 利用数学归纳法。m=1,d=0m=1,d=0 或 m=1,d=1m=1,d=1 时引理成立。
    • 假设引理在 (m−1,d−1)(m−1,d−1) 和 (m−1,d)(m−1,d) 下成立
    • 令 D={x1,…,xm},D′={x1,…,x𝑚−1}D=\{x_1,…,x_m\},D'=\{x_1,…,x_{𝑚−1}\},有限制
    H∣D={(h(x1),...,h(xm))∣h∈H}H∣D′={(h(x1),...,h(xm−1))∣h∈H}\mathcal{H}_{|D}=\left\{(h(x_1),...,h(x_m))|h\in\mathcal{H}\right\}\\ \mathcal{H}_{|D'}=\left\{(h(x_1),...,h(x_{m-1}))|h\in\mathcal{H}\right\}
    • 假设 h∈Hh\in\mathcal{H} 对 xmx_m 的分类结果为+1或者-1,则任何出现在 H∣D′\mathcal{H}_{|D'} 的串都会在 H∣D\mathcal{H}_{|D} 中出现一次或者两次。令 HD′∣D\mathcal{H}_{D'|D} 表示 H∣D\mathcal{H}_{|D} 中出现两次的 H∣D′\mathcal{H}_{|D'} 中串组成的集合,即
    HD′∣D={(y1,...,ym−1∈H∣D′)∣∃h,h′∈H,(h(xi)=h′(xi)=yi)∧(h(xm)≠h′(xm)) i∈[m−1]}\mathcal{H}_{D'|D}=\{(y_1,...,y_{m-1}\in\mathcal{H}_{|D'})|\exists h,h'\in\mathcal{H},\\ (h(x_i)=h'(x_i)=y_i)\land(h(x_m)\ne h'(x_m))\ i\in[m-1]\}
    • 因为 HD′∣D\mathcal{H}_{D'|D} 中的串在 H∣D\mathcal{H}_{|D} 中出现了两次,但是在 H∣D′\mathcal{H}_{|D'} 中仅出现了一次,有
    ∣H∣D∣=∣HD′∣D∣+∣H∣D′∣|\mathcal{H}_{|D}|=|\mathcal{H}_{D'|D}|+|\mathcal{H}_{|D'}|
    • 因为 D′D' 的大小为 m-1,由归纳假设可知
    ∣H∣D′∣≤ΠH(m−1)≤∑i=0dCm−1i|\mathcal{H}_{|D'}|\le\Pi_{\mathcal{H}}(m-1)\le\sum_{i=0}^dC_{m-1}^i
    • 令 Q 表示能被 HD′∣D\mathcal{H}_{D'|D} 打散的集合,由 Q 的定义可知 Q∪{xm}Q\cup\{x_m\} 必能被 H∣D\mathcal{H}_{|D} 打散
    • 由于 H\mathcal{H} 的 VC 维为 d,因此 HD′∣D\mathcal{H}_{D'|D} 的 VC 维最大为d-1,所以有
    ∣HD′∣D∣≤ΠH(m−1)≤∑i=0d−1Cm−1i|\mathcal{H}_{D'|D}|\le\Pi_{\mathcal{H}}(m-1)\le\sum_{i=0}^{d-1}C_{m-1}^i
    • 综上可知
    ∣H∣D∣≤∑i=0dCm−1i+∑i=0d−1Cm−1i=∑i=0d(Cm−1i+Cm−1i−1)=∑i=0dCmi|\mathcal{H}_{|D}|\le\sum_{i=0}^dC_{m-1}^i+\sum_{i=0}^{d-1}C_{m-1}^i=\sum_{i=0}^d(C_{m-1}^i+C_{m-1}^{i-1})\\ =\sum_{i=0}^dC_m^i
  • (Sauer定理) 若假设空间 H\mathcal{H} 的 VC 维为 d,则对任意 m≥dm\ge d 有
    ΠH(m)≤(e⋅md)d\Pi_{\mathcal{H}}(m)\le\left(\frac{e\cdot m}{d}\right)^d
  • 证明
    ΠH(m)≤∑i=0dCmi≤∑i=0dCmi(md)d−i=(md)d∑i=0dCmi(dm)i≤(md)m∑i=0dCmi(dm)i=(md)d(1+dm)m=(md)d((1+dm)md)d≤(e⋅md)d\Pi_{\mathcal{H}}(m)\le\sum_{i=0}^dC_m^i\le\sum_{i=0}^dC_m^i\left(\frac{m}{d}\right)^{d-i}\\ =\left(\frac{m}{d}\right)^d\sum_{i=0}^dC_m^i\left(\frac{d}{m}\right)^i\le\left(\frac{m}{d}\right)^m\sum_{i=0}^dC_m^i\left(\frac{d}{m}\right)^i\\ =\left(\frac{m}{d}\right)^d\left(1+\frac{d}{m}\right)^m=\left(\frac{m}{d}\right)^d\left(\left(1+\frac{d}{m}\right)^{\frac{m}{d}}\right)^d\\ \le\left(\frac{e\cdot m}{d}\right)^d

多分类任务-Natarajan维

  • 定义
    • 假设空间中的假设变成了 X\mathcal{X} 到 Y={0,…,K−1}\mathcal{Y}=\{0,…,K−1\} 的映射
    • 打散
      • 对于任意给定的集合 D⊂XD\subset\mathcal{X},若假设空间 H\mathcal{H} 中存在两个假设 f0,f1:D→Yf_0,f_1:D\rightarrow\mathcal{Y} 满足以下条件
        • 对于任意 x∈Dx\in D,f0(x)≠f1(x)f_0(\mathbf{x})\ne f_1(\mathbf{x})
        • 对于任意集合 B⊂DB\subset D 存在 h∈Hh\in\mathcal{H} 使得
          ∀x∈B,h(x)=f0(x) and ∀x∈D∖B,h(x)=f1(x)\forall\mathbf{x}\in B,h(\mathbf{x})=f_0(\mathbf{x})\ and\ \forall\mathbf{x}\in D\setminus B,h(\mathbf{x})=f_1(\mathbf{x})
      • 则称集合 D 能被假设空间 H\mathcal{H} 打散
    • Natarajan维
      • 对于多分类问题的假设空间 H\mathcal{H},Natarajan维是能被 H\mathcal{H} 打散的最大样本集的大小,记为 Natarajan(H)Natarajan(\mathcal{H})
  • 定理 类别数 K=2K=2 时,VC(H)=Natarajan(H)VC(\mathcal{H})=Natarajan(\mathcal{H})
  • 证明
    • VC(H)≤Natarajan(H)VC(\mathcal{H})\le Natarajan(\mathcal{H})
      • 令 DD 表示大小为 VC(H)VC(\mathcal{H}) 且能被 H\mathcal{H} 二分类打散的集合
      • 取多分类问题打散定义中 f0=0,f1=1f_0=0,f_1=1
      • D 能被 H\mathcal{H} 二分类打散 ⇒\Rightarrow 对于任意集合 B⊂DB\subset D,存在 hBh_B 使得 x∈Bx\in B 时 hB(𝒙)=0h_B(\mathbf{𝒙})=0,x∈D∖Bx\in D\setminus B时 hB(x)=1h_B(\mathbf{x})=1
      • 所以 H\mathcal{H} 能在多分类问题的语境下打散大小为 VC(H)VC(\mathcal{H}) 的 D
    • VC(H)≥Natarajan(H)VC(\mathcal{H})\ge Natarajan(\mathcal{H})
      • 令 D 表示大小为 Natarajan(H)Natarajan(\mathcal{H}) 且在多分类问题中能被 H\mathcal{H} 打散的集合
      • 对于 D 上的任意一种对分 g:D→Yg:D\rightarrow\mathcal{Y},令 D+={x∈D│g(x)=1},D−={x∈D∣g(x)=0}D^+=\{\mathbf{x}\in D│g(\mathbf{x})=1\},D^−=\{\mathbf{x}\in D|g(\mathbf{x})=0\},则我们只需证明存在 h∈Hh\in\mathcal{H} 能实现该对分,即 ∀x∈D,h(x)=g(x)\forall\mathbf{x}\in D,h(\mathbf{x})=g(\mathbf{x})
      • 当 K=2K=2 时,f0,f1:D→Y={0,1}f_0,f_1:D\rightarrow \mathcal{Y}=\{0,1\},令 Diy=x∈D│fi(x)=y,i∈{0,1},y∈YD_i^y={\mathcal{x}\in D│f_i(\mathcal{x})=y},i\in\{0,1\},y\in\mathcal{Y}
      • 取多分类问题打散定义中的 B=(D+∩D01)∪(D−∩D00)B=(D^+\cap D_0^1)\cup(D^-\cap D_0^0),由多分类问题中的打散定义可知 ∃h∈H,∀x∈B,h(x)=f0(x) 𝑎𝑛𝑑 ∀x∈𝐷∖B,h(x)=f1(x)\exists h\in\mathcal{H},\forall \mathbf{x}\in B,h(\mathbf{x})=f_0(\mathbf{x})\ 𝑎𝑛𝑑\ \forall\mathcal{x}\in 𝐷\setminus B,h(\mathcal{x})=f_1(\mathcal{x})
      • 由于 ∀x∈D,f0(x)≠f1(x)\forall\mathcal{x}\in D,f_0(\mathbf{x})\ne f_1(\mathbf{x}),通过计算可知 ∀x∈B,g(x)=f0(x) 𝑎𝑛𝑑 ∀x∈D∖B,g(x)=f1(x)\forall\mathbf{x}\in B,g(\mathbf{x})=f_0 (\mathbf{x})\ 𝑎𝑛𝑑\ \forall\mathbf{x}\in D\setminus B,g(\mathbf{x})=f_1(\mathbf{x})
      • 从而有 ∀x∈D,h(x)=g(x)\forall\mathbf{x}\in D,h(\mathbf{x})=g(\mathbf{x}),即 H\mathbf{H} 能二分类打散大小为 Natarajan(H)Natarajan(\mathcal{H}) 的 D。
  • 定理 若多分类问题假设空间 H\mathcal{H} 的 Natarajan维为d,类别数为K,则对于任意的 m∈Nm\in\mathbb{N},有
    ΠH(m)≤mdK2d\Pi_{\mathcal{H}}(m)\le m^dK^{2d}
  • 证明
    • 利用数学归纳法。当 m=1,d=0m=1,d=0 或 m=1,d=1m=1,d=1 时,定理成立。
    • 假设定理对 (m−1,d−1)(m−1,d−1) 和 (m−1,d)(m−1,d) 成立
    • 对于 D={x1,…,x𝑚},Y={0,...,K−1}D=\{\mathbf{x}_1,…,\mathbf{x}_𝑚\},\mathcal{Y}=\{0,...,K−1\},令
    Hk={h∈HD∣∣h(x1)=k}  (k∈{0,...,K−1})\mathcal{H}_k=\left\{h\in\mathcal{H}_{D|}|h(\mathbf{x_1})=k\right\}\ \ (k\in\{0,...,K-1\})
    • 基于 Hk\mathcal{H}_k 可以构造如下集合:
    Hij={h∈Hi∣∃h′∈Hj,h(xl)=h′(xl),2≤l≤m} (i≠j)Hˉ=H∣D−∪i≠jHij\mathcal{H}_{ij}=\left\{h\in\mathcal{H}_i|\exists h'\in\mathcal{H}_j,h(\mathbf{x_l})=h'(\mathbf{x_l}),2\le l\le m\right\}\ (i\ne j)\\ \bar{\mathcal{H}}=\mathcal{H}_{|D}-\cup_{i\ne j}\mathcal{H}_{ij}
    • 基于联合界不等式可知
    ∣H∣D∣≤∣Hˉ∣+∣∪i≠jHij∣≤∣Hˉ∣+∑i≠j∣Hij∣|\mathcal{H}_{|D}|\le|\bar{\mathcal{H}}|+|\cup_{i\ne j}\mathcal{H}_{ij}|\le|\bar{\mathcal{H}}|+\sum_{i\ne j}|\mathcal{H}_{ij}|
    • 基于 Hˉ\bar{\mathcal{H}} ̅的构造可知 Hˉ\bar{\mathcal{H}} ̅在 D−{x1}D-\{\mathbf{x_1}\} 上无预测结果相同的假设,且 Natarajan(Hˉ)≤dNatarajan(\bar{\mathcal{H}})\le d,根据归纳的前提假设可知
    ∣Hˉ∣≤ΠHˉ(m)=ΠHˉ(m−1)≤(m−1)dK2d|\bar{\mathcal{H}}|\le\Pi_{\bar{\mathcal{H}}}(m)=\Pi_{\bar{\mathcal{H}}}(m-1)\le(m-1)^dK^{2d}
    • 同时,Hij\mathcal{H}_{ij} 的Natarajan维最多为d−1,否则 H\mathcal{H} 的Natarajan维将超过d。同样可以根据 Hij\mathcal{H}_{ij} 在 D 上无预测结果相同的假设以及归纳的前提假设,有
    ∣Hij∣≤ΠHij(m)≤md−1K2(d−1) (i≠j)|\mathcal{H}_{ij}|\le\Pi_{\mathcal{H}_{ij}}(m)\le m^{d-1}K^{2(d-1)}\ (i\ne j)
    • 综上可得
    ∣H∣D∣≤∣Hˉ∣+∑i≠j∣Hij∣≤ΠHˉ(m−1)+∑i≠jΠHij(m)≤(m−1)dK2d+K2md−1K2(d−1)≤mdK2d|\mathcal{H}_{|D}|\le|\bar{\mathcal{H}}|+\sum_{i\ne j}|\mathcal{H}_{ij}|\le \Pi_{\bar{\mathcal{H}}}(m-1)+\sum_{i\ne j}\Pi_{\mathcal{H}_{ij}}(m)\\ \le(m-1)^dK^{2d}+K^2m^{d-1}K^{2(d-1)}\le m^dK^{2d}

3.2 数据分布相关

Rademacher 复杂度

  • 经验误差
    • 给定数据集 D={(x1,y1),...,(xm,ym)}D=\{(\mathbf{x}_1,y_1),...,(\mathbf{x}_m,y_m)\},h∈Hh\in\mathcal{H} 的经验误差为
    E^(h)=1m∑i=1mI(h(xi)≠yi)=1m∑i=1m1−yih(xi)2=12−12m∑i=1myih(xi)\hat{E}(h)=\frac{1}{m}\sum_{i=1}^m\mathbb{I}(h(\mathbf{x}_i)\ne y_i)=\frac{1}{m}\sum_{i=1}^m\frac{1-y_ih(\mathbf{x}_i)}{2}\\ =\frac{1}{2}-\frac{1}{2m}\sum_{i=1}^my_ih(\mathbf{x}_i)
    • 具有最小经验误差的假设是
    arg min⁡h∈H1m∑i=1myih(xi)\argmin_{h\in\mathcal{H}}\frac{1}{m}\sum_{i=1}^my_ih(\mathbf{x_i})
  • Rademacher 随机变量
    • 考虑随机变量 σi\sigma_i,它以 0.5 的概率取值 +1,以 0.5 的概率取值 -1。
  • 最小经验误差假设 (考虑随机噪声)
    Eσ[sup⁡h∈H1m∑i=1mσih(xi)]\mathbb{E}_\sigma\left[\sup_{h\in\mathcal{H}}\frac{1}{m}\sum_{i=1}^m\sigma_ih(\mathbf{x}_i)\right]
    • 该式与增长函数作用类似,体现了假设空间在数据集 D 上的表示能力,取值范围为 [0,1][0,1]
    • 当该式取值为1,则意味着对于任意 σ=(σ1,...,σm),σi∈{−1,+1}\mathbf{\sigma}=(\sigma_1,...,\sigma_m),\sigma_i\in\{−1,+1\}有
    sup⁡h∈H1m∑i=1mσih(xi)=1\sup_{h\in\mathcal{H}}\frac{1}{m}\sum_{i=1}^m\sigma_ih(\mathbf{x}_i)=1
    也就是说存在 h∈Hh\in\mathcal{H} 使得 h(xi)=σih(\mathbf{x}_i)=\sigma_i,ΠH(m)=2m\Pi_{\mathcal{H}}(m)=2^m,H 能打散 D
    • 如果假设空间中只有一个假设,那么该式取值为 0
  • 经验 Rademacher 复杂度
    • 考虑实值函数空间 F:Z→R\mathcal{F}:\mathcal{Z}\rightarrow\mathbb{R},令 Z={z1,...,zm}Z=\{z_1,...,z_m\},其中 zi∈Zz_i\in\mathcal{Z},那么函数空间 F\mathcal{F} 关于 𝑍 的经验 Rademacher 复杂度为
    R^Z(F)=Eσ[sup⁡f∈F1m∑i=1mσif(zi)]\widehat{\mathcal{R}}_Z(\mathcal{F})=\mathbb{E}_\sigma\left[\sup_{f\in\mathcal{F}}\frac{1}{m}\sum_{i=1}^m\sigma_if(z_i)\right]
    • 其中 𝑍 是一个给定集合,经验 Rademacher 复杂度衡量了函数空间 F\mathcal{F} 与随机噪声在 𝑍 上的相关性。
  • Rademacher 复杂度
    • 函数空间 F\mathcal{F} 关于 Z\mathcal{Z} 在分布 m 上的 Rademacher 复杂度为
    RZ(F)=EZ⊂Z:∣Z∣=m[R^Z(F)]\mathcal{R}_Z(\mathcal{F})=\mathbb{E}_{Z\subset\mathcal{Z}:|Z|=m}[\widehat{\mathcal{R}}_Z(\mathcal{F})]
    • 将 σi\sigma_i 所服从的均匀分布改成其他分布可以得到一些其他复杂度的定义

Rademacher复杂度——定理

  • 定理3.4 令 A⊂RmA\subset\mathbb{R}^m 为有限集合且 r=max⁡x∈A∥x∥r=\max_{\mathbf{x}\in A}\lVert \mathbf{x}\rVert 有
    Eσ[1msup⁡x∈A∑i=1mσixi]≤r2ln⁡∣A∣m\mathbb{E}_\sigma\left[\frac{1}{m}\sup_{\mathbf{x}\in A}\sum_{i=1}^m\sigma_ix_i\right]\le\frac{r\sqrt{2\ln|A|}}{m}
    其中 x=(x1;...;xm)\mathbf{x}=(x_1;...;x_m),σi\sigma_i为 Rademacher 随机变量
  • 证明
    • 对于任意 t>0t>0使用 Jensen 不等式可得
    exp⁡(tEσ[sup⁡x∈A∑i=1mσixi])≤Eσ[exp⁡(tsup⁡x∈A∑i=1mσixi)]=Eσ[sup⁡x∈Aexp⁡(t∑i=1mσixi)]≤∑x∈AEσ[exp⁡(t∑i=1mσixi)]\exp\left(t\mathbb{E}_\sigma\left[\sup_{\mathbf{x}\in A}\sum_{i=1}^m\sigma_ix_i\right]\right)\le\mathbb{E}_\sigma\left[\exp\left(t\sup_{\mathbf{x}\in A}\sum_{i=1}^m\sigma_ix_i\right)\right]\\ =\mathbb{E}_\sigma\left[\sup_{\mathbf{x}\in A}\exp\left(t\sum_{i=1}^m\sigma_ix_i\right)\right]\le\sum_{\mathbf{x}\in A}\mathbb{E}_\sigma\left[\exp\left(t\sum_{i=1}^m\sigma_ix_i\right)\right]
    • 基于 σ1,…,σm\sigma_1,…,\sigma_m 之间的独立性以及 Hoeffding 引理可得

      (Hoeffding引理:若 X 为期望为0,且有界的实值随机变量,a≤X≤ba\le X\le b,那么对于任意的 t∈Rt\in\mathbb{R} 会有 R[exp⁡⁡(t𝑋)]≤exp⁡(t2(b−a)28)\mathbb{R}[\exp⁡(t𝑋)]\le\exp\left(\frac{t^2(b-a)^2}{8}\right),其中 −∣xi∣≤σixi≤∣xi∣−|x_i|\le \sigma_i x_i\le|x_i|

      ∑x∈AEσ[exp⁡(t∑i=1mσixi)]≤∑x∈A∏i=1mEσi[exp⁡(tσixi)]≤∑x∈A∏i=1mexp⁡(t2(2xi)28)=∑x∈Aexp⁡(t22∑i=1mxi2)≤∑x∈Aexp⁡(t2r22)=∣A∣exp⁡(t2r22)\sum_{\mathbf{x}\in A}\mathbb{E}_\sigma\left[\exp\left(t\sum_{i=1}^m\sigma_ix_i\right)\right]\le\sum_{\mathbf{x}\in A}\prod_{i=1}^m\mathbb{E}_{\sigma_i}\left[\exp(t\sigma_ix_i)\right]\\ \le\sum_{\mathbf{x}\in A}\prod_{i=1}^m\exp\left(\frac{t^2(2x_i)^2}{8}\right)=\sum_{\mathbf{x}\in A}\exp\left(\frac{t^2}{2}\sum_{i=1}^mx_i^2\right)\\ \le\sum_{\mathbf{x}\in A}\exp\left(\frac{t^2r^2}{2}\right)=|A|\exp\left(\frac{t^2r^2}{2}\right)

      即有

      exp⁡(tEσ[sup⁡x∈A∑i=1mσixi])≤∣A∣exp⁡(t2r22)\exp\left(t\mathbb{E}_\sigma\left[\sup_{\mathbf{x}\in A}\sum_{i=1}^m\sigma_ix_i\right]\right)\le|A|\exp\left(\frac{t^2r^2}{2}\right)

      对两边取对数

      Eσ[sup⁡x∈A∑i=1mσixi]≤ln⁡∣A∣t+tr22\mathbb{E}_\sigma\left[\sup_{\mathbf{x}\in A}\sum_{i=1}^m\sigma_ix_i\right]\le\frac{\ln|A|}{t}+\frac{tr^2}{2}

      当 t=2ln⁡∣A∣rt=\frac{\sqrt{2\ln|A|}}{r} 时上式右侧取最小值,可得

      Eσ[sup⁡x∈A∑i=1mσixi]≤r2ln⁡∣A∣\mathbb{E}_\sigma\left[\sup_{\mathbf{x}\in A}\sum_{i=1}^m\sigma_ix_i\right]\le r\sqrt{2\ln|A|}

      不等式两边同时除以 m,定理得证

  • 推论 假设空间 H\mathcal{H} 的 Rademacher 复杂度 Rm(H)\mathcal{R}_m(\mathcal{H}) 与增长函数 ΠH(m)\Pi_{\mathcal{H}}(m) 之间满足
    Rm(H)≤2ln⁡ΠH(m)m\mathcal{R}_m(\mathcal{H})\le\sqrt{\frac{2\ln\Pi_{\mathcal{H}}(m)}{m}}
  • 证明
    • 对于 D=x1,...,xmD={x_1,...,x_m},H∣m\mathcal{H}_{|m} 为假设空间 H\mathcal{H} 在 D 上的限制
    • 由于 h∈Hh\in\mathcal{H} 的值域为 {−1,+1}\{-1,+1\},可知 H∣m\mathcal{H}_{|m} 中的元素为模长 m\sqrt{m} 的向量
    • 由上面的定理 Eσ[1msup⁡x∈A∑i=1mσixi]≤r2ln⁡∣A∣m\mathbb{E}_\sigma\left[\frac{1}{m}\sup_{\mathbf{x}\in A}\sum_{i=1}^m\sigma_ix_i\right]\le\frac{r\sqrt{2\ln|A|}}{m}可得
    Rm(H)=ED[Eσ[sup⁡u∈H∣D1m∑i=1mσiui]]≤ED[m2ln⁡∣H∣D∣m]\mathcal{R}_m(\mathcal{H})=\mathbb{E}_D\left[\mathbb{E}_\sigma\left[\sup_{u\in\mathcal{H_{|D}}}\frac{1}{m}\sum_{i=1}^m\sigma_iu_i\right]\right]\le\mathbb{E}_D\left[\frac{\sqrt{m}\sqrt{2\ln|\mathcal{H}_{|D}|}}{m}\right]
    • 又因为 ∣H∣D∣≤ΠH(m)|\mathcal{H}_{|D}|\le\Pi_\mathcal{H}(m),有
    Rm(H)≤ED[m2ln⁡ΠH(m)m]=2ln⁡ΠH(m)m\mathcal{R}_m(\mathcal{H})\le\mathbb{E}_D\left[\frac{\sqrt{m}\sqrt{2\ln\Pi_\mathcal{H}(m)}}{m}\right]=\sqrt{\frac{2\ln\Pi_{\mathcal{H}}(m)}{m}}

3.3 实例分析

线性超平面

  • 线性超平面的假设空间 H\mathcal{H} 可表示为

    {hw,b:hw,b(x)=sign(wTx+b)=sign((∑i=1dwixi)+b)}\left\{h_{\mathbf{w},b}:h_{\mathbf{w},b}(x)=\text{sign}(\mathbf{w}^T\mathbf{x}+b)=\text{sign}\left(\left(\sum_{i=1}^dw_ix_i\right)+b\right)\right\}

    b=0b=0 时为齐次线性超平面,而典型线性超平面是缩放 w,b\mathbf{w},b 后满足 min⁡x∣wTx+b∣=1\min_\mathcal{x}|\mathbf{w}^T\mathbf{x}+b|=1 的超平面

  • 定理3.5 Rd\mathbb{R}^d 中由齐次线性超平面构成的假设空间 H\mathcal{H} 的 VC维为 d

  • 证明

    • 能打散某个大小为 d 的样本集
      • 令 e1,...,ede_1,...,e_d 表示 Rd\mathbb{R}^d 中的 d 个单位向量,集合 D={e1,...,ed}D=\{e_1,...,e_d\}
      • 对于任意 d 个标记 y1,...,ydy_1,...,y_d,取 wy=(y1,...,yd)\mathbf{w}_y=(y_1,...,y_d),则有 wyTei=yi\mathbf{w}_y^T\mathbf{e}_i=y_i,所以 D 能被齐次线性超平面构成的假设空间打散
    • 不能打散任意大小为 d+1 的样本集
      • 令集合 D′={x1,...,xd+1}D'=\{\mathbf{x}_1,...,\mathbf{x}_{d+1}\} 为 Rd\mathbb{R}^d 中任意 d+1 个向量,则必存在不全为 0 的实数 a1,...,ad+1a_1,...,a_{d+1} 使得 ∑i=1d+1aixi=0\sum_{i=1}^{d+1}a_i\mathbf{x}_i=0。
      • 令 I={i:ai>0}I=\{i:a_i>0\},J={j:aj<0}J=\{j:a_j<0\},则 I,JI,J 中必定有一个非空
      • 假设二者都非空
      ∑i∈Iaixi=∑j∈J∣aj∣xj\sum_{i\in I}a_i\mathbf{x}_i=\sum_{j\in J}|a_j|\mathbf{x}_j
      采用反证法,假设 D′D' 能被 H\mathcal{H} 打散,则存在向量 w\mathbf{w} 使得 wTxi>0,i∈I\mathbf{w}^T\mathbf{x}_i>0,i\in I 且 wTxj<0,j∈J\mathbf{w}^T \mathbf{x}_j<0,j\in J,由此可得
      0<∑i∈Iai(xiTw)=(∑i∈Iaixi)Tw=(∑j∈J∣aj∣xj)Tw=∑j∈J∣aj∣(xjTw)<00<\sum_{i\in I}a_i(\mathbf{x}_i^T\mathbf{w})=\left(\sum_{i\in I}a_i\mathbf{x}_i\right)^T\mathbf{w}=\left(\sum_{j\in J}|a_j|\mathbf{x}_j\right)^T\mathbf{w}=\sum_{j\in J}|a_j|(\mathbf{x}_j^T\mathbf{w})<0
      矛盾,反证成立
      • 当 I,JI,J 只有一个不为空集时同理
  • 定理3.6 Rd\mathbb{R}^d 中由非齐次线性超平面构成的假设空间 H\mathcal{H} 的 VC维为 d+1

  • 证明

    • 由定理 3.5 的证明可知 D={0,e1,...,ed}D=\{0,e_1,...,e_d\} 能被 H\mathcal{H} 打散
    • 将非齐次线性超平面转化为齐次线性超平面
    wTx+b=w′Tx′  (w∈R,x∈Rd,w′∈Rd+1,x′∈Rd+1)w′=(w;b),x′=(x;1)\mathbf{w}^T\mathbf{x}+b=\mathbf{w}'^T\mathbf{x}'\ \ (\mathbf{w}\in\mathbb{R},\mathbf{x}\in\mathbb{R}^d,\mathbf{w}'\in\mathbb{R}^{d+1},\mathbf{x}'\in\mathbb{R}^{d+1})\\ \mathbf{w}'=(\mathbf{w};b),\mathbf{x}'=(\mathbf{x};1)
    • 如果 D′={x1,...,xd+2}D'=\{\mathbf{x}_1,...,\mathbf{x}_{d+2}\} 能被 Rd\mathbb{R}^d 中非齐次线性超平面打散,则 D′′={x1′,...,xd+2′}D''=\{\mathbf{x}_1',...,\mathbf{x}_{d+2}'\} 能被 Rd+1\mathbb{R}^{d+1} 中齐次线性超平面打散,与定理3.5矛盾
  • 定理3.7 若 ∥x∥≤r\lVert x\rVert\le r,D 为大小为 m 的数据集,则超平面族 H={x↦wTx:∥w∥≤Λ}\mathcal{H}=\{x\mapsto \mathbf{w}^T\mathbf{x}:\lVert \mathbf{w}\rVert\le\Lambda\} 的经验 Rademacher复杂度满足

RD^(H)≤r2Λ2m\hat{\mathcal{R}_D}(\mathcal{H})\le\sqrt{\frac{r^2\Lambda^2}{m}}
  • 证明
    RD^(H)=1mEσ[sup⁡∑i=1mσiwTxi]=1mEσ[sup⁡wT∑i=1mσixi]≤ΛmEσ[∥∑i=1mσixi∥]=ΛmEσ2∥∑i=1mσixi∥≤ΛmEσ∥∑i=1mσixi∥2=ΛmEσ[∑i,j=1mσiσj(xiTxj)]=ΛmEσ[∑i,j=1mEσ[σiσj](xiTxj)]≤Λm∑i=1m∥xi2∥≤r2Λ2m\hat{\mathcal{R}_D}(\mathcal{H})=\frac{1}{m}\mathbb{E}_\sigma\left[\sup\sum_{i=1}^m\sigma_i\mathbf{w}^T\mathbf{x}_i\right]=\frac{1}{m}\mathbb{E}_\sigma\left[\sup\mathbf{w}^T\sum_{i=1}^m\sigma_i\mathbf{x}_i\right]\\ \le\frac{\Lambda}{m}\mathbb{E}_\sigma\left[\lVert \sum_{i=1}^m\sigma_i\mathbf{x}_i\rVert\right]=\frac{\Lambda}{m}\sqrt{\mathbb{E}_\sigma^2\lVert \sum_{i=1}^m\sigma_i\mathbf{x}_i\rVert}\le\frac{\Lambda}{m}\sqrt{\mathbb{E}_\sigma\lVert \sum_{i=1}^m\sigma_i\mathbf{x}_i\rVert^2}\\ =\frac{\Lambda}{m}\sqrt{\mathbb{E}_\sigma\left[ \sum_{i,j=1}^m\sigma_i\sigma_j(\mathbf{x}_i^T\mathbf{x}_j)\right]}=\frac{\Lambda}{m}\sqrt{\mathbb{E}_\sigma\left[ \sum_{i,j=1}^m\mathbb{E}_\sigma[\sigma_i\sigma_j](\mathbf{x}_i^T\mathbf{x}_j)\right]}\\ \le\frac{\Lambda}{m}\sqrt{\sum_{i=1}^m\lVert \mathbf{x}_i^2\rVert}\le\sqrt{\frac{r^2\Lambda^2}{m}}

支持向量机

  • 定理3.8 若 ∥x∥≤r\lVert \mathbf{x}\rVert\le r,则超平面族 {x↦sign(wTx):min⁡x⁡∣wTx∣=1∧∥w∥≤Λ}\{\mathcal{x}\mapsto\text{sign}(\mathbf{w}^T\mathbf{x}):\min_\mathbf{x}⁡|\mathbf{w}^T\mathbf{x}|=1\land\lVert \mathbf{w}\rVert\le\Lambda\} 的 VC维 d满足
d≤r2Λ2d\le r^2\Lambda^2
  • 证明
    • 令 {x1,...,xd}\{\mathbf{x}_1,...,\mathbf{x}_d\} 为能被超平面族打散的集合,则对于任意 y=(y1,...,yd)∈{−1,+1}d\mathbf{y}=(y_1,...,y_d)\in\{−1,+1\}^d 存在 w\mathbf{w} 使得
    yi(wTxi)≥1  (i∈[d])y_i(\mathbf{w}^T\mathbf{x}_i)\ge1\ \ (i\in[d])
    • 对这些不等式求和
    d≤wT∑i=1dyixi≤∥w∥∥∑i=1dyixi∥≤Λ∥∑i=1dyixi∥d\le\mathbf{w}^T\sum_{i=1}^dy_i\mathbf{x}_i\le\lVert \mathbf{w}\rVert\lVert \sum_{i=1}^dy_i\mathbf{x}_i\rVert\le\Lambda\lVert \sum_{i=1}^dy_i\mathbf{x}_i\rVert
    • 上式对任}意 y∈{−1,+1}dy\in\{−1,+1\}^d 都成立,对其两边按 y1,...,ydy_1,...,y_d 服从 {−1,+1}\{−1,+1\} 独立且均匀的分布取期望可得
    d≤ΛEy[∥∑i=1dyixi∥]≤ΛEy[∥∑i=1dyixi∥2]=Λ∑i,j=1dEy[yiyj](xiTxj)=Λ∑i=1dxiTxi≤Λdr2=Λrdd\le\Lambda\mathbb{E}_y\left[\lVert \sum_{i=1}^dy_i\mathbf{x}_i\rVert \right]\le\Lambda\sqrt{\mathbb{E}_y\left[\lVert\sum_{i=1}^dy_i\mathbf{x}_i\rVert^2\right]}\\ =\Lambda\sqrt{\sum_{i,j=1}^d\mathbb{E}_y[y_iy_j](\mathbf{x}_i^T\mathbf{x}_j)}=\Lambda\sqrt{\sum_{i=1}^d\mathbf{x}_i^T\mathbf{x}_i}\le\Lambda\sqrt{dr^2}=\Lambda r\sqrt{d}
    得证

多层神经网络

  • 引理3.2 令 F(1)⊂Y1X,F(2)⊂Y2X\mathcal{F}^{(1)}\subset \mathcal{Y}_1^\mathcal{X},\mathcal{F}^{(2)}\subset \mathcal{Y}_2^\mathcal{X} 为两个函数族,F=F(1)×F(2)\mathcal{F}=\mathcal{F}^{(1)}\times\mathcal{F}^{(2) } 为它们的笛卡尔积,有
ΠF(m)≤ΠF(1)(m)⋅ΠF(2)(m)\Pi_\mathcal{F} (m)\le\Pi_{\mathcal{F}^{(1)}} (m)\cdot\Pi_{\mathcal{F}^{(2)}} (m)
  • 证明

    • 对于大小为 m 且独立同分布从 X\mathcal{X} 采样得到的训练集 D⊂XD\subset\mathcal{X},根据笛卡尔积的定义 (A×B={(x,y)∣x∈A∧y∈B}A\times B=\{(x,y)|x\in A\land y\in B\}) 有
    ∣F∣m∣=∣F∣m(1)∣∣F∣m(2)∣≤Π(F(1))(m)⋅Π(F(2))(m)|\mathcal{F}_{|m} |=|\mathcal{F}_{|m}^{(1)}||\mathcal{F}_{|m}^{(2)} |\le\Pi_(\mathcal{F}^{(1)} ) (m)\cdot\Pi_(\mathcal{F}^{(2)} ) (m)
    • 由 D 的任意性可知引理得证
  • 引理3.3 令 F(1)⊂Y1X,F(2)⊂Y2X\mathcal{F}^{(1)}\subset \mathcal{Y}_1^\mathcal{X},\mathcal{F}^{(2)}\subset \mathcal{Y}_2^\mathcal{X} 为两个函数族,F=F(1)∘F(2)\mathcal{F}=\mathcal{F}^{(1)}\circ\mathcal{F}^{(2) } 为它们的复合函数族,有

ΠF(m)≤ΠF(1)(m)⋅ΠF(2)(m)\Pi_\mathcal{F} (m)\le\Pi_{\mathcal{F}^{(1)}} (m)\cdot\Pi_{\mathcal{F}^{(2)}} (m)
  • 证明

    • 对于大小为 m 且独立同分布从 X\mathcal{X} 采样得到的训练集 D⊂XD\subset\mathcal{X},根据 F\mathcal{F} 的定义
    F∣m={(f2(f1(x1)),...,f2(f1(xm)))∣f1∈F(1),f2∈F(2)}=∪ui∈F∣m(1)⁡{(f2(u1),...,f2(um))∣f2∈F(2)}\mathcal{F}_{|m}=\left\{(f_2 (f_1 (x_1 )),...,f_2 (f_1 (x_m )))|f_1\in\mathcal{F}^{(1)},f_2\in\mathcal{F}^{(2)} \right\}=\\ \cup_{u_i\in\mathcal{F}_{|m}^{(1)}}⁡\left\{(f_2(u_1),...,f_2(u_m))|f_2\in\mathcal{F}^{(2)}\right\}
    • 因此有
    ∣F∣D∣≤∑ui∈F∣D(1)∣{(f2(u1),...,f2(um))│f2∈F(2)}∣≤∑ui∈F∣D(1)ΠF(2)(m)=∣F∣D(1)∣⋅ΠF(2)(m)≤ΠF(2)(m)⋅ΠF(1)(m)|\mathcal{F}_{|D}|\le \sum_{u_i\in\mathcal{F}_{|D}^{(1)}}\left|\left\{(f_2(u_1),...,f_2 (u_m))│f_2\in\mathcal{F}^{(2)}\right\}\right|\\ \le\sum_{u_i\in\mathcal{F}_{|D}^{(1)}}\Pi_{\mathcal{F}^{(2)}}(m)=\left|\mathcal{F}_{|D}^{(1)}\right|\cdot\Pi_{\mathcal{F}^{(2)}} (m)\le\Pi_{\mathcal{F}^{(2)}}(m)\cdot\Pi_{\mathcal{F}^{(1)}}(m)
    • 根据 D 的任意性可知引理得证
  • VC维分析

    • 神经元 v 计算函数 ϕ(wvTx−θv)\phi(\mathbb{w}^T_v\mathbf{x}-\theta_v)
    • 考虑使用符号激活函数 ϕ(t)=sign(t)\phi(t)=\text{sign}(t) 的多层神经网络
    • 假设输入空间 X=Rd0\mathcal{X}=\mathbb{R}^{d_0},一个 l 层的多层网络可以简化成一系列映射的复合
    fl∘⋯∘f2∘f1(x)f_l\circ⋯\circ f_2\circ f_1(\mathbf{x})

    其中

    fi:Rdi−1↦{±1}di  (i∈[l−1])fl:Rdl−1↦{±1}f_i:\mathbb{R}^{d_{i−1}}\mapsto\{\pm1\}^{d_i}\ \ (i\in[l−1])\\ f_l:\mathbb{R}^{d_{l−1}}\mapsto\{\pm1\}
    • 考虑 fif_i 是一个多维到多维的映射,可以将其分解为若干个二值多元函数,对于 fif_i 的每个分量 fi,j:Rdi−1↦{±1}f_{i,j}:\mathbb{R}^{d_{i−1}}\mapsto\{\pm1\} 表示为 fi,j(u)=sign(wi,jTu−θi,j)f_{i,j}(\mathbf{u})=\text{sign}(\mathbf{w}_{i,j}^T \mathbf{u}−\theta_{i,j}),其中 wi,j∈Rdi−1,θi,j∈R\mathbf{w}_{i,j}\in\mathbb{R}^{d_i−1},\theta_{i,j}\in\mathbb{R} 分别为关于第 i 层第 j 个神经元的权值参数与阈值参数
    • 将多元函数 fi,j(u)f_{i,j}(\mathbf{u}) 的函数族记为 F(i,j)\mathcal{F}^{(i,j)},关于第 i 层的函数族可以表示为
    F(i)=F(i,1)×...×F(i,di)\mathcal{F}^{(i)}=\mathcal{F}^{(i,1)}\times...\times\mathcal{F}^{(i,d_i )}
    • 从而整个多层神经网络的函数族可以表示为
    F=F(l)∘...∘F(2)∘F(1)\mathcal{F}=\mathcal{F}^{(l) }\circ...\circ\mathcal{F}^{(2)}\circ\mathcal{F}^{(1)}
    • 根据引理3.2、引理3.3、定理3.1和定理3.6可得
    ΠF(m)≤∏i=1lπF(i)(m)≤∏i=1l∏j=1diπF(i,j)(m)≤∏i=1l∏j=1di(e⋅mdi−1+1)di−1+1\Pi_\mathcal{F}(m)\le\prod_{i=1}^l\pi_{\mathcal{F}^{(i)}}(m) \le\prod_{i=1}^l\prod_{j=1}^{d_i}\pi_{\mathcal{F}^{(i,j)}}(m)\\ \le\prod_{i=1}^l\prod_{j=1}^{d_i}\left(\frac{e\cdot m}{d_{i−1}+1}\right)^{d_{i−1}+1}
    • 令 N=∑i=1l∑j=1didi−1+1N=\sum_{i=1}^l\sum_{j=1}^{d_i}{d_{i−1}+1} 表示整个多层神经网络的参数数目,可以将上式化简为
    ΠF(m)≤(e⋅m)N\Pi_\mathcal{F}(m)\le(e\cdot m)^N
  • 定理3.9 令 F\mathcal{F} 表示对应多层神经网络的函数族,其 VC维 VC(F)=O(Nlog⁡2N)VC(\mathcal{F})=O(N\log_2N)

  • 证明

    • 假设能被 F\mathcal{F} 打散的最大样本集合大小为 d,易知 ΠF(d)=2d\Pi_\mathcal{F}(d)=2^d
    • 由前述结论可知
    2d≤(de)N2^d\le(de)^N
    • 化简即为 d=O(Nlog⁡2N)d=O(N\log_2N)